

TNT-LLM là gì?
TNT-LLM (Taxonomy and Text classification using Large Language Models) là một framework gồm hai giai đoạn, được phát triển để tạo và phân loại taxonomy từ các tài liệu văn bản. Hệ thống có hai giai đoạn chính.
Giai đoạn 1: Tạo taxonomy
Ở giai đoạn đầu, hệ thống nhận một mẫu tài liệu văn bản và một hướng dẫn cho trường hợp sử dụng cụ thể, chẳng hạn như "tạo taxonomy để gom cụm bài báo". Hệ thống sử dụng một mô hình ngôn ngữ lớn (LLM) để tóm tắt từng bài viết, trích xuất thông tin chính. Thông qua quá trình lặp, LLM tạo, cập nhật và tinh chỉnh taxonomy dựa trên các bản tóm tắt này, cuối cùng tạo ra một tập nhãn và mô tả có cấu trúc giúp phân loại bài báo một cách hiệu quả.
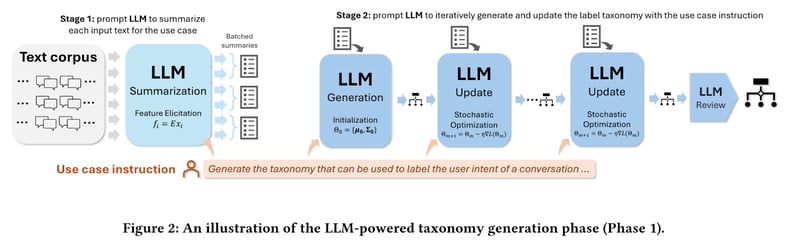
Nguồn: Mengting Wan và cộng sự
Giai đoạn 2: Phân loại văn bản
Giai đoạn thứ hai là sử dụng taxonomy đã tạo để gán nhãn cho một tập dữ liệu lớn hơn. Hệ thống nhắc một LLM áp dụng các nhãn này, sau đó các nhãn sẽ đóng vai trò làm dữ liệu huấn luyện cho một bộ phân loại gọn nhẹ, chẳng hạn như hồi quy logistic. Khi đã huấn luyện, bộ phân loại này có thể được triển khai để gán nhãn hiệu quả cho toàn bộ kho văn bản hoặc phân loại theo thời gian thực.
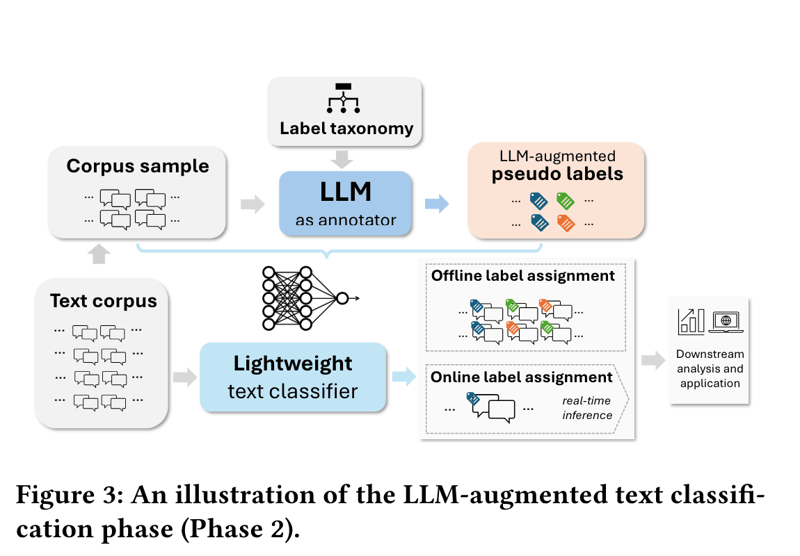
Nguồn: Mengting Wan và cộng sự
Tính linh hoạt của TNT-LLM giúp nó áp dụng được cho nhiều tác vụ phân loại văn bản, bao gồm phát hiện ý định và phân loại chủ đề, mở rộng phạm vi ứng dụng vượt ra ngoài phân tích hội thoại.
Lợi ích của TNT-LLM
TNT-LLM nổi bật như một công cụ mạnh cho khai thác và phân loại văn bản ở quy mô lớn, mang lại nhiều lợi thế quan trọng.
Tự động tạo taxonomy
TNT-LLM đơn giản hóa việc tạo các taxonomy chi tiết và dễ diễn giải từ dữ liệu văn bản thô. Quy trình này tự động hóa một công việc tốn nhiều công sức vốn thường đòi hỏi chuyên môn lĩnh vực. Hệ thống tạo ra các taxonomy phù hợp với trường hợp sử dụng cụ thể với đầu vào từ con người tối thiểu, giúp tiết kiệm đáng kể thời gian và nguồn lực.
Phân loại có khả năng mở rộng
Dựa trên các taxonomy đã tạo, TNT-LLM cho phép phân loại văn bản ở quy mô lớn. Nó cho phép xây dựng các mô hình gọn nhẹ có thể xử lý các tập dữ liệu lớn hoặc tác vụ phân loại theo thời gian thực một cách hiệu quả, lý tưởng cho các ứng dụng có yêu cầu thông lượng cao.
Cách tiếp cận tiết kiệm chi phí
TNT-LLM tối ưu hóa việc sử dụng tài nguyên bằng cách tận dụng mô hình LLM theo từng tầng. Nó sử dụng các mô hình mạnh như GPT-4 cho việc tạo taxonomy và các lựa chọn tiết kiệm hơn như GPT-3.5-Turbo cho tác vụ tóm tắt. Việc phân loại cuối cùng được thực hiện bởi mô hình hồi quy logistic hiệu quả, tiếp tục giảm chi phí vận hành.
Đầu ra chất lượng cao
Quy trình tạo taxonomy theo vòng lặp của TNT-LLM đảm bảo liên tục tinh chỉnh, mang lại các phân loại chất lượng cao, phù hợp và chính xác, được điều chỉnh theo từng tập dữ liệu và trường hợp sử dụng cụ thể.
Ít cần can thiệp của con người
Trong khi vẫn cho phép con người xem xét và điều chỉnh, TNT-LLM yêu cầu đầu vào thủ công tối thiểu so với các phương pháp truyền thống. Điều này giúp giảm thiểu thiên lệch và sự không nhất quán khi tạo taxonomy.
Linh hoạt
TNT-LLM thích ứng tốt với nhiều tác vụ và miền phân loại văn bản, mang lại tính đa dụng trong ứng dụng. Thiết kế dạng mô-đun hỗ trợ tích hợp với các LLM, phương pháp embedding và bộ phân loại khác nhau khi cần.
Tổng thể, TNT-LLM mang đến một giải pháp vững chắc cho các tổ chức xử lý lượng lớn dữ liệu văn bản phi cấu trúc.
Triển khai TNT-LLM
Hãy cùng đi qua quy trình triển khai từng bước.
Cài đặt
Để bắt đầu với các triển khai TNT-LLM, bạn cần cài đặt các gói cần thiết. Bạn có thể làm điều này bằng lệnh pip sau:
pip install langgraph langchain langchain_openaiNgoài ra, hãy thiết lập biến môi trường cho khóa API và tên mô hình:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Khái niệm cơ bản
Trong bối cảnh TNT-LLM, hiểu một vài khái niệm nền tảng là điều thiết yếu để khai thác hiệu quả các khả năng của nó.
Tài liệu
Tài liệu trong TNT-LLM đề cập đến dữ liệu văn bản thô, như nhật ký trò chuyện hoặc bài viết, cần được xử lý. Đây là đầu vào chính cho pipeline TNT-LLM. Mỗi tài liệu được cấu trúc bằng lớp Doc, bao gồm các trường như id, content, và các thuộc tính tùy chọn như summary, explanation và category.
Taxonomy
Taxonomy là các cụm gồm những ý định hoặc chủ đề đã được phân loại. Chúng tổ chức dữ liệu thành các nhóm có ý nghĩa, điều thiết yếu cho các tác vụ như nhận diện ý định và phân loại chủ đề. Lớp TaxonomyGenerationState định nghĩa cấu trúc trạng thái cho việc tạo taxonomy. Lớp này bao gồm tài liệu thô, chỉ số minibatch và các cụm taxonomy ứng viên.
Xây dựng một ứng dụng TNT-LLM đơn giản
Hiểu các khía cạnh nền tảng của TNT-LLM là rất quan trọng để triển khai hiệu quả. Để bắt đầu với TNT-LLM, quá trình tạo taxonomy gồm một số bước chính:
Bước 0: Định nghĩa lớp trạng thái đồ thị, tải dữ liệu và GPT-4o
Trước hết, chúng ta cần định nghĩa lớp trạng thái đồ thị TaxonomyGenerationState, lớp này quản lý các khía cạnh có trạng thái của việc tạo và tiến hóa taxonomy trong suốt quá trình thực thi của đồ thị. Lớp Doc định nghĩa cấu trúc cho từng tài liệu trong đồ thị.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]Trước khi bắt đầu quá trình tạo taxonomy, chúng ta cần tải các tập dữ liệu chứa văn bản thô, như bài báo hoặc nhật ký trò chuyện. Các tập dữ liệu này là đầu vào chính cho TNT-LLM. Ở đây, chúng ta tải bài báo từ Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Cuối cùng, chúng ta khởi tạo một mô hình OpenAI GPT-4o dựa trên Azure để làm mô hình ngôn ngữ (LLM) cho tất cả các thành phần của TNT-LLM. Dù trong thực tế có thể khởi tạo các LLM khác nhau cho từng thành phần, ở đây chúng ta đơn giản hóa bằng cách dùng một mô hình cho mọi tác vụ.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)Bước 1: Tóm tắt tài liệu
Sau khi tải tập dữ liệu, mỗi tài liệu sẽ được tóm tắt. Bước này sử dụng các mô hình ngôn ngữ để tạo bản tóm tắt ngắn gọn, nêu bật các điểm chính của mỗi tài liệu. Các bản tóm tắt rất quan trọng vì chúng cô đọng văn bản dài thành dạng ngắn gọn, dễ xử lý trong khi vẫn giữ thông tin cốt lõi.
Đoạn mã cung cấp khởi tạo prompt LLM để tóm tắt tài liệu bằng TNT-LLM, phân tích đầu ra XML để trích xuất tóm tắt và giải thích. Nó thiết lập một pipeline để ánh xạ nội dung tài liệu, xử lý theo lô để tạo tóm tắt, và tích hợp các bản tóm tắt này trở lại cấu trúc dữ liệu tài liệu ban đầu bằng các bước mapping và reduction.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summariesBước 2: Tạo minibatch
Sau khi tóm tắt, bước tiếp theo là tổ chức các tài liệu đã tóm tắt thành các minibatch. Minibatch giúp xử lý khối lượng dữ liệu lớn hiệu quả hơn. Bằng cách chia tập dữ liệu thành các lô nhỏ hơn, TNT-LLM có thể xử lý song song, tối ưu cả thời gian lẫn tài nguyên tính toán.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}Bước 3: Tạo taxonomy ban đầu
Sử dụng minibatch đầu tiên của các tài liệu đã tóm tắt, TNT-LLM bắt đầu quá trình tạo taxonomy. Bước này gồm việc gom cụm các ý định hoặc chủ đề được nhận diện trong tài liệu. Bằng cách phân tích nội dung mỗi tài liệu, hệ thống xác định các chủ đề hoặc danh mục chung, đặt nền tảng ban đầu cho taxonomy.
Hai hàm chính là:
invoke_taxonomy_chain()- Hàm này tích hợp các bước tạo taxonomy bằng một chuỗi dựa trên LLM (chain) được cấu hình cho các tác vụ TNT-LLM. Nó xây dựng các bảng dữ liệu XML (data_table_xml) từ bản tóm tắt tài liệu và các cụm taxonomy trước đó. Hàm gọi chuỗi LLM để cập nhật taxonomy dựa trên tham số cấu hình (config), trả về trạng thái đã cập nhật với các cụm taxonomy mới.generate_taxonomy()- Hàm này điều phối việc tạo các cụm taxonomy. Nó gọiinvoke_taxonomy_chainvới chuỗi được cấu hình cho việc tạo taxonomy (generate_taxonomy_chain) dùng minibatch ban đầu của tài liệu (state["minibatches"][0]). Nó trả về trạng thái taxonomy đã cập nhật sau quá trình tạo ban đầu.
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Giờ hãy xem cách tích hợp mô hình ngôn ngữ vào quy trình tạo taxonomy:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)Bước 4: Cập nhật taxonomy
Khi các minibatch tiếp theo được xử lý, TNT-LLM lặp lại việc cập nhật và tinh chỉnh taxonomy. Quá trình lặp này cho phép taxonomy tiến hóa và cải thiện theo thời gian, kết hợp các phát hiện và danh mục mới trong các lô dữ liệu bổ sung. Các cập nhật giúp taxonomy toàn diện và phản ánh đúng toàn bộ tập dữ liệu.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Bước 5: Rà soát taxonomy
Khi tất cả minibatch đã được xử lý và taxonomy đã được cập nhật, bước cuối cùng là rà soát taxonomy. Việc rà soát này rất quan trọng để xác thực độ chính xác và mức độ phù hợp của các nhãn đã phân loại. Nó đảm bảo taxonomy tổ chức và phân loại tập dữ liệu một cách có ý nghĩa, phù hợp với trường hợp sử dụng như nhận diện ý định hoặc phân loại chủ đề.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)Bước 6: Điều phối pipeline TNT-LLM với StateGraph
Đến đây, năm bước đầu tiên đã chuẩn bị các thành phần riêng lẻ như tóm tắt tài liệu, tạo minibatch, tạo taxonomy, cập nhật và rà soát. Giờ chúng ta sẵn sàng tích hợp các thành phần này thành một pipeline TNT-LLM thống nhất bằng framework StateGraph.
Đồ thị này điều phối việc thực thi tuần tự các tác vụ: tóm tắt tài liệu, tạo taxonomy từ các minibatch, cập nhật taxonomy theo vòng lặp và cuối cùng rà soát, xác thực taxonomy. Các cạnh có điều kiện đảm bảo taxonomy được cập nhật cho đến khi xử lý hết mọi minibatch, sau đó taxonomy cuối cùng được rà soát và hoàn thiện để dùng trong tác vụ gán nhãn.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()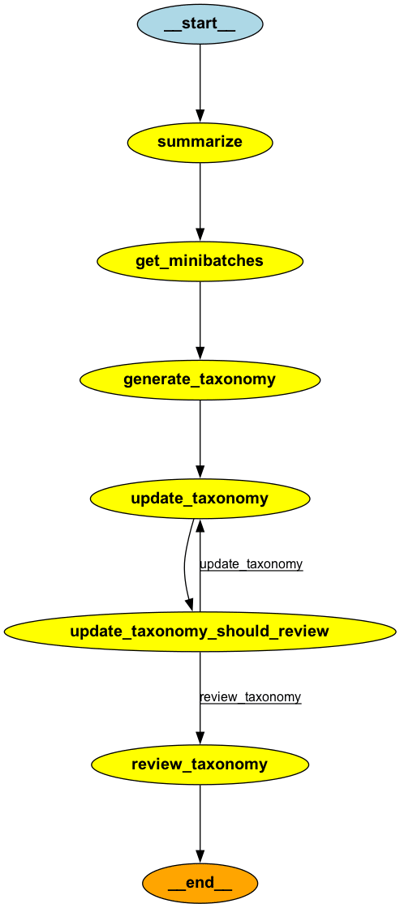
Bước 7: Gom cụm và hiển thị taxonomy bài báo của TNT-LLM
Ở bước cuối cùng này, chúng ta sử dụng TNT-LLM để gom cụm các bài báo. Taxonomy thu được sẽ được hiển thị theo định dạng Markdown, trình bày tên và mô tả của từng cụm.
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)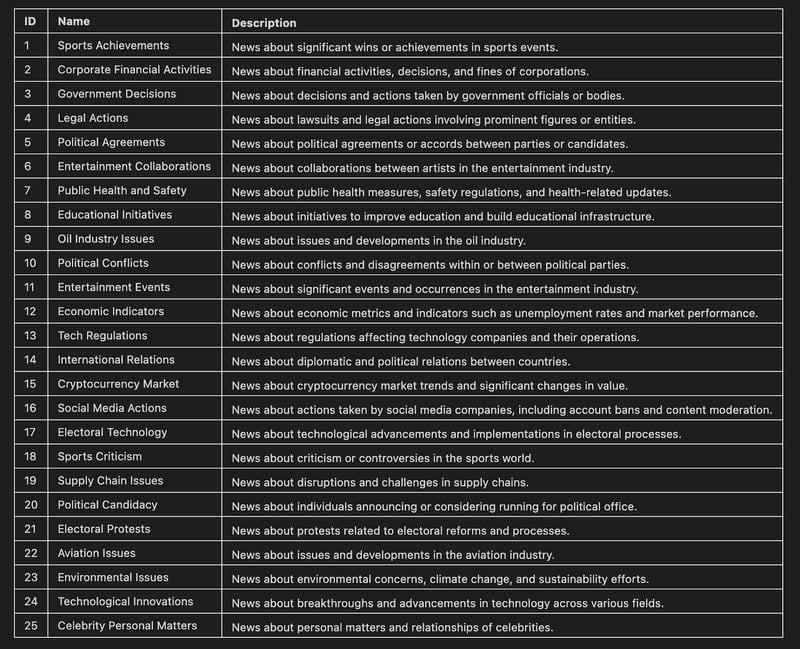
Vậy là xong! Bằng cách làm theo các bước có cấu trúc này, TNT-LLM đã tự động hóa việc tạo các taxonomy chi tiết và dễ diễn giải từ dữ liệu văn bản thô. Cách tiếp cận này đơn giản hóa một công việc vốn đòi hỏi nhiều công sức và chuyên môn, biến nó thành công cụ mạnh cho các tác vụ khai thác và phân loại văn bản ở quy mô lớn.
Kết luận
TNT-LLM là một bước tiến đáng kể trong khai thác và phân loại văn bản, mang đến giải pháp hiệu quả để phân tích lượng lớn dữ liệu phi cấu trúc. Bằng cách tự động hóa việc tạo taxonomy và phân loại có khả năng mở rộng, nó giảm thời gian và công sức để khai thác insight từ văn bản.
Khi TNT-LLM tiếp tục phát triển, nó có tiềm năng thay đổi cách các tổ chức phân tích lượng dữ liệu văn bản khổng lồ. Công cụ này giúp ra quyết định dựa trên dữ liệu trong nhiều ngành, khiến insight từ dữ liệu văn bản trở nên dễ tiếp cận và tạo tác động hơn.
Nếu bạn muốn học thêm về phát triển ứng dụng LLM, tôi gợi ý khóa học Phát triển ứng dụng LLM với LangChain.

Ryan là trưởng nhóm khoa học dữ liệu, chuyên xây dựng các ứng dụng AI sử dụng LLM. Anh là nghiên cứu sinh Tiến sĩ về Xử lý Ngôn ngữ Tự nhiên và Đồ thị Tri thức tại Imperial College London, nơi anh cũng hoàn thành bằng Thạc sĩ Khoa học Máy tính. Ngoài lĩnh vực khoa học dữ liệu, anh viết bản tin Substack hàng tuần, The Limitless Playbook, nơi anh chia sẻ một ý tưởng có thể áp dụng ngay từ các tư tưởng gia hàng đầu thế giới và đôi khi viết về những khái niệm cốt lõi của AI.


Microsoft đã giới thiệu TNT-LLM, một hệ thống mạnh mẽ được thiết kế để tự động hóa việc tạo taxonomy và phân loại văn bản, vượt trội hơn các phương pháp truyền thống về hiệu quả và độ chính xác.
TNT-LLM tận dụng sức mạnh của các mô hình ngôn ngữ lớn (LLM) để tự động hóa và mở rộng quy mô việc tạo taxonomy và bộ phân loại với sự can thiệp tối thiểu của con người. Điều này đặc biệt hữu ích cho các ứng dụng như Bing Copilot, nơi việc quản lý các miền văn bản đa dạng và luôn thay đổi là rất quan trọng.
Trong bài viết này, tôi sẽ hướng dẫn bạn triển khai TNT-LLM bằng GPT-4o và LangGraph để gom cụm bài báo một cách hiệu quả.
Nếu bạn muốn đọc thêm về GPT-4o hoặc LangGraph, tôi gợi ý các bài viết sau:
Nếu bạn muốn tìm hiểu thêm về TNT-LLM, tôi khuyến nghị bài báo gốc TnT-LLM: Khai thác văn bản ở quy mô lớn với các mô hình ngôn ngữ lớn.