
Kursus
Sistem Multi-Agen dengan LangGraph
2 jam 45 menit
9K
TNT-LLM (Taxonomy and Text classification using Large Language Models) adalah kerangka kerja dua fase yang dikembangkan untuk membuat dan mengklasifikasikan taksonomi dari dokumen teks. Sistem ini memiliki dua fase utama.
Pada fase pertama, sistem mengambil sampel dokumen teks dan instruksi kasus penggunaan tertentu, seperti "buat taksonomi untuk mengelompokkan artikel berita." Sistem mempekerjakan model bahasa besar (LLM) untuk meringkas setiap artikel dan mengekstrak informasi kunci. Melalui proses iteratif, LLM menghasilkan, memperbarui, dan menyempurnakan taksonomi berdasarkan ringkasan ini, hingga menghasilkan seperangkat label dan deskripsi terstruktur yang secara efektif mengkategorikan artikel berita.
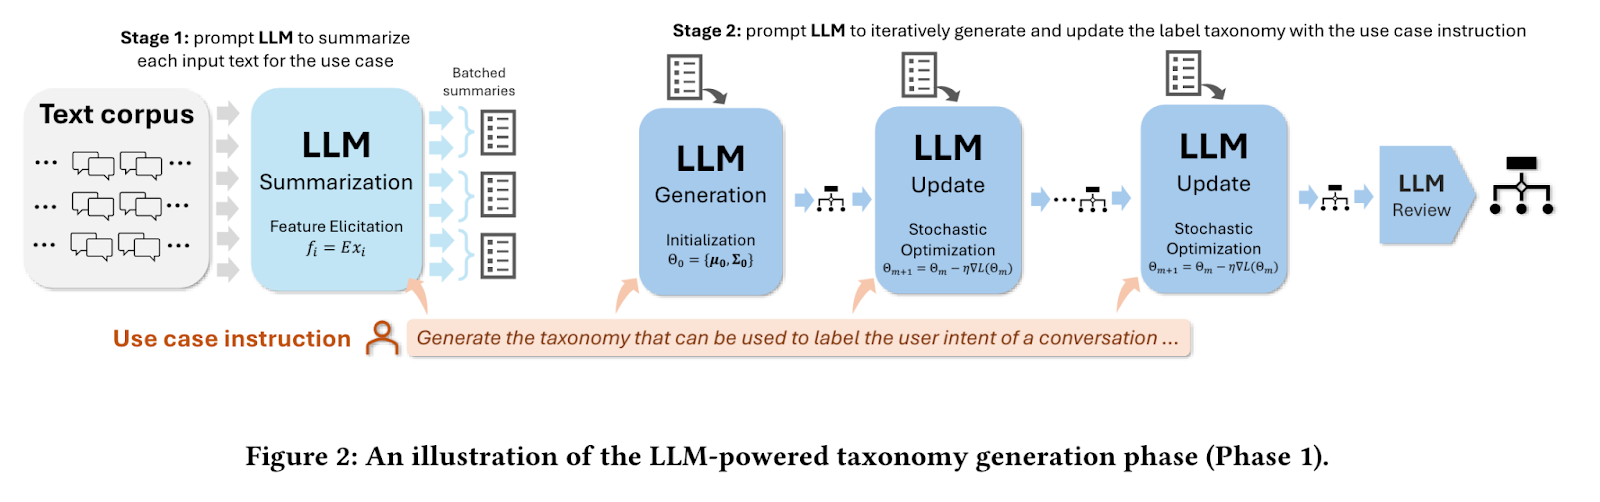
Sumber: Mengting Wan dkk.
Fase kedua melibatkan penggunaan taksonomi yang dihasilkan untuk memberi label pada dataset yang lebih besar. Sistem memandu LLM untuk menerapkan label tersebut, yang kemudian menjadi data pelatihan bagi pengklasifikasi ringan, seperti regresi logistik. Setelah dilatih, pengklasifikasi ini dapat diterapkan untuk memberi label seluruh korpus secara efisien atau melakukan klasifikasi waktu nyata.
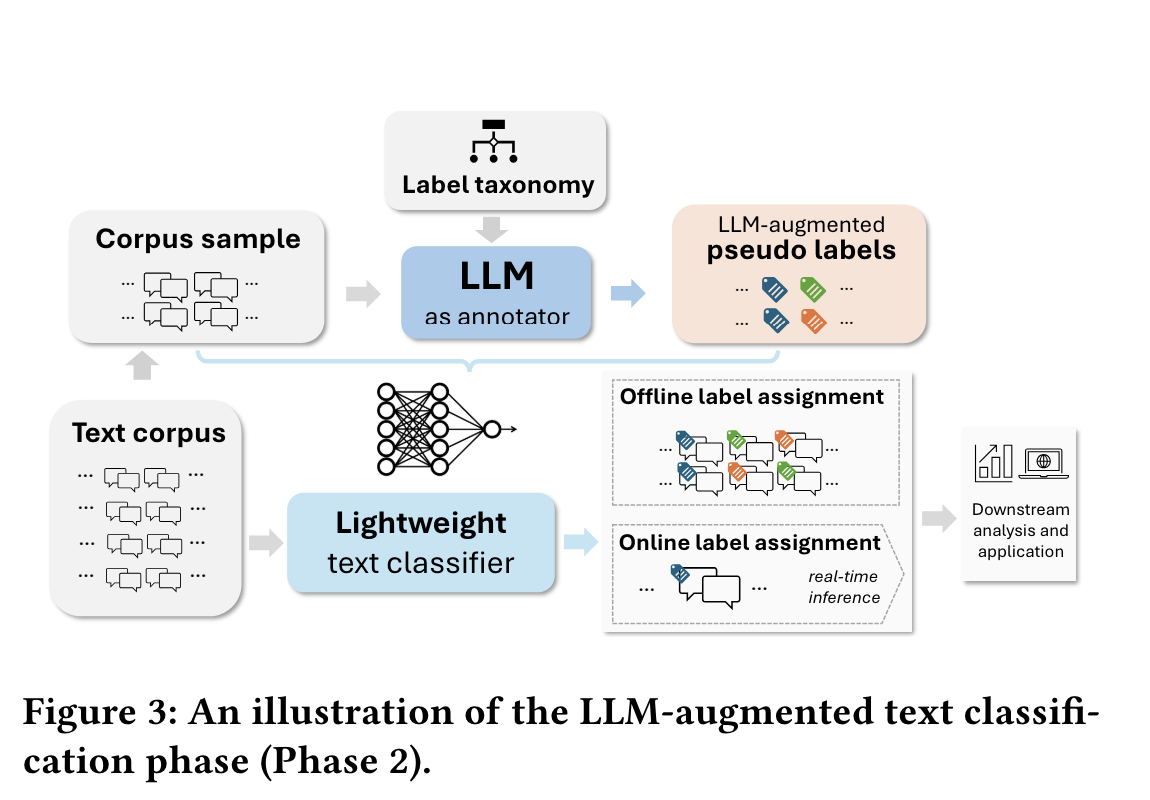
Sumber: Mengting Wan dkk.
Fleksibilitas TNT-LLM membuatnya dapat diterapkan pada beragam tugas klasifikasi teks, termasuk deteksi niat dan kategorisasi topik, memperluas kegunaannya melampaui sekadar analisis percakapan.
TNT-LLM menonjol sebagai alat andal untuk penambangan dan klasifikasi teks skala besar, dengan beberapa keunggulan utama.
TNT-LLM menyederhanakan pembuatan taksonomi yang terperinci dan mudah diinterpretasikan dari data teks mentah. Proses ini mengotomatiskan tugas padat karya yang sering membutuhkan keahlian domain. Sistem menghasilkan taksonomi yang disesuaikan untuk kasus penggunaan spesifik dengan masukan manusia minimal, menghemat banyak waktu dan sumber daya.
Dengan memanfaatkan taksonomi yang dihasilkan, TNT-LLM memungkinkan klasifikasi teks yang dapat diskalakan. Sistem ini memfasilitasi pembuatan model ringan yang dapat menangani dataset besar atau tugas klasifikasi waktu nyata secara efisien, sehingga ideal untuk aplikasi dengan kebutuhan throughput tinggi.
TNT-LLM mengoptimalkan penggunaan sumber daya dengan memanfaatkan pemakaian LLM bertingkat. Model kuat seperti GPT-4 digunakan untuk pembuatan taksonomi, sementara opsi yang lebih ekonomis seperti GPT-3.5-Turbo digunakan untuk tugas peringkasan. Klasifikasi akhir dilakukan oleh model regresi logistik yang efisien, sehingga semakin menekan biaya operasional.
Proses pembuatan taksonomi iteratif pada TNT-LLM memastikan penyempurnaan berkelanjutan, menghasilkan kategorisasi yang berkualitas tinggi, relevan, dan akurat, disesuaikan dengan dataset dan kasus penggunaan spesifik.
Sambil tetap memungkinkan tinjauan dan penyesuaian oleh manusia, TNT-LLM memerlukan masukan manual yang jauh lebih sedikit dibandingkan metode tradisional. Ini mengurangi potensi bias dan ketidakkonsistenan dalam pembuatan taksonomi.
TNT-LLM beradaptasi dengan baik pada berbagai tugas dan domain klasifikasi teks, menawarkan keluwesan dalam penerapan. Desain modularnya mendukung integrasi dengan beragam LLM, metode embedding, dan pengklasifikasi sesuai kebutuhan.
Secara keseluruhan, TNT-LLM memberikan solusi tangguh bagi organisasi yang menangani sejumlah besar data teks tidak terstruktur.
Mari kita telusuri proses implementasinya langkah demi langkah.
Untuk mulai dengan implementasi TNT-LLM, Anda perlu memasang paket yang diperlukan. Anda dapat melakukannya menggunakan perintah pip berikut:
pip install langgraph langchain langchain_openaiSelain itu, atur variabel lingkungan untuk kunci API dan nama model:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Dalam konteks TNT-LLM, memahami beberapa konsep fundamental sangat penting untuk memanfaatkan kemampuannya secara efektif.
Dokumen dalam TNT-LLM mengacu pada data teks mentah, seperti log percakapan atau artikel, yang perlu diproses. Ini adalah masukan utama untuk pipeline TNT-LLM. Setiap dokumen distrukturkan menggunakan kelas Doc, yang mencakup bidang seperti id, content, dan atribut opsional seperti summary, explanation, dan category.
Taksonomi adalah klaster niat atau topik yang telah dikategorikan. Taksonomi mengorganisasi data ke dalam kategori yang bermakna, yang penting untuk tugas seperti pengenalan niat dan klasifikasi topik. Kelas TaxonomyGenerationState mendefinisikan struktur status untuk pembuatan taksonomi. Kelas ini mencakup dokumen mentah, indeks minibatch, dan klaster taksonomi kandidat.
Memahami aspek fundamental TNT-LLM penting untuk menerapkan kemampuannya secara efektif. Untuk memulai dengan TNT-LLM, proses pembuatan taksonomi melibatkan beberapa langkah kunci:
Pertama, kita perlu mendefinisikan kelas status graf TaxonomyGenerationState, yang mengelola aspek stateful dari pembuatan dan evolusi taksonomi sepanjang eksekusi graf. Kelas Doc mendefinisikan struktur untuk dokumen individual dalam graf.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
    id: str
    content: str
    summary: Optional[str]
    explanation: Optional[str]
    category: Optional[str]
class TaxonomyGenerationState(TypedDict):
    # The raw docs; we inject summaries within them in the first step
    documents: List[Doc]
    # Indices to be concise
    minibatches: List[List[int]]
    # Candidate Taxonomies (full trajectory)
    clusters: Annotated[List[List[dict]], operator.add]
Sebelum memulai proses pembuatan taksonomi, kita perlu memuat dataset yang berisi data teks mentah, seperti artikel berita atau log percakapan. Dataset ini berfungsi sebagai masukan utama untuk TNT-LLM. Di sini, kita memuat artikel berita dari Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
    all_data = []
    for i in range(len(df)):
        d = df.iloc[i]
        all_data.append({
            "id": i,
            "content": d['Title'] + "\\n\\n" + d['Excerpt']
        })

    return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0])
{'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Terakhir, kita menginisialisasi model OpenAI GPT-4o berbasis Azure untuk menjadi model bahasa (LLM) kita di seluruh komponen TNT-LLM. Meski dalam praktiknya LLM berbeda dapat diinisialisasi untuk tiap komponen, di sini kita sederhanakan dengan menggunakan satu model untuk semua tugas.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
    openai_api_version="2023-06-01-preview"
    azure_deployment="gpt-4o-2024-05-13",
    temperature=0.0
)Setelah dataset dimuat, setiap dokumen akan dirangkum. Langkah ini melibatkan penggunaan model bahasa untuk menghasilkan ringkasan singkat yang menangkap pokok bahasan utama tiap dokumen. Ringkasan sangat krusial karena mereduksi teks panjang menjadi bentuk yang lebih ringkas dan mudah dikelola sambil tetap mempertahankan informasi esensial.
Kode yang disediakan menginisialisasi prompt LLM untuk merangkum dokumen menggunakan TNT-LLM, mem-parsing keluaran XML untuk mengekstrak ringkasan dan penjelasan. Kode ini menyiapkan pipeline untuk memetakan konten dokumen, memrosesnya dalam batch untuk pembuatan ringkasan, dan mengintegrasikan ringkasan tersebut kembali ke struktur data dokumen asli menggunakan langkah pemetaan dan reduksi.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
    summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
    summary_pattern = r"<summary>(.*?)</summary>"
    explanation_pattern = r"<explanation>(.*?)</explanation>"
    summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
    explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
    summary = summary_match.group(1).strip() if summary_match else ""
    explanation = explanation_match.group(1).strip() if explanation_match else ""
    return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
    summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
    docs = state["documents"]
    return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
    summaries=get_content
    | RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
    summaries = combined["summaries"]
    documents = combined["documents"]
    return {
        "documents": [
            {
                "id": doc["id"],
                "content": doc["content"],
                "summary": summ_info["summary"],
                "explanation": summ_info["explanation"],
            }
            for doc, summ_info in zip(documents, summaries)
        ]
    }
# This is the summary node
map_reduce_chain = map_step | reduce_summariesSetelah peringkasan, langkah berikutnya adalah mengatur dokumen yang diringkas ke dalam minibatch. Minibatch membantu memproses data dalam jumlah besar lebih efisien. Dengan membagi dataset menjadi batch yang lebih kecil, TNT-LLM dapat menangani komputasi secara paralel, mengoptimalkan waktu dan sumber daya komputasi.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    if len(indices) < batch_size:
        # Don't pad needlessly if we can't fill a single batch
        return [indices]
    num_full_batches = len(indices) // batch_size
    batches = [
        indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
    ]
    leftovers = len(indices) % batch_size
    if leftovers:
        last_batch = indices[num_full_batches * batch_size :]
        elements_to_add = batch_size - leftovers
        last_batch += random.sample(indices, elements_to_add)
        batches.append(last_batch)
    return {
        "minibatches": batches,
}Dengan menggunakan minibatch pertama dari dokumen yang telah diringkas, TNT-LLM memulai proses pembuatan taksonomi. Langkah ini melibatkan pengelompokan niat atau topik yang diidentifikasi dalam dokumen. Dengan menganalisis konten tiap dokumen, sistem mengidentifikasi tema atau kategori umum, meletakkan fondasi awal taksonomi.
Dua fungsi utama adalah:
invoke_taxonomy_chain() - Fungsi ini mengintegrasikan langkah pembuatan taksonomi menggunakan rantai berbasis LLM (chain) yang dikonfigurasikan untuk tugas TNT-LLM. Fungsi ini menyusun tabel data XML (data_table_xml) dari ringkasan dokumen dan klaster taksonomi sebelumnya. Fungsi ini memanggil rantai LLM untuk memperbarui taksonomi berdasarkan parameter konfigurasi yang ditentukan (config), dan mengembalikan status yang diperbarui dengan klaster taksonomi baru.generate_taxonomy() - Fungsi ini mengorkestrasi pembuatan klaster taksonomi. Fungsi ini memanggil invoke_taxonomy_chain dengan rantai yang dikonfigurasikan untuk pembuatan taksonomi (generate_taxonomy_chain) menggunakan minibatch awal dokumen (state["minibatches"][0]). Fungsi ini mengembalikan status taksonomi yang diperbarui setelah proses pembuatan awal.from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Sekarang, mari lihat bagaimana model bahasa dapat diintegrasikan ke dalam proses pembuatan taksonomi:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
    use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
    taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    return invoke_taxonomy_chain(
        generate_taxonomy_chain, state, config, state["minibatches"][0]
)Saat minibatch berikutnya diproses, TNT-LLM secara iteratif memperbarui dan menyempurnakan taksonomi. Proses iteratif ini memungkinkan taksonomi berkembang dan membaik seiring waktu, memasukkan wawasan dan kategori baru yang ditemukan dalam batch data tambahan. Pembaruan taksonomi memastikan cakupan yang komprehensif dan mencerminkan keseluruhan dataset.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
    taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    which_mb = len(state["clusters"]) % len(state["minibatches"])
    return invoke_taxonomy_chain(
        update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Setelah semua minibatch diproses dan taksonomi diperbarui, langkah terakhir adalah meninjau taksonomi. Tinjauan ini krusial untuk memvalidasi ketepatan dan relevansi label yang dikategorikan. Ini memastikan taksonomi secara efektif mengatur dan mengategorikan dataset dengan cara yang bermakna, selaras dengan kasus penggunaan seperti pengenalan niat atau klasifikasi topik.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
    taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    return invoke_taxonomy_chain(
        review_taxonomy_chain, state, config, indices[:batch_size]
)Sejauh ini, lima langkah pertama melibatkan penyiapan komponen individual seperti peringkasan dokumen, pembuatan minibatch, pembuatan, pembaruan, dan peninjauan taksonomi. Sekarang, kita siap mengintegrasikan komponen-komponen ini ke dalam pipeline TNT-LLM yang koheren menggunakan kerangka StateGraph.
Graf ini mengorkestrasi eksekusi tugas secara berurutan: merangkum dokumen, membuat taksonomi dari minibatch, memperbarui taksonomi secara iteratif, dan akhirnya meninjau serta memvalidasi taksonomi. Tepi bersyarat memastikan taksonomi terus diperbarui hingga semua minibatch diproses, setelah itu taksonomi final ditinjau dan difinalisasi untuk digunakan dalam tugas pelabelan.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
    num_minibatches = len(state["minibatches"])
    num_revisions = len(state["clusters"])
    if num_revisions < num_minibatches:
        return "update_taxonomy"
    return "review_taxonomy"
graph.add_conditional_edges(
    "update_taxonomy",
    should_review,
    # Optional (but required for the diagram to be drawn correctly below)
    {"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()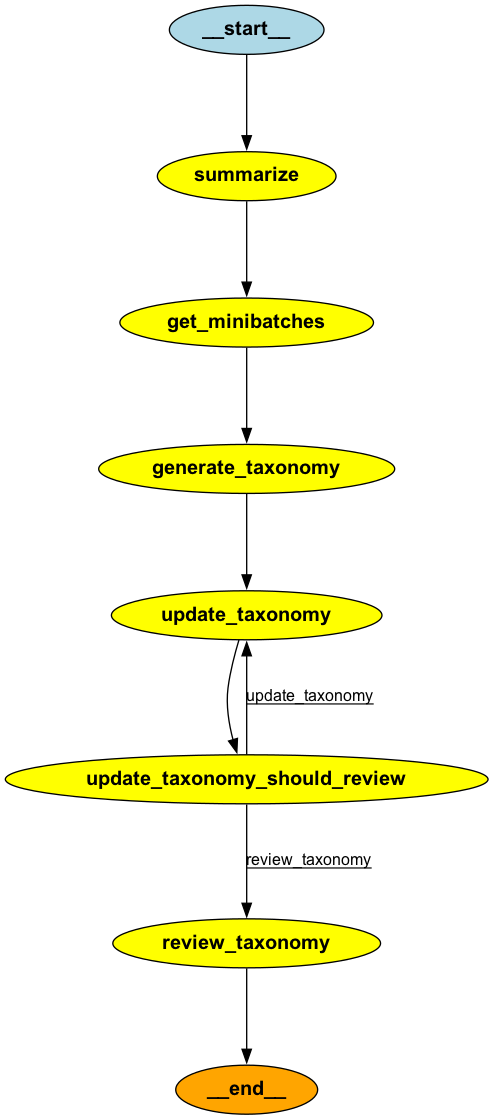
Pada langkah terakhir ini, kita memanfaatkan TNT-LLM untuk mengelompokkan artikel berita. Taksonomi yang dihasilkan ditampilkan dalam format Markdown, menampilkan nama dan deskripsi setiap klaster.
use_case = (
    "Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
    {"documents": docs},
    {
        "configurable": {
            "use_case": use_case,
            # Optional:
            "batch_size": 10,
            "suggestion_length": 30,
            "cluster_name_length": 10,
            "cluster_description_length": 30,
            "explanation_length": 20,
            "max_num_clusters": 25,
        },
        "max_concurrency": 2,
        "recursion_limit": 50,
    },
)
for step in stream:
    node, state = next(iter(step.items()))
    print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
    md = "## Final Taxonomy\\n\\n"
    md += "| ID | Name | Description |\\n"
    md += "|----|------|-------------|\\n"
    # Iterate over each inner list of dictionaries
    for cluster_list in clusters:
        for label in cluster_list:
            id = label["id"]
            name = label["name"].replace("|", "\\\\|")  # Escape any pipe characters within the content
            description = label["description"].replace("|", "\\\\|")  # Escape any pipe characters
            md += f"| {id} | {name} | {description} |\\n"
    return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)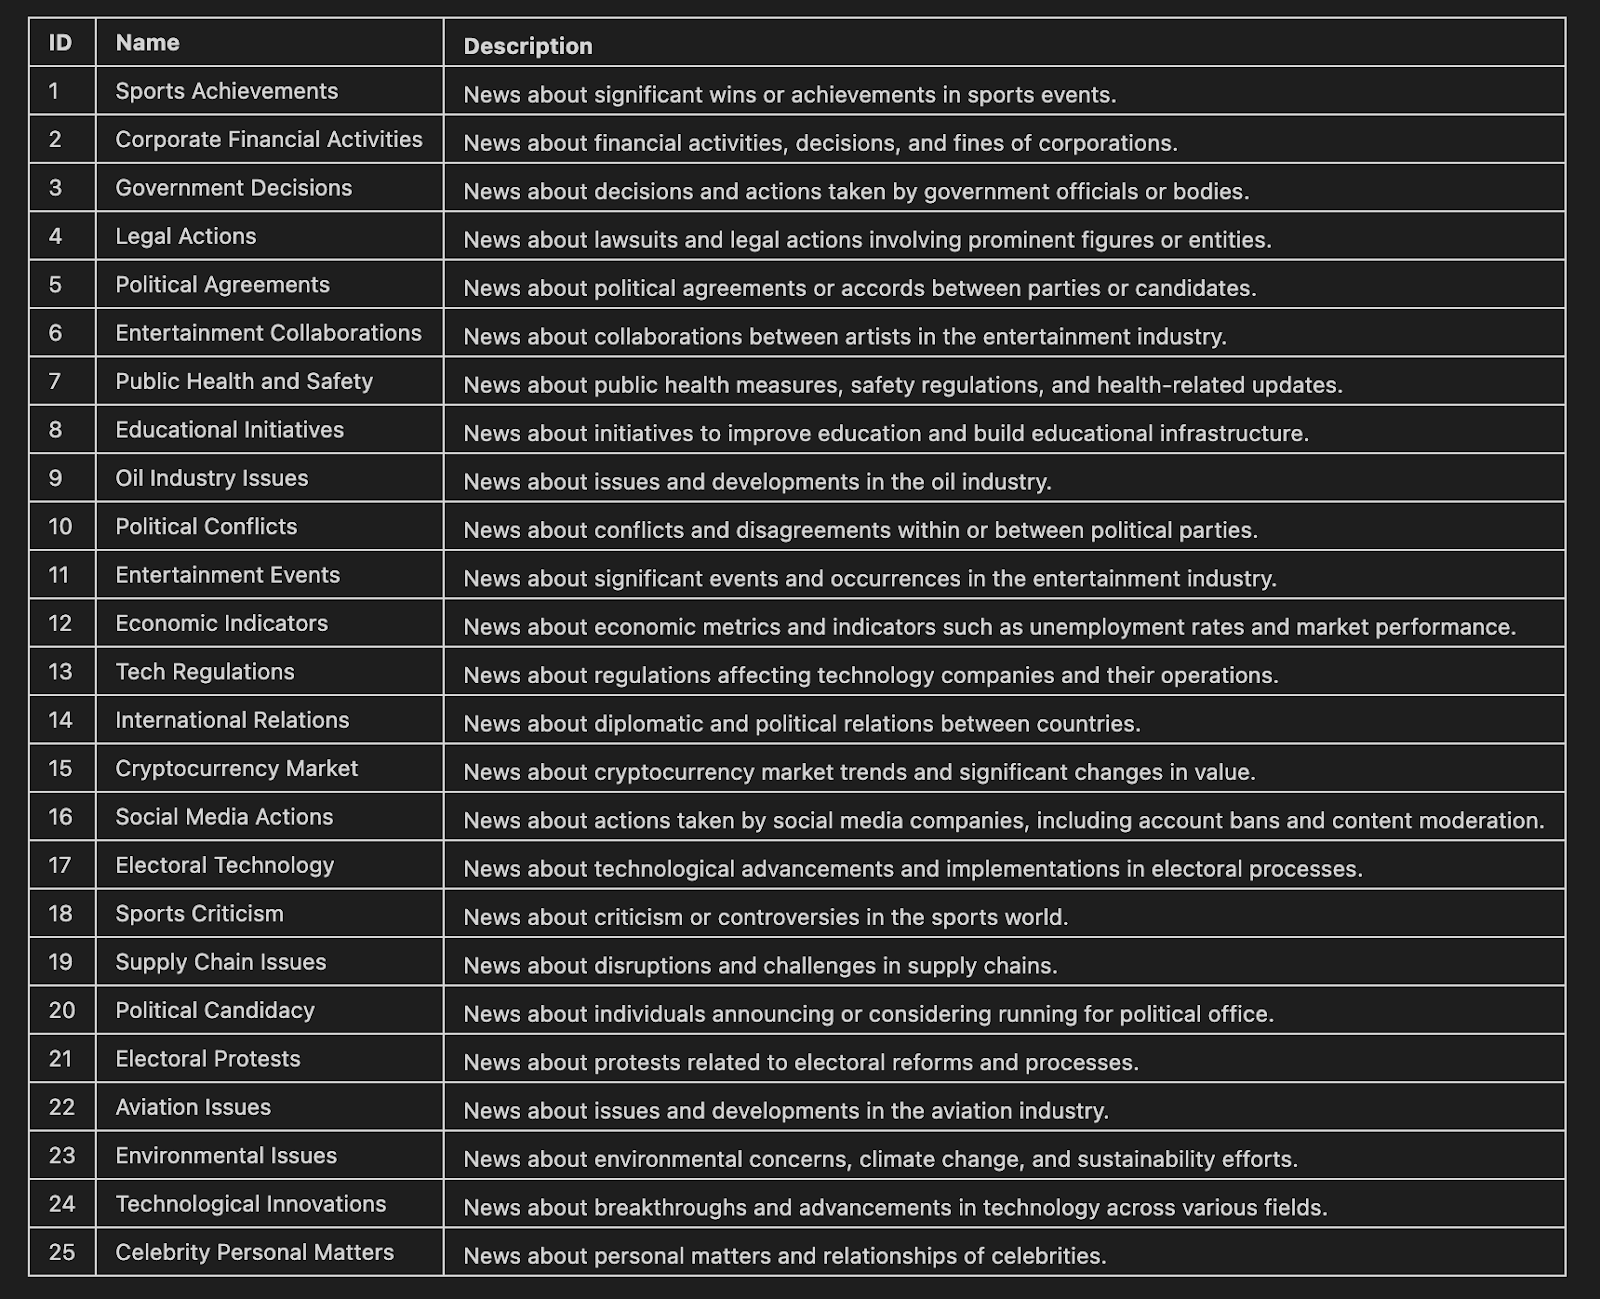
Selesai! Dengan mengikuti langkah-langkah terstruktur ini, TNT-LLM mengotomatisasi pembuatan taksonomi yang terperinci dan mudah diinterpretasikan dari data teks mentah. Pendekatan ini menyederhanakan proses yang secara tradisional membutuhkan banyak upaya manusia dan keahlian domain, menjadikannya alat yang kuat untuk tugas penambangan dan klasifikasi teks skala besar.
TNT-LLM mewakili langkah maju yang signifikan dalam penambangan dan klasifikasi teks, menawarkan solusi efisien untuk menganalisis volume besar data tidak terstruktur. Dengan mengotomatiskan pembuatan taksonomi dan klasifikasi yang dapat diskalakan, alat ini mengurangi waktu dan upaya untuk menggali wawasan dari teks.
Seiring TNT-LLM berkembang, ia berpotensi mentransformasi cara organisasi menganalisis data teks dalam jumlah besar. Alat ini memungkinkan pengambilan keputusan berbasis data di berbagai industri, membuat wawasan dari data tekstual lebih mudah diakses dan berdampak.
Jika Anda ingin mempelajari lebih lanjut tentang pengembangan aplikasi LLM, saya merekomendasikan kursus ini tentang Mengembangkan Aplikasi LLM dengan LangChain.
Belajar AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



