Kurs
Multi-Agent Systems mit LangGraph
2 Std. 45 Min.
8.4K
TNT-LLM (Taxonomy and Text classification using Large Language Models) ist ein zweiphasiges Framework zur Generierung und Klassifikation von Taxonomien aus Textdokumenten. Das System umfasst zwei Hauptphasen.
In der ersten Phase erhält das System eine Stichprobe von Textdokumenten und eine spezifische Aufgabeninstruktion, etwa "Erzeuge eine Taxonomie zum Clustern von Nachrichtenartikeln". Ein großes Sprachmodell (LLM) fasst jeden Artikel zusammen und extrahiert die Kernaussagen. Über einen iterativen Prozess erzeugt, aktualisiert und verfeinert das LLM eine Taxonomie auf Basis dieser Zusammenfassungen und liefert am Ende eine strukturierte Menge an Labels und Beschreibungen, die die Artikel wirksam kategorisiert.
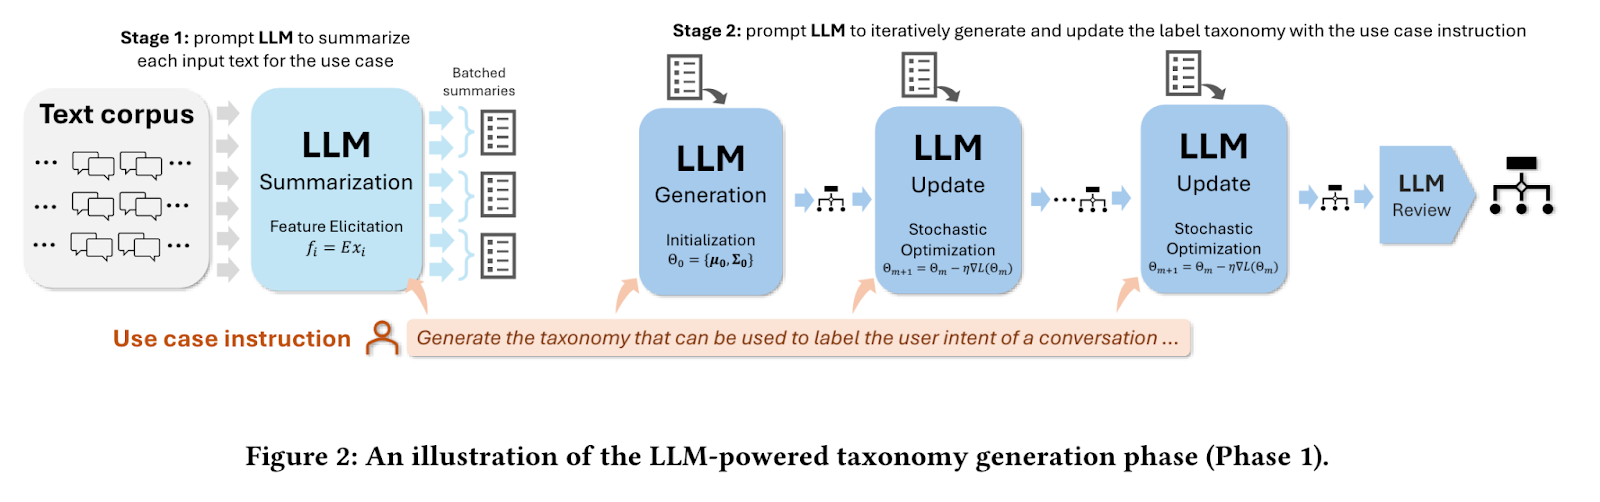
Quelle: Mengting Wan et al.
In der zweiten Phase wird die erzeugte Taxonomie genutzt, um einen größeren Datensatz zu labeln. Ein LLM wird dazu aufgefordert, diese Labels anzuwenden; die resultierenden Labels dienen anschließend als Trainingsdaten für einen schlanken Klassifikator wie z. B. logistische Regression. Nach dem Training kann dieser Klassifikator das gesamte Korpus effizient labeln oder Echtzeitklassifikation durchführen.
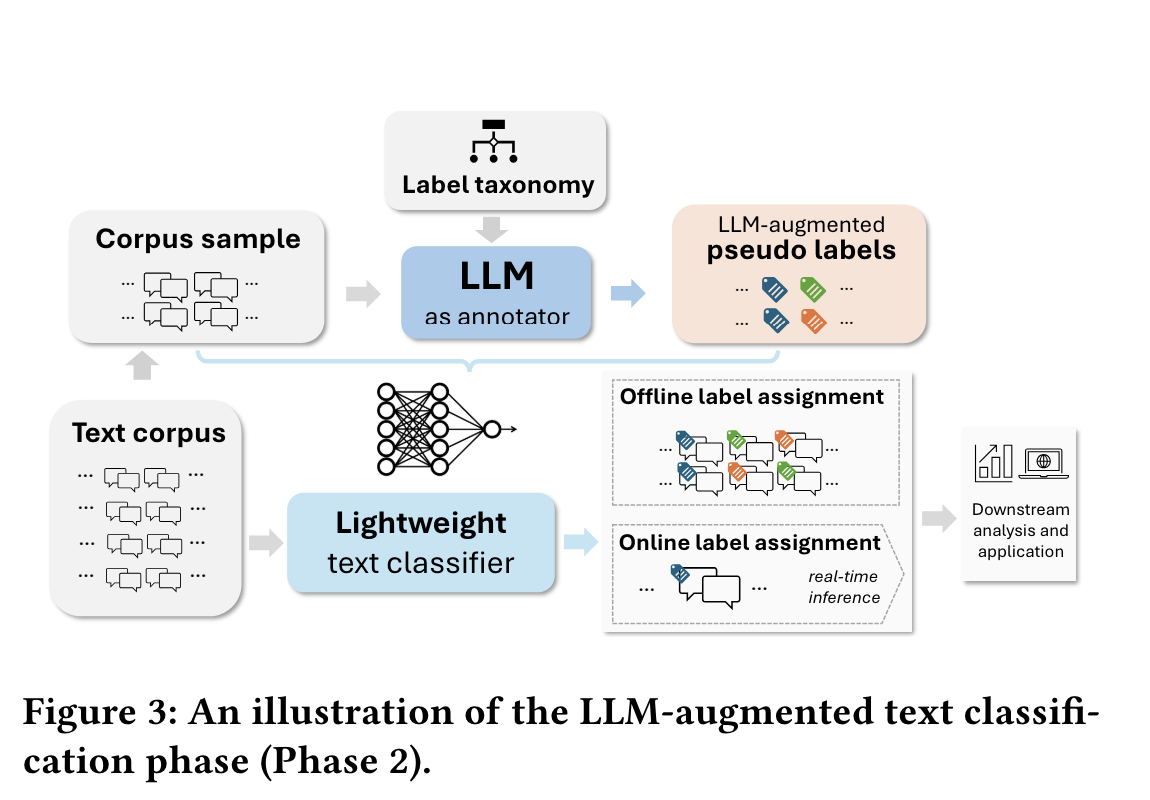
Quelle: Mengting Wan et al.
Die Flexibilität von TNT-LLM macht es für verschiedenste Textklassifikationsaufgaben einsetzbar – von Intent-Erkennung bis Themenklassifizierung – und damit weit über reine Konversationsanalyse hinaus.
TNT-LLM ist ein starkes Werkzeug für Text Mining und Klassifikation im großen Stil und bietet mehrere zentrale Vorteile.
TNT-LLM vereinfacht die Erstellung detaillierter, gut interpretierbarer Taxonomien aus Rohtexten. Damit wird eine sonst arbeitsintensive Aufgabe automatisiert, die häufig Domänenexpertise erfordert. Das System erzeugt maßgeschneiderte Taxonomien für spezifische Use Cases mit minimalem Input – und spart so Zeit und Ressourcen.
Auf Basis der erzeugten Taxonomien ermöglicht TNT-LLM eine skalierbare Textklassifikation. Es entstehen leichte Modelle, die große Datensätze oder Echtzeitklassifikation effizient bewältigen – ideal für Anwendungen mit hohen Durchsatzanforderungen.
TNT-LLM optimiert den Ressourceneinsatz durch gestufte LLM-Nutzung. Für die Taxonomieerstellung kommen leistungsstarke Modelle wie GPT-4 zum Einsatz, während für Zusammenfassungen günstigere Optionen wie GPT-3.5-Turbo genügen. Die finale Klassifikation übernimmt ein effizienter Logit-Regressionsansatz, was die Betriebskosten weiter senkt.
Der iterative Prozess der Taxonomieerstellung sorgt für laufende Verfeinerung – mit hochwertigen, relevanten und präzisen Kategorisierungen, die auf Datensatz und Use Case zugeschnitten sind.
Trotz der Möglichkeit zur menschlichen Überprüfung und Anpassung benötigt TNT-LLM deutlich weniger manuelle Eingriffe als traditionelle Verfahren. Das reduziert potenzielle Verzerrungen und Inkonsistenzen bei der Taxonomieerstellung.
TNT-LLM passt sich an verschiedene Aufgaben und Domänen der Textklassifikation an und lässt sich vielseitig einsetzen. Das modulare Design unterstützt die Integration unterschiedlicher LLMs, Embedding-Methoden und Klassifikatoren nach Bedarf.
Unterm Strich bietet TNT-LLM eine robuste Lösung für Organisationen, die große Mengen unstrukturierter Textdaten verarbeiten.
Gehen wir den Implementierungsprozess Schritt für Schritt durch.
Um mit TNT-LLM loszulegen, installierst du zunächst die benötigten Pakete. Das geht mit folgendem pip-Befehl:
pip install langgraph langchain langchain_openaiRichte außerdem deine Umgebungsvariablen für API-Schlüssel und Modellnamen ein:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Im Kontext von TNT-LLM sind ein paar Grundlagen entscheidend, um die Funktionen effektiv zu nutzen.
Dokumente in TNT-LLM sind Rohtexte wie Chatprotokolle oder Artikel, die verarbeitet werden sollen. Sie sind die primären Eingaben der TNT-LLM-Pipeline. Jedes Dokument wird über die Klasse Doc strukturiert, mit Feldern wie id, content und optional summary, explanation und category.
Taxonomien sind Cluster kategorisierter Intents oder Themen. Sie ordnen Daten in sinnvolle Kategorien – essenziell für Aufgaben wie Intent-Erkennung und Themenklassifizierung. Die Klasse TaxonomyGenerationState definiert die Zustandsstruktur für die Taxonomieerstellung. Sie umfasst Rohdokumente, Minibatch-Indizes und Cluster der Kandidatentaxonomien.
Ein solides Verständnis der Grundlagen ist entscheidend, um TNT-LLM wirksam einzusetzen. Der Prozess zur Taxonomieerstellung umfasst mehrere Schritte:
Zunächst definieren wir die Graph-State-Klasse TaxonomyGenerationState, die die Zustände der Taxonomieerstellung und -weiterentwicklung während der Graphausführung verwaltet. Die Klasse Doc legt die Struktur einzelner Dokumente im Graphen fest.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
    id: str
    content: str
    summary: Optional[str]
    explanation: Optional[str]
    category: Optional[str]
class TaxonomyGenerationState(TypedDict):
    # The raw docs; we inject summaries within them in the first step
    documents: List[Doc]
    # Indices to be concise
    minibatches: List[List[int]]
    # Candidate Taxonomies (full trajectory)
    clusters: Annotated[List[List[dict]], operator.add]
Bevor wir mit der Taxonomieerstellung beginnen, laden wir die Datensätze mit Rohtexten, etwa Nachrichtenartikel oder Chatlogs. Diese dienen als Primäreingabe für TNT-LLM. Hier laden wir Nachrichtenartikel von Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
    all_data = []
    for i in range(len(df)):
        d = df.iloc[i]
        all_data.append({
            "id": i,
            "content": d['Title'] + "\\n\\n" + d['Excerpt']
        })

    return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0])
{'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Zum Schluss initialisieren wir ein Azure-basiertes OpenAI GPT-4o-Modell als zentrales Sprachmodell (LLM) für alle TNT-LLM-Komponenten. In der Praxis können einzelne Komponenten mit unterschiedlichen LLMs laufen; hier vereinfachen wir und nutzen ein einziges Modell für alle Aufgaben.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
    openai_api_version="2023-06-01-preview"
    azure_deployment="gpt-4o-2024-05-13",
    temperature=0.0
)Nachdem die Datensätze geladen sind, wird jedes Dokument zusammengefasst. Sprachmodelle erstellen prägnante Summaries, die die Hauptpunkte erfassen. Diese Zusammenfassungen destillieren lange Texte in handliche Formate, ohne wichtige Informationen zu verlieren.
Der bereitgestellte Code initialisiert einen LLM-Prompt für Dokumentzusammenfassungen mit TNT-LLM, parst XML-Ausgaben, um Summary und Erklärung zu extrahieren, und baut eine Pipeline auf, die Inhalte in Batches verarbeitet. Die erzeugten Summaries werden per Mapping- und Reduktionsschritt zurück in die ursprüngliche Datenstruktur der Dokumente integriert.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
    summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
    summary_pattern = r"<summary>(.*?)</summary>"
    explanation_pattern = r"<explanation>(.*?)</explanation>"
    summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
    explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
    summary = summary_match.group(1).strip() if summary_match else ""
    explanation = explanation_match.group(1).strip() if explanation_match else ""
    return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
    summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
    docs = state["documents"]
    return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
    summaries=get_content
    | RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
    summaries = combined["summaries"]
    documents = combined["documents"]
    return {
        "documents": [
            {
                "id": doc["id"],
                "content": doc["content"],
                "summary": summ_info["summary"],
                "explanation": summ_info["explanation"],
            }
            for doc, summ_info in zip(documents, summaries)
        ]
    }
# This is the summary node
map_reduce_chain = map_step | reduce_summariesNach der Zusammenfassung werden die Dokumente in Minibatches organisiert. Minibatching erleichtert die Verarbeitung großer Datenmengen. Durch Aufteilung in kleinere Batches kann TNT-LLM Berechnungen parallelisieren und so Zeit und Rechenressourcen optimieren.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    if len(indices) < batch_size:
        # Don't pad needlessly if we can't fill a single batch
        return [indices]
    num_full_batches = len(indices) // batch_size
    batches = [
        indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
    ]
    leftovers = len(indices) % batch_size
    if leftovers:
        last_batch = indices[num_full_batches * batch_size :]
        elements_to_add = batch_size - leftovers
        last_batch += random.sample(indices, elements_to_add)
        batches.append(last_batch)
    return {
        "minibatches": batches,
}Mit dem ersten Minibatch zusammengefasster Dokumente startet TNT-LLM die Taxonomieerstellung. Dabei werden erkannte Intents oder Themen geclustert. Durch Inhaltsanalyse identifiziert das System gemeinsame Motive oder Kategorien und legt damit das Fundament der initialen Taxonomie.
Die zwei zentralen Funktionen sind:
invoke_taxonomy_chain() – Diese Funktion integriert die Schritte der Taxonomieerstellung über eine LLM-basierte Chain (chain), bildet XML-Datentabellen (data_table_xml) aus Dokumentzusammenfassungen und vorherigen Taxonomieclustern und ruft die Chain mit den Konfigurationsparametern (config) auf. Das Ergebnis ist ein aktualisierter Zustand mit neuen Clustern.generate_taxonomy() – Diese Funktion orchestriert die Generierung der Cluster. Sie ruft invoke_taxonomy_chain mit der für die Taxonomieerstellung konfigurierten Chain (generate_taxonomy_chain) und dem ersten Minibatch (state["minibatches"][0]) auf und gibt den aktualisierten Taxonomiestatus zurück.from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Schauen wir uns an, wie das Sprachmodell in die Taxonomieerstellung eingebunden wird:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
    use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
    taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    return invoke_taxonomy_chain(
        generate_taxonomy_chain, state, config, state["minibatches"][0]
)Mit den folgenden Minibatches wird die Taxonomie iterativ aktualisiert und verfeinert. So entwickelt sie sich im Zeitverlauf weiter, nimmt neue Einsichten und Kategorien auf und deckt den gesamten Datensatz besser ab. Die Updates stellen sicher, dass die Taxonomie umfassend bleibt.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
    taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    which_mb = len(state["clusters"]) % len(state["minibatches"])
    return invoke_taxonomy_chain(
        update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Wenn alle Minibatches verarbeitet sind und die Taxonomie aktualisiert wurde, folgt die Überprüfung. Sie ist wichtig, um die Genauigkeit und Relevanz der Labels zu validieren und sicherzustellen, dass die Taxonomie den Datensatz sinnvoll strukturiert – passend zum Use Case wie Intent-Erkennung oder Themenklassifizierung.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
    taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
    state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
    batch_size = config["configurable"].get("batch_size", 200)
    original = state["documents"]
    indices = list(range(len(original)))
    random.shuffle(indices)
    return invoke_taxonomy_chain(
        review_taxonomy_chain, state, config, indices[:batch_size]
)Bisher haben wir die Bausteine vorbereitet: Zusammenfassung, Minibatches, Taxonomieerstellung, -aktualisierung und -prüfung. Jetzt integrieren wir diese Komponenten zu einer durchgängigen TNT-LLM-Pipeline mit dem StateGraph-Framework.
Der Graph steuert die Abfolge: Dokumente zusammenfassen, Taxonomien aus Minibatches generieren, iterativ aktualisieren und schließlich prüfen und validieren. Bedingte Kanten sorgen dafür, dass Updates solange erfolgen, bis alle Minibatches verarbeitet sind. Anschließend wird die finale Taxonomie für die Labeling-Aufgaben freigegeben.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
    num_minibatches = len(state["minibatches"])
    num_revisions = len(state["clusters"])
    if num_revisions < num_minibatches:
        return "update_taxonomy"
    return "review_taxonomy"
graph.add_conditional_edges(
    "update_taxonomy",
    should_review,
    # Optional (but required for the diagram to be drawn correctly below)
    {"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()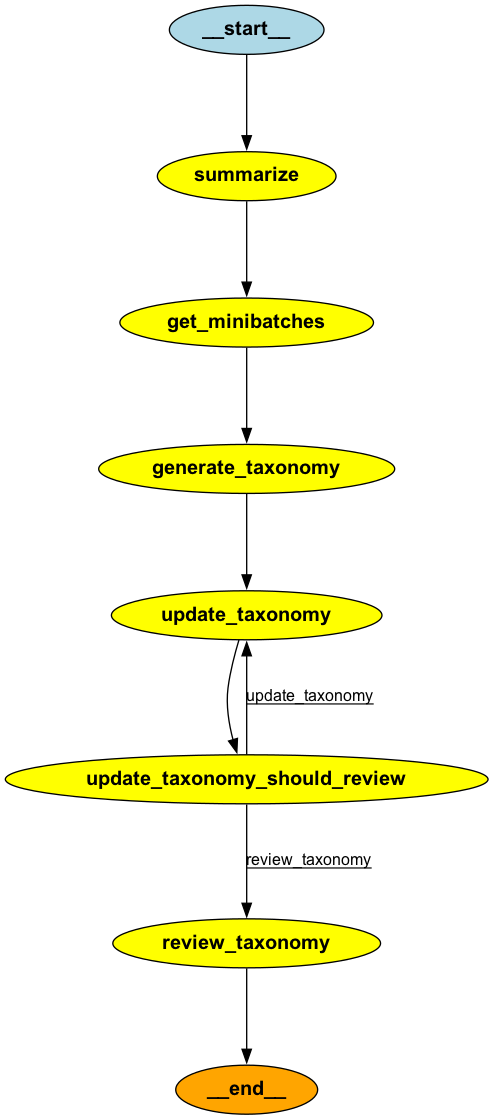
Im letzten Schritt nutzen wir TNT-LLM zum Clustern von Nachrichtenartikeln. Die resultierende Taxonomie wird in Markdown dargestellt und zeigt Namen und Beschreibungen der einzelnen Cluster.
use_case = (
    "Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
    {"documents": docs},
    {
        "configurable": {
            "use_case": use_case,
            # Optional:
            "batch_size": 10,
            "suggestion_length": 30,
            "cluster_name_length": 10,
            "cluster_description_length": 30,
            "explanation_length": 20,
            "max_num_clusters": 25,
        },
        "max_concurrency": 2,
        "recursion_limit": 50,
    },
)
for step in stream:
    node, state = next(iter(step.items()))
    print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
    md = "## Final Taxonomy\\n\\n"
    md += "| ID | Name | Description |\\n"
    md += "|----|------|-------------|\\n"
    # Iterate over each inner list of dictionaries
    for cluster_list in clusters:
        for label in cluster_list:
            id = label["id"]
            name = label["name"].replace("|", "\\\\|")  # Escape any pipe characters within the content
            description = label["description"].replace("|", "\\\\|")  # Escape any pipe characters
            md += f"| {id} | {name} | {description} |\\n"
    return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)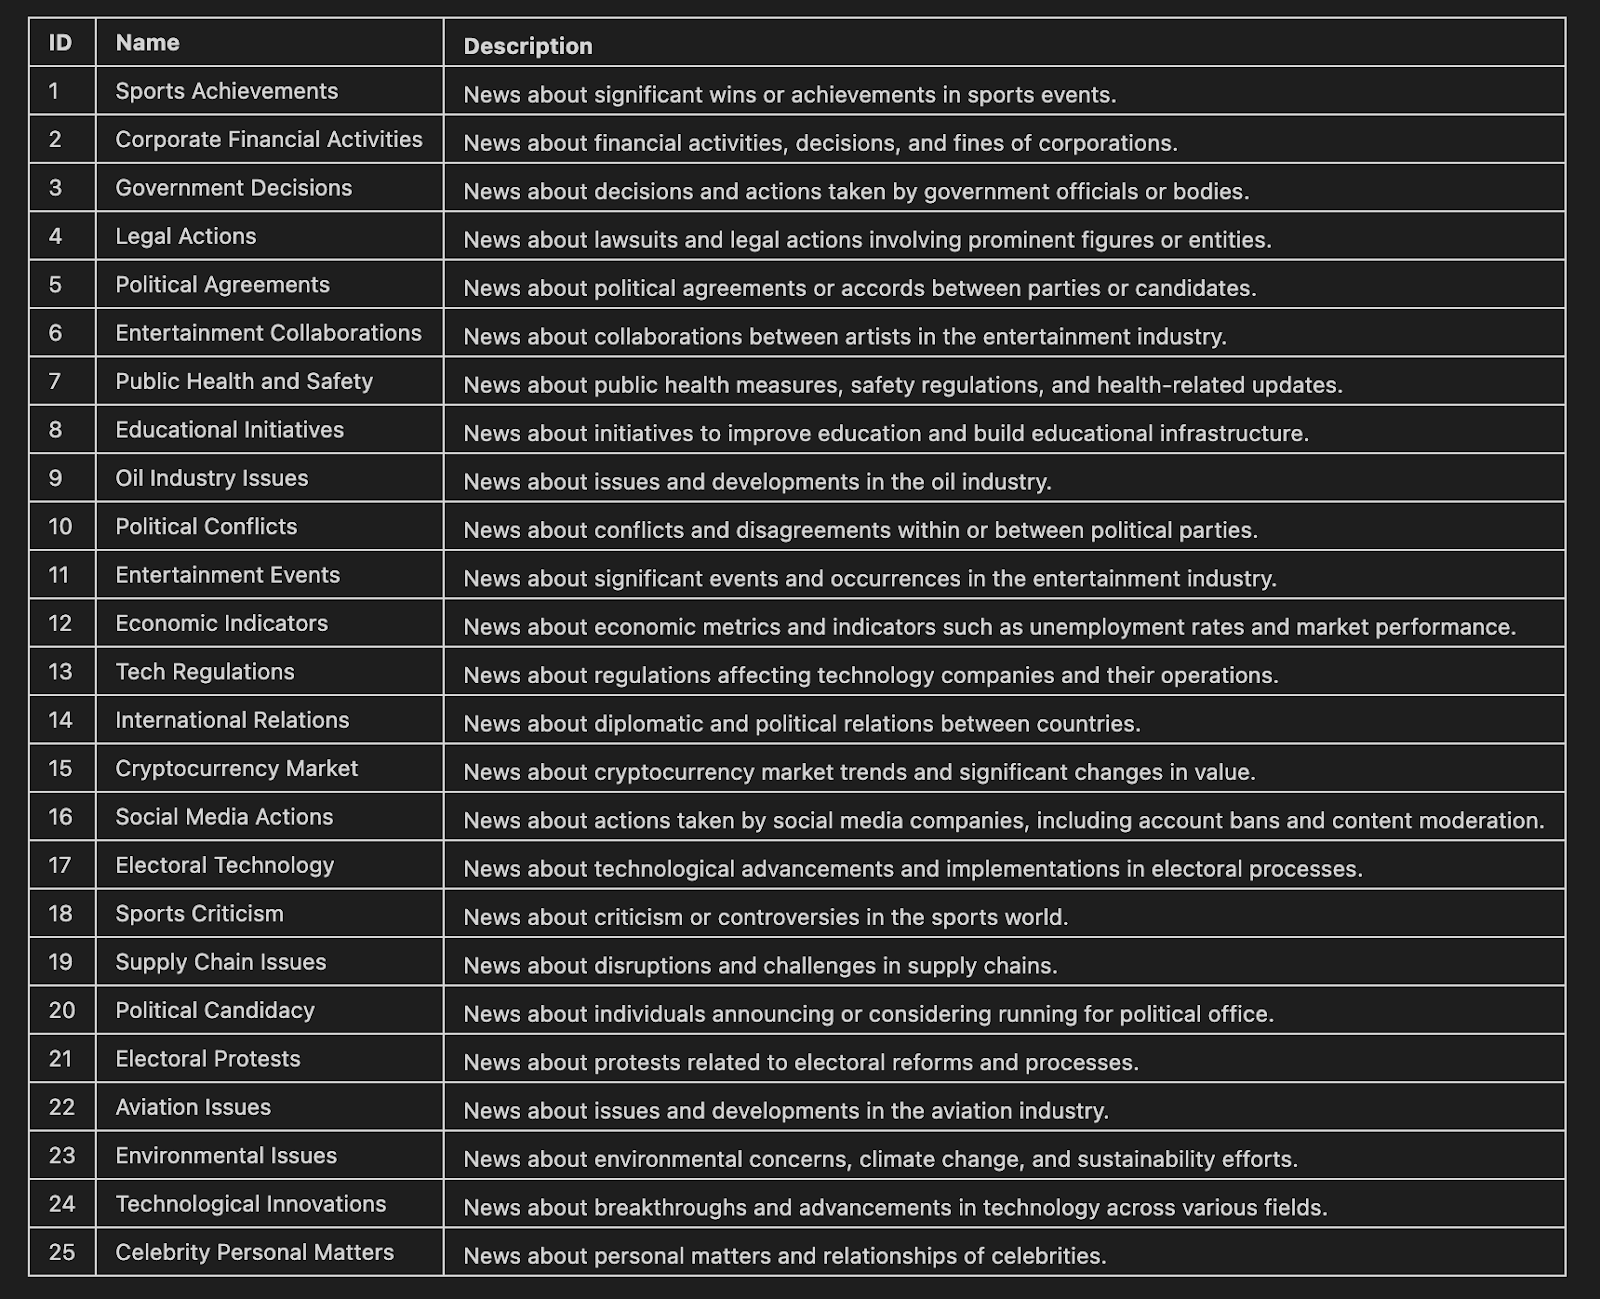
Und fertig! Mit diesen strukturierten Schritten automatisiert TNT-LLM die Erstellung detaillierter, gut interpretierbarer Taxonomien aus Rohtexten. Ein Ansatz, der sonst viel menschlichen Aufwand und Domänenwissen erfordert – und der Text Mining sowie Klassifikation im großen Stil deutlich vereinfacht.
TNT-LLM ist ein großer Fortschritt für Text Mining und Klassifikation und bietet eine effiziente Lösung zur Analyse großer Mengen unstrukturierter Daten. Durch automatisierte Taxonomieerstellung und skalierbare Klassifikation sinken Zeit- und Arbeitsaufwand, um aus Texten Insights zu gewinnen.
Mit der Weiterentwicklung von TNT-LLM hat das Tool das Potenzial, die Textanalyse in Unternehmen grundlegend zu verändern. Es ermöglicht datenbasierte Entscheidungen in vielen Branchen und macht Erkenntnisse aus Textdaten zugänglicher und wirkungsvoller.
Wenn du mehr über die Entwicklung von LLM-Anwendungen lernen willst, empfehle ich diesen Kurs: Developing LLM Applications with LangChain.
Lerne KI mit diesen Kursen!
Kurs
Kurs
Kurs