

Che cos'è TNT-LLM?
TNT-LLM (Taxonomy and Text classification using Large Language Models) è un framework in due fasi sviluppato per generare e classificare tassonomie a partire da documenti di testo. Il sistema prevede due fasi principali.
Fase 1: Generazione della tassonomia
Nella prima fase, il sistema prende un campione di documenti di testo e un'istruzione relativa al caso d'uso, ad esempio "genera una tassonomia per raggruppare articoli di news". Utilizza un large language model (LLM) per riassumere ogni articolo, estraendone le informazioni chiave. Attraverso un processo iterativo, l'LLM genera, aggiorna e perfeziona una tassonomia basata su questi riassunti, producendo infine un insieme strutturato di etichette e descrizioni che categorizzano efficacemente gli articoli.
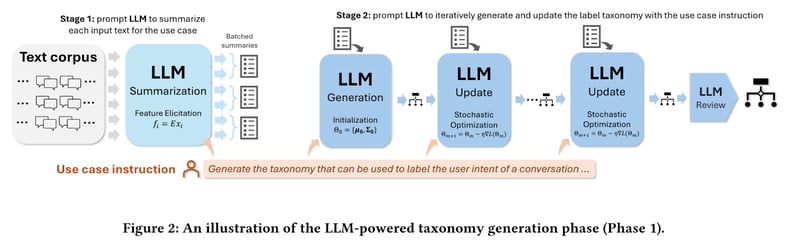
Fonte: Mengting Wan et al.
Fase 2: Classificazione del testo
La seconda fase prevede l'uso della tassonomia generata per etichettare un dataset più ampio. Il sistema chiede a un LLM di applicare queste etichette, che poi fungono da dati di addestramento per un classificatore leggero, come la regressione logistica. Una volta addestrato, questo classificatore può essere distribuito per etichettare in modo efficiente l'intero corpus o effettuare classificazione in tempo reale.
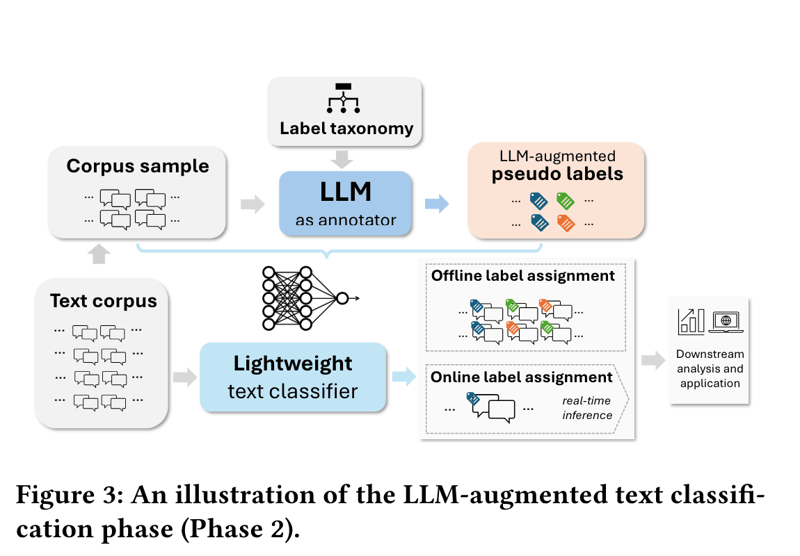
Fonte: Mengting Wan et al.
La flessibilità di TNT-LLM lo rende applicabile a vari compiti di classificazione del testo, tra cui il rilevamento dell'intento e la categorizzazione degli argomenti, estendendo la sua utilità oltre la sola analisi delle conversazioni.
Vantaggi di TNT-LLM
TNT-LLM si distingue come uno strumento potente per il text mining e la classificazione su larga scala, offrendo diversi vantaggi chiave.
Generazione automatizzata della tassonomia
TNT-LLM semplifica la creazione di tassonomie dettagliate e interpretabili a partire da dati testuali grezzi. Questo processo ha automatizzato un'attività laboriosa che spesso richiede competenze di dominio. Il sistema genera tassonomie su misura per casi d'uso specifici con un input umano minimo, risparmiando tempo e risorse considerevoli.
Classificazione scalabile
Usando le tassonomie generate, TNT-LLM abilita una classificazione del testo scalabile. Consente di creare modelli leggeri che possono gestire dataset di grandi dimensioni o attività di classificazione in tempo reale in modo efficiente, rendendolo ideale per applicazioni con elevati requisiti di throughput.
Approccio conveniente
TNT-LLM ottimizza l'uso delle risorse sfruttando un impiego a livelli degli LLM. Utilizza modelli potenti come GPT-4 per la generazione della tassonomia e opzioni più economiche come GPT-3.5-Turbo per i compiti di sintesi. La classificazione finale è eseguita da un efficiente modello di regressione logistica, riducendo ulteriormente i costi operativi.
Output di alta qualità
Il processo iterativo di generazione della tassonomia in TNT-LLM assicura un raffinamento continuo, producendo categorizzazioni di alta qualità, pertinenti e accurate, adattate a specifici dataset e casi d'uso.
Intervento umano minimo
Pur consentendo revisione e aggiustamenti umani, TNT-LLM richiede un input manuale minimo rispetto ai metodi tradizionali. Questo riduce potenziali bias e incoerenze nella creazione della tassonomia.
Flessibilità
TNT-LLM si adatta bene a vari compiti e domini di classificazione del testo, offrendo versatilità d'uso. Il suo design modulare supporta l'integrazione con diversi LLM, metodi di embedding e classificatori a seconda delle necessità.
Nel complesso, TNT-LLM fornisce una soluzione robusta per le organizzazioni che gestiscono grandi quantità di dati testuali non strutturati.
Implementazione di TNT-LLM
Vediamo il processo di implementazione passo dopo passo.
Installazione
Per iniziare con le implementazioni di TNT-LLM, devi installare i pacchetti necessari. Puoi farlo con il seguente comando pip:
pip install langgraph langchain langchain_openaiInoltre, imposta le variabili d'ambiente per le chiavi API e i nomi dei modelli:
export AZURE_OPENAI_API_KEY='your_api_key_here' export AZURE_OPENAI_MODEL='your_deployment_name_here' export AZURE_OPENAI_ENDPOINT='deployment_endpoint'Concetti di base
Nel contesto di TNT-LLM, comprendere alcuni concetti fondamentali è cruciale per sfruttarne efficacemente le capacità.
Documenti
In TNT-LLM, per documenti si intendono i dati testuali grezzi, come log di chat o articoli, che devono essere elaborati. Questi sono gli input principali della pipeline TNT-LLM. Ogni documento è strutturato tramite la classe Doc, che include campi come id, content e attributi opzionali come summary, explanation e category.
Tassonomie
Le tassonomie sono insiemi di intenti o argomenti categorizzati. Organizzano i dati in categorie significative, essenziali per compiti come il riconoscimento dell'intento e la classificazione degli argomenti. La classe TaxonomyGenerationState definisce la struttura dello stato per la generazione della tassonomia. Questa classe include documenti grezzi, indici dei minibatch e raggruppamenti di tassonomie candidate.
Costruire una semplice applicazione TNT-LLM
Comprendere gli aspetti fondamentali di TNT-LLM è cruciale per implementarne efficacemente le funzionalità. Per iniziare con TNT-LLM, il processo di generazione della tassonomia prevede diversi passaggi chiave:
Passo 0: Definire la classe di stato del grafo, caricare i dataset e GPT-4o
Per prima cosa, dobbiamo definire la classe di stato del grafo TaxonomyGenerationState, che gestisce gli aspetti a stato della generazione ed evoluzione della tassonomia durante l'esecuzione del grafo. La classe Doc definisce la struttura dei singoli documenti all'interno del grafo.
import operator
from typing import Annotated, List, TypedDict, Optional
class Doc(TypedDict):
id: str
content: str
summary: Optional[str]
explanation: Optional[str]
category: Optional[str]
class TaxonomyGenerationState(TypedDict):
# The raw docs; we inject summaries within them in the first step
documents: List[Doc]
# Indices to be concise
minibatches: List[List[int]]
# Candidate Taxonomies (full trajectory)
clusters: Annotated[List[List[dict]], operator.add]Prima di iniziare il processo di generazione della tassonomia, dobbiamo caricare i dataset contenenti dati testuali grezzi, come articoli di news o log di chat. Questi dataset fungono da input principale per TNT-LLM. Qui stiamo caricando articoli di news da Hugging Face.
import pandas as pd
from datasets import load_dataset
# Load the dataset
dataset = load_dataset("okite97/news-data")
# Access the different splits if available (e.g., train, test, validation)
train_data = dataset['train']
df = pd.DataFrame(train_data)
df = df.dropna()
df.reset_index(drop=True, inplace=True)
def run_to_doc(df: pd.DataFrame) -> Doc:
all_data = []
for i in range(len(df)):
d = df.iloc[i]
all_data.append({
"id": i,
"content": d['Title'] + "\\n\\n" + d['Excerpt']
})
return all_data
# Only clustering 100 documents
docs = run_to_doc(df[:100])
print(docs[0]){'id': 0,
'content': 'Uefa Opens Proceedings against Barcelona, Juventus and Real Madrid Over European Super League Plan\\n\\nUefa has opened disciplinary proceedings against Barcelona, Juventus and Real Madrid over their involvement in the proposed European Super League.'}Infine, inizializziamo un modello OpenAI GPT-4o basato su Azure da usare come nostro language model (LLM) in tutti i componenti di TNT-LLM. Sebbene in pratica si possano inizializzare LLM diversi per ciascun componente, qui semplifichiamo usando un unico modello per tutti i compiti.
import os
from langchain_openai import AzureChatOpenAI
model = AzureChatOpenAI(
openai_api_version="2023-06-01-preview"
azure_deployment="gpt-4o-2024-05-13",
temperature=0.0
)Passo 1: Riassumere i documenti
Una volta caricati i dataset, ogni documento viene sottoposto a sintesi. Questo passaggio prevede l'uso di modelli linguistici per generare riassunti concisi che catturino i punti principali di ciascun documento. I riassunti sono cruciali perché distillano testi lunghi in forme più brevi e gestibili, mantenendo al contempo le informazioni essenziali.
Il codice fornito inizializza un prompt LLM per riassumere i documenti usando TNT-LLM, analizzando l'output XML per estrarre riassunti e spiegazioni. Imposta una pipeline per mappare il contenuto dei documenti, elaborarlo in batch per la generazione dei riassunti e integrare questi riassunti nella struttura dati originale dei documenti tramite passaggi di mapping e reduction.
import re
import random
from langchain import hub
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableConfig, RunnableLambda, RunnablePassthrough
summary_prompt = hub.pull("wfh/tnt-llm-summary-generation").partial(
summary_length=20, explanation_length=30
)
def parse_summary(xml_string: str) -> dict:
summary_pattern = r"<summary>(.*?)</summary>"
explanation_pattern = r"<explanation>(.*?)</explanation>"
summary_match = re.search(summary_pattern, xml_string, re.DOTALL)
explanation_match = re.search(explanation_pattern, xml_string, re.DOTALL)
summary = summary_match.group(1).strip() if summary_match else ""
explanation = explanation_match.group(1).strip() if explanation_match else ""
return {"summary": summary, "explanation": explanation}
summary_llm_chain = (
summary_prompt | model | StrOutputParser()
).with_config(run_name="GenerateSummary")
summary_chain = summary_llm_chain | parse_summary
# Input: state
# Output: state and summaries
# Processes docs in parallel
def get_content(state: TaxonomyGenerationState):
docs = state["documents"]
return [{"content": doc["content"]} for doc in docs]
map_step = RunnablePassthrough.assign(
summaries=get_content
| RunnableLambda(func=summary_chain.batch, afunc=summary_chain.abatch)
)
def reduce_summaries(combined: dict) -> TaxonomyGenerationState:
summaries = combined["summaries"]
documents = combined["documents"]
return {
"documents": [
{
"id": doc["id"],
"content": doc["content"],
"summary": summ_info["summary"],
"explanation": summ_info["explanation"],
}
for doc, summ_info in zip(documents, summaries)
]
}
# This is the summary node
map_reduce_chain = map_step | reduce_summariesPasso 2: Creare i minibatch
Dopo la sintesi, il passo successivo è organizzare i documenti riassunti in minibatch. Il minibatching aiuta a elaborare grandi volumi di dati in modo più efficiente. Suddividendo il dataset in batch più piccoli, TNT-LLM può gestire i calcoli in parallelo, ottimizzando sia il tempo che le risorse computazionali.
def get_minibatches(state: TaxonomyGenerationState, config: RunnableConfig):
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
if len(indices) < batch_size:
# Don't pad needlessly if we can't fill a single batch
return [indices]
num_full_batches = len(indices) // batch_size
batches = [
indices[i * batch_size : (i + 1) * batch_size] for i in range(num_full_batches)
]
leftovers = len(indices) % batch_size
if leftovers:
last_batch = indices[num_full_batches * batch_size :]
elements_to_add = batch_size - leftovers
last_batch += random.sample(indices, elements_to_add)
batches.append(last_batch)
return {
"minibatches": batches,
}Passo 3: Generare la tassonomia iniziale
Usando il primo minibatch di documenti riassunti, TNT-LLM avvia il processo di generazione della tassonomia. Questo passaggio prevede il clustering degli intenti o degli argomenti identificati nei documenti. Analizzando il contenuto di ciascun documento, il sistema individua temi o categorie comuni, gettando le basi iniziali della tassonomia.
Le due funzioni principali sono:
invoke_taxonomy_chain()- Questa funzione integra i passaggi di generazione della tassonomia usando una catena basata su LLM (chain) configurata per i compiti di TNT-LLM. Costruisce tabelle di dati in XML (data_table_xml) a partire dai riassunti dei documenti e dai precedenti cluster di tassonomia. La funzione invoca la catena LLM per aggiornare la tassonomia in base ai parametri di configurazione specificati (config), restituendo uno stato aggiornato con i nuovi cluster di tassonomia.generate_taxonomy()- Questa funzione orchestra la generazione dei cluster della tassonomia. Invocainvoke_taxonomy_chaincon una catena configurata per la generazione della tassonomia (generate_taxonomy_chain) usando il minibatch iniziale di documenti (state["minibatches"][0]). Restituisce lo stato della tassonomia aggiornato dopo il processo di generazione iniziale.
from typing import Dict
from langchain_core.runnables import Runnable
def parse_taxa(output_text: str) -> Dict:
"""Extract the taxonomy from the generated output."""
cluster_pattern = r"<cluster>\\s*<id>(.*?)</id>\\s*<name>(.*?)</name>\\s*<description>(.*?)</description>\\s*</cluster>"
cluster_matches = re.findall(cluster_pattern, output_text, re.DOTALL)
clusters = [
{"id": id.strip(), "name": name.strip(), "description": description.strip()}
for id, name, description in cluster_matches
]
return {"clusters": clusters}
def format_docs(docs: List[Doc]) -> str:
xml_table = "\\n"
for doc in docs:
xml_table += f'{doc["summary"]}\\n'
xml_table += ""
return xml_table
def format_taxonomy(clusters):
xml = "\\n"
for label in clusters:
xml += " \\n"
xml += f' {label["id"]}\\n'
xml += f' {label["name"]}\\n'
xml += f' {label["description"]}\\n'
xml += " \\n"
xml += ""
return xml
def invoke_taxonomy_chain(
chain: Runnable,
state: TaxonomyGenerationState,
config: RunnableConfig,
mb_indices: List[int],
) -> TaxonomyGenerationState:
configurable = config["configurable"]
docs = state["documents"]
minibatch = [docs[idx] for idx in mb_indices]
data_table_xml = format_docs(minibatch)
previous_taxonomy = state["clusters"][-1] if state["clusters"] else []
cluster_table_xml = format_taxonomy(previous_taxonomy)
updated_taxonomy = chain.invoke(
{
"data_xml": data_table_xml,
"use_case": configurable["use_case"],
"cluster_table_xml": cluster_table_xml,
"suggestion_length": configurable.get("suggestion_length", 30),
"cluster_name_length": configurable.get("cluster_name_length", 10),
"cluster_description_length": configurable.get(
"cluster_description_length", 30
),
"explanation_length": configurable.get("explanation_length", 20),
"max_num_clusters": configurable.get("max_num_clusters", 25),
}
)
return {
"clusters": [updated_taxonomy["clusters"]],
}Ora vediamo come integrare il modello linguistico nel processo di generazione della tassonomia:
# We will share an LLM for each step of the generate -> update -> review cycle
# You may want to consider using Opus or another more powerful model for this
taxonomy_generation_llm = model
## Initial generation
taxonomy_generation_prompt = hub.pull("wfh/tnt-llm-taxonomy-generation").partial(
use_case="Generate the taxonomy that can be used to label the user intent in the conversation.",
)
taxa_gen_llm_chain = (
taxonomy_generation_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="GenerateTaxonomy")
generate_taxonomy_chain = taxa_gen_llm_chain | parse_taxa
def generate_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
return invoke_taxonomy_chain(
generate_taxonomy_chain, state, config, state["minibatches"][0]
)Passo 4: Aggiornare la tassonomia
Man mano che vengono elaborati i minibatch successivi, TNT-LLM aggiorna e affina iterativamente la tassonomia. Questo processo consente alla tassonomia di evolvere e migliorare nel tempo, incorporando nuove intuizioni e categorie scoperte nei batch aggiuntivi di dati. Gli aggiornamenti assicurano che la tassonomia resti completa e rifletta l'intero dataset.
taxonomy_update_prompt = hub.pull("wfh/tnt-llm-taxonomy-update")
taxa_update_llm_chain = (
taxonomy_update_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="UpdateTaxonomy")
update_taxonomy_chain = taxa_update_llm_chain | parse_taxa
def update_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
which_mb = len(state["clusters"]) % len(state["minibatches"])
return invoke_taxonomy_chain(
update_taxonomy_chain, state, config, state["minibatches"][which_mb]
)Passo 5: Revisionare la tassonomia
Una volta elaborati tutti i minibatch e aggiornata la tassonomia, l'ultimo passaggio consiste nella revisione della tassonomia. Questa revisione è cruciale per validare l'accuratezza e la pertinenza delle etichette categorizzate. Garantisce che la tassonomia organizzi e categorizzi il dataset in modo significativo, allineandosi al caso d'uso previsto come il riconoscimento dell'intento o la classificazione degli argomenti.
taxonomy_review_prompt = hub.pull("wfh/tnt-llm-taxonomy-review")
taxa_review_llm_chain = (
taxonomy_review_prompt | taxonomy_generation_llm | StrOutputParser()
).with_config(run_name="ReviewTaxonomy")
review_taxonomy_chain = taxa_review_llm_chain | parse_taxa
def review_taxonomy(
state: TaxonomyGenerationState, config: RunnableConfig
) -> TaxonomyGenerationState:
batch_size = config["configurable"].get("batch_size", 200)
original = state["documents"]
indices = list(range(len(original)))
random.shuffle(indices)
return invoke_taxonomy_chain(
review_taxonomy_chain, state, config, indices[:batch_size]
)Passo 6: Orchestrare la pipeline TNT-LLM con StateGraph
Finora, i primi cinque passaggi hanno riguardato la preparazione di singoli componenti come la sintesi dei documenti, la creazione dei minibatch, la generazione, l'aggiornamento e la revisione della tassonomia. Ora siamo pronti a integrare questi componenti in un'unica pipeline TNT-LLM coerente usando un framework StateGraph.
Questo grafo orchestra l'esecuzione sequenziale dei compiti: riassumere i documenti, generare tassonomie dai minibatch, aggiornare iterativamente le tassonomie e infine rivedere e convalidare la tassonomia. I bordi condizionali assicurano che le tassonomie vengano aggiornate fino all'elaborazione di tutti i minibatch, dopodiché la tassonomia finale viene revisionata e finalizzata per l'uso nelle attività di etichettatura.
from langgraph.graph import StateGraph
graph = StateGraph(TaxonomyGenerationState)
graph.add_node("summarize", map_reduce_chain)
graph.add_node("get_minibatches", get_minibatches)
graph.add_node("generate_taxonomy", generate_taxonomy)
graph.add_node("update_taxonomy", update_taxonomy)
graph.add_node("review_taxonomy", review_taxonomy)
graph.add_edge("summarize", "get_minibatches")
graph.add_edge("get_minibatches", "generate_taxonomy")
graph.add_edge("generate_taxonomy", "update_taxonomy")
def should_review(state: TaxonomyGenerationState) -> str:
num_minibatches = len(state["minibatches"])
num_revisions = len(state["clusters"])
if num_revisions < num_minibatches:
return "update_taxonomy"
return "review_taxonomy"
graph.add_conditional_edges(
"update_taxonomy",
should_review,
# Optional (but required for the diagram to be drawn correctly below)
{"update_taxonomy": "update_taxonomy", "review_taxonomy": "review_taxonomy"},
)
graph.set_finish_point("review_taxonomy")
graph.set_entry_point("summarize")
app = graph.compile()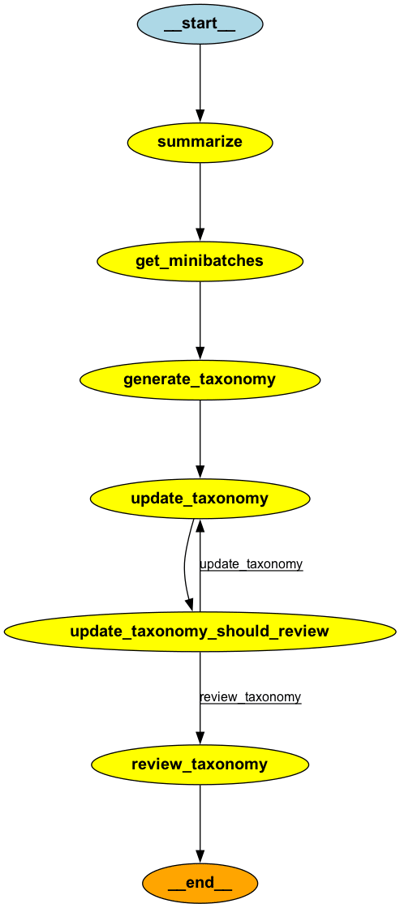
Passo 7: Clustering e visualizzazione della tassonomia degli articoli di news con TNT-LLM
In quest'ultimo passaggio, utilizziamo TNT-LLM per raggruppare articoli di news. La tassonomia risultante viene mostrata in formato Markdown, con i nomi e le descrizioni di ciascun cluster.
use_case = (
"Generate the taxonomy that can be used to label the news article that would benefit the user."
)
stream = app.stream(
{"documents": docs},
{
"configurable": {
"use_case": use_case,
# Optional:
"batch_size": 10,
"suggestion_length": 30,
"cluster_name_length": 10,
"cluster_description_length": 30,
"explanation_length": 20,
"max_num_clusters": 25,
},
"max_concurrency": 2,
"recursion_limit": 50,
},
)
for step in stream:
node, state = next(iter(step.items()))
print(node, str(state)[:20] + " ...")
from IPython.display import Markdown
def format_taxonomy_md(clusters):
md = "## Final Taxonomy\\n\\n"
md += "| ID | Name | Description |\\n"
md += "|----|------|-------------|\\n"
# Iterate over each inner list of dictionaries
for cluster_list in clusters:
for label in cluster_list:
id = label["id"]
name = label["name"].replace("|", "\\\\|") # Escape any pipe characters within the content
description = label["description"].replace("|", "\\\\|") # Escape any pipe characters
md += f"| {id} | {name} | {description} |\\n"
return md
markdown_table = format_taxonomy_md(step['review_taxonomy']['clusters'])
Markdown(markdown_table)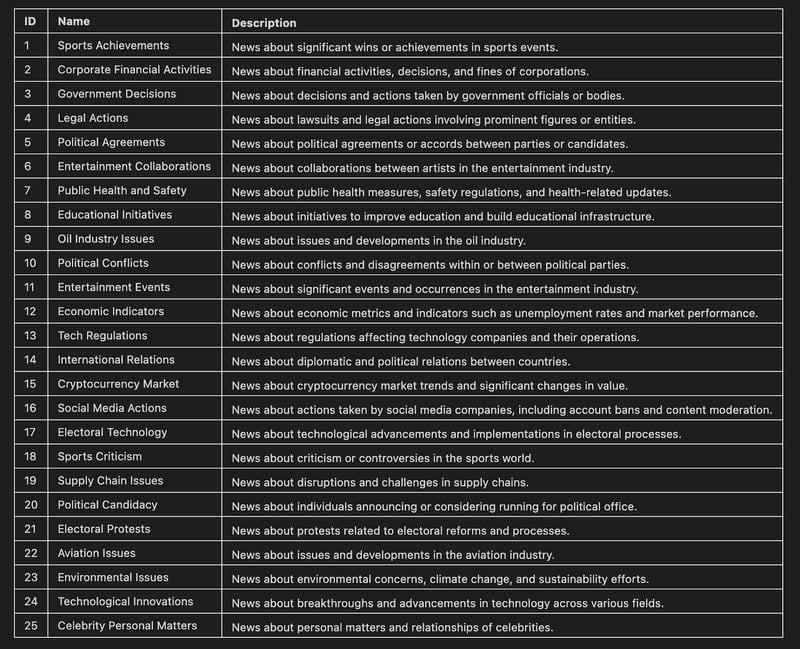
Ed ecco fatto! Seguendo questi passaggi strutturati, TNT-LLM ha automatizzato la creazione di tassonomie dettagliate e interpretabili da dati testuali grezzi. Questo approccio semplifica ciò che tradizionalmente richiede notevole impegno umano e competenze di dominio, rendendolo uno strumento potente per attività di text mining e classificazione su larga scala.
Conclusione
TNT-LLM rappresenta un passo avanti significativo nel text mining e nella classificazione, offrendo una soluzione efficiente per analizzare grandi volumi di dati non strutturati. Automatizzando la generazione di tassonomie e la classificazione scalabile, riduce il tempo e lo sforzo necessari per ricavare insight dal testo.
Man mano che TNT-LLM evolve, ha il potenziale per trasformare il modo in cui le organizzazioni analizzano enormi quantità di dati testuali. Questo strumento abilita decisioni data‑driven in diversi settori, rendendo gli insight dai dati testuali più accessibili e incisivi.
Se vuoi saperne di più sullo sviluppo di applicazioni LLM, ti consiglio questo corso su Sviluppare applicazioni LLM con LangChain.

Ryan è un lead data scientist specializzato nello sviluppo di applicazioni di IA con LLM. È dottorando in Elaborazione del Linguaggio Naturale e Knowledge Graph all’Imperial College London, dove ha anche conseguito la laurea magistrale in Informatica. Oltre alla data science, scrive una newsletter settimanale su Substack, The Limitless Playbook, in cui condivide un’idea pratica dei migliori pensatori al mondo e, di tanto in tanto, scrive sui concetti fondamentali dell’IA.




Microsoft ha introdotto TNT-LLM, un potente sistema progettato per automatizzare la generazione di tassonomie e la classificazione del testo, superando i metodi tradizionali in termini di efficienza e accuratezza.
TNT-LLM sfrutta la potenza dei large language model (LLM) per automatizzare e scalare la creazione di tassonomie e classificatori con un intervento umano minimo. Questo lo rende particolarmente utile per applicazioni come Bing Copilot, dove la gestione di domini testuali diversi e in continua evoluzione è cruciale.
In questo articolo ti guiderò nell'implementazione di TNT-LLM usando GPT-4o e LangGraph per raggruppare in modo efficace articoli di news.
Se vuoi approfondire GPT-4o o LangGraph, ti consiglio questi articoli:
Se vuoi saperne di più su TNT-LLM, ti consiglio l'articolo originale TnT-LLM: Text Mining at Scale with Large Language Models.