
课程
数据科学概览
2 小时
876.1K
距离度量为衡量对象之间的差异提供了基本方法。相比 欧氏距离 或 曼哈顿距离 这类衡量空间差异的度量,汉明距离采取了不同的思路:它统计两条序列在对应位置上不同的个数。这使其在错误检测、数据校验以及信息论中尤为有用。
汉明距离最早由理查德·汉明于 1950 年在贝尔实验室从事代码校验系统工作时提出,如今它的应用已超越电信领域。当前,它在以下诸多领域中都是关键度量:
在本指南中,我们将解释汉明距离的工作原理,探讨其实际应用,并在 Python 与 R 中实现。通过这些概念与实现,您将更好地解决数据校验、生物信息学与机器学习中的相关问题。
汉明距离衡量的是两条等长字符串在对应位置上符号不同的个数。可以将其理解为把一个字符串转换为另一个字符串所需的最少替换次数。
例如,比较两条二进制字符串:
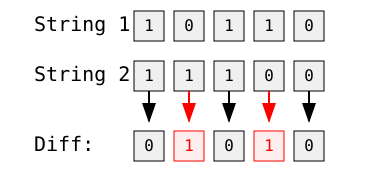
作者制图
此处汉明距离为 2,因为两条字符串在两个位置不同——第二位与第四位比特。
数学上,对于长度为 n 的两条等长字符串 x 和 y,汉明距离 D(x,y) 表达为:
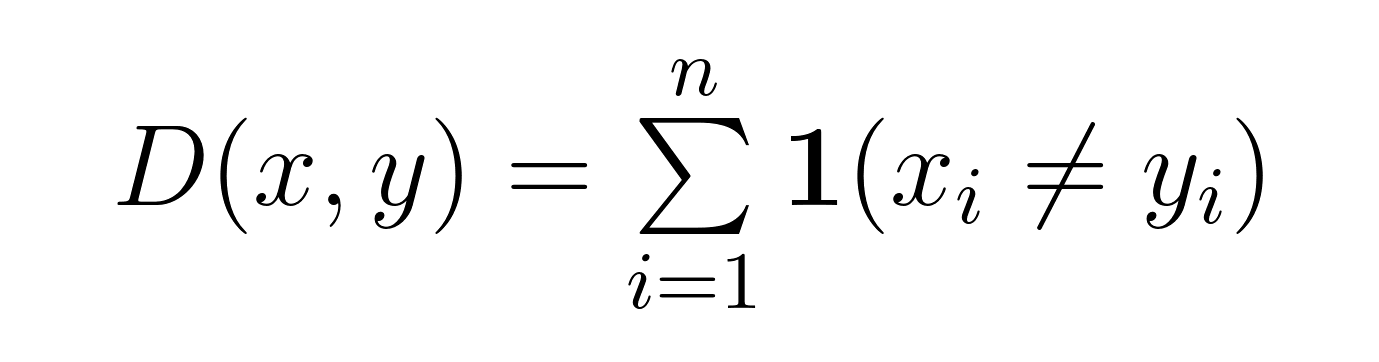
该公式统计所有满足 xᵢ ≠ yᵢ 的位置。对于二进制字符串,这等价于统计比特不相同的位置。对于其他类型的序列(如 DNA 或文本),则统计符号不同的对应位置。
需要注意的两个关键性质:
这些性质使汉明距离非常适用于以下场景:
我们通过示例来说明如何计算汉明距离,从简单的二进制字符串开始,再扩展到更复杂的应用。
最直接的应用是比较二进制字符串。来看两条 8 位字符串:
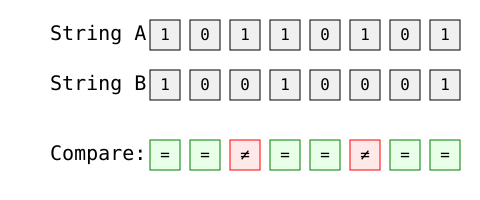
作者制图
逐步计算:
汉明距离为 2,因为有两个位置不同(第 3 位与第 6 位)。
汉明距离在生物信息学中常用于比较基因序列。考虑以下两段 DNA 片段:
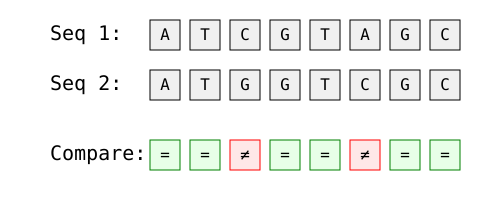
作者制图
逐步分析:
这种比较有助于生物学家量化基因突变并分析 DNA 相似性。
汉明距离同样适用于等长的常规文本字符串:
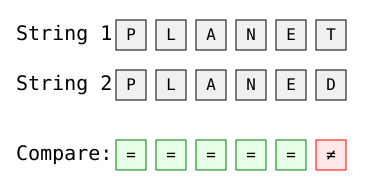
作者制图
此处汉明距离为 1,唯一差异在最后一个位置(“T” 与 “D”)。
这类比较适用于:
这些示例表明,无论比较的数据类型为何,汉明距离都能以简单而有效的方式量化序列之间的差异。关键在于它关注按位置的差异,而忽略具体变更的性质。
汉明距离为数字通信中的错误检测与纠错码奠定了基础。通过策略性地添加校验位,以在有效码字之间建立最小距离,系统可以在接收数据不匹配有效模式时进行检测,甚至通过映射到最近的有效码字来纠正错误。这一原理支撑了现代技术,如计算机中的 ECC(纠错码)内存、二维码的纠错机制,以及在数据完整性至关重要的深空通信系统。
信息论利用汉明距离来设计可靠的通信系统。构造错误处理码时,工程师会确保有效消息(码字)之间至少在若干位上不同。例如,若有效消息之间至少相差两位,系统即可检测到单比特在传输中被破坏的情况。若有效消息之间至少相差三位,系统甚至能够通过识别最近的有效消息来纠正单比特错误。这些原则帮助构建从卫星通信到数据存储等各类稳健的通信系统。
遗传学研究者使用汉明距离分析 DNA 序列并量化突变。通过逐位比较基因序列,科学家可以识别点突变、追踪进化变化,并研究遗传多样性。这在研究疾病突变时尤为重要,了解基因变化的具体位置有助于研究人员追踪疾病如何演化并在人群中传播。
在机器学习中,汉明距离是用于二元或分类数据的相似度度量。它可用于模式识别任务中的特征向量比较、推荐系统中的相似度衡量,以及分类问题中的分类数据分析。该度量简单且计算高效,尤其适用于处理高维二元数据,或在大规模数据集上需要快速相似度计算的场景。
汉明距离构成一个数学度量空间,意味着它遵循四个基本规则。其一,距离总是不负的——两个字符串不同位置的数量不可能为负。其二,当且仅当两条序列完全相同时,距离为零。其三,距离具有对称性——比较序列 A 与 B 的结果与比较 B 与 A 相同。最后,它满足三角不等式:A 与 C 之间的距离不大于 A 与 B 与 B 与 C 距离之和。
在处理二进制字符串时,汉明距离具有一些对错误检测尤为有用的特性。对于任意两条长度为 n 的二进制字符串,其汉明距离不可能超过 n,且只有当它们互为补码时才会达到该上限。两条随机二进制字符串之间出现特定汉明距离“d”的概率服从二项分布,最可能的距离为 n/2。该性质有助于设计能够识别传输过程中比特翻转的错误检测码。
Python 既提供了库函数也支持自定义实现来计算汉明距离。SciPy 库通过其空间距离函数提供了最高效的方案:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
如果您更偏好自定义实现:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101"))  # Output: 1
R 可通过基础函数简单计算汉明距离:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
若要在上述代码基础上进一步扩展,并探索距离度量在实践中的更多应用,请参考以下深度资源:
这些课程将帮助您超越基础实现,理解距离度量如何影响机器学习应用,无论您偏好哪种编程语言。
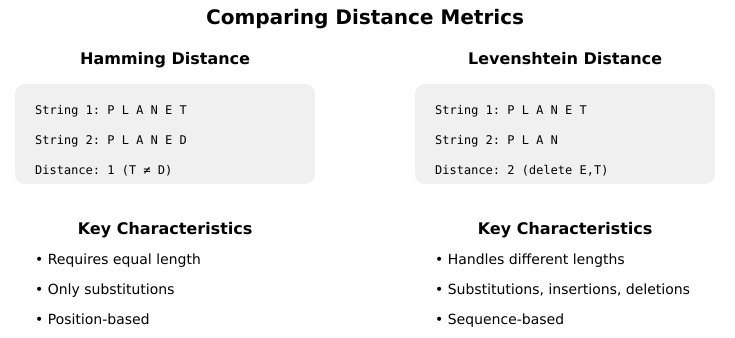
作者制图
莱文斯坦距离表示将一个字符串变为另一个字符串所需的最少单字符编辑操作数。与汉明距离不同,它可通过考虑插入和删除(以及替换)来处理不同长度的字符串。这种灵活性使其在拼写检查、DNA 序列比对和模糊字符串匹配中尤为有用,但也以更高的计算复杂度为代价。比如比较 "planet" 与 "plan" 时,莱文斯坦距离会把删除 'e' 与 't' 计为两次操作,而汉明距离则无法进行该比较。
在标准莱文斯坦距离的基础上,Damerau–Levenshtein 距离将相邻字符对调作为一种有效操作。此项补充使其对常见的字符交换式输入错误格外敏感。例如比较 "form" 与 "from" 时,它会将其视为一次对调而非两次替换。该度量广泛应用于自然语言处理,尤其是自动拼写纠正系统中,字符对调是常见的输入错误。
Jaro–Winkler 距离采取独特方法,强调字符位置权重,尤其偏好字符串开头的匹配。它不统计编辑操作,而是给出 0 到 1 的相似度分数,1 表示完全匹配。该度量在比较专有名词和短字符串方面表现突出,适用于记录关联与去重任务。例如比较 "Martha" 与 "Marhta" 时,由于差异出现在字符串后部,它会给出较高的相似度。
不同场景适用不同的距离度量。选择时可考虑以下关键因素:
上述结构化对比表明,各类距离度量各有所长;当需要对定长数据进行比较且重视简洁与速度时,汉明距离尤为合适。
汉明距离的优雅之处在于其简洁。通过统计序列在对应位置上的差异,它为度量不相似性提供了可靠方法——无论是检测传输数据中的错误,还是分析基因突变。在每个位置同等重要、且主要关心替换的领域,它尤为出色。
在您的工作中选择距离度量时,若满足以下条件可优先考虑汉明距离:
若要继续提升您在距离度量及其他数据科学基础概念方面的能力,欢迎探索我们的 数据科学家认证 项目(提供 Python 与 R 两种路径)。