
Last chance! 50% off DataCamp Premium
Sale ends in
Le metriche di distanza offrono modi essenziali per misurare le differenze tra oggetti. Mentre metriche come la Euclidea o la Manhattan misurano differenze spaziali, la distanza di Hamming adotta un approccio diverso: conta le posizioni in cui due sequenze differiscono. Questo la rende particolarmente utile per il rilevamento degli errori, la validazione dei dati e la teoria dell'informazione.
Sviluppata originariamente da Richard Hamming nel 1950 mentre lavorava su sistemi di verifica del codice ai Bell Labs, la distanza di Hamming ha superato le sue radici nelle telecomunicazioni. Oggi è una metrica chiave in campi diversi, tra cui:
In questa guida esploreremo come funziona la distanza di Hamming, ne vedremo le applicazioni pratiche e la implementeremo in Python e R. I concetti e le implementazioni trattati rafforzeranno la tua capacità di risolvere problemi di validazione dei dati, bioinformatica e machine learning.
La distanza di Hamming misura il numero di posizioni in cui due stringhe della stessa lunghezza hanno simboli diversi. Puoi pensarla come il conteggio del numero minimo di sostituzioni necessarie per trasformare una stringa nell'altra.
Ad esempio, confrontando due stringhe binarie:
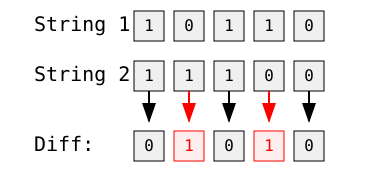
Immagine dell'autore
Qui la distanza di Hamming è 2 perché le stringhe differiscono in due posizioni: il secondo e il quarto bit.
Matematicamente, per due stringhe x e y della stessa lunghezza n, la distanza di Hamming D(x,y) si esprime come:
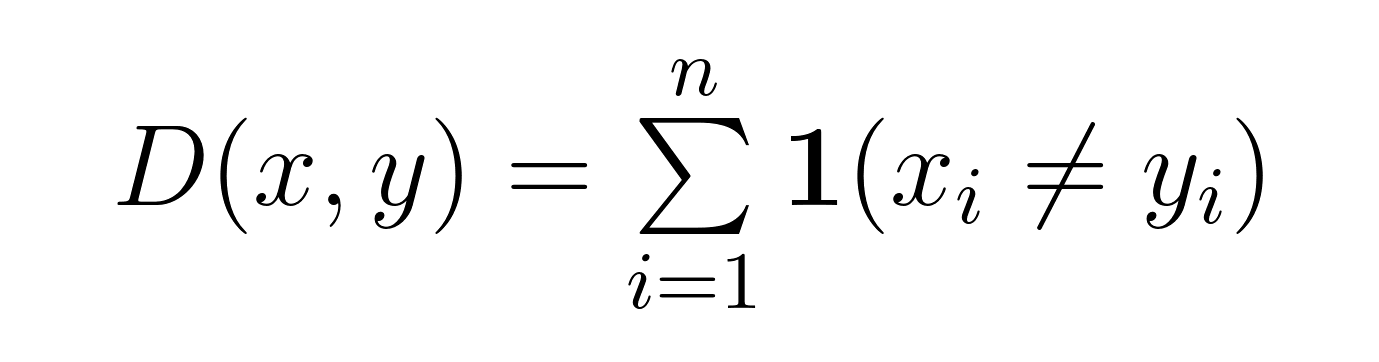
Questa formula conta le posizioni in cui xᵢ ≠ yᵢ. Per stringhe binarie, si riduce a contare dove i bit differiscono. Per altri tipi di sequenze (come DNA o testo), conta le posizioni con simboli diversi.
Due proprietà chiave da ricordare:
Queste proprietà rendono la distanza di Hamming ideale negli scenari in cui:
Vediamo come calcolare la distanza di Hamming con alcuni esempi, partendo da stringhe binarie semplici fino ad applicazioni più complesse.
L'applicazione più diretta della distanza di Hamming è il confronto di stringhe binarie. Analizziamo due stringhe a 8 bit:
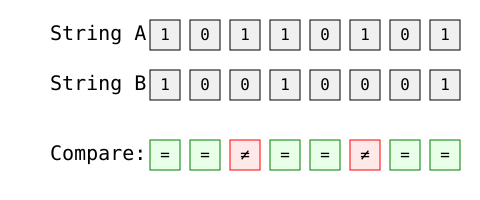
Immagine dell'autore
Calcolo passo per passo:
La distanza di Hamming è 2, poiché ci sono due posizioni in cui le stringhe differiscono (posizioni 3 e 6).
La distanza di Hamming è usata spesso in bioinformatica per confrontare sequenze genetiche. Considera due frammenti di DNA:
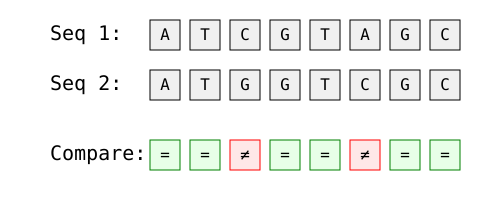
Immagine dell'autore
Analisi passo per passo:
Questo confronto aiuta i biologi a quantificare le mutazioni genetiche e analizzare la somiglianza tra DNA.
La distanza di Hamming funziona anche con normali stringhe di testo della stessa lunghezza:
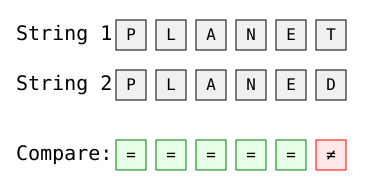
Immagine dell'autore
Qui la distanza di Hamming è 1, con l'unica differenza all'ultima posizione ("T" vs "D").
Questo tipo di confronto è utile in:
Ogni esempio mostra come la distanza di Hamming offra un modo semplice ma efficace per quantificare le differenze tra sequenze, indipendentemente dal tipo di dati confrontati. L'intuizione chiave è che guarda alle differenze posizione per posizione ignorando la natura specifica delle modifiche.
La distanza di Hamming ha posto le basi per i codici di rilevamento e correzione degli errori nelle comunicazioni digitali. Aggiungendo in modo strategico bit di parità per creare distanze minime tra codeword valide, i sistemi possono rilevare quando i dati ricevuti non corrispondono a pattern validi e persino correggere gli errori mappando alla codeword valida più vicina. Questo principio alimenta tecnologie moderne come la memoria ECC (Error-Correcting Code) nei computer, la correzione degli errori nei codici QR e i sistemi di comunicazione per lo spazio profondo, dove l'integrità dei dati è cruciale.
La teoria dell'informazione utilizza la distanza di Hamming per progettare sistemi di comunicazione affidabili. Quando si creano codici per la gestione degli errori, gli ingegneri si assicurano che i messaggi validi (codeword) differiscano per un numero minimo specifico di bit. Ad esempio, se i messaggi validi differiscono sempre per almeno due bit, il sistema può rilevare quando durante la trasmissione si corrompe un singolo bit. Se i messaggi validi differiscono per almeno tre bit, il sistema può persino correggere errori a singolo bit identificando il messaggio valido più vicino. Questi principi contribuiscono a creare sistemi di comunicazione robusti usati da comunicazioni satellitari all'archiviazione dei dati.
I ricercatori genetici usano la distanza di Hamming per analizzare le sequenze di DNA e quantificare le mutazioni. Confrontando le sequenze genetiche posizione per posizione, gli scienziati possono identificare mutazioni puntiformi, tracciare cambiamenti evolutivi e studiare la diversità genetica. Questa applicazione è particolarmente preziosa nello studio delle mutazioni patologiche, dove comprendere le posizioni esatte delle variazioni genetiche aiuta a seguire come le malattie evolvono e si diffondono nelle popolazioni.
Nel machine learning, la distanza di Hamming funge da metrica di similarità per dati binari o categorici. Aiuta a confrontare vettori di feature nei compiti di riconoscimento di pattern, misurare la similarità nei sistemi di raccomandazione e analizzare dati categorici nei problemi di classificazione. La sua semplicità e l'efficienza computazionale la rendono particolarmente utile con dati binari ad alta dimensionalità o quando servono calcoli rapidi di similarità su grandi dataset.
La distanza di Hamming definisce uno spazio metrico matematico, il che significa che segue quattro regole fondamentali. Primo, la distanza è sempre non negativa: non puoi avere un numero negativo di posizioni in cui le stringhe differiscono. Secondo, la distanza tra due sequenze è zero se e solo se sono identiche. Terzo, la distanza è simmetrica: confrontare la sequenza A con B dà lo stesso risultato che confrontare B con A. Infine, soddisfa la disuguaglianza triangolare: la distanza tra le sequenze A e C non può essere maggiore della somma delle distanze da A a B e da B a C.
Quando si lavora con stringhe binarie, la distanza di Hamming assume caratteristiche speciali che la rendono particolarmente utile per il rilevamento degli errori. Per due stringhe binarie di lunghezza n, la loro distanza di Hamming non può superare n, verificandosi solo quando le stringhe sono complementi l'una dell'altra. La probabilità di una specifica distanza di Hamming “d” tra due stringhe binarie casuali segue una distribuzione binomiale, con la distanza più probabile pari a n/2. Questa proprietà aiuta a progettare codici di rilevamento degli errori in grado di riconoscere quando i bit sono stati invertiti durante la trasmissione.
Python offre sia funzioni di libreria sia implementazioni personalizzate per calcolare la distanza di Hamming. La libreria SciPy fornisce la soluzione più efficiente tramite le sue funzioni di distanza spaziale:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
Per chi preferisce un'implementazione personalizzata:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101")) # Output: 1R offre un modo semplice per calcolare la distanza di Hamming usando le funzioni base:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
Per approfondire questi esempi di codice ed esplorare altre applicazioni pratiche delle metriche di distanza, dai un'occhiata a queste risorse complete:
Questi corsi ti aiuteranno ad andare oltre le implementazioni di base per capire come le metriche di distanza influenzano le applicazioni di machine learning, a prescindere dal tuo linguaggio di programmazione preferito.
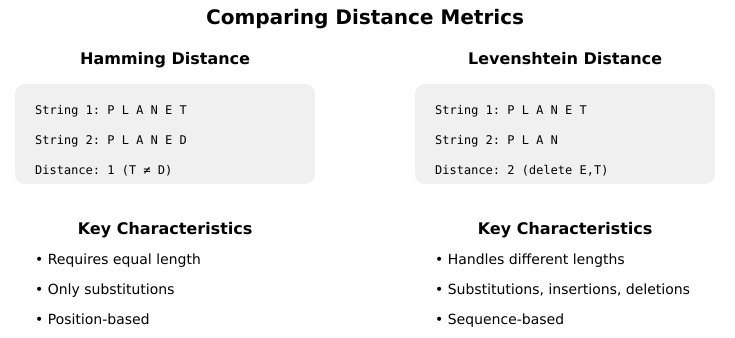
Immagine dell'autore
La distanza di Levenshtein rappresenta il numero minimo di modifiche a singolo carattere necessarie per trasformare una stringa in un'altra. A differenza della distanza di Hamming, può gestire stringhe di lunghezze diverse considerando inserimenti e cancellazioni oltre alle sostituzioni. Questa flessibilità la rende particolarmente utile per correttori ortografici, allineamento di sequenze di DNA e fuzzy string matching, anche se questa versatilità comporta una maggiore complessità computazionale. Confrontando stringhe come "planet" e "plan", la distanza di Levenshtein conterebbe l'eliminazione di 'e' e 't' come due operazioni, mentre la distanza di Hamming non potrebbe effettuare affatto questo confronto.
Basata sulla distanza di Levenshtein standard, la distanza di Damerau-Levenshtein aggiunge la trasposizione di caratteri adiacenti come operazione valida. Questa aggiunta la rende particolarmente efficace nel rilevare errori di digitazione comuni in cui i caratteri vengono scambiati per errore. Ad esempio, confrontando "form" con "from", conterebbe ciò come una singola trasposizione anziché due sostituzioni separate. Questa metrica è ampiamente usata nelle applicazioni di elaborazione del linguaggio naturale, in particolare nei sistemi di correzione ortografica automatica dove la trasposizione di caratteri è un errore frequente.
La distanza di Jaro-Winkler adotta un approccio particolare basato sui pesi delle posizioni dei caratteri, privilegiando in particolare le corrispondenze all'inizio delle stringhe. Invece di contare le operazioni di modifica, produce un punteggio di similarità tra 0 e 1, dove 1 indica una corrispondenza perfetta. Questa metrica eccelle nel confronto di nomi propri e stringhe corte, risultando ideale per il record linkage e la deduplicazione. Ad esempio, confrontando nomi come "Martha" e "Marhta", assegnerà un punteggio di similarità più alto perché i caratteri differenti compaiono più avanti nella stringa.
Situazioni diverse richiedono metriche di distanza diverse. Considera questi fattori chiave quando selezioni il tuo approccio:
Questo confronto strutturato mostra come ogni metrica di distanza serva a scopi distinti, con la distanza di Hamming particolarmente preziosa negli scenari in cui la sua semplicità e velocità si allineano a requisiti di confronto a lunghezza fissa.
L'eleganza della distanza di Hamming sta nella sua semplicità. Contando le posizioni in cui le sequenze differiscono, offre un modo robusto per misurare la dissimilarità, che si tratti di rilevare errori nei dati trasmessi o di analizzare mutazioni genetiche. Questa metrica dà il meglio di sé in domini in cui ogni posizione conta allo stesso modo e le sostituzioni sono la principale preoccupazione.
Quando esplori le metriche di distanza nel tuo lavoro, prendi in considerazione la distanza di Hamming quando:
Per continuare a sviluppare le tue competenze sulle metriche di distanza e su altri concetti fondamentali di data science, esplora il nostro programma di Data Scientist Certification, disponibile sia in Python che in R.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min




