
कोर्स
डेटा साइंस को समझना
2 घंटा
876.1K
डिस्टेंस मेट्रिक्स वस्तुओं के बीच अंतर मापने के मूलभूत तरीके प्रदान करते हैं। जहाँ Euclidean या Manhattan distance जैसे मेट्रिक्स स्थानिक अंतर मापते हैं, वहीं हैमिंग डिस्टेंस अलग दृष्टिकोण अपनाता है: यह उन स्थानों की गणना करता है जहाँ दो अनुक्रम भिन्न होते हैं। इससे यह त्रुटि जाँच, डेटा सत्यापन और सूचना सिद्धांत में विशेष रूप से उपयोगी हो जाता है।
मूल रूप से 1950 में रिचर्ड हैमिंग द्वारा Bell Labs में कोड वेरिफिकेशन सिस्टम पर काम करते समय विकसित, हैमिंग डिस्टेंस अपनी दूरसंचार जड़ों से आगे विकसित हो चुका है। आज, यह कई विविध क्षेत्रों में एक प्रमुख मेट्रिक के रूप में कार्य करता है, जिनमें शामिल हैं:
इस गाइड में, हम देखेंगे कि हैमिंग डिस्टेंस कैसे काम करता है, इसके व्यावहारिक उपयोगों का अध्ययन करेंगे, और इसे Python तथा R में लागू करेंगे। जिन अवधारणाओं और इम्प्लीमेंटेशन को हम कवर करेंगे, वे डेटा वैलिडेशन, बायोइन्फॉर्मेटिक्स, और मशीन लर्निंग की समस्याएँ सुलझाने की आपकी क्षमता को मजबूत करेंगे।
हैमिंग डिस्टेंस समान लंबाई वाली दो स्ट्रिंग्स में उन स्थानों की संख्या मापता है जहाँ उनके प्रतीक अलग होते हैं। इसे इस तरह समझें कि एक स्ट्रिंग को दूसरी में बदलने के लिए आवश्यक न्यूनतम प्रतिस्थापनों (substitutions) की गिनती।
उदाहरण के लिए, दो बाइनरी स्ट्रिंग्स की तुलना:
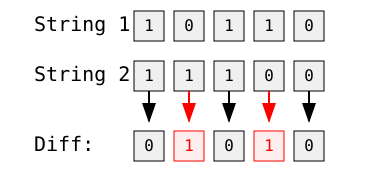
चित्र: लेखक द्वारा
यहाँ हैमिंग डिस्टेंस 2 है क्योंकि स्ट्रिंग्स दो स्थानों—दूसरे और चौथे बिट—पर भिन्न हैं।
गणितीय रूप से, समान लंबाई n वाली दो स्ट्रिंग्स x और y के लिए, हैमिंग डिस्टेंस D(x,y) इस प्रकार व्यक्त होता है:
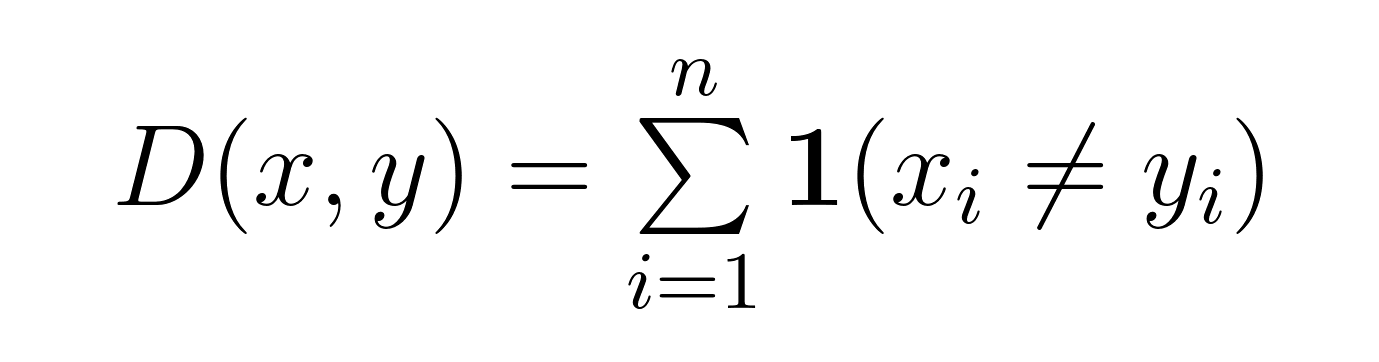
यह सूत्र उन स्थानों की गिनती करता है जहाँ xᵢ ≠ yᵢ हो। बाइनरी स्ट्रिंग्स के लिए यह उन बिट्स की गिनती तक सरल हो जाता है जहाँ अंतर है। अन्य प्रकार के अनुक्रमों (जैसे DNA या टेक्स्ट) के लिए, यह अलग प्रतीकों वाले स्थानों की गिनती करता है।
दो मुख्य गुण जिन्हें ध्यान में रखना चाहिए:
ये गुण हैमिंग डिस्टेंस को उन परिस्थितियों के लिए आदर्श बनाते हैं जहाँ:
आइए उदाहरणों के माध्यम से हैमिंग डिस्टेंस की गणना समझें—सरल बाइनरी स्ट्रिंग्स से शुरू करते हुए और अधिक जटिल उपयोगों तक।
हैमिंग डिस्टेंस का सबसे सीधे-सीधा उपयोग बाइनरी स्ट्रिंग्स की तुलना करना है। आइए दो 8-बिट स्ट्रिंग्स का विश्लेषण करें:
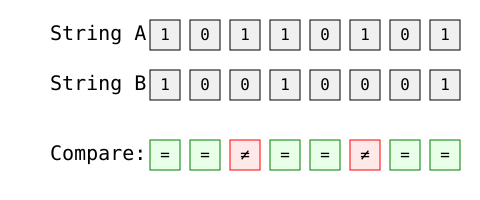
चित्र: लेखक द्वारा
चरण-दर-चरण गणना:
हैमिंग डिस्टेंस 2 है, क्योंकि दो स्थानों (3 और 6) पर स्ट्रिंग्स भिन्न हैं।
बायोइन्फॉर्मेटिक्स में जेनेटिक अनुक्रमों की तुलना के लिए हैमिंग डिस्टेंस का अक्सर उपयोग होता है। दो DNA अंशों पर विचार करें:
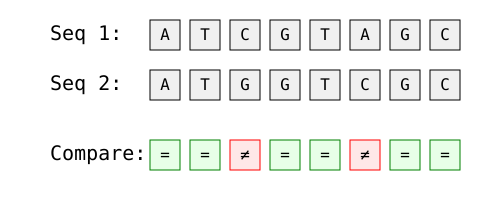
चित्र: लेखक द्वारा
चरण-दर-चरण विश्लेषण:
यह तुलना जीवविज्ञानियों को आनुवंशिक म्यूटेशन की मात्रा निर्धारित करने और DNA समानता का विश्लेषण करने में मदद करती है।
हैमिंग डिस्टेंस समान लंबाई वाली सामान्य टेक्स्ट स्ट्रिंग्स पर भी काम करता है:
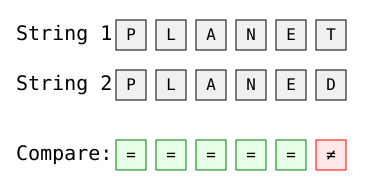
चित्र: लेखक द्वारा
यहाँ हैमिंग डिस्टेंस 1 है, और एकमात्र अंतर अंतिम स्थान पर है ('T' बनाम 'D')।
इस प्रकार की तुलना इन कार्यों में उपयोगी है:
प्रत्येक उदाहरण दिखाता है कि हैमिंग डिस्टेंस डेटा के प्रकार की परवाह किए बिना अनुक्रमों के बीच अंतर को मापने का एक सरल लेकिन प्रभावी तरीका प्रदान करता है। मुख्य बात यह है कि यह परिवर्तनों की प्रकृति की बजाय स्थान-विशिष्ट अंतर पर ध्यान देता है।
हैमिंग डिस्टेंस ने डिजिटल संचार में त्रुटि-जाँच और त्रुटि-सुधार कोड्स की नींव रखी। वैध कोडवर्ड्स के बीच न्यूनतम दूरी बनाने के लिए रणनीतिक रूप से पैरिटी बिट्स जोड़कर, सिस्टम यह पता लगा सकते हैं कि प्राप्त डेटा वैध पैटर्न से मेल नहीं खाता, और नज़दीकी वैध कोडवर्ड पर मैप करके त्रुटियाँ सुधार भी सकते हैं। यही सिद्धांत कंप्यूटरों में ECC (Error-Correcting Code) मेमोरी, QR कोड त्रुटि सुधार, और डीप स्पेस कम्युनिकेशन जैसे क्षेत्रों को शक्ति देता है जहाँ डेटा की अखंडता अत्यंत महत्वपूर्ण होती है।
सूचना सिद्धांत भरोसेमंद संचार प्रणालियों को डिजाइन करने के लिए हैमिंग डिस्टेंस का उपयोग करता है। त्रुटि-प्रबंधन कोड बनाते समय, इंजीनियर सुनिश्चित करते हैं कि वैध संदेश (कोडवर्ड्स) कम-से-कम निश्चित संख्या के बिट्स से भिन्न हों। उदाहरण के लिए, यदि वैध संदेश हमेशा कम-से-कम दो बिट्स से भिन्न हों, तो प्रणाली ट्रांसमिशन के दौरान एक बिट के भ्रष्ट होने पर उसे पकड़ सकती है। यदि वैध संदेश कम-से-कम तीन बिट्स से भिन्न हों, तो प्रणाली सबसे नज़दीकी वैध संदेश की पहचान कर एक-बिट त्रुटियों को सुधार भी सकती है। ये सिद्धांत सैटेलाइट कम्युनिकेशन से लेकर डेटा स्टोरेज तक, मजबूत संचार प्रणालियाँ बनाने में मदद करते हैं।
आनुवंशिकी शोधकर्ता DNA अनुक्रमों का विश्लेषण करने और म्यूटेशन की मात्रा निर्धारित करने के लिए हैमिंग डिस्टेंस का उपयोग करते हैं। आनुवंशिक अनुक्रमों की स्थान-दर-स्थान तुलना करके, वैज्ञानिक प्वाइंट म्यूटेशन की पहचान कर सकते हैं, विकासवादी बदलावों को ट्रैक कर सकते हैं, और आनुवंशिक विविधता का अध्ययन कर सकते हैं। यह उपयोग विशेष रूप से रोग संबंधी म्यूटेशन के अध्ययन में मूल्यवान है, जहाँ आनुवंशिक बदलावों के सटीक स्थान समझना शोधकर्ताओं को यह ट्रैक करने में मदद करता है कि बीमारियाँ समय के साथ कैसे विकसित होती हैं और आबादी में कैसे फैलती हैं।
मशीन लर्निंग में, हैमिंग डिस्टेंस बाइनरी या श्रेणीय (categorical) डेटा के लिए समानता मेट्रिक का काम करता है। यह पैटर्न पहचान कार्यों में फीचर वेक्टरों की तुलना करने, रिकमेंडेशन सिस्टम में समानता मापने, और वर्गीकरण समस्याओं में श्रेणीय डेटा का विश्लेषण करने में मदद करता है। इसकी सरलता और कुशल गणना इसे उच्च-आयामी बाइनरी डेटा के साथ काम करते समय या बड़े डेटासेट्स के लिए त्वरित समानता गणनाओं की आवश्यकता होने पर विशेष रूप से उपयोगी बनाती है।
हैमिंग डिस्टेंस एक गणितीय मेट्रिक स्पेस बनाता है, अर्थात यह चार बुनियादी नियमों का पालन करता है। प्रथम, दूरी हमेशा गैर-ऋणात्मक होती है—स्ट्रिंग्स के भिन्न होने वाले स्थानों की संख्या ऋणात्मक नहीं हो सकती। द्वितीय, दूरी शून्य तभी होती है जब दोनों अनुक्रम समान हों। तृतीय, दूरी सममित होती है—अनुक्रम A की B से तुलना का परिणाम B की A से तुलना के समान होता है। अंत में, यह ट्रायंगल इनइक्वॉलिटी को संतुष्ट करता है: A और C के बीच दूरी A से B तथा B से C की दूरियों के योग से अधिक नहीं हो सकती।
बाइनरी स्ट्रिंग्स के साथ काम करते समय, हैमिंग डिस्टेंस ऐसे विशेष लक्षण दर्शाता है जो इसे त्रुटि जाँच के लिए खास तौर पर उपयोगी बनाते हैं। किसी भी लंबाई n की दो बाइनरी स्ट्रिंग्स के लिए, उनका हैमिंग डिस्टेंस n से अधिक नहीं हो सकता, और यह तभी होता है जब दोनों स्ट्रिंग्स एक-दूसरे की परिपूरक (complement) हों। दो यादृच्छिक बाइनरी स्ट्रिंग्स के बीच किसी विशिष्ट हैमिंग डिस्टेंस “d” की प्रायिकता बाइनोमियल वितरण का पालन करती है, जहाँ सबसे संभावित दूरी n/2 होती है। यह गुण ऐसे त्रुटि-जाँच कोड डिजाइन करने में सहायक है जो ट्रांसमिशन के दौरान बिट-फ्लिप्स को पहचान सकें।
Python हैमिंग डिस्टेंस की गणना के लिए बिल्ट-इन लाइब्रेरी फ़ंक्शंस और कस्टम दोनों प्रकार के इम्प्लीमेंटेशन प्रदान करता है। SciPy लाइब्रेरी अपने स्पैटियल डिस्टेंस फ़ंक्शंस के ज़रिये सबसे कुशल समाधान देती है:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
जो लोग कस्टम इम्प्लीमेंटेशन पसंद करते हैं, उनके लिए:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101"))  # Output: 1
R बेस फ़ंक्शंस का उपयोग करके हैमिंग डिस्टेंस की गणना का एक सरल तरीका प्रदान करता है:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
इन कोडिंग उदाहरणों पर आगे निर्माण करने और व्यवहार में डिस्टेंस मेट्रिक्स के और अनुप्रयोगों का अन्वेषण करने के लिए, ये समग्र संसाधन देखें:
ये पाठ्यक्रम आपको बुनियादी इम्प्लीमेंटेशन से आगे ले जाकर यह समझने में मदद करेंगे कि डिस्टेंस मेट्रिक्स मशीन लर्निंग अनुप्रयोगों को कैसे प्रभावित करते हैं, चाहे आपकी पसंदीदा प्रोग्रामिंग भाषा कोई भी हो।
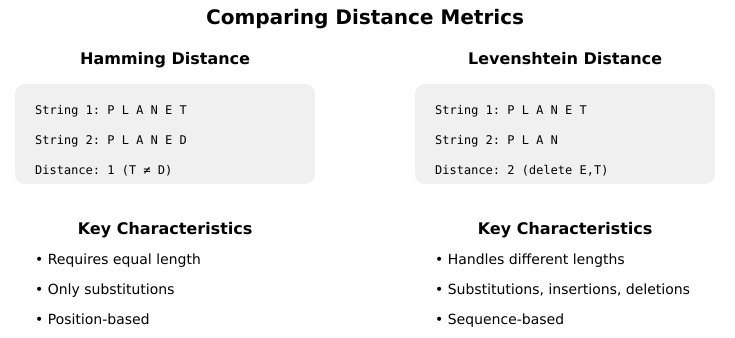
चित्र: लेखक द्वारा
Levenshtein डिस्टेंस उस न्यूनतम सिंगल-कैरेक्टर एडिट्स की संख्या का प्रतिनिधित्व करता है जो एक स्ट्रिंग को दूसरी में बदलने के लिए आवश्यक होती है। हैमिंग डिस्टेंस के विपरीत, यह सब्स्टिट्यूशन के साथ-साथ इंसर्शन और डिलीशन को भी ध्यान में रखकर अलग लंबाई वाली स्ट्रिंग्स संभाल सकता है। यह लचीलापन इसे स्पेल चेकर, DNA अनुक्रम एलाइनमेंट, और फज़्जी स्ट्रिंग मैचिंग के लिए विशेष रूप से उपयोगी बनाता है, यद्यपि इसकी बहुमुखी प्रतिभा अधिक कम्प्यूटेशनल जटिलता की कीमत पर आती है। जब "planet" और "plan" जैसी स्ट्रिंग्स की तुलना की जाती है, तो Levenshtein डिस्टेंस 'e' और 't' के डिलीशन को दो ऑपरेशनों के रूप में गिनेगा, जबकि हैमिंग डिस्टेंस ऐसी तुलना कर ही नहीं सकता।
मानक Levenshtein डिस्टेंस पर आधारित, Damerau-Levenshtein डिस्टेंस सटे हुए अक्षरों के ट्रांसपोज़िशन को एक वैध ऑपरेशन के रूप में जोड़ता है। यह जोड़ इसे उन आम टाइपिंग त्रुटियों को पकड़ने में विशेष रूप से प्रभावी बनाता है जहाँ अक्षर गलती से अदल-बदल हो जाते हैं। उदाहरण के लिए, "form" और "from" की तुलना करते समय, यह इसे दो अलग-अलग सब्स्टिट्यूशनों की बजाय एक ही ट्रांसपोज़िशन मानेगा। यह मेट्रिक नैचुरल लैंग्वेज प्रोसेसिंग अनुप्रयोगों, विशेषकर ऑटोमेटेड स्पेलिंग करेक्शन सिस्टम में, व्यापक रूप से उपयोग होती है जहाँ कैरेक्टर ट्रांसपोज़िशन एक सामान्य टाइपिंग त्रुटि है।
Jaro-Winkler डिस्टेंस एक अनोखा दृष्टिकोण अपनाता है जो कैरेक्टर पोज़िशन वेट पर केंद्रित है, विशेष रूप से स्ट्रिंग्स की शुरुआत में होने वाले मेल को प्राथमिकता देता है। एडिट ऑपरेशनों की गिनती करने के बजाय, यह 0 और 1 के बीच एक समानता स्कोर देता है, जहाँ 1 पूर्ण मिलान को दर्शाता है। यह मेट्रिक प्रॉपर नाउन और छोटी स्ट्रिंग्स की तुलना में उत्कृष्ट है, जिससे यह रिकॉर्ड लिंकेज और डीडुप्लिकेशन कार्यों के लिए आदर्श बनती है। उदाहरण के लिए, "Martha" और "Marhta" जैसे नामों की तुलना करते समय, यह उच्च समानता स्कोर देगी क्योंकि भिन्न अक्षर स्ट्रिंग के बाद के हिस्से में आते हैं।
अलग-अलग परिस्थितियों में अलग-अलग डिस्टेंस मेट्रिक की ज़रूरत होती है। अपना तरीका चुनते समय इन प्रमुख कारकों पर विचार करें:
यह संरचित तुलना दर्शाती है कि प्रत्येक डिस्टेंस मेट्रिक का अलग उद्देश्य है, और हैमिंग डिस्टेंस विशेष रूप से उन परिस्थितियों में मूल्यवान है जहाँ इसकी सरलता और गति फिक्स्ड-लंबाई तुलना की आवश्यकताओं से मेल खाती है।
हैमिंग डिस्टेंस की खूबसूरती इसकी सरलता में है। अनुक्रमों के भिन्न होने वाले स्थानों की गणना करके, यह असमानता मापने का एक मज़बूत तरीका देता है—चाहे आप प्रेषित डेटा में त्रुटियों का पता लगा रहे हों या आनुवंशिक म्यूटेशन का विश्लेषण कर रहे हों। यह मेट्रिक खास तौर पर उन क्षेत्रों में चमकता है जहाँ हर स्थान समान महत्व रखता है और मुख्य चिंता प्रतिस्थापन होती है।
जब आप अपने काम में डिस्टेंस मेट्रिक्स का उपयोग खोजें, तो हैमिंग डिस्टेंस पर विचार करें जब:
डिस्टेंस मेट्रिक्स और अन्य मौलिक डेटा साइंस अवधारणाओं में अपनी विशेषज्ञता को आगे बढ़ाने के लिए, हमारे Data Scientist Certification प्रोग्राम का अन्वेषण करें, जो Python और R दोनों में उपलब्ध है।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स