
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Afstandsmaatstaven bieden essentiële manieren om verschillen tussen objecten te meten. Terwijl maatstaven zoals Euclidische afstand of Manhattan-afstand ruimtelijke verschillen meten, pakt de Hamming-afstand het anders aan: hij telt de posities waarop twee reeksen van elkaar verschillen. Dat maakt hem vooral waardevol voor foutdetectie, datavalidatie en informatietheorie.
Oorspronkelijk ontwikkeld door Richard Hamming in 1950 tijdens zijn werk aan codeverificatiesystemen bij Bell Labs, is de Hamming-afstand uitgegroeid tot veel meer dan zijn telecommunicatieroots. Tegenwoordig is het een belangrijke maatstaf in diverse domeinen, waaronder:
In deze gids bekijken we hoe de Hamming-afstand werkt, onderzoeken we praktische toepassingen en implementeren we hem in Python en R. De concepten en implementaties die we behandelen, versterken je vermogen om problemen op te lossen in datavalidatie, bio-informatica en machine learning.
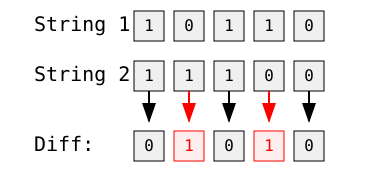
De Hamming-afstand meet het aantal posities waarop twee strings van gelijke lengte verschillende symbolen hebben. Zie het als het tellen van het minimum aantal substituties dat nodig is om de ene string in de andere te veranderen.
Bijvoorbeeld, bij het vergelijken van twee binaire strings:
Afbeelding door auteur
De Hamming-afstand is hier 2, omdat de strings op twee posities verschillen: de tweede en vierde bit.
Wiskundig geldt voor twee strings x en y van gelijke lengte n dat de Hamming-afstand D(x,y) als volgt wordt uitgedrukt:
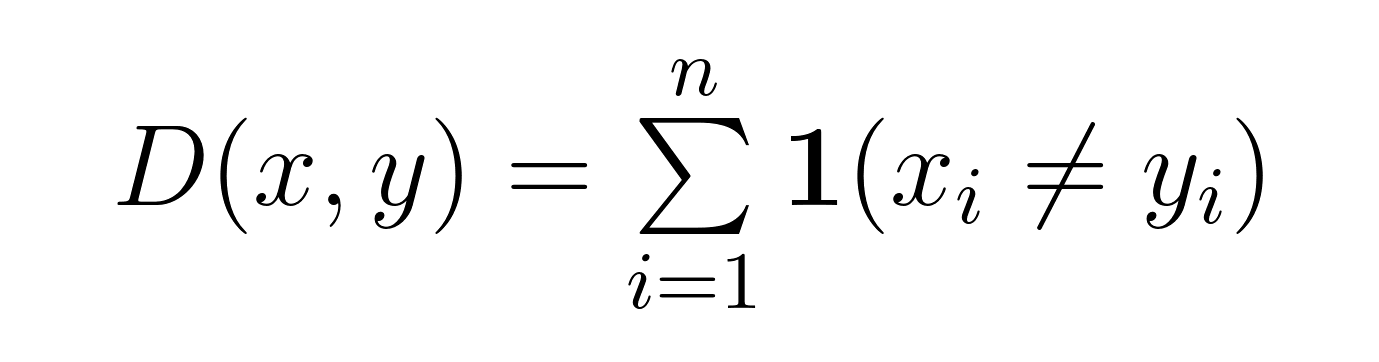
Deze formule telt de posities waarvoor xᵢ ≠ yᵢ. Voor binaire strings komt dit neer op het tellen van de posities waar bits verschillen. Voor andere typen reeksen (zoals DNA of tekst) telt hij de posities met verschillende symbolen.
Twee belangrijke eigenschappen om te onthouden:
Deze eigenschappen maken de Hamming-afstand ideaal voor situaties waarin:
Laten we aan de hand van voorbeelden bekijken hoe je de Hamming-afstand berekent, te beginnen met eenvoudige binaire strings en vervolgens met complexere toepassingen.
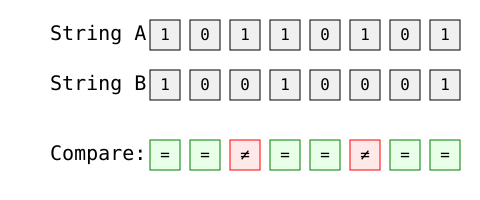
De meest rechttoe rechtaan toepassing van de Hamming-afstand is het vergelijken van binaire strings. Laten we twee 8-bits strings analyseren:
Afbeelding door auteur
Stapsgewijze berekening:
De Hamming-afstand is 2, omdat er twee posities zijn waar de strings verschillen (posities 3 en 6).
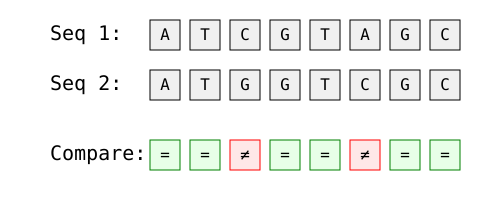
De Hamming-afstand wordt vaak gebruikt in de bio-informatica om genetische sequenties te vergelijken. Neem twee DNA-fragmenten:
Afbeelding door auteur
Stapsgewijze analyse:
Deze vergelijking helpt biologen genetische mutaties te kwantificeren en DNA-overeenkomsten te analyseren.
De Hamming-afstand werkt ook met gewone tekststrings van gelijke lengte:
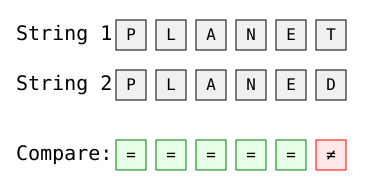
Afbeelding door auteur
De Hamming-afstand is hier 1, met het enige verschil op de laatste positie (‘T’ vs ‘D’).
Dit type vergelijking is nuttig bij:
Elk voorbeeld laat zien hoe de Hamming-afstand een eenvoudige maar effectieve manier biedt om verschillen tussen reeksen te kwantificeren, ongeacht het datatype dat wordt vergeleken. De kern is dat hij kijkt naar positiegewijze verschillen en de specifieke aard van de wijzigingen negeert.
De Hamming-afstand legde de basis voor foutdetecterende en foutcorrigerende codes in digitale communicatie. Door strategisch pariteitsbits toe te voegen om minimale afstanden tussen geldige codewoorden te creëren, kunnen systemen detecteren wanneer ontvangen data niet overeenkomt met geldige patronen en zelfs fouten corrigeren door te mappen naar het dichtstbijzijnde geldige codewoord. Dit principe drijft moderne technologieën zoals ECC-geheugen (Error-Correcting Code) in computers, foutcorrectie in QR-codes en communicatie met diepe ruimte, waar dataintegriteit cruciaal is.
In de informatietheorie wordt de Hamming-afstand gebruikt om betrouwbare communicatiesystemen te ontwerpen. Bij het maken van foutafhandelingscodes zorgen ingenieurs ervoor dat geldige berichten (codewoorden) met specifieke minimale aantallen bits van elkaar verschillen. Als geldige berichten bijvoorbeeld altijd minimaal twee bits verschillen, kan het systeem detecteren wanneer één bit tijdens transmissie is beschadigd. Als geldige berichten minimaal drie bits verschillen, kan het systeem zelfs enkelbitsfouten corrigeren door het dichtstbijzijnde geldige bericht te identificeren. Deze principes helpen robuuste systemen te bouwen, van satellietcommunicatie tot dataopslag.
Genetisch onderzoekers gebruiken de Hamming-afstand om DNA-sequenties te analyseren en mutaties te kwantificeren. Door genetische sequenties positie voor positie te vergelijken, kunnen wetenschappers puntmutaties identificeren, evolutionaire veranderingen volgen en genetische diversiteit bestuderen. Deze toepassing is vooral waardevol bij het bestuderen van ziektemutaties, waar inzicht in de exacte posities van genetische veranderingen helpt om te volgen hoe ziekten evolueren en zich verspreiden door populaties.
In machine learning dient de Hamming-afstand als similariteitsmaat voor binaire of categorische data. Het helpt kenmerkenvectoren te vergelijken in patroonherkenningstaken, similariteit te meten in aanbevelingssystemen en categorische data te analyseren in classificatieproblemen. Door de eenvoud en efficiënte berekening is de maat bijzonder nuttig bij hoog-dimensionale binaire data of wanneer snelle similariteitsberekeningen nodig zijn voor grote datasets.
De Hamming-afstand vormt een metrische ruimte in wiskundige zin, wat betekent dat hij voldoet aan vier fundamentele regels. Ten eerste is de afstand altijd niet-negatief: je kunt geen negatief aantal posities hebben waarop strings verschillen. Ten tweede is de afstand tussen twee reeksen nul als en alleen als ze identiek zijn. Ten derde is de afstand symmetrisch: A met B vergelijken geeft hetzelfde resultaat als B met A vergelijken. Ten slotte voldoet hij aan de driehoeksongelijkheid: de afstand tussen reeksen A en C kan niet groter zijn dan de som van de afstanden van A naar B en van B naar C.
Bij binaire strings krijgt de Hamming-afstand speciale kenmerken die hem bijzonder nuttig maken voor foutdetectie. Voor twee binaire strings van lengte n kan hun Hamming-afstand niet groter zijn dan n, wat alleen voorkomt als de strings elkaars complement zijn. De kans op een specifieke Hamming-afstand “d” tussen twee willekeurige binaire strings volgt een binomiale verdeling, waarbij de meest waarschijnlijke afstand n/2 is. Deze eigenschap helpt bij het ontwerpen van foutdetecterende codes die kunnen herkennen wanneer bits tijdens de overdracht zijn omgedraaid.
Python biedt zowel functies uit standaardbibliotheken als maatwerkimplementaties om de Hamming-afstand te berekenen. De SciPy-bibliotheek biedt de meest efficiënte oplossing via zijn ruimtelijke afstandsfuncties:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
Voor wie de voorkeur geeft aan een maatwerkimplementatie:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101")) # Output: 1R biedt een eenvoudige manier om de Hamming-afstand te berekenen met basisfuncties:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
Wil je voortbouwen op deze codevoorbeelden en meer toepassingen van afstandsmaatstaven in de praktijk verkennen? Bekijk dan deze uitgebreide resources:
Deze cursussen helpen je verder te gaan dan basisimplementaties en te begrijpen hoe afstandsmaatstaven impact hebben op machine-learningtoepassingen, ongeacht je voorkeurstaal.
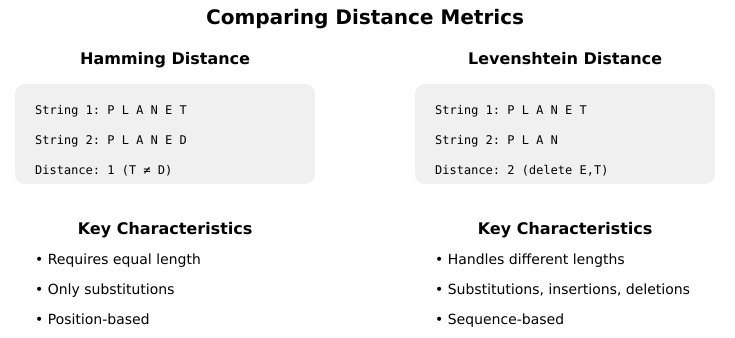
Afbeelding door auteur
De Levenshtein-afstand geeft het minimumaantal bewerkingen op tekenniveau weer dat nodig is om de ene string in de andere te veranderen. In tegenstelling tot de Hamming-afstand kan hij strings van verschillende lengtes aan door invoegingen en verwijderingen naast substituties mee te nemen. Deze flexibiliteit maakt hem bijzonder waardevol voor spellingcontrole, DNA-sequentie-uitlijning en fuzzy string matching, al gaat deze veelzijdigheid ten koste van hogere computationele complexiteit. Bij het vergelijken van strings als "planet" en "plan" zou de Levenshtein-afstand het verwijderen van ‘e’ en ‘t’ als twee bewerkingen tellen, terwijl de Hamming-afstand deze vergelijking helemaal niet kan maken.
Boven op de standaard Levenshtein-afstand voegt de Damerau-Levenshtein-afstand de transpositie van aangrenzende tekens toe als geldige bewerking. Deze toevoeging maakt hem bijzonder effectief bij het opvangen van veelvoorkomende typfouten waarbij tekens per ongeluk zijn omgewisseld. Zo wordt bij het vergelijken van "form" met "from" dit gezien als één transpositie in plaats van twee afzonderlijke substituties. Deze maat is wijdverbreid in NLP-toepassingen, vooral in geautomatiseerde spellingcorrectiesystemen waar karaktertranspositie een veelvoorkomende typfout is.
De Jaro-Winkler-afstand volgt een unieke aanpak door te focussen op posities van tekens, met name door overeenkomsten aan het begin van strings zwaarder te wegen. In plaats van bewerkingen te tellen, levert hij een similariteitsscore op tussen 0 en 1, waarbij 1 een perfecte match betekent. Deze maat blinkt uit in het vergelijken van eigennamen en korte strings, wat hem ideaal maakt voor record linkage en deduplicatie. Bij het vergelijken van namen als "Martha" en "Marhta" geeft hij bijvoorbeeld een hogere similariteitsscore omdat de afwijkende tekens later in de string voorkomen.
Verschillende situaties vragen om verschillende afstandsmaatstaven. Houd met name rekening met deze factoren bij je keuze:
Deze gestructureerde vergelijking laat zien hoe elke afstandsmaat een eigen doel dient, waarbij de Hamming-afstand vooral waardevol is in scenario’s waar zijn eenvoud en snelheid aansluiten bij vereisten voor vergelijkingen met vaste lengte.
De elegantie van de Hamming-afstand zit in de eenvoud. Door posities te tellen waar reeksen verschillen, biedt hij een robuuste manier om ongelijkheid te meten, of je nu fouten in verzonden data detecteert of genetische mutaties analyseert. Deze maat schittert vooral in domeinen waar elke positie even zwaar weegt en substituties de primaire zorg zijn.
Overweeg de Hamming-afstand in je eigen werk wanneer je:
Wil je je expertise in afstandsmaatstaven en andere fundamentele data science-concepten verder uitbouwen? Verken dan ons Data Scientist Certification-programma, beschikbaar in zowel Python als R.
Leren met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


