
Last chance! 50% off DataCamp Premium
Sale ends in
Metrik jarak menyediakan cara penting untuk mengukur perbedaan antarobjek. Sementara metrik seperti Euclidean atau Manhattan mengukur perbedaan secara spasial, jarak Hamming mengambil pendekatan berbeda: metrik ini menghitung posisi di mana dua urutan berbeda. Hal ini membuatnya sangat berguna untuk deteksi kesalahan, validasi data, dan teori informasi.
Awalnya dikembangkan oleh Richard Hamming pada tahun 1950 saat bekerja pada sistem verifikasi kode di Bell Labs, jarak Hamming telah berkembang melampaui akar telekomunikasinya. Kini, metrik ini menjadi ukuran kunci di berbagai bidang, termasuk:
Dalam panduan ini, kita akan membahas cara kerja jarak Hamming, meninjau penerapannya secara praktis, dan mengimplementasikannya di Python dan R. Konsep dan implementasi yang kita bahas akan meningkatkan kemampuan Anda memecahkan masalah dalam validasi data, bioinformatika, dan machine learning.
Jarak Hamming mengukur jumlah posisi di mana dua string dengan panjang yang sama memiliki simbol yang berbeda. Anggap saja sebagai menghitung jumlah minimum substitusi yang diperlukan untuk mengubah satu string menjadi string lain.
Sebagai contoh, membandingkan dua string biner:
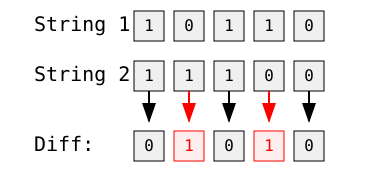
Gambar oleh Penulis
Jarak Hamming di sini adalah 2 karena string berbeda pada dua posisi — bit kedua dan keempat.
Secara matematis, untuk dua string x dan y dengan panjang sama n, jarak Hamming D(x,y) dinyatakan sebagai:
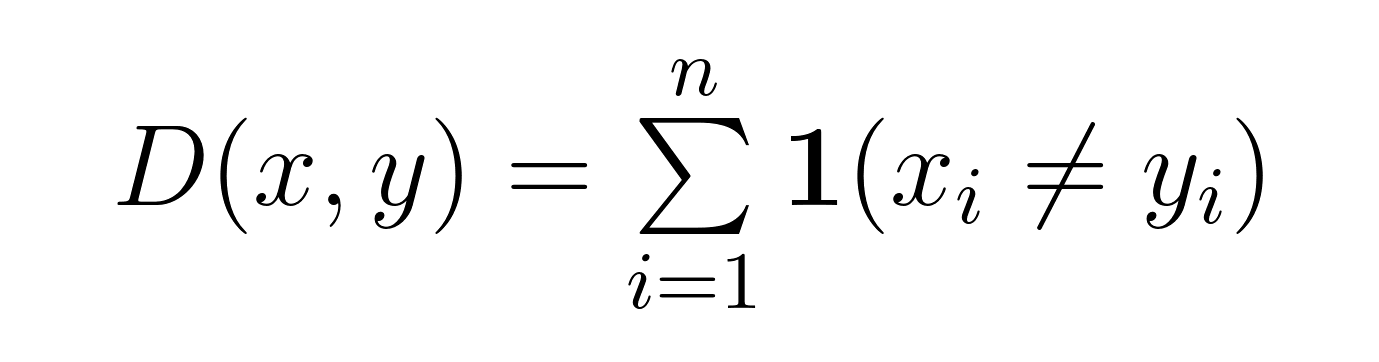
Rumus ini menghitung posisi di mana xᵢ ≠ yᵢ. Untuk string biner, ini menyederhana menjadi menghitung posisi di mana bit berbeda. Untuk jenis urutan lain (seperti DNA atau teks), rumus ini menghitung posisi dengan simbol yang berbeda.
Dua sifat kunci yang perlu diperhatikan:
Sifat-sifat ini menjadikan jarak Hamming ideal untuk skenario di mana:
Mari kita bahas cara menghitung jarak Hamming melalui contoh, mulai dari string biner sederhana hingga aplikasi yang lebih kompleks.
Penerapan paling langsung dari jarak Hamming adalah membandingkan string biner. Mari analisis dua string 8-bit:
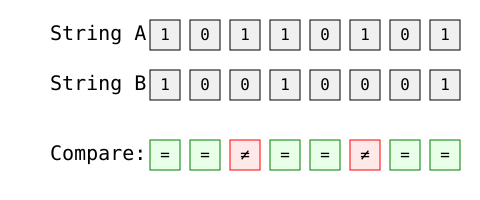
Gambar oleh Penulis
Perhitungan langkah demi langkah:
Jarak Hamming adalah 2, karena ada dua posisi di mana string berbeda (posisi 3 dan 6).
Jarak Hamming sering digunakan dalam bioinformatika untuk membandingkan urutan genetik. Pertimbangkan dua fragmen DNA:
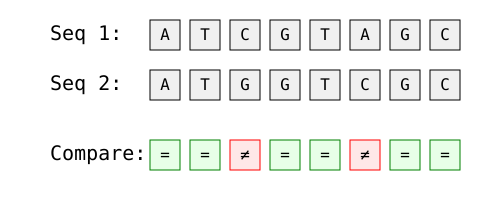
Gambar oleh Penulis
Analisis langkah demi langkah:
Perbandingan ini membantu ahli biologi mengukur mutasi genetik dan menganalisis kesamaan DNA.
Jarak Hamming juga berlaku untuk string teks biasa dengan panjang yang sama:
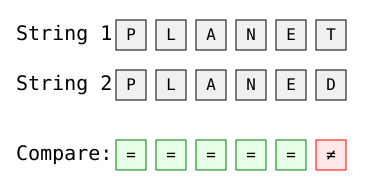
Gambar oleh Penulis
Jarak Hamming di sini adalah 1, dengan satu-satunya perbedaan pada posisi terakhir ('T' vs 'D').
Jenis perbandingan ini berguna dalam:
Setiap contoh menunjukkan bagaimana jarak Hamming memberikan cara yang sederhana namun efektif untuk mengukur perbedaan antarurutan, terlepas dari jenis data yang dibandingkan. Wawasan utamanya adalah metrik ini melihat perbedaan per posisi sambil mengabaikan sifat spesifik dari perubahan tersebut.
Jarak Hamming menjadi dasar bagi kode pendeteksi dan pengoreksi kesalahan dalam komunikasi digital. Dengan menambahkan bit paritas secara strategis untuk menciptakan jarak minimum antar codeword yang valid, sistem dapat mendeteksi saat data yang diterima tidak sesuai dengan pola yang valid dan bahkan mengoreksi kesalahan dengan memetakan ke codeword valid terdekat. Prinsip ini mendukung teknologi modern seperti memori ECC (Error-Correcting Code) pada komputer, koreksi kesalahan pada kode QR, dan sistem komunikasi luar angkasa yang sangat menuntut integritas data.
Teori informasi menggunakan jarak Hamming untuk merancang sistem komunikasi yang andal. Saat membuat kode penanganan kesalahan, para insinyur memastikan pesan valid (codeword) berbeda dengan jumlah bit minimum tertentu. Misalnya, jika pesan valid selalu berbeda setidaknya dua bit, sistem dapat mendeteksi saat satu bit rusak selama transmisi. Jika pesan valid berbeda setidaknya tiga bit, sistem bahkan dapat mengoreksi kesalahan satu bit dengan mengidentifikasi pesan valid terdekat. Prinsip-prinsip ini membantu menciptakan sistem komunikasi yang tangguh, digunakan mulai dari komunikasi satelit hingga penyimpanan data.
Peneliti genetik menggunakan jarak Hamming untuk menganalisis urutan DNA dan mengukur mutasi. Dengan membandingkan urutan genetik per posisi, ilmuwan dapat mengidentifikasi mutasi titik, melacak perubahan evolusioner, dan mempelajari keragaman genetik. Penerapan ini sangat berharga dalam mempelajari mutasi penyakit, di mana memahami posisi tepat perubahan genetik membantu peneliti melacak bagaimana penyakit berevolusi dan menyebar dalam populasi.
Dalam machine learning, jarak Hamming berfungsi sebagai metrik kesamaan untuk data biner atau kategorikal. Metrik ini membantu membandingkan vektor fitur dalam tugas pengenalan pola, mengukur kesamaan dalam sistem rekomendasi, dan menganalisis data kategorikal dalam masalah klasifikasi. Kesederhanaan dan efisiensi perhitungannya membuatnya sangat berguna saat bekerja dengan data biner berdimensi tinggi atau ketika perhitungan kesamaan cepat diperlukan untuk kumpulan data besar.
Jarak Hamming membentuk ruang metrik matematis, yang berarti memenuhi empat aturan dasar. Pertama, jarak selalu tidak negatif — Anda tidak bisa memiliki jumlah posisi negatif di mana string berbeda. Kedua, jarak antara dua urutan adalah nol jika dan hanya jika keduanya identik. Ketiga, jarak bersifat simetris — membandingkan urutan A dengan B memberikan hasil yang sama seperti membandingkan B dengan A. Terakhir, metrik ini memenuhi ketaksamaan segitiga: jarak antara urutan A dan C tidak boleh lebih besar dari jumlah jarak dari A ke B dan B ke C.
Saat bekerja dengan string biner, jarak Hamming memiliki karakteristik khusus yang membuatnya sangat berguna untuk deteksi kesalahan. Untuk dua string biner dengan panjang n, jarak Hamming tidak dapat melebihi n, yang terjadi hanya ketika kedua string merupakan komplemen satu sama lain. Probabilitas jarak Hamming tertentu “d” antara dua string biner acak mengikuti distribusi binomial, dengan jarak yang paling mungkin adalah n/2. Sifat ini membantu dalam merancang kode pendeteksi kesalahan yang dapat mengenali saat bit terbalik selama transmisi.
Python menawarkan fungsi pustaka bawaan dan implementasi khusus untuk menghitung jarak Hamming. Pustaka SciPy menyediakan solusi paling efisien melalui fungsi jarak spasialnya:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
Bagi yang lebih menyukai implementasi khusus:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101")) # Output: 1R menyediakan cara sederhana untuk menghitung jarak Hamming menggunakan fungsi dasar:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
Untuk memperluas contoh pengkodean ini dan menjelajahi lebih banyak penerapan metrik jarak dalam praktik, lihat sumber daya komprehensif berikut:
Kursus-kursus ini akan membantu Anda melampaui implementasi dasar untuk memahami bagaimana metrik jarak memengaruhi aplikasi machine learning, apa pun bahasa pemrograman pilihan Anda.
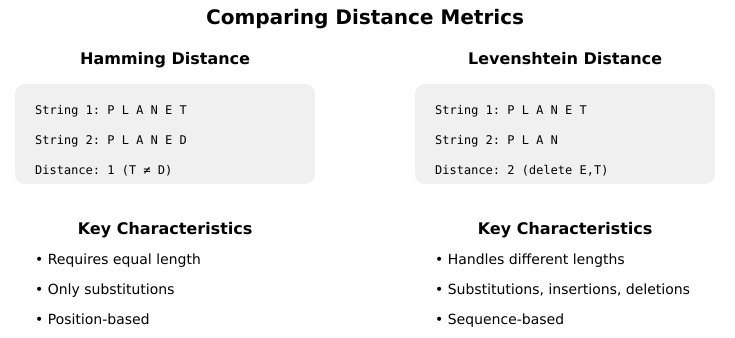
Gambar oleh Penulis
Jarak Levenshtein merepresentasikan jumlah minimum suntingan satu karakter yang diperlukan untuk mengubah satu string menjadi string lain. Berbeda dengan jarak Hamming, metrik ini dapat menangani string dengan panjang berbeda dengan mempertimbangkan penyisipan dan penghapusan selain substitusi. Fleksibilitas ini membuatnya sangat berguna untuk pemeriksa ejaan, penyelarasan urutan DNA, dan pencocokan string fuzzy, meskipun keserbagunaan ini datang dengan kompleksitas komputasi yang lebih tinggi. Saat membandingkan string seperti "planet" dan "plan", jarak Levenshtein akan menghitung penghapusan 'e' dan 't' sebagai dua operasi, sementara jarak Hamming sama sekali tidak dapat melakukan perbandingan ini.
Mengembangkan jarak Levenshtein standar, jarak Damerau-Levenshtein menambahkan transposisi karakter yang berdekatan sebagai operasi yang valid. Penambahan ini membuatnya sangat efektif untuk menangkap kesalahan pengetikan umum saat karakter tertukar secara tidak sengaja. Misalnya, saat membandingkan "form" dengan "from", metrik ini akan menghitungnya sebagai satu transposisi daripada dua substitusi terpisah. Metrik ini banyak digunakan dalam aplikasi pemrosesan bahasa alami, khususnya dalam sistem koreksi ejaan otomatis di mana transposisi karakter merupakan kesalahan pengetikan yang umum.
Jarak Jaro-Winkler mengambil pendekatan unik dengan berfokus pada bobot posisi karakter, khususnya mengutamakan kecocokan di awal string. Alih-alih menghitung operasi penyuntingan, metrik ini menghasilkan skor kemiripan antara 0 dan 1, di mana 1 menunjukkan kecocokan sempurna. Metrik ini unggul dalam membandingkan nama diri dan string pendek, sehingga ideal untuk penautan rekaman dan tugas deduplikasi. Misalnya, saat membandingkan nama seperti "Martha" dan "Marhta", metrik ini akan memberikan skor kemiripan lebih tinggi karena karakter yang berbeda muncul lebih akhir dalam string.
Skenario yang berbeda memerlukan metrik jarak yang berbeda. Pertimbangkan faktor-faktor kunci berikut saat memilih pendekatan:
Perbandingan terstruktur ini menunjukkan bagaimana setiap metrik jarak memiliki tujuan yang berbeda, dengan jarak Hamming sangat berharga dalam skenario di mana kesederhanaan dan kecepatannya selaras dengan kebutuhan perbandingan panjang tetap.
Keanggunan jarak Hamming terletak pada kesederhanaannya. Dengan menghitung posisi di mana urutan berbeda, metrik ini memberikan cara yang andal untuk mengukur ketidakmiripan, baik Anda mendeteksi kesalahan dalam data yang ditransmisikan maupun menganalisis mutasi genetik. Metrik ini sangat unggul di domain di mana setiap posisi sama pentingnya dan substitusi menjadi perhatian utama.
Saat Anda mengeksplorasi metrik jarak dalam pekerjaan Anda, pertimbangkan jarak Hamming ketika:
Untuk terus membangun keahlian Anda dalam metrik jarak dan konsep dasar ilmu data lainnya, jelajahi program Sertifikasi Data Scientist kami, tersedia dalam Python dan R.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt




