Python में क्लस्टर विश्लेषण
BasicSkill Level
4 घंटा
65.9K learners

क्लस्टरिंग मॉडल डेटा को अलग-अलग “क्लस्टर्स” या समूहों में बाँटने का लक्ष्य रखते हैं। यह विश्लेषण में एक रोचक परिप्रेक्ष्य दे सकता है, या सुपरवाइज़्ड लर्निंग एल्गोरिद्म में एक फीचर के रूप में काम कर सकता है।
एक सामाजिक माहौल की कल्पना करें जहाँ लोग कमरे में अलग-अलग गोल घेरों में चर्चा कर रहे हैं। जब आप पहली बार कमरे को देखते हैं, तो बस लोगों का एक समूह दिखता है। आप मानसिक रूप से हर समूह के केंद्र में एक बिंदु रख सकते हैं और उस बिंदु को एक अद्वितीय पहचानकर्ता दे सकते हैं। फिर आप हर समूह को उस अद्वितीय नाम से संदर्भित कर पाएँगे। मूल रूप से k-means क्लस्टरिंग डेटा के साथ यही करती है।
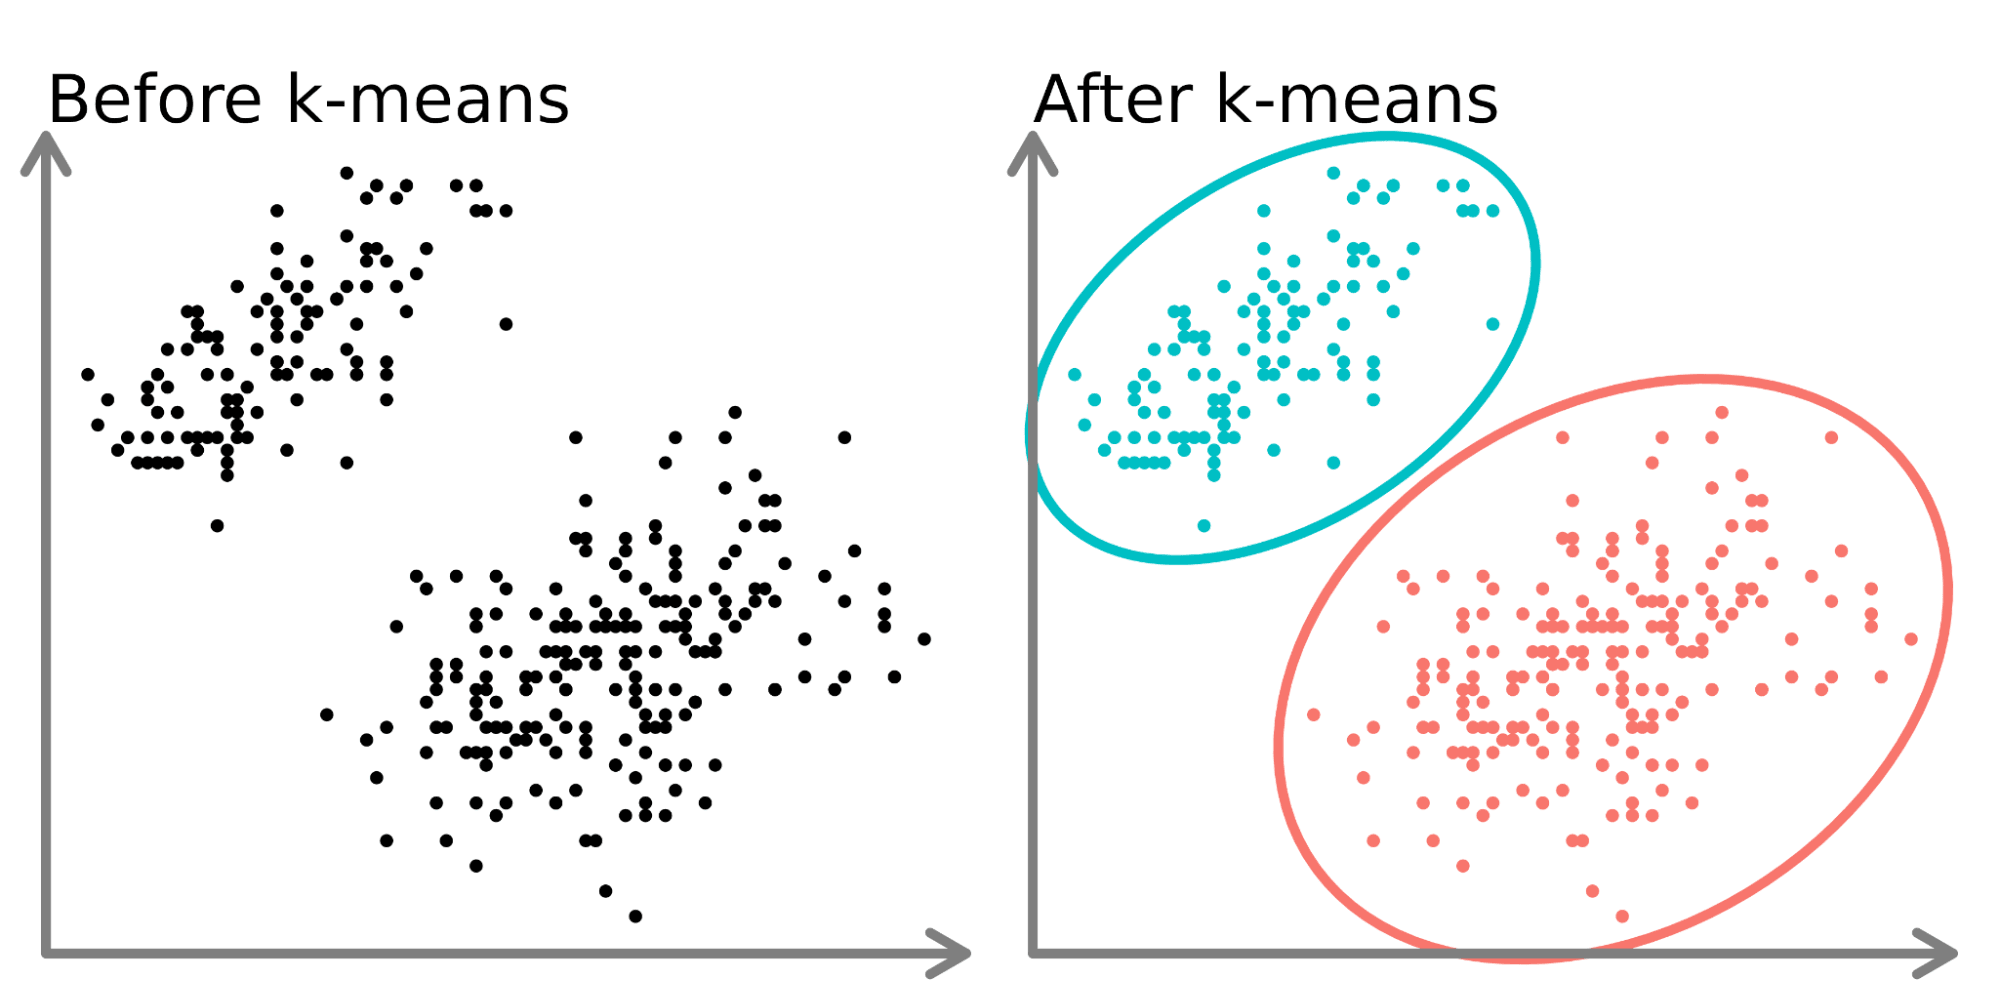
ऊपर के आरेख के बाएँ हिस्से में, हम 2 अलग-अलग बिंदु-समुच्चय देखते हैं जो अनलेबल्ड हैं और समान डेटा बिंदुओं के रूप में रंगे गए हैं। इस डेटा पर k-means मॉडल फिट करना (दाएँ हिस्से में) 2 स्पष्ट समूह प्रकट कर सकता है (अलग-अलग वृत्तों और रंगों में दिखाए गए)।
दो आयामों में इंसानों के लिए इन क्लस्टर्स को विभाजित करना आसान है, लेकिन अधिक आयामों में आपको एक मॉडल की आवश्यकता होती है।
इस ट्यूटोरियल में, हम Kaggle से कैलिफ़ोर्निया हाउसिंग डेटा (यहाँ) का उपयोग करेंगे। हम लोकेशन डेटा (latitude और longitude) के साथ-साथ median house value का उपयोग करेंगे। हम घरों को लोकेशन के आधार पर क्लस्टर करेंगे और देखेंगे कि कैलिफ़ोर्निया में घरों की कीमतें कैसे बदलती हैं। हम डेटासेट को अपने वर्किंग डायरेक्टरी में ‘housing.csv’ नाम की csv फ़ाइल के रूप में सहेजते हैं और उसे pandas से पढ़ते हैं।
import pandas as pd

home_data = pd.read_csv('housing.csv', usecols = ['longitude', 'latitude', 'median_house_value'])
home_data.head()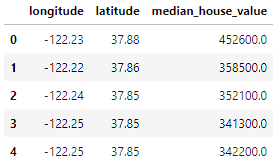
डेटा में 3 चर शामिल हैं जिन्हें हमने usecols पैरामीटर से चुना है:
अन्य मशीन लर्निंग एल्गोरिद्म की तरह, k-Means क्लस्टरिंग का भी एक वर्कफ़्लो होता है (मशीन लर्निंग वर्कफ़्लो का विस्तृत विवरण पाने के लिए A Beginner's Guide to The Machine Learning Workflow देखें)।
इस ट्यूटोरियल में, हम डेटा तैयारी में डेटा एकत्र करने और विभाजित करने पर, तथा मॉडलिंग में हाइपरपैरामीटर ट्यूनिंग, अपने मॉडल को प्रशिक्षित करने और मॉडल के प्रदर्शन का आकलन करने पर ध्यान देंगे। अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म में काफी काम हाइपरपैरामीटर ट्यूनिंग और प्रदर्शन के आकलन में होता है ताकि आपके मॉडल से सर्वोत्तम परिणाम मिलें।
हम अपने हाउसिंग डेटा का विज़ुअलाइज़ेशन करके शुरू करते हैं। हम किसी ब्लॉक में माध्यिका कीमत के आधार पर लोकेशन डेटा को हीटमैप से देखते हैं। इस ट्यूटोरियल में हम जल्दी से प्लॉट बनाने के लिए Seaborn का उपयोग करेंगे (यह ग्राफ़ कैसे बनाए जाते हैं, इसे बेहतर समझने के लिए हमारा Introduction to Data Visualization with Seaborn कोर्स देखें)।
import seaborn as sns

sns.scatterplot(data = home_data, x = 'longitude', y = 'latitude', hue = 'median_house_value')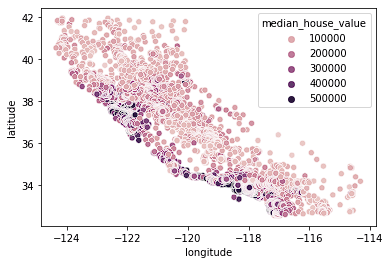
हम देखते हैं कि अधिकतर महंगे घर कैलिफ़ोर्निया के पश्चिमी तट पर हैं, और अलग-अलग क्षेत्रों में मध्यम कीमत वाले घरों के क्लस्टर हैं। यह अपेक्षित है क्योंकि आम तौर पर वॉटरफ़्रंट प्रॉपर्टीज़ की कीमतें अंदरूनी इलाक़ों के घरों से ज़्यादा होती हैं।
जब आप केवल 2 या 3 फ़ीचर्स का उपयोग करते हैं तो क्लस्टर्स को पहचानना अक्सर आसान होता है। जैसे-जैसे आयाम बढ़ते हैं, यह कठिन या असंभव हो जाता है जब
दूरी-आधारित एल्गोरिद्म, जैसे k-Means क्लस्टरिंग, के साथ काम करते समय हमें डेटा को सामान्यीकृत करना होता है। यदि हम डेटा को सामान्यीकृत नहीं करते, तो अलग-अलग स्केल वाले वेरिएबल्स को उस दूरी सूत्र में अलग-अलग वज़न मिलेंगे जिसे प्रशिक्षण के दौरान ऑप्टिमाइज़ किया जा रहा है। उदाहरण के लिए, यदि हम latitude और longitude के साथ-साथ price को भी क्लस्टर में शामिल करें, तो price का प्रभाव अनुपातहीन रूप से बड़ा होगा क्योंकि उसका स्केल लोकेशन वेरिएबल्स की तुलना में काफी बड़ा और व्यापक है।
पहले, हम sklearn से train_test_split का उपयोग करके ट्रेनिंग और टेस्ट विभाजन सेटअप करते हैं।
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(home_data[['latitude', 'longitude']], home_data[['median_house_value']], test_size=0.33, random_state=0)
इसके बाद, हम sklearn के preprocessing.normalize() मेथड से ट्रेनिंग और टेस्ट डेटा को सामान्यीकृत करते हैं।
from sklearn import preprocessing

X_train_norm = preprocessing.normalize(X_train)
X_test_norm = preprocessing.normalize(X_test)पहले इटरेशन के लिए, हम मनमाने ढंग से क्लस्टर्स की संख्या (k) को 3 चुनेंगे। sklearn में मॉडल बनाना और फिट करना बहुत सरल है। हम KMeans का एक इंस्टेंस बनाएँगे, n_clusters एट्रिब्यूट से क्लस्टर्स की संख्या परिभाषित करेंगे, n_init सेट करेंगे, जो अलग-अलग सेंट्रोइड सीड्स के साथ एल्गोरिद्म चलने की संख्या तय करता है, “auto” पर, और random_state को 0 सेट करेंगे ताकि हर बार कोड चलाने पर वही परिणाम मिले। इसके बाद हम fit() मेथड से मॉडल को सामान्यीकृत ट्रेनिंग डेटा पर फिट कर सकते हैं।
from sklearn import KMeans

kmeans = KMeans(n_clusters = 3, random_state = 0, n_init='auto')
kmeans.fit(X_train_norm)
डेटा फिट होने के बाद, हम labels_ एट्रिब्यूट से लेबल्स एक्सेस कर सकते हैं। नीचे, हम अभी फिट किए गए डेटा को विज़ुअलाइज़ करते हैं।
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = kmeans.labels_)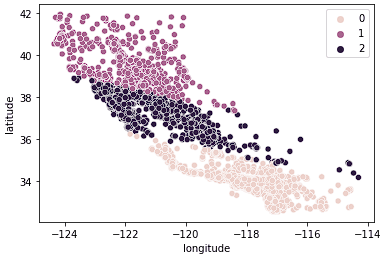
हम देखते हैं कि अब डेटा स्पष्ट रूप से 3 अलग-अलग समूहों (उत्तरी कैलिफ़ोर्निया, मध्य कैलिफ़ोर्निया और दक्षिणी कैलिफ़ोर्निया) में विभाजित हो गया है। हम इन 3 समूहों में माध्यिका घर कीमतों के वितरण को बॉक्सप्लॉट से भी देख सकते हैं।
sns.boxplot(x = kmeans.labels_, y = y_train['median_house_value'])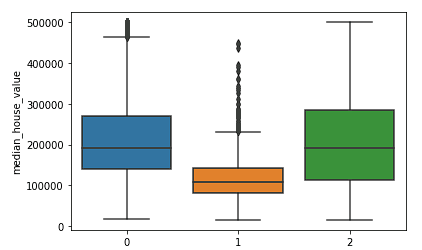
हम स्पष्ट रूप से देखते हैं कि उत्तरी और दक्षिणी क्लस्टर्स (क्लस्टर 0 और 2) की माध्यिका घर कीमतों के वितरण समान हैं और केंद्रीय क्लस्टर (क्लस्टर 1) की कीमतों से अधिक हैं।
हम क्लस्टरिंग एल्गोरिद्म के प्रदर्शन का मूल्यांकन sklearn.metrics में उपलब्ध Silhouette स्कोर से कर सकते हैं, जहाँ कम स्कोर बेहतर फिट को दर्शाता है।
from sklearn.metrics import silhouette_score

silhouette_score(X_train_norm, kmeans.labels_, metric='euclidean')
क्योंकि हमने अलग-अलग क्लस्टर्स की ताकत नहीं जाँची है, हमें नहीं पता कि k = 3 वाला मॉडल कितना अच्छा फिट है। अगला सेक्शन में, हम अलग-अलग क्लस्टर्स का अन्वेषण करेंगे और प्रदर्शन की तुलना करेंगे ताकि अपने मॉडल के लिए सर्वोत्तम हाइपरपैरामीटर मान तय कर सकें।
k-means क्लस्टरिंग की कमजोरी यह है कि मॉडल चलाकर हमें क्लस्टर्स की संख्या स्वतः ज्ञात नहीं होती। हमें मानों की रेंज का परीक्षण करना होता है और k का सर्वोत्तम मान तय करना होता है। आमतौर पर, हम Elbow विधि से यह निर्णय लेते हैं ताकि न तो बहुत अधिक क्लस्टर्स लेकर ओवरफ़िटिंग हो और न ही बहुत कम लेकर अंडरफ़िटिंग।
हम नीचे वाला लूप बनाते हैं ताकि अलग-अलग मॉडलों के परिणामों को टेस्ट और स्टोर कर सकें और क्लस्टर्स की सर्वोत्तम संख्या पर निर्णय ले सकें।
K = range(2, 8)
fits = []
score = []


for k in K:
    # train the model for current value of k on training data
    model = KMeans(n_clusters = k, random_state = 0, n_init='auto').fit(X_train_norm)

    # append the model to fits
    fits.append(model)

    # Append the silhouette score to scores
    score.append(silhouette_score(X_train_norm, model.labels_, metric='euclidean'))
इसके बाद हम पहले कुछ अलग-अलग k के मानों को विज़ुअली देखते हैं।
सबसे पहले k = 2 देखते हैं।
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[0].labels_)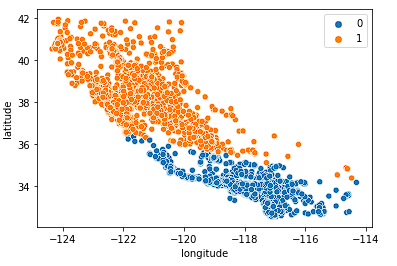
मॉडल राज्य को दो हिस्सों में बाँटने का ठीक-ठाक काम करता है, लेकिन शायद कैलिफ़ोर्निया हाउसिंग मार्केट की पर्याप्त बारीकियाँ नहीं पकड़ता।
अगला, k = 4 देखते हैं।
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[2].labels_)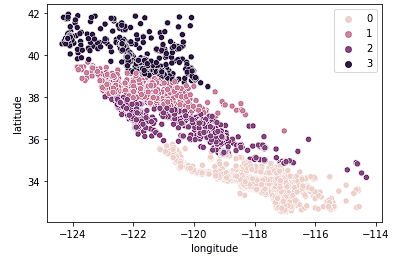
यह प्लॉट राज्य भर में घरों के उत्तर या दक्षिण में होने के आधार पर कैलिफ़ोर्निया को अधिक तार्किक क्लस्टर्स में समूहित करता दिखता है। यह मॉडल संभवतः राज्य भर में आगे बढ़ते हुए बाज़ार की और बारीकियाँ पकड़ता है।
अंत में, k = 7 देखते हैं।
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[2].labels_)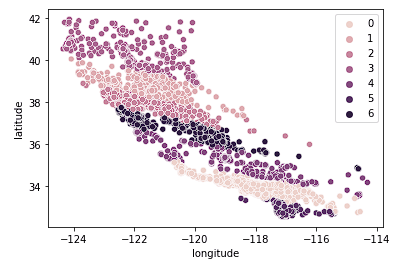
ऊपर का ग्राफ़ बहुत अधिक क्लस्टर्स वाला प्रतीत होता है। हमने क्लस्टर्स की आसान व्याख्या को “अधिक सटीक” भू-समूहीकरण परिणाम के लिए त्याग दिया है।
आम तौर पर, जैसे-जैसे हम K का मान बढ़ाते हैं, एक बिंदु तक क्लस्टर्स और उनके प्रतिनिधित्व में सुधार दिखाई देता है। फिर घटती वापसी (diminishing returns) या और भी खराब प्रदर्शन दिखने लगता है। हम एक एल्बो प्लॉट से इसे विज़ुअली देख सकते हैं, जहाँ y-अक्ष फिट की गुणवत्ता का माप है और x-अक्ष k का मान।
sns.lineplot(x = K, y = score)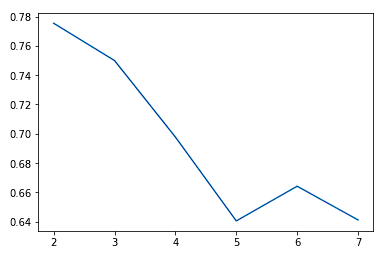
हम आम तौर पर उस बिंदु को चुनते हैं जहाँ प्रदर्शन में सुधार समतल होने लगता है या बदतर होने लगता है। हम देखते हैं कि k = 5 शायद सबसे अच्छा है जिसे हम बिना ओवरफ़िटिंग के कर सकते हैं।
हम यह भी देखते हैं कि क्लस्टर्स कैलिफ़ोर्निया को अलग-अलग क्लस्टर्स में बाँटने का अपेक्षाकृत अच्छा काम करते हैं और ये क्लस्टर्स अलग-अलग मूल्य श्रेणियों से भी काफ़ी हद तक मेल खाते हैं, जैसा कि नीचे दिखाया गया है।
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[3].labels_)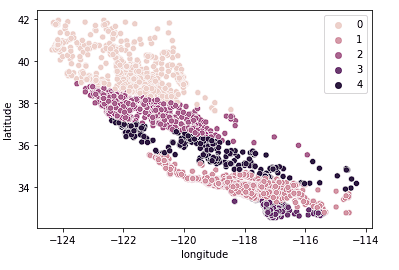
sns.boxplot(x = fits[3].labels_, y = y_train['median_house_value'])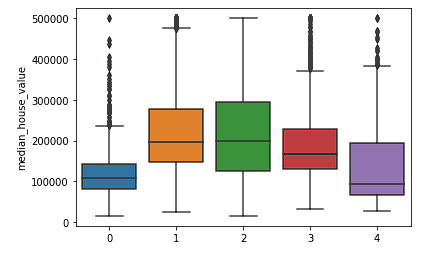
k-means क्लस्टरिंग गोलाकार डेटा पर सबसे अच्छा प्रदर्शन करती है। गोलाकार डेटा वे हैं जो स्पेस में एक-दूसरे के क़रीब समूह बनाते हैं। इसे 2 या 3 आयामी स्पेस में अधिक आसानी से विज़ुअलाइज़ किया जा सकता है। जो डेटा गोलाकार नहीं हैं या होने चाहिए, वे k-means क्लस्टरिंग के साथ अच्छा काम नहीं करते। उदाहरण के लिए, नीचे दिखाए गए डेटा पर k-means अच्छा नहीं करेगा क्योंकि हम दो वृत्तों या चापों को अलग-अलग क्लस्टर करने के लिए विशिष्ट सेंट्रोइड्स नहीं ढूँढ पाएँगे, जबकि दृश्य रूप से वे स्पष्ट रूप से दो अलग-अलग वृत्त और चाप हैं जिन्हें उसी तरह लेबल किया जाना चाहिए।
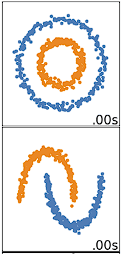
कई अन्य क्लस्टरिंग एल्गोरिद्म हैं जो गैर-गोलाकार डेटा को क्लस्टर करने का अच्छा काम करते हैं, जिन पर Clustering in Machine Learning: 5 Essential Clustering Algorithms में चर्चा की गई है।
डेटा बाँटने का निर्णय आपके क्लस्टरिंग लक्ष्यों पर निर्भर करता है। यदि लक्ष्य आपके विश्लेषण के अंत में डेटा को क्लस्टर करना है, तो यह आवश्यक नहीं है। यदि आप क्लस्टर्स का उपयोग सुपरवाइज़्ड लर्निंग मॉडल में एक फीचर या पूर्वानुमान के लिए कर रहे हैं (जैसे हम Scikit-Learn Tutorial: Baseball Analytics Pt 1 ट्यूटोरियल में करते हैं), तो आपको सुपरवाइज़्ड लर्निंग वर्कफ़्लो के सर्वोत्तम अभ्यासों का पालन सुनिश्चित करने के लिए क्लस्टरिंग से पहले अपने डेटा को विभाजित करना होगा।
अब जब हमने Python में k-means क्लस्टरिंग की बुनियादी बातें कवर कर ली हैं, तो आप Unsupervised Learning in Python कोर्स देख सकते हैं—k-means और अन्य अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म का अच्छा परिचय। हमारा अधिक उन्नत कोर्स, Cluster Analysis in Python, क्लस्टरिंग एल्गोरिद्म पर गहराई से नज़र डालता है और Python में उन्हें कैसे बनाना और ट्यून करना सिखाता है। अंत में, आप An Introduction to Hierarchical Clustering in Python ट्यूटोरियल भी देख सकते हैं, जो डेटा से हायरार्कीज़ बनाने के लिए वैकल्पिक एल्गोरिद्म का उपयोग करता है।
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स