

यह ट्यूटोरियल k-nearest neighbors (kNN) एल्गोरिदम की अवधारणा, वर्कफ़्लो, और उदाहरणों को कवर करेगा। यह एक लोकप्रिय सुपरवाइज़्ड मॉडल है जिसका उपयोग वर्गीकरण और प्रतिगमन दोनों के लिए किया जाता है, तथा दूरी फ़ंक्शंस, वोटिंग सिस्टम, और हाइपरपैरामीटर ऑप्टिमाइज़ेशन को समझने का एक उपयोगी तरीका है।
इस ट्यूटोरियल से अधिकतम लाभ उठाने के लिए, आपको Python का बुनियादी ज्ञान और DataFrames के साथ काम करने का अनुभव होना चाहिए। scikit-learn के सिंटैक्स का कुछ अनुभव होना भी सहायक रहेगा। kNN को अक्सर अनसुपरवाइज़्ड विधि k-Means Clustering से भ्रमित किया जाता है। यदि आप इसमें रुचि रखते हैं, तो scikit-learn के साथ Python में k-Means Clustering पर नज़र डालें। आप तुरंत हमारे Python में मशीन लर्निंग कोर्सेज़ के लिए रजिस्टर करके भी शुरुआत कर सकते हैं, जहाँ kNNs को और विस्तार से कवर किया गया है।
प्रैक्टिस (KNN) क्लासिफिकेशन इस हैंड्स-ऑन अभ्यास के साथ करें।
हालाँकि kNN का उपयोग वर्गीकरण और प्रतिगमन दोनों के लिए किया जा सकता है, यह लेख एक वर्गीकरण मॉडल बनाने पर केंद्रित है। मशीन लर्निंग में वर्गीकरण एक सुपरवाइज़्ड लर्निंग कार्य है, जिसमें दिए गए इनपुट डेटा पॉइंट के लिए श्रेणीगत लेबल की भविष्यवाणी करनी होती है। एल्गोरिदम को लेबल वाले डेटासेट पर प्रशिक्षित किया जाता है और इनपुट फीचर्स का उपयोग करके इनपुट और संबंधित क्लास लेबल के बीच मैपिंग सीखता है। हम प्रशिक्षित मॉडल का उपयोग नए, अनदेखे डेटा की भविष्यवाणी करने के लिए कर सकते हैं। आप इस ट्यूटोरियल का कोड चलाने के लिए यह DataLab वर्कबुक खोल सकते हैं।
k-Nearest Neighbors का एक अवलोकन
kNN एल्गोरिदम को एक वोटिंग सिस्टम माना जा सकता है, जहाँ फ़ीचर स्पेस में किसी नए डेटा पॉइंट के निकटतम ‘k’ (जहाँ k एक पूर्णांक है) पड़ोसियों के बीच बहुमत क्लास लेबल उसके क्लास लेबल को निर्धारित करता है। कल्पना कीजिए एक छोटा सा गाँव है जिसमें कुछ सौ निवासी हैं, और आपको यह तय करना है कि आपको किस राजनीतिक दल को वोट देना चाहिए। ऐसा करने के लिए, आप अपने निकटतम पड़ोसियों से पूछ सकते हैं कि वे किस दल का समर्थन करते हैं। यदि आपके ‘k’ निकटतम पड़ोसियों में से बहुमत दल A का समर्थन करता है, तो संभवतः आप भी दल A को वोट देंगे। kNN भी इसी तरह काम करता है, जहाँ बहुमत क्लास लेबल नए डेटा पॉइंट का क्लास लेबल तय करता है।
आइए एक और उदाहरण के साथ गहराई से समझते हैं। मान लीजिए आपके पास फलों का डेटा है—विशेष रूप से अंगूर और नाशपाती। आपके पास इस बात का स्कोर है कि फल कितना गोल है और उसका व्यास कितना है। आप इन्हें ग्राफ़ पर प्लॉट करने का निर्णय लेते हैं। यदि कोई आपको नया फल देता है, तो आप उसे भी ग्राफ़ पर प्लॉट कर सकते हैं, फिर k (एक संख्या) निकटतम बिंदुओं तक की दूरी मापकर तय कर सकते हैं कि वह कौन सा फल है। नीचे के उदाहरण में, यदि हम तीन बिंदु मापने का चुनाव करते हैं, तो तीन निकटतम बिंदु नाशपाती हैं, तो मैं 100% निश्चित हूँ कि यह नाशपाती है। यदि हम चार निकटतम बिंदु मापते हैं, तो तीन नाशपाती हैं और एक अंगूर, तो हम कहेंगे कि 75% निश्चितता है कि यह नाशपाती है। हम इस लेख में आगे चलकर k के सर्वोत्तम मान को चुनने और दूरी मापने के विभिन्न तरीकों पर चर्चा करेंगे।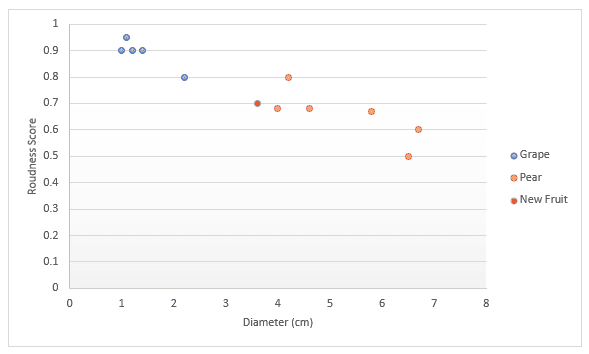
डेटासेट
kNN एल्गोरिदम को और स्पष्ट करने के लिए, आइए एक केस स्टडी पर काम करें जो आपको एक डेटा वैज्ञानिक के रूप में मिल सकती है। मान लीजिए आप एक ऑनलाइन रिटेलर में डेटा वैज्ञानिक हैं, और आपको धोखाधड़ी वाले ट्रांज़ैक्शंस का पता लगाने का कार्य दिया गया है। इस चरण में आपके पास केवल ये फीचर्स हैं:
dist_from_home: उपयोगकर्ता के घर के स्थान और जहाँ लेन-देन किया गया उसके बीच की दूरी।purchase_price_ratio: इस ट्रांज़ैक्शन में खरीदी गई वस्तु की कीमत का उस उपयोगकर्ता की माध्यिका खरीद कीमत के अनुपात से संबंध।
डेटा में 39 ऑब्ज़र्वेशंस हैं जो व्यक्तिगत ट्रांज़ैक्शंस हैं। इस ट्यूटोरियल में, हमें डेटासेट वेरिएबल df के रूप में दिया गया है, यह कुछ इस प्रकार दिखता है:
|
0
|
2.1
|
6.4
|
1
|
|
1
|
3.8
|
2.2
|
1
|
|
2
|
15.7
|
4.4
|
1
|
|
3
|
26.7
|
4.6
|
1
|
|
4
|
10.7
|
4.9
|
1
|
k-Nearest Neighbors वर्कफ़्लो
इस मॉडल को फिट और ट्रेन करने के लिए, हम The Machine Learning Workflow इन्फ़ोग्राफ़िक का पालन करेंगे।
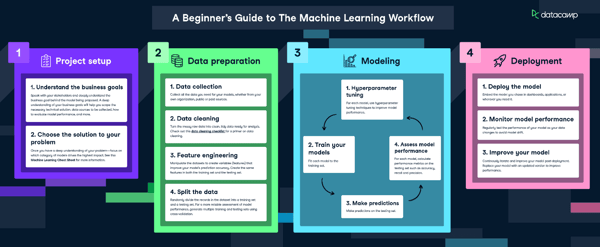
मशीन लर्निंग वर्कफ़्लो इन्फ़ोग्राफ़िक डाउनलोड करें
हालाँकि, क्योंकि हमारा डेटा काफ़ी साफ़ है, हम हर चरण नहीं करेंगे। हम निम्नलिखित करेंगे:
- फ़ीचर इंजीनियरिंग
- डेटा को विभाजित करना
- मॉडल को ट्रेन करना
- हाइपरपैरामीटर ट्यूनिंग
- मॉडल के प्रदर्शन का आकलन
डेटा का विज़ुअलाइज़ेशन
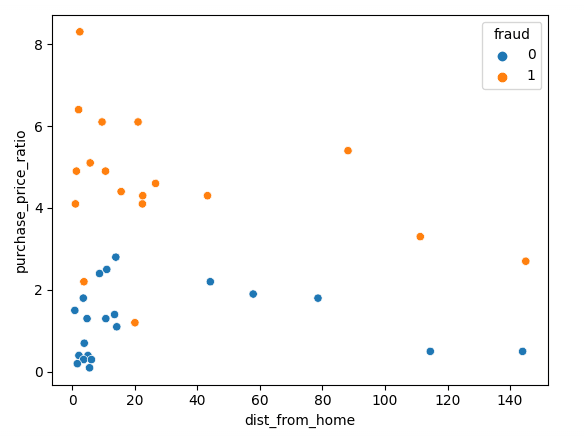
आइए Matplotlib का उपयोग करके अपने डेटा का विज़ुअलाइज़ेशन शुरू करें; हम अपने दो फीचर्स को एक स्कैटरप्लॉट में प्लॉट कर सकते हैं।
sns.scatterplot(x=df['dist_from_home'],y=df['purchase_price_ratio'], hue=df['fraud'])जैसा कि आप देख सकते हैं, इन ट्रांज़ैक्शंस के बीच स्पष्ट अंतर है—धोखाधड़ी वाले ट्रांज़ैक्शंस ग्राहकों के माध्यिका ऑर्डर की तुलना में काफ़ी अधिक मूल्य के हैं। घर से दूरी के आसपास के रुझान कुछ हद तक समझना कठिन हैं—ग़ैर-धोखाधड़ी वाले ट्रांज़ैक्शंस आमतौर पर घर के अधिक क़रीब हैं, लेकिन कई आउटलायर्स मौजूद हैं।
डेटा को सामान्यीकृत करना और विभाजित करना
किसी भी मशीन लर्निंग मॉडल को प्रशिक्षित करते समय, डेटा को प्रशिक्षण और परीक्षण डेटा में विभाजित करना महत्वपूर्ण है। प्रशिक्षण डेटा का उपयोग मॉडल को फिट करने के लिए किया जाता है। एल्गोरिदम फीचर्स और टार्गेट के बीच संबंध सीखने के लिए प्रशिक्षण डेटा का उपयोग करता है। यह प्रशिक्षण डेटा में ऐसे पैटर्न खोजने की कोशिश करता है जिनका उपयोग नए, अनदेखे डेटा पर भविष्यवाणियाँ करने के लिए किया जा सके। परीक्षण डेटा मॉडल के प्रदर्शन का मूल्यांकन करने के लिए प्रयोग किया जाता है। मॉडल से परीक्षण डेटा पर भविष्यवाणियाँ कराई जाती हैं और इन्हें वास्तविक टार्गेट मानों से तुलना की जाती है।
kNN क्लासिफ़ायर को प्रशिक्षित करते समय, फीचर्स का सामान्यीकरण करना आवश्यक है। इसका कारण है कि kNN बिंदुओं के बीच दूरी मापता है। डिफ़ॉल्ट रूप से यूक्लिडियन दूरी का उपयोग होता है, जो दो बिंदुओं के बीच वर्गांतरों के योग का वर्गमूल है। हमारे मामले में, purchase_price_ratio 0 से 8 के बीच है, जबकि dist_from_home काफ़ी बड़ा है। यदि हम सामान्यीकरण नहीं करेंगे, तो हमारी गणना dist_from_home द्वारा भारी रूप से प्रभावित होगी क्योंकि इसके संख्यात्मक मान बड़े हैं।
हमें डेटा को प्रशिक्षण और परीक्षण सेट में विभाजित करने के बाद सामान्यीकृत करना चाहिए। इसका उद्देश्य ‘डेटा लीकेज’ को रोकना है, क्योंकि यदि हम एक बार में सभी डेटा को सामान्यीकृत कर देंगे, तो सामान्यीकरण मॉडल को टेस्ट सेट के बारे में अतिरिक्त जानकारी दे देगा।
निम्नलिखित कोड डेटा को ट्रेन/टेस्ट स्प्लिट्स में विभाजित करता है, फिर scikit-learn के Standard Scaler का उपयोग करके सामान्यीकृत करता है। हम पहले प्रशिक्षण डेटा पर .fit_transform() कॉल करते हैं, जो हमारे स्केलर को प्रशिक्षण डेटा के माध्य और मानक विचलन पर फिट करता है। इसके बाद .transform() कॉल करके हम इन्हीं सीखे हुए मानों को टेस्ट डेटा पर लागू करते हैं।
# Split the data into features (X) and target (y)
X = df.drop('fraud', axis=1)
y = df['fraud']
# Split the data into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
# Scale the features using StandardScaler
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)मॉडल को फिट करना और मूल्यांकन करना
अब हम मॉडल को ट्रेन करने के लिए तैयार हैं। इसके लिए, हम k के लिए 3 का एक निश्चित मान उपयोग करेंगे, लेकिन बाद में हमें इसे ऑप्टिमाइज़ करना होगा। पहले हम kNN मॉडल का एक उदाहरण बनाते हैं, फिर इसे अपने प्रशिक्षण डेटा पर फिट करते हैं। हम फीचर्स और टार्गेट वेरिएबल दोनों पास करते हैं ताकि मॉडल सीख सके।
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)मॉडल अब प्रशिक्षित हो चुका है! हम टेस्ट डेटासेट पर भविष्यवाणियाँ कर सकते हैं, जिनका उपयोग बाद में मॉडल को स्कोर करने के लिए किया जा सकता है।
y_pred = knn.predict(X_test)इस मॉडल का आकलन करने का सबसे सरल तरीका एक्युरेसी का उपयोग करना है। हम भविष्यवाणियों की टेस्ट सेट के वास्तविक मानों से तुलना करते हैं और गिनते हैं कि मॉडल ने कितनी बार सही अनुमान लगाया।
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)Accuracy: 0.875यह काफ़ी अच्छा स्कोर है! हालाँकि, हम k के मान को ऑप्टिमाइज़ करके और बेहतर कर सकते हैं।
क्रॉस-वैलिडेशन का उपयोग कर k का सर्वोत्तम मान पाना
दुर्भाग्यवश, k का सर्वोत्तम मान खोजने का कोई जादुई तरीका नहीं है। हमें कई अलग-अलग मानों को आज़माना पड़ता है और फिर अपने सर्वोत्तम निर्णय का उपयोग करना होता है।
नीचे दिए गए कोड में, हम k के लिए मानों की एक रेंज चुनते हैं और अपने परिणामों को संग्रहीत करने के लिए एक खाली सूची बनाते हैं। हम एक्युरेसी स्कोर पाने के लिए क्रॉस-वैलिडेशन का उपयोग करते हैं, जिसका अर्थ है कि हमें ट्रेन और टेस्ट स्प्लिट बनाने की आवश्यकता नहीं है, लेकिन हमें डेटा को स्केल करना होगा। फिर हम मानों पर लूप लगाते हैं और स्कोर को अपनी सूची में जोड़ते हैं।
क्रॉस-वैलिडेशन लागू करने के लिए, हम scikit-learn की cross_val_score का उपयोग करते हैं। हम kNN मॉडल का एक उदाहरण, अपने डेटा, और जितने स्प्लिट करने हैं उनकी संख्या पास करते हैं। नीचे के कोड में, हम पाँच स्प्लिट का उपयोग करते हैं, जिसका मतलब है कि मॉडल डेटा को पाँच समान आकार के समूहों में बाँटेगा और 4 पर ट्रेन तथा 1 पर टेस्ट करेगा। यह प्रत्येक समूह पर लूप चलाएगा और एक्युरेसी स्कोर देगा, जिन्हें हम औसत करके सर्वश्रेष्ठ मॉडल पाते हैं।
k_values = [i for i in range (1,31)]
scores = []
scaler = StandardScaler()
X = scaler.fit_transform(X)
for k in k_values:
knn = KNeighborsClassifier(n_neighbors=k)
score = cross_val_score(knn, X, y, cv=5)
scores.append(np.mean(score))हम निम्नलिखित कोड से परिणामों को प्लॉट कर सकते हैं
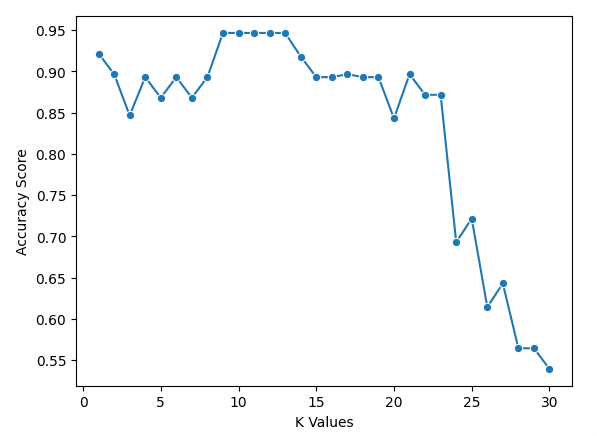
sns.lineplot(x = k_values, y = scores, marker = 'o')
plt.xlabel("K Values")
plt.ylabel("Accuracy Score")हमारे चार्ट से पता चलता है कि k = 9, 10, 11, 12, और 13 की एक्युरेसी लगभग 95% से थोड़ी कम है। चूँकि ये सर्वोच्च स्कोर के लिए बराबरी पर हैं, इसलिए एक छोटे k मान का उपयोग करना उचित है। ऐसा इसलिए क्योंकि k के उच्च मान पर मॉडल मूल बिंदु से अधिक दूर स्थित डेटा पॉइंट्स का उपयोग करेगा। एक अन्य विकल्प यह होगा कि अन्य मूल्यांकन मैट्रिक्स का भी अन्वेषण किया जाए।
अधिक मूल्यांकन मैट्रिक्स
अब हम नीचे दिए गए कोड का उपयोग करके सर्वोत्तम k मान के साथ अपना मॉडल प्रशिक्षित कर सकते हैं।
best_index = np.argmax(scores)
best_k = k_values[best_index]
knn = KNeighborsClassifier(n_neighbors=best_k)
knn.fit(X_train, y_train)फिर एक्युरेसी, प्रिसिशन और रिकॉल से मूल्यांकन करें (ध्यान दें कि रैंडमाइज़ेशन के कारण आपके परिणाम भिन्न हो सकते हैं)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
print("Accuracy:", accuracy)
print("Precision:", precision)
print("Recall:", recall)Accuracy: 0.875
Precision: 0.75
Recall: 1.0अगले स्तर पर ले जाएँ
- Supervised Learning with scikit-learn कोर्स DataCamp के Python में मशीन लर्निंग करिकुलम का प्रवेश बिंदु है और k-nearest neighbors को कवर करता है।
- Anomaly Detection in Python, Dealing with Missing Data in Python, और Machine Learning for Finance in Python कोर्स—all k-nearest neighbors के उपयोग के उदाहरण दिखाते हैं।
- Decision Tree Classification in Python Tutorial डेटा को वर्गीकृत करने के लिए एक अन्य मशीन लर्निंग मॉडल को कवर करता है।
- scikit-learn चीट शीट लोकप्रिय मशीन लर्निंग फ़ंक्शनैलिटी के लिए एक उपयोगी संदर्भ प्रदान करती है।