
Khóa học
Tìm hiểu Data Engineering
2 giờ
377.9K
Phân vùng là các thành phần thiết yếu trong kiến trúc phân tán của Kafka, cho phép Kafka mở rộng theo chiều ngang, từ đó xử lý dữ liệu song song một cách hiệu quả. Chúng là các khối xây dựng để tổ chức và phân phối dữ liệu trên toàn cụm Kafka.
Hãy hình dung chúng như các kênh riêng trong một chủ đề (topic) nơi thông điệp được lưu trữ. Mỗi phân vùng có thể có nhiều bản sao (replica) phân tán trên các broker khác nhau, đảm bảo khả năng chịu lỗi và dự phòng dữ liệu.
Ngoài ra, phân vùng còn đảm bảo tính thứ tự, nghĩa là các thông điệp trong một phân vùng được xử lý theo đúng thứ tự chúng được tạo ra. Điều này khiến phân vùng Kafka đóng vai trò then chốt trong việc duy trì tính toàn vẹn và nhất quán dữ liệu, rất quan trọng cho các kịch bản xử lý dữ liệu theo thời gian thực.
Trong bài viết này, chúng ta sẽ đi sâu vào các nội dung sau:
Bạn có thể xem so sánh Kafka và SQS để có hướng dẫn chi tiết về cách hai công cụ này đối chiếu với nhau.
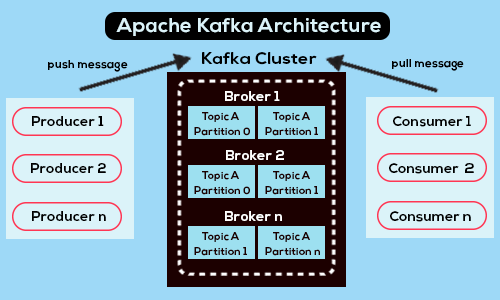
Tổng quan về kiến trúc Kafka - Nguồn
Apache Kafka là một nền tảng streaming phân tán mã nguồn mở, được thiết kế cho thông lượng cao, khả năng chịu lỗi và khả năng mở rộng, khiến nó trở thành lựa chọn phổ biến để xây dựng pipeline dữ liệu và ứng dụng theo thời gian thực.
Cốt lõi của Kafka gồm nhiều thành phần. Các thành phần này bao gồm producer, consumer, broker, topic và partition, mỗi thành phần đều đóng vai trò quan trọng trong toàn hệ thống.
Phân vùng đóng vai trò then chốt trong việc định hình hiệu quả và độ vững chắc của Kafka. Chúng tạo điều kiện phân phối dữ liệu trên các broker Kafka, cho phép mở rộng theo chiều ngang.
Bằng cách chia nhỏ các topic thành phân vùng, Kafka có thể trải rộng khối lượng công việc xử lý dữ liệu trên nhiều máy chủ, giúp sử dụng tài nguyên hiệu quả và đáp ứng khối lượng dữ liệu tăng lên mà không làm quá tải từng broker riêng lẻ.
Hơn nữa, phân vùng còn cho phép xử lý dữ liệu song song. Consumer có thể đọc đồng thời từ nhiều phân vùng, phân tán tải tính toán và nâng cao thông lượng. Việc tiêu thụ dữ liệu song song này đảm bảo sử dụng tài nguyên của consumer hiệu quả và giảm độ trễ trong các pipeline xử lý dữ liệu.
Một lý do khác khiến phân vùng quan trọng trong Kafka là chúng hỗ trợ khả năng chịu lỗi của nền tảng. Mỗi phân vùng có thể có nhiều bản sao phân tán trên các broker khác nhau. Khi một broker gặp sự cố, Kafka vẫn có thể phục vụ dữ liệu từ các bản sao trên broker khác, đảm bảo tính sẵn sàng và độ tin cậy của dữ liệu.
Tóm lại, phân vùng quan trọng vì nhiều lý do. Chúng là thành phần cốt lõi của kiến trúc Kafka và đóng vai trò chủ đạo trong việc mang lại khả năng mở rộng, chịu lỗi, xử lý song song và tính nhất quán dữ liệu.
Như đã đề cập trước đó, mỗi phân vùng hoạt động như một dãy bản ghi được phân đoạn, có thứ tự và bất biến. Khi producer gửi dữ liệu vào Kafka, nó sử dụng logic phân vùng để xác định dữ liệu nên được ghi vào phân vùng nào trong một topic.
Logic này có thể dựa trên nhiều yếu tố, như khóa (key) gắn với dữ liệu hoặc một bộ chia phân vùng tùy chỉnh do producer triển khai. Khi phân vùng đã được xác định, Kafka sẽ nối dữ liệu vào cuối phân vùng, duy trì thứ tự thông điệp dựa trên offset của chúng.
Bên trong, các broker Kafka xử lý việc lưu trữ và sao chép dữ liệu của phân vùng. Mỗi phân vùng có thể có nhiều bản sao phân tán trên các broker khác nhau để đảm bảo khả năng chịu lỗi.
Kafka sử dụng mô hình leader-follower, trong đó một broker đóng vai trò leader chịu trách nhiệm xử lý các yêu cầu đọc và ghi cho phân vùng, trong khi các broker khác là follower sao chép dữ liệu từ leader. Thiết lập này đảm bảo độ bền và tính sẵn sàng của dữ liệu ngay cả khi xảy ra sự cố broker.
Trước khi thiết lập một phân vùng Kafka, hãy đảm bảo Apache Kafka và Zookeeper đã được cài đặt, cấu hình và chạy trên máy của bạn. Điều này được khuyến nghị để đảm bảo khả năng tương thích tối ưu. Đồng thời, kiểm tra rằng Java 8 hoặc phiên bản mới hơn đã được cài đặt và hoạt động.
Lưu ý Kafka có thể gặp nhiều vấn đề khi cài đặt trên Windows do thiếu khả năng tương thích gốc với hệ điều hành này. Vì vậy, khuyến nghị sử dụng các phương pháp sau để khởi chạy Apache Kafka trên Windows:
Không khuyến khích dùng JVM để chạy Kafka trên Windows vì thiếu một số đặc tính POSIX vốn có của Linux. Cố gắng chạy Kafka trên Windows mà không có WSL2 có thể dẫn đến khó khăn về sau.
Bạn có thể tìm hiểu thêm về cách thiết lập Apache Kafka trong Apache Kafka cho người mới bắt đầu: Hướng dẫn toàn diện.
Dưới đây là hướng dẫn từng bước để thiết lập phân vùng:
Mở cửa sổ dòng lệnh và điều hướng đến thư mục gốc của Kafka. Tại đó, chạy lệnh sau để khởi động Zookeeper:
bin/zookeeper-server-start.sh config/zookeeper.propertiesMở một cửa sổ dòng lệnh khác và chạy lệnh sau từ thư mục gốc của Apache Kafka để khởi động Apache Kafka:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesĐể tạo một topic với ba phân vùng, mở một cửa sổ dòng lệnh mới từ thư mục gốc Kafka và chạy lệnh sau:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicLệnh này sẽ tạo một topic Kafka mới có tên “my_topic.”
Lưu ý: để xác nhận đã tạo đúng, khi thực thi lệnh sẽ trả về “Create topic <name of topic>.”
Bạn có thể kiểm tra topic đã được tạo chính xác bằng cách chạy:
bin/kafka-topics.sh --list --zookeeper localhost:2181Kết quả dự kiến:
my_topicPhân vùng lại (repartitioning) các topic hiện có trong Kafka liên quan đến việc điều chỉnh số lượng phân vùng, có thể cần thiết để đáp ứng thay đổi về khối lượng dữ liệu, cải thiện xử lý song song hoặc tối ưu hóa sử dụng tài nguyên.
Dưới đây là một số kỹ thuật và lưu ý khi phân vùng lại các topic hiện có:
kafka-topics.sh --alter để tăng số lượng phân vùng của một topic hiện có. Thao tác này sẽ phân phối lại dữ liệu sang các phân vùng mới.Tối ưu hóa việc sử dụng và hiệu năng của phân vùng trong Kafka là điều thiết yếu để đảm bảo xử lý dữ liệu hiệu quả, sử dụng tài nguyên hợp lý và khả năng mở rộng tổng thể của hệ thống.
Dưới đây là một số chiến lược để cân bằng và tối ưu hóa phân vùng:
Kafka đã trở thành xương sống của nhiều ứng dụng chuyên sâu về dữ liệu, nhưng mượn lời chú Ben trong Spider-Man, quyền năng lớn đi kèm với tiềm năng xuất hiện nhiều thách thức phức tạp.
Có khá nhiều sự cố phân vùng thường gặp có thể phát sinh khi sử dụng Kafka. Điều này có thể do cấu hình sai, hạn chế tài nguyên, phân phối dữ liệu không đồng đều hoặc các nguyên nhân khác.
Trong phần này, chúng ta sẽ đi sâu vào các sự cố phân vùng thường gặp và cách giải quyết.
Khi dữ liệu được phân phối không đồng đều giữa các phân vùng, một số phân vùng có thể trở thành điểm nóng, dẫn đến sử dụng tài nguyên không đều và có thể gây nghẽn hiệu năng. Cách khắc phục là liên tục giám sát phân phối dữ liệu, có thể thực hiện bằng các công cụ giám sát của Kafka như Kafka Manager hoặc Confluent Control Center. Ngoài ra, cân nhắc triển khai chiến lược phân vùng tùy chỉnh hoặc tăng số lượng phân vùng để đạt phân phối dữ liệu cân bằng hơn.
Khi một phân vùng tích lũy lượng dữ liệu lớn theo thời gian, điều này có thể dẫn đến suy giảm hiệu năng và tăng độ trễ khi truy xuất và xử lý dữ liệu.
Chìa khóa để giải quyết là thường xuyên theo dõi kích thước phân vùng và tách các phân vùng lớn thành phân vùng nhỏ hơn để phân phối dữ liệu đồng đều hơn. Bên cạnh đó, điều chỉnh chính sách lưu trữ (retention) cũng giúp kiểm soát lượng dữ liệu được lưu trong các phân vùng.
Phân vùng thiếu bản sao (under-replicated) xảy ra khi số bản sao đồng bộ (ISR) giảm xuống dưới mức tối thiểu đã cấu hình, thường do sự cố broker hoặc vấn đề mạng.
Để ngăn chặn, hãy theo dõi trạng thái sao chép của các phân vùng và điều tra mọi phân vùng thiếu bản sao. Đảm bảo hệ số sao chép (replication factor) được cấu hình phù hợp để duy trì mức chịu lỗi mong muốn. Xử lý kịp thời các vấn đề liên quan đến kết nối mạng hoặc sự cố broker.
Leader của phân vùng xử lý các yêu cầu đọc và ghi trong một cụm Kafka. Sự mất cân bằng leader giữa các broker có thể dẫn đến sử dụng tài nguyên không đều và có thể gây vấn đề hiệu năng.
Có thể phòng tránh bằng cách theo dõi phân bố leader của phân vùng bằng Kafka Manager hoặc Confluent Control Center và cân bằng lại leader khi cần. Ngoài ra, cân nhắc điều chỉnh cấu hình broker để phân phối leader đồng đều giữa các broker.
Độ lệch phân vùng xảy ra khi một số phân vùng nhận lượng truy cập cao vượt trội so với các phân vùng khác, dẫn đến sử dụng tài nguyên không đều và có thể suy giảm hiệu năng. Vì vậy, việc phân tích mô hình lưu lượng là rất quan trọng.
Cân nhắc triển khai chiến lược phân vùng tùy chỉnh để phân phối dữ liệu đều giữa các phân vùng và tối ưu cấu hình nhóm consumer để phân phối khối lượng công việc đều giữa các consumer.
Apache Kafka là một nền tảng streaming phân tán mạnh mẽ, đóng vai trò xương sống cho nhiều ứng dụng đòi hỏi dữ liệu cao. Trung tâm của nó là khái niệm phân vùng, các đơn vị thiết yếu để tổ chức và phân phối dữ liệu trong các topic của Kafka. Phân vùng có vai trò then chốt trong hệ sinh thái Kafka, mang lại khả năng mở rộng, chịu lỗi, xử lý song song và xử lý dữ liệu hiệu quả.
Bằng cách phân phối dữ liệu trên nhiều broker, phân vùng cho phép Kafka xử lý khối lượng dữ liệu lớn trong khi vẫn duy trì thông lượng cao và độ tin cậy. Bên cạnh đó, phân vùng hỗ trợ xử lý dữ liệu song song, đảm bảo sử dụng tài nguyên tối ưu và giảm độ trễ.
Cuối cùng, hiểu và quản lý hiệu quả các phân vùng là yếu tố then chốt để tối đa hóa hiệu năng và độ tin cậy của các cụm Kafka, khiến chúng trở thành thành phần không thể thiếu khi xây dựng pipeline và ứng dụng dữ liệu theo thời gian thực có khả năng mở rộng và bền bỉ.
Một số tài nguyên để bạn tiếp tục học:
Tiếp tục học cùng DataCamp
Khóa học
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
