
कोर्स
डेटा इंजीनियरिंग को समझना
2 घंटा
375.5K
पार्टिशन Kafka की वितरित आर्किटेक्चर के भीतर आवश्यक घटक हैं, जो Kafka को क्षैतिज रूप से स्केल करने में सक्षम बनाते हैं और कुशल समानांतर डेटा प्रोसेसिंग की अनुमति देते हैं। ये Kafka क्लस्टर में डेटा को व्यवस्थित और वितरित करने के बुनियादी निर्माण खंड हैं।
इन्हें किसी टॉपिक के भीतर अलग-अलग चैनल के रूप में सोचें जहाँ संदेश संग्रहीत होते हैं। प्रत्येक पार्टिशन के कई प्रतिरूप (रिप्लिका) अलग-अलग ब्रोकर्स में फैले हो सकते हैं, जिससे फॉल्ट टॉलरेंस और डेटा रेडंडेंसी सुनिश्चित होती है।
इसके अलावा, पार्टिशन ऑर्डरिंग की गारंटी देते हैं, यह सुनिश्चित करते हुए कि किसी पार्टिशन के भीतर संदेश उसी क्रम में प्रोसेस हों जिसमें वे प्रोड्यूस हुए थे। यह Kafka पार्टिशन को डेटा अखंडता और स्थिरता बनाए रखने में बेहद महत्वपूर्ण बनाता है, जो रियल-टाइम डेटा प्रोसेसिंग परिदृश्यों के लिए निर्णायक है।
इस लेख में, हम निम्नलिखित विषयों में गहराई से जाएंगे:
आप हमारे Kafka बनाम SQS की तुलना को देख सकते हैं, जहाँ दोनों टूल्स का विस्तृत तुलनात्मक मार्गदर्शन उपलब्ध है।
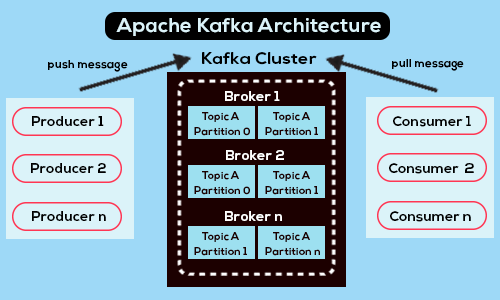
Kafka की आर्किटेक्चर का अवलोकन - स्रोत
Apache Kafka एक ओपन-सोर्स, वितरित स्ट्रीमिंग प्लेटफ़ॉर्म है, जिसे उच्च थ्रूपुट, फॉल्ट टॉलरेंस, और स्केलेबिलिटी के लिए डिज़ाइन किया गया है। यही कारण है कि रियल-टाइम डेटा पाइपलाइनों और अनुप्रयोगों के निर्माण में यह लोकप्रिय विकल्प है।
मूल रूप से, Kafka कई घटकों से मिलकर बना है। इनमें प्रोड्यूसर, कंज्यूमर, ब्रोकर्स, टॉपिक्स, और पार्टिशन शामिल हैं, और प्रत्येक पूरे सिस्टम में महत्वपूर्ण भूमिका निभाता है।
पार्टिशन Kafka की दक्षता और मजबूती को आकार देने में प्रमुख भूमिका निभाते हैं। ये Kafka ब्रोकर्स में डेटा वितरण को सुगम बनाते हैं, जिससे क्षैतिज स्केलिंग संभव होती है।
टॉपिक्स को पार्टिशन में बाँटकर, Kafka डेटा प्रोसेसिंग वर्कलोड को कई सर्वरों पर फैला सकता है, जिससे संसाधनों का कुशल उपयोग होता है और बढ़ती डेटा वॉल्यूम को बिना किसी एकल ब्रोकर्स को ओवरव्हेल्म किए संभाला जा सकता है।
इसके अलावा, पार्टिशन डेटा प्रोसेसिंग में पैरेललिज़्म भी सक्षम करते हैं। कंज्यूमर एक साथ कई पार्टिशन से पढ़ सकते हैं, जिससे कम्प्यूटेशनल लोड वितरित होता है और थ्रूपुट बढ़ता है। यह समानांतर डेटा कंजम्प्शन कंज्यूमर संसाधनों के कुशल उपयोग को सुनिश्चित करता है और डेटा प्रोसेसिंग पाइपलाइनों में लेटेंसी घटाता है।
पार्टिशन का एक और महत्वपूर्ण कारण यह है कि वे प्लेटफ़ॉर्म की फॉल्ट टॉलरेंस क्षमताओं में मदद करते हैं। प्रत्येक पार्टिशन के कई रिप्लिका अलग-अलग ब्रोकर्स में वितरित हो सकते हैं। किसी ब्रोकर्स के फेल होने की स्थिति में, Kafka अन्य ब्रोकर्स पर होस्ट किए गए रिप्लिकाज़ से डेटा सर्व करना जारी रख सकता है, जिससे डेटा उपलब्धता और विश्वसनीयता बनी रहती है।
संक्षेप में, कई कारणों से पार्टिशन महत्वपूर्ण हैं। वे Kafka की आर्किटेक्चर के केंद्र में हैं और स्केलेबिलिटी, फॉल्ट टॉलरेंस, पैरेललिज़्म, और डेटा स्थिरता सक्षम करने में निर्णायक भूमिका निभाते हैं।
जैसा कि लेख में पहले उल्लेख किया गया है, प्रत्येक पार्टिशन रिकॉर्ड्स का खंडित, क्रमबद्ध और अपरिवर्तनीय अनुक्रम होता है। जब कोई प्रोड्यूसर Kafka को डेटा भेजता है, तो वह पार्टिशनिंग लॉजिक का उपयोग करता है यह निर्धारित करने के लिए कि टॉपिक के किस पार्टिशन में डेटा लिखा जाना चाहिए।
यह लॉजिक विभिन्न कारकों पर आधारित हो सकता है, जैसे डेटा से जुड़ी कोई कुंजी, या प्रोड्यूसर द्वारा लागू किया गया कस्टम पार्टिशनर। एक बार पार्टिशन निर्धारित हो जाने पर, Kafka उस पार्टिशन के अंत में डेटा जोड़ देता है, और ऑफ़सेट के आधार पर संदेशों का क्रम बनाए रखता है।
आंतरिक रूप से, Kafka ब्रोकर्स पार्टिशन डेटा के स्टोरेज और प्रतिकृति को संभालते हैं। फॉल्ट टॉलरेंस सुनिश्चित करने के लिए प्रत्येक पार्टिशन के कई रिप्लिका अलग-अलग ब्रोकर्स में वितरित हो सकते हैं।
यहाँ लीडर-फॉलोअर मॉडल अपनाया जाता है, जहाँ एक ब्रोकर्स लीडर के रूप में कार्य करता है और पार्टिशन के लिए रीड और राइट रिक्वेस्ट हैंडल करता है, जबकि अन्य ब्रोकर्स फॉलोअर के रूप में लीडर से डेटा की प्रतिकृति बनाते हैं। यह सेटअप ब्रोकर्स की विफलता की स्थिति में भी डेटा की स्थायित्व और उपलब्धता सुनिश्चित करता है।
Kafka पार्टिशन सेट अप करने से पहले सुनिश्चित करें कि Apache Kafka और Zookeeper आपके लोकल मशीन पर इंस्टॉल, कॉन्फ़िगर और रन हो रहे हों। यह सर्वोत्तम संगतता के लिए अनुशंसित है। साथ ही, यह भी जाँच लें कि Java 8 या नया संस्करण इंस्टॉल और कार्यशील है।
ध्यान दें कि Windows पर इंस्टॉल किए जाने पर Kafka को इस ऑपरेटिंग सिस्टम के साथ नैटिव संगतता की कमी के कारण विभिन्न समस्याओं का सामना करना पड़ सकता है। इसलिए, Windows पर Apache Kafka लॉन्च करने के लिए निम्न तरीकों का उपयोग करने की सिफारिश की जाती है:
Windows पर JVM का उपयोग करके Kafka चलाना हतोत्साहित किया जाता है क्योंकि इसमें Linux की अंतर्निहित कुछ POSIX विशेषताएँ नहीं हैं। WSL2 के बिना Windows पर Kafka चलाने का प्रयास अंततः कठिनाइयों का कारण बन सकता है।
Apache Kafka सेट अप करने के बारे में अधिक जानने के लिए देखें Apache Kafka for Beginners: A Comprehensive Guide।
यहाँ पार्टिशन सेट अप करने के लिए चरण-दर-चरण गाइड है:
कमांड प्रॉम्प्ट खोलें और रूट Kafka डायरेक्टरी पर जाएँ। वहाँ पहुँचने के बाद, Zookeeper शुरू करने के लिए निम्न कमांड चलाएँ:
bin/zookeeper-server-start.sh config/zookeeper.propertiesएक और कमांड प्रॉम्प्ट खोलें और Apache Kafka को शुरू करने के लिए Apache Kafka की रूट डायरेक्टरी से निम्न कमांड चलाएँ:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesतीन पार्टिशन वाले टॉपिक बनाने के लिए, रूट Kafka डायरेक्टरी से नया कमांड प्रॉम्प्ट शुरू करें और निम्न कमांड चलाएँ:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicयह “my_topic” नामक नया Kafka टॉपिक बना देगा।
नोट: यह पुष्टि करने के लिए कि यह सही से बना है, कमांड चलाने पर “Create topic <name of topic>.” रिटर्न होगा।
आप निम्न कमांड चलाकर सत्यापित कर सकते हैं कि टॉपिक सही से बना है:
bin/kafka-topics.sh --list --zookeeper localhost:2181जिसका आउटपुट होना चाहिए:
my_topicKafka में मौजूदा टॉपिक्स का रि-पार्टिशनिंग पार्टिशन काउंट में बदलाव करना होता है, जो बदलती डेटा वॉल्यूम, बेहतर पैरेललिज़्म, या संसाधन उपयोग के अनुकूलन के लिए आवश्यक हो सकता है।
मौजूदा टॉपिक्स के रि-पार्टिशनिंग के लिए कुछ तकनीकें और विचार निम्न हैं:
kafka-topics.sh --alter कमांड का उपयोग करें। इससे डेटा नए पार्टिशन में पुनर्वितरित हो जाएगा।Kafka में पार्टिशन उपयोग और परफॉर्मेंस का अनुकूलन प्रभावी डेटा प्रोसेसिंग, संसाधन उपयोग, और समग्र सिस्टम स्केलेबिलिटी सुनिश्चित करने के लिए आवश्यक है।
पार्टिशन बैलेंसिंग और ऑप्टिमाइज़ेशन के लिए कुछ रणनीतियाँ देखें:
Kafka कई डेटा-गहन अनुप्रयोगों की रीढ़ बन गया है, लेकिन Spider-Man के अंकल बेन के शब्दों की तर्ज पर कहें, तो बड़ी शक्ति के साथ जटिल चुनौतियों की संभावनाएँ भी बढ़ जाती हैं।
Kafka का उपयोग करते समय कई सामान्य पार्टिशन समस्याएँ सामने आ सकती हैं। यह मिसकन्फ़िगरेशन, संसाधन सीमाएँ, असमान डेटा वितरण, या अन्य कारणों से हो सकता है।
इस भाग में, हम सामान्य पार्टिशन समस्याओं को गहराई से समझेंगे और उनके समाधान पर चर्चा करेंगे।
जब डेटा पार्टिशन में असमान रूप से वितरित होता है, तो कुछ पार्टिशन हॉटस्पॉट बन सकते हैं, जिसके परिणामस्वरूप संसाधनों का असमान उपयोग और संभावित परफॉर्मेंस बाधाएँ उत्पन्न होती हैं। इससे निपटने का तरीका है डेटा वितरण की लगातार निगरानी करना, जिसे Kafka के मॉनिटरिंग टूल्स जैसे Kafka Manager या Confluent Control Center से किया जा सकता है। साथ ही, कस्टम पार्टिशनिंग रणनीति लागू करने या पार्टिशन काउंट बढ़ाने पर विचार करें ताकि अधिक संतुलित डेटा वितरण प्राप्त हो।
जब कोई पार्टिशन समय के साथ बड़ी मात्रा में डेटा इकट्ठा कर लेता है, तो यह परफॉर्मेंस में गिरावट और डेटा रिट्रीवल व प्रोसेसिंग के दौरान लेटेंसी बढ़ने का कारण बन सकता है।
इस समस्या का समाधान नियमित रूप से पार्टिशन आकार की निगरानी करना और बड़े पार्टिशन को छोटे हिस्सों में विभाजित करना है, ताकि डेटा अधिक समान रूप से वितरित हो सके। साथ ही, पार्टिशन में संग्रहीत डेटा की मात्रा को नियंत्रित करने के लिए रिटेंशन नीतियों को समायोजित करना उपयोगी होता है।
अंडर-रिप्लिकेटेड पार्टिशन तब होते हैं जब ब्रोकर्स विफलताओं या नेटवर्क समस्याओं के कारण इन-सिंक रिप्लिका (ISR) की संख्या कॉन्फ़िगर किए गए न्यूनतम से कम हो जाती है।
इसे रोकने के लिए, पार्टिशन की प्रतिकृति स्थिति की निगरानी करें और किसी भी अंडर-रिप्लिकेटेड पार्टिशन की जाँच करें। वांछित फॉल्ट टॉलरेंस स्तर बनाए रखने के लिए प्रतिकृति फैक्टर उचित रूप से कॉन्फ़िगर करें। नेटवर्क कनेक्टिविटी या ब्रोकर्स विफलताओं से संबंधित किसी भी समस्या का तुरंत समाधान करें।
Kafka क्लस्टर में पार्टिशन लीडर रीड और राइट रिक्वेस्ट हैंडल करते हैं। ब्रोकर्स में पार्टिशन लीडर्स का असंतुलन संसाधनों के असमान उपयोग और संभावित परफॉर्मेंस समस्याओं को जन्म दे सकता है।
इसे रोकने के लिए Kafka Manager या Confluent Control Center का उपयोग करके पार्टिशन लीडर वितरण की निगरानी करें और आवश्यकता पड़ने पर लीडर्स को रीबैलेंस करें। साथ ही, ब्रोकर्स कॉन्फ़िगरेशन समायोजित करने पर विचार करें ताकि पार्टिशन लीडर्स ब्रोकर्स में समान रूप से वितरित हों।
पार्टिशन स्क्यू तब होता है जब कुछ पार्टिशन अन्य की तुलना में असामान्य रूप से अधिक ट्रैफ़िक प्राप्त करते हैं, जिससे संसाधनों का असमान उपयोग और संभावित परफॉर्मेंस गिरावट होती है। इसी कारण ट्रैफ़िक पैटर्न का विश्लेषण महत्वपूर्ण है।
डेटा को पार्टिशन में समान रूप से वितरित करने के लिए कस्टम पार्टिशनिंग रणनीति लागू करने और कंज्यूमर ग्रुप कॉन्फ़िगरेशन को अनुकूलित करने पर विचार करें ताकि वर्कलोड कंज्यूमरों के बीच समान रूप से वितरित हो।
Apache Kafka एक सुदृढ़ वितरित स्ट्रीमिंग प्लेटफ़ॉर्म है, जो अनेक डेटा-गहन अनुप्रयोगों की रीढ़ का कार्य करता है। इसके केंद्र में पार्टिशन की अवधारणा है, जो Kafka टॉपिक्स के भीतर डेटा को व्यवस्थित और वितरित करने की आवश्यक इकाइयाँ हैं। Kafka के इकोसिस्टम में पार्टिशन निर्णायक हैं—ये स्केलेबिलिटी, फॉल्ट टॉलरेंस, पैरेललिज़्म, और कुशल डेटा प्रोसेसिंग सक्षम करते हैं।
कई ब्रोकर्स में डेटा वितरित करके, पार्टिशन Kafka को बड़े पैमाने के डेटा को उच्च थ्रूपुट और विश्वसनीयता के साथ संभालने में सक्षम बनाते हैं। साथ ही, पार्टिशन समानांतर डेटा प्रोसेसिंग को सुगम बनाते हैं, जिससे संसाधनों का इष्टतम उपयोग और लेटेंसी में कमी सुनिश्चित होती है।
अंततः, पार्टिशन को समझना और उनका प्रभावी प्रबंधन करना Kafka क्लस्टर्स के परफॉर्मेंस और विश्वसनीयता को अधिकतम करने के लिए महत्वपूर्ण है, जो स्केलेबल और मज़बूत रियल-टाइम डेटा पाइपलाइनों और अनुप्रयोगों के निर्माण में इन्हें अनिवार्य बनाता है।
आगे सीखने के लिए ये संसाधन देखें:
DataCamp के साथ सीखना जारी रखें
कोर्स
लर्निंग पाथ
लर्निंग पाथ