
Corso
Capire il Data Engineering
2 ore
377.9K
Le partizioni sono componenti essenziali dell'architettura distribuita di Kafka che consentono a Kafka di scalare orizzontalmente, permettendo un'elaborazione dei dati parallela ed efficiente. Sono i mattoni di base per organizzare e distribuire i dati all'interno del cluster Kafka.
Immaginale come canali individuali all'interno di un topic in cui vengono archiviati i messaggi. Ogni partizione può avere più repliche distribuite su diversi broker, garantendo tolleranza ai guasti e ridondanza dei dati.
Inoltre, le partizioni offrono garanzie di ordinamento, assicurando che i messaggi all'interno di una partizione vengano elaborati nell'ordine in cui sono stati prodotti. Questo rende le partizioni di Kafka fondamentali per mantenere l'integrità e la coerenza dei dati, cruciali negli scenari di elaborazione dati in tempo reale.
In questo articolo, approfondiremo i seguenti aspetti:
Puoi consultare il nostro confronto tra Kafka e SQS per una guida dettagliata su come si posizionano i due strumenti.
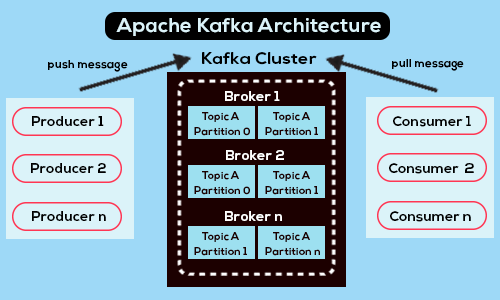
Panoramica dell'architettura di Kafka - Fonte
Apache Kafka è una piattaforma di streaming distribuita open source progettata per elevato throughput, tolleranza ai guasti e scalabilità, che la rende una scelta popolare per costruire pipeline di dati e applicazioni in tempo reale.
Alla base, Kafka è composto da più componenti. Questi includono producer, consumer, broker, topic e partizioni, e ciascuno svolge un ruolo cruciale nel sistema complessivo.
Le partizioni giocano un ruolo chiave nell'efficienza e nella robustezza di Kafka. Facilitano la distribuzione dei dati tra i broker Kafka, consentendo la scalabilità orizzontale.
Suddividendo i topic in partizioni, Kafka può distribuire i carichi di lavoro di elaborazione dei dati su più server, permettendo un utilizzo efficiente delle risorse e gestendo volumi di dati crescenti senza sovraccaricare i singoli broker.
Inoltre, le partizioni abilitano anche il parallelismo nell'elaborazione dei dati. I consumer possono leggere da più partizioni contemporaneamente, distribuendo il carico computazionale e aumentando il throughput. Questo consumo parallelo dei dati assicura un utilizzo efficiente delle risorse dei consumer e riduce la latenza nelle pipeline di elaborazione dati.
Un altro motivo per cui le partizioni contano in Kafka è che contribuiscono alle capacità di tolleranza ai guasti della piattaforma. Ogni partizione può avere più repliche distribuite tra diversi broker. In caso di guasto di un broker, Kafka può continuare a servire i dati dalle repliche ospitate su altri broker, garantendo disponibilità e affidabilità dei dati.
In sostanza, le partizioni sono importanti per molte ragioni. Sono fondamentali per l'architettura di Kafka e svolgono un ruolo centrale nell'abilitare scalabilità, tolleranza ai guasti, parallelismo e coerenza dei dati.
Come accennato in precedenza, ogni partizione funge da sequenza di record segmentata, ordinata e immutabile. Quando un producer invia dati a Kafka, utilizza una logica di partizionamento per determinare in quale partizione del topic scrivere i dati.
Questa logica può basarsi su vari fattori, come una chiave associata ai dati o un partizionatore personalizzato implementato dal producer. Una volta determinata la partizione, Kafka accoda i dati in fondo alla partizione, mantenendo l'ordine dei messaggi in base ai loro offset.
Internamente, i broker Kafka gestiscono l'archiviazione e la replica dei dati delle partizioni. Ogni partizione può avere più repliche distribuite su diversi broker per garantire la tolleranza ai guasti.
Viene impiegato un modello leader-follower in cui un broker funge da leader responsabile della gestione delle richieste di lettura e scrittura per la partizione, mentre gli altri broker agiscono da follower replicando i dati dal leader. Questa configurazione assicura durabilità e disponibilità dei dati anche in caso di guasti dei broker.
Prima di configurare una partizione Kafka, assicurati che Apache Kafka e Zookeeper siano stati installati, configurati e siano in esecuzione sulla tua macchina locale. Questo è consigliato per un'ottima compatibilità. Verifica anche che Java 8 o una versione più recente sia installata e operativa.
Nota che Kafka può incontrare vari problemi se installato su Windows a causa della mancanza di compatibilità nativa con questo sistema operativo. Pertanto, si consiglia di utilizzare i seguenti metodi per avviare Apache Kafka su Windows:
L'utilizzo della JVM per eseguire Kafka su Windows è sconsigliato perché manca di alcune caratteristiche POSIX proprie di Linux. Tentare di eseguire Kafka su Windows senza WSL2 può portare a difficoltà nel tempo.
Puoi saperne di più sulla configurazione di Apache Kafka in Apache Kafka for Beginners: A Comprehensive Guide.
Ecco una guida passo passo per configurare le partizioni:
Apri il prompt dei comandi e vai alla directory root di Kafka. Una volta lì, esegui il seguente comando per avviare Zookeeper:
bin/zookeeper-server-start.sh config/zookeeper.propertiesApri un altro prompt dei comandi ed esegui il seguente comando dalla root di Apache Kafka per avviare Apache Kafka:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesPer creare un topic con tre partizioni, avvia un nuovo prompt dei comandi dalla directory root di Kafka ed esegui il seguente comando:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicQuesto creerà un nuovo topic Kafka chiamato “my_topic”.
Nota: per confermare che è stato creato correttamente, l'esecuzione del comando restituirà “Create topic <name of topic>.”
Puoi verificare che il topic sia stato creato correttamente eseguendo:
bin/kafka-topics.sh --list --zookeeper localhost:2181Che dovrebbe produrre:
my_topicRipartizionare i topic esistenti in Kafka implica modificare il numero di partizioni, operazione che può essere necessaria per adattarsi a volumi di dati variabili, migliorare il parallelismo o ottimizzare l'utilizzo delle risorse.
Ecco alcune tecniche e considerazioni per ripartizionare i topic esistenti:
kafka-topics.sh --alter per aumentare il numero di partizioni di un topic esistente. Questo redistribuirà i dati tra le nuove partizioni.Ottimizzare l'uso e le prestazioni delle partizioni in Kafka è essenziale per garantire un'elaborazione dei dati efficiente, un uso appropriato delle risorse e la scalabilità complessiva del sistema.
Vediamo alcune strategie per il bilanciamento e l'ottimizzazione delle partizioni:
Kafka è diventato la spina dorsale di molte applicazioni data-intensive, ma, per citare lo Zio Ben di Spider-Man, a grandi poteri corrisponde un maggiore potenziale di sfide complesse.
Possono emergere diversi problemi comuni legati alle partizioni quando si utilizza Kafka. Ciò può essere dovuto a configurazioni errate, vincoli di risorse, distribuzione dei dati non uniforme o altro ancora.
In questa sezione approfondiremo i problemi più comuni delle partizioni e vedremo come risolverli.
Quando i dati sono distribuiti in modo non uniforme tra le partizioni, alcune di esse possono diventare hotspot, con conseguente utilizzo disomogeneo delle risorse e potenziali colli di bottiglia nelle prestazioni. Il modo per ovviare a ciò è monitorare costantemente la distribuzione dei dati, operazione possibile con gli strumenti di monitoraggio di Kafka come Kafka Manager o Confluent Control Center. Valuta inoltre l'implementazione di una strategia di partizionamento personalizzata o l'aumento del numero di partizioni per ottenere distribuzioni dei dati più bilanciate.
Quando una partizione accumula una grande quantità di dati nel tempo, ciò può portare a un degrado delle prestazioni e a un aumento della latenza durante il recupero e l'elaborazione dei dati.
La chiave per risolvere questo problema è monitorare regolarmente la dimensione delle partizioni e suddividere quelle grandi in partizioni più piccole per distribuire i dati in modo più uniforme. Inoltre, è utile regolare le policy di retention per controllare la quantità di dati archiviati nelle partizioni.
Le partizioni sotto-replicate si verificano quando il numero di repliche sincronizzate (ISR) scende al di sotto del minimo configurato a fronte di guasti dei broker o problemi di rete.
Per prevenirlo, monitora lo stato di replica delle partizioni e indaga su eventuali partizioni sotto-replicate. Assicurati che il fattore di replica sia configurato correttamente per mantenere il livello desiderato di tolleranza ai guasti. Affronta tempestivamente eventuali problemi legati alla connettività di rete o ai guasti dei broker.
I leader di partizione gestiscono le richieste di lettura e scrittura in un cluster Kafka. Uno sbilanciamento dei leader di partizione tra i broker può portare a un utilizzo disomogeneo delle risorse e a potenziali problemi di prestazioni.
Per prevenirlo, monitora la distribuzione dei leader di partizione utilizzando Kafka Manager o Confluent Control Center e ribilancia i leader se necessario. Valuta anche la regolazione delle configurazioni dei broker per distribuire uniformemente i leader di partizione tra i broker.
Lo skew delle partizioni si verifica quando alcune partizioni ricevono un volume di traffico sproporzionatamente elevato rispetto ad altre, determinando un utilizzo disomogeneo delle risorse e un potenziale degrado delle prestazioni. Ecco perché è importante analizzare i pattern di traffico.
Valuta l'implementazione di una strategia di partizionamento personalizzata per distribuire uniformemente i dati tra le partizioni e ottimizza le configurazioni dei consumer group per distribuire equamente il carico tra i consumer.
Apache Kafka è una robusta piattaforma di streaming distribuita che funge da spina dorsale per numerose applicazioni data-intensive. Al suo centro c'è il concetto di partizioni, unità essenziali per organizzare e distribuire i dati all'interno dei topic Kafka. Le partizioni sono fondamentali nell'ecosistema di Kafka, poiché abilitano scalabilità, tolleranza ai guasti, parallelismo ed elaborazione efficiente dei dati.
Distribuendo i dati su più broker, le partizioni consentono a Kafka di gestire grandi volumi di dati mantenendo un throughput elevato e un'elevata affidabilità. Inoltre, le partizioni facilitano l'elaborazione dei dati in parallelo, garantendo un utilizzo ottimale delle risorse e una latenza ridotta.
In definitiva, comprendere e gestire efficacemente le partizioni è fondamentale per massimizzare le prestazioni e l'affidabilità dei cluster Kafka, rendendole componenti indispensabili per costruire pipeline e applicazioni di dati in tempo reale scalabili e resilienti.
Ecco alcune risorse per continuare a imparare:
Continua a imparare con DataCamp
Corso
Programma
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



