
Cours
Présentation de l’ingénierie des données
2 h
372.5K
Les partitions sont des composants essentiels de l’architecture distribuée de Kafka. Elles permettent à Kafka de s’étendre horizontalement et d’assurer un traitement parallèle efficace des données. Ce sont les briques de base qui servent à organiser et à distribuer les données dans le cluster Kafka.
Pensez-y comme à des canaux individuels au sein d’un topic où les messages sont stockés. Chaque partition peut avoir plusieurs réplicas répartis sur différents brokers, garantissant la tolérance aux pannes et la redondance des données.
De plus, les partitions offrent des garanties d’ordonnancement : elles veillent à ce que les messages d’une même partition soient traités dans l’ordre où ils ont été produits. Les partitions Kafka sont donc déterminantes pour préserver l’intégrité et la cohérence des données — un point crucial pour les cas d’usage en temps réel.
Dans cet article, nous allons approfondir les points suivants :
Vous pouvez consulter notre comparatif Kafka vs SQS pour un guide détaillé des différences entre ces deux outils.
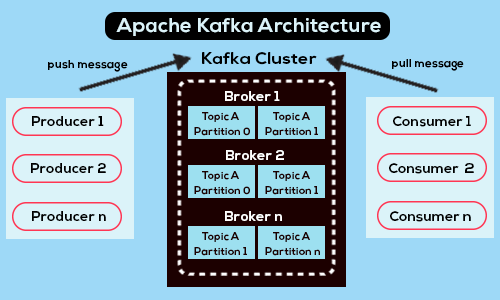
Vue d’ensemble de l’architecture de Kafka - Source
Apache Kafka est une plateforme de streaming distribuée open source, conçue pour un débit élevé, une forte tolérance aux pannes et une grande évolutivité ; elle s’impose comme un choix de référence pour construire des pipelines de données et des applications en temps réel.
Au cœur de Kafka se trouvent plusieurs composants : producteurs, consommateurs, brokers, topics et partitions, chacun jouant un rôle essentiel dans le système global.
Les partitions sont clés pour l’efficacité et la robustesse de Kafka. Elles facilitent la répartition des données entre les brokers, permettant une mise à l’échelle horizontale.
En divisant les topics en partitions, Kafka peut répartir les charges de traitement entre plusieurs serveurs, optimiser l’utilisation des ressources et absorber la montée en volume sans saturer un broker isolé.
Les partitions permettent aussi le parallélisme du traitement : des consommateurs peuvent lire simultanément depuis plusieurs partitions, ce qui distribue la charge de calcul et augmente le débit. Cette consommation parallèle améliore l’utilisation des ressources côté consommateurs et réduit la latence dans les pipelines.
Autre point d’importance : elles renforcent la tolérance aux pannes. Chaque partition peut disposer de plusieurs réplicas répartis sur différents brokers. En cas de panne d’un broker, Kafka peut continuer à servir les données depuis les réplicas présents sur d’autres brokers, assurant disponibilité et fiabilité.
En somme, les partitions sont cruciales à plus d’un titre : elles sont au cœur de l’architecture de Kafka et conditionnent son évolutivité, sa tolérance aux pannes, son parallélisme et la cohérence des données.
Comme indiqué plus haut, chaque partition est une séquence de messages segmentée, ordonnée et immuable. Lorsqu’un producteur envoie des données à Kafka, il applique une logique de partitionnement pour déterminer dans quelle partition du topic écrire.
Cette logique peut s’appuyer sur différents facteurs, comme une clé associée aux données ou un partitionneur personnalisé implémenté côté producteur. Une fois la partition choisie, Kafka ajoute les données en fin de partition, en préservant l’ordre des messages via leurs offsets.
En interne, les brokers Kafka gèrent le stockage et la réplication des données des partitions. Chaque partition peut être répliquée sur plusieurs brokers pour assurer la tolérance aux pannes.
Kafka utilise un modèle leader/follower : un broker leader gère les lectures et écritures de la partition, tandis que les autres brokers, followers, répliquent les données depuis le leader. Cette architecture garantit la durabilité et la disponibilité des données même en cas de panne d’un broker.
Avant de configurer une partition Kafka, assurez-vous qu’Apache Kafka et Zookeeper sont installés, configurés et en cours d’exécution sur votre machine locale, pour une compatibilité optimale. Vérifiez également que Java 8 (ou une version plus récente) est installé et opérationnel.
Notez que Kafka peut rencontrer divers problèmes sous Windows, ce système n’étant pas nativement compatible. Il est donc recommandé d’utiliser les méthodes suivantes pour lancer Apache Kafka sur Windows :
Faire tourner Kafka sur Windows via la JVM est déconseillé : il manque certaines caractéristiques POSIX propres à Linux. Tenter de l’exécuter sans WSL2 risque de poser des difficultés à terme.
Pour en savoir plus sur la configuration d’Apache Kafka, consultez Apache Kafka for Beginners: A Comprehensive Guide.
Voici un guide pas à pas pour configurer des partitions :
Ouvrez l’invite de commandes et placez-vous à la racine du répertoire Kafka. Exécutez ensuite la commande suivante pour démarrer Zookeeper :
bin/zookeeper-server-start.sh config/zookeeper.propertiesOuvrez une autre invite de commandes et exécutez la commande suivante depuis la racine d’Apache Kafka pour démarrer le serveur :
.\bin\windows\kafka-server-start.bat .\config\server.propertiesPour créer un topic avec trois partitions, ouvrez une nouvelle invite de commandes à la racine de Kafka et lancez :
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicCette commande crée un nouveau topic Kafka nommé « my_topic ».
Remarque : pour confirmer la création, la commande renverra « Create topic <name of topic>. »
Vous pouvez vérifier la création du topic en exécutant :
bin/kafka-topics.sh --list --zookeeper localhost:2181Ce qui devrait afficher :
my_topicRépartitionner des topics existants dans Kafka consiste à modifier le nombre de partitions, ce qui peut s’avérer nécessaire pour suivre l’évolution des volumes, améliorer le parallélisme ou optimiser l’usage des ressources.
Voici des techniques et points de vigilance pour répartitionner des topics :
kafka-topics.sh --alter pour augmenter le nombre de partitions d’un topic existant. Les données seront redistribuées sur les nouvelles partitions.Optimiser l’usage et les performances des partitions dans Kafka est essentiel pour un traitement efficace des données, une bonne utilisation des ressources et une évolutivité globale du système.
Voici quelques stratégies d’équilibrage et d’optimisation :
Kafka est devenu l’épine dorsale de nombreuses applications intensives en données, mais, pour paraphraser l’Oncle Ben dans Spider-Man, avec de grands pouvoirs viennent des défis plus complexes.
Plusieurs problèmes récurrents peuvent survenir autour des partitions : mauvaises configurations, contraintes de ressources, répartition inhomogène des données, etc.
Dans cette section, nous examinons ces problèmes courants et les façons de les résoudre.
Quand les données sont mal réparties entre partitions, certaines deviennent des points chauds, ce qui provoque une utilisation déséquilibrée des ressources et des goulets d’étranglement. Pour y remédier, surveillez en continu la distribution des données avec des outils comme Kafka Manager ou Confluent Control Center. Envisagez aussi un partitionnement personnalisé ou l’augmentation du nombre de partitions pour obtenir une répartition plus homogène.
Quand une partition accumule beaucoup de données avec le temps, les performances peuvent se dégrader et la latence de lecture/traitement augmenter.
La clé est de surveiller régulièrement la taille des partitions et de scinder les plus volumineuses pour mieux répartir les données. Ajustez également les politiques de rétention pour contrôler la quantité de données stockées.
Les partitions sous-répliquées apparaissent quand le nombre d’ISRs (in-sync replicas) passe sous le minimum configuré, par exemple lors de pannes de brokers ou de problèmes réseau.
Pour prévenir cela, surveillez l’état de réplication des partitions et investiguez tout cas de sous-réplication. Vérifiez que le facteur de réplication est adapté au niveau de tolérance aux pannes souhaité et corrigez rapidement tout problème de connectivité réseau ou de brokers.
Les leaders de partition gèrent les requêtes de lecture et d’écriture. Un déséquilibre des leaders entre les brokers peut entraîner une utilisation inégale des ressources et des problèmes de performance.
Pour éviter cela, surveillez la distribution des leaders avec Kafka Manager ou Confluent Control Center et rééquilibrez si nécessaire. Ajustez également la configuration des brokers pour répartir les leaders de façon homogène.
Le skew survient lorsque certaines partitions reçoivent beaucoup plus de trafic que d’autres, déséquilibrant l’usage des ressources et dégradant les performances. D’où l’importance d’analyser les schémas de trafic.
Envisagez un partitionnement personnalisé pour mieux répartir les données entre partitions et optimisez la configuration des consumer groups pour équilibrer la charge entre consommateurs.
Apache Kafka est une plateforme de streaming distribuée robuste, pilier de nombreuses applications intensives en données. Au centre, on trouve le concept de partitions, unités essentielles pour organiser et distribuer les données au sein des topics. Elles sont déterminantes dans l’écosystème Kafka : évolutivité, tolérance aux pannes, parallélisme et traitement efficace.
En répartissant les données sur plusieurs brokers, les partitions permettent à Kafka de gérer de grands volumes tout en conservant un débit élevé et une grande fiabilité. Elles facilitent aussi le traitement en parallèle, optimisent l’usage des ressources et réduisent la latence.
En définitive, comprendre et bien gérer les partitions est crucial pour maximiser les performances et la fiabilité des clusters Kafka ; c’est un ingrédient indispensable pour bâtir des pipelines et applications temps réel à la fois évolutifs et résilients.
Pour aller plus loin :
Continuez à apprendre avec DataCamp
Cours
Cursus
Cursus