
Kurs
Grundlagen von Data Engineering
2 Std.
372.4K
Partitionen sind zentrale Bausteine in Kafkas verteilter Architektur. Sie ermöglichen horizontale Skalierung und damit eine effiziente parallele Verarbeitung von Daten. Mit ihnen werden Daten im Kafka-Cluster strukturiert und verteilt.
Stell sie dir als einzelne Kanäle innerhalb eines Topics vor, in denen Nachrichten gespeichert werden. Jede Partition kann mehrere Replikate auf unterschiedlichen Brokern haben und sorgt so für Fehlertoleranz und Datenredundanz.
Darüber hinaus garantieren Partitionen die Reihenfolge: Nachrichten innerhalb einer Partition werden in der Reihenfolge verarbeitet, in der sie erzeugt wurden. Das macht Kafka-Partitionen entscheidend für Datenintegrität und -konsistenz – ein Muss für Echtzeitverarbeitung.
In diesem Artikel schauen wir uns im Detail an:
Eine ausführliche Gegenüberstellung findest du in unserem Vergleich von Kafka vs. SQS.
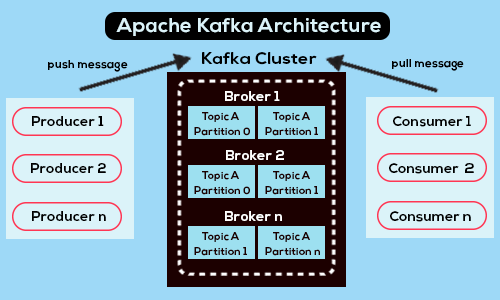
Ein Überblick über Kafkas Architektur – Quelle
Apache Kafka ist eine Open-Source-Streaming-Plattform für hohen Durchsatz, Fehlertoleranz und Skalierbarkeit. Sie ist eine der beliebtesten Optionen für Echtzeit-Datenpipelines und -anwendungen.
Im Kern besteht Kafka aus mehreren Komponenten: Producer, Consumer, Broker, Topics und Partitionen – und jede davon erfüllt eine Schlüsselfunktion im Gesamtsystem.
Partitionen prägen Kafkas Effizienz und Robustheit. Sie verteilen Daten über die Broker und ermöglichen so horizontale Skalierung.
Indem Topics in Partitionen aufgeteilt werden, kann Kafka Workloads über mehrere Server streuen, Ressourcen besser ausnutzen und wachsende Datenmengen verarbeiten, ohne einzelne Broker zu überlasten.
Partitionen ermöglichen außerdem Parallelität in der Verarbeitung. Consumer können gleichzeitig aus mehreren Partitionen lesen, die Rechenlast verteilen und den Durchsatz erhöhen. Diese parallele Datenaufnahme nutzt Consumer-Ressourcen optimal und senkt die Latenz in Datenpipelines.
Ein weiterer Grund: Partitionen stärken die Fehlertoleranz. Jede Partition kann mehrere Replikate auf unterschiedlichen Brokern haben. Fällt ein Broker aus, liefert Kafka weiterhin Daten über Replikate auf anderen Brokern – Verfügbarkeit und Zuverlässigkeit bleiben erhalten.
Kurz gesagt: Partitionen sind unverzichtbar für Kafkas Architektur. Sie sind der Schlüssel zu Skalierbarkeit, Fehlertoleranz, Parallelität und Datenkonsistenz.
Wie eingangs erwähnt, ist jede Partition eine segmentierte, geordnete und unveränderliche Sequenz von Records. Wenn ein Producer Daten an Kafka sendet, entscheidet eine Partitionierungslogik, in welche Partition eines Topics geschrieben wird.
Diese Logik kann auf verschiedenen Faktoren basieren, etwa auf einem Schlüssel der Daten oder auf einem benutzerdefinierten Partitioner des Producers. Steht die Partition fest, hängt Kafka die Daten am Ende der Partition an und behält die Nachrichtenreihenfolge anhand ihrer Offsets bei.
Intern übernehmen Kafka-Broker die Speicherung und Replikation der Partitionsdaten. Jede Partition kann mehrere Replikate auf verschiedenen Brokern haben, um Fehlertoleranz sicherzustellen.
Kafka nutzt dabei ein Leader-Follower-Modell: Ein Broker ist Leader und bedient Lese- und Schreibanfragen für die Partition, die übrigen Broker sind Follower und replizieren die Daten vom Leader. So bleiben Daten dauerhaft verfügbar – selbst bei Broker-Ausfällen.
Bevor du Partitionen einrichtest, stelle sicher, dass Apache Kafka und Zookeeper auf deinem lokalen Rechner installiert, konfiguriert und gestartet sind. Das sorgt für optimale Kompatibilität. Prüfe außerdem, dass Java 8 oder neuer installiert und lauffähig ist.
Beachte: Unter Windows kann es wegen fehlender nativer Kompatibilität zu Problemen kommen. Daher empfiehlt es sich, Apache Kafka unter Windows folgendermaßen zu starten:
Kafka direkt über die JVM unter Windows zu betreiben ist nicht empfehlenswert, da bestimmte POSIX-Eigenschaften von Linux fehlen. Ohne WSL2 kann es langfristig zu Schwierigkeiten kommen.
Mehr zum Setup findest du in Apache Kafka for Beginners: A Comprehensive Guide.
Hier ist eine Schritt-für-Schritt-Anleitung zum Einrichten von Partitionen:
Öffne die Eingabeaufforderung und wechsle ins Kafka-Stammverzeichnis. Führe dann folgenden Befehl aus, um Zookeeper zu starten:
bin/zookeeper-server-start.sh config/zookeeper.propertiesÖffne eine weitere Eingabeaufforderung und starte Apache Kafka vom Stammverzeichnis aus mit:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesUm ein Topic mit drei Partitionen zu erstellen, öffne eine neue Eingabeaufforderung im Kafka-Stammverzeichnis und führe aus:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicDamit wird ein neues Kafka-Topic namens „my_topic“ angelegt.
Hinweis: Zur Bestätigung gibt der Befehl "Create topic <name of topic>." zurück.
Du kannst die Erstellung mit folgendem Befehl prüfen:
bin/kafka-topics.sh --list --zookeeper localhost:2181Die Ausgabe sollte lauten:
my_topicBeim Repartitionieren bestehender Topics wird die Anzahl der Partitionen geändert. Das kann nötig sein, um wachsende Datenmengen zu bewältigen, mehr Parallelität zu erreichen oder Ressourcen besser zu nutzen.
Hier sind Techniken und Punkte, die du beim Repartitionieren beachten solltest:
kafka-topics.sh --alter, um die Partitionsanzahl eines bestehenden Topics zu erhöhen. Dadurch werden Daten auf die neuen Partitionen verteilt.Eine optimale Nutzung und Performance der Partitionen ist entscheidend für effiziente Verarbeitung, gute Ressourcenauslastung und die Skalierbarkeit des Systems.
Folgende Strategien helfen beim Balancing und bei der Optimierung:
Kafka ist das Rückgrat vieler datenintensiver Anwendungen. Doch frei nach Onkel Ben aus Spider-Man: Mit großer Macht wächst das Potenzial für komplexe Herausforderungen.
Bei der Arbeit mit Kafka treten immer wieder ähnliche Partitionsprobleme auf – verursacht durch Fehlkonfigurationen, begrenzte Ressourcen, ungleich verteilte Daten oder andere Faktoren.
Im Folgenden gehen wir auf typische Probleme ein und zeigen Lösungswege.
Werden Daten ungleichmäßig über Partitionen verteilt, entstehen Hotspots. Das führt zu ungleicher Ressourcennutzung und potenziellen Engpässen. Abhilfe schafft konsequentes Monitoring der Verteilung, z. B. mit Kafka Manager oder Confluent Control Center. Implementiere bei Bedarf eine eigene Partitionierungsstrategie oder erhöhe die Partitionsanzahl, um die Verteilung auszugleichen.
Sammelt eine Partition über die Zeit zu viele Daten an, leidet die Performance, und Lese- sowie Verarbeitungslatenzen steigen.
Die Lösung: Überwache die Partitionsgröße regelmäßig und splitte große Partitionen, um Daten besser zu verteilen. Passe außerdem Aufbewahrungsrichtlinien an, um die Datenmenge pro Partition zu steuern.
Unterreplizierte Partitionen entstehen, wenn die Anzahl der In-Sync-Replikas (ISR) bei Broker-Ausfällen oder Netzwerkproblemen unter das konfigurierte Minimum fällt.
Beuge vor, indem du den Replikationsstatus überwachst und unterreplizierte Partitionen untersuchst. Stelle sicher, dass der Replikationsfaktor ausreichend dimensioniert ist. Behebe Netzwerk- oder Broker-Probleme zeitnah.
Partition-Leader bedienen Lese- und Schreibanfragen. Sind Leader ungleich über Broker verteilt, führt das zu ungleicher Ressourcennutzung und möglichen Performanceproblemen.
Überwache die Leader-Verteilung mit Kafka Manager oder Confluent Control Center und rebalance bei Bedarf. Passe Broker-Konfigurationen an, um Leader gleichmäßiger zu verteilen.
Von Partition Skew spricht man, wenn einzelne Partitionen deutlich mehr Traffic erhalten als andere. Das führt zu ungleicher Auslastung und Leistungseinbußen. Analysiere deshalb regelmäßig Traffic-Muster.
Setze gegebenenfalls eine eigene Partitionierungsstrategie ein, um Daten gleichmäßig zu verteilen, und optimiere Consumer-Gruppen, damit die Last fair verteilt wird.
Apache Kafka ist eine robuste, verteilte Streaming-Plattform und das Rückgrat zahlreicher datenintensiver Anwendungen. Im Zentrum stehen Partitionen – die Einheiten, mit denen Daten in Topics organisiert und verteilt werden. Sie ermöglichen Skalierbarkeit, Fehlertoleranz, Parallelität und effiziente Verarbeitung.
Indem Daten über mehrere Broker verteilt werden, kann Kafka große Datenmengen bei hohem Durchsatz und hoher Zuverlässigkeit bewältigen. Gleichzeitig fördern Partitionen parallele Verarbeitung, nutzen Ressourcen optimal und senken Latenzen.
Wer Kafka-Partitionen versteht und gezielt managt, holt das Maximum aus Performance und Zuverlässigkeit seiner Cluster heraus – eine Grundvoraussetzung für skalierbare und resiliente Echtzeit-Datenpipelines und -anwendungen.
Zum Weiterlernen empfehlen wir:
Mit DataCamp weiterlernen
Kurs
Lernpfad
Lernpfad