

什么是 Llama Stack?
Llama Stack 是一个框架,用于简化基于Meta 的 Llama 模型构建与部署生成式 AI 应用的流程。它通过提供一组标准化的 API 与组件,覆盖推理、安全、内存管理与智能体能力等任务。
其目标与优势包括:
- 标准化:这组 API 为开发者提供一致的接口与工作环境,并能在新模型可用时快速适配应用。
- 协同效应:通过将复杂功能抽象为 API,促进不同工具与组件协作,有利于模块化与灵活性。
- 顺畅开发:Llama Stack 通过预定义核心功能并加速部署,为简化开发生命周期提供工具。
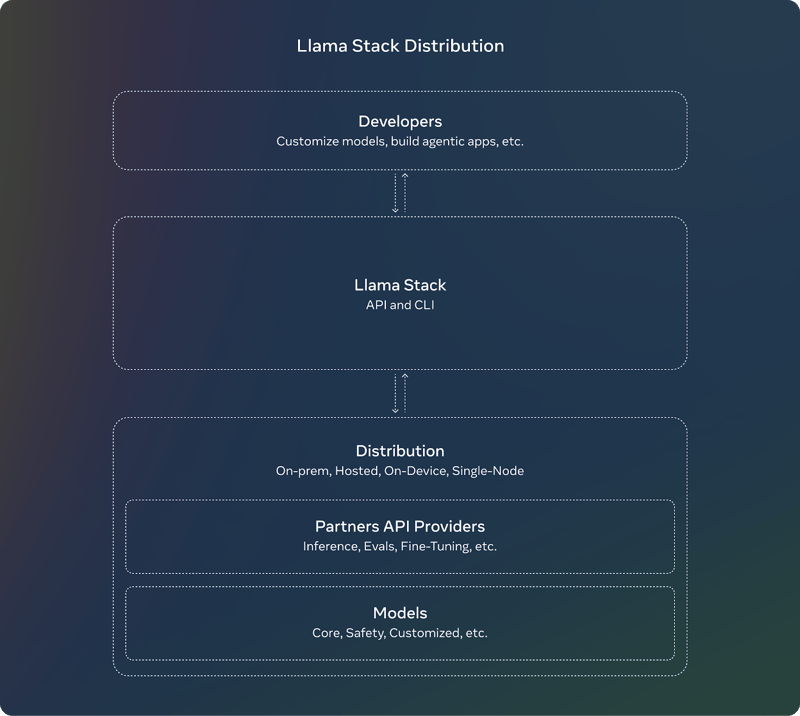
来源:Meta AI
Llama Stack 的组件与 API
Llama Stack 提供多种 API,分别针对构建生成式 AI 应用中的不同任务。
Inference API
Inference API 负责文本生成,或用于提示多模态 Llama 变体。其主要特性包括:
- 支持多种解码策略,如 top-k 采样。
- 支持批处理请求与流式响应,适用于大规模应用。
该 API 定义了多种可配置项,使开发者能按应用需求控制模型行为(例如 FP8 或 BF16量化)。
Safety API
Safety API 致力于负责任地部署 AI 模型,通过内容审核与过滤潜在有害或偏见的输出实现。可配置违规级别(如 INFO、WARN、ERROR),并向用户返回可执行的提示信息。
Memory API
Memory API 使模型能够保留并引用过往交互,从而构建更连贯、具备上下文感知的对话。丰富的内存配置为开发者提供多种存储类型选择,以满足不同应用需求。其主要特性包括:
- 通过多种配置(如向量、键值、关键词和图谱)实现灵活的内存存储,本质上是多种会话记忆的存储方式。
- 允许在内存库中插入、查询、更新与删除文档。查询结果以分块形式返回,并附带相关性评分。
Agentic API
Agentic API 使大型语言模型能够调用外部工具与函数,从而执行网页搜索、代码运行或内存检索等任务。开发者可为智能体配置特定工具与目标。支持多轮交互,每轮可包含多个步骤。其主要特性包括:
- 内置工具包括brave_search、wolfram_alpha、photogen、code_interpreter。可利用这些工具在模型上下文中处理请求或执行代码。
- 与 Memory API 协同,检索相关信息以增强长期上下文。
- 模型可通过多步流程执行任务,如推理、工具调用、内存检索与安全检查。
其他 API
Llama Stack 还提供以下 API:
- Evaluation API:用于评估模型表现。
- Post-training API:用于微调模型以适配特定任务或数据,支持LORA、DORA 等方法。
- 合成数据生成 API:用于生成合成数据集以训练模型。
- 奖励评分 API:适用于强化学习场景,为模型采取的动作或决策分配奖励分数。
如何安装与设置 Llama Stack
我们将实现一个基于 Llama Stack 的示例项目,以熟悉该框架的整体思路与能力。
在开始之前,请注意:
- Llama Stack 发展迅速,在实现客户端时可能会遇到 bug,因此务必参考仓库文档并反馈问题。以本文写作时为例,我在 Windows 上因操作系统相关问题无法运行 Llama Stack 容器,开发团队正在跟进处理。
- 您无法在 Google Colab 上使用 Llama Stack,因为该平台免费版不支持构建 Docker 容器。
现在开始设置 Llama 命令行界面(CLI)。
1. Llama CLI
Llama Stack 提供命令行界面(CLI),用于管理发行版、安装模型与配置环境。安装步骤如下:
a. 创建并激活虚拟环境:
conda create -n llama_stack python=3.10
conda activate llama_stackb. 克隆 Llama Stack 仓库:
git clone <https://github.com/meta-llama/llama-stack.git>
cd llama-stackc. 安装所需依赖:
pip install llama-stack
pip install -r requirements.txt2. 使用 Docker 容器
Docker 容器可简化 Llama Stack 服务器与 Agent API 提供方的部署。官方提供预构建镜像,便于快速搭建:
docker pull llamastack/llamastack-local-gpu
llama stack build
llama stack configure llamastack-local-gpu以上命令将拉取 Docker 镜像、构建并配置栈环境。
如何使用 Llama Stack API 构建应用
我们来用 Llama Stack API 搭建一个基础聊天机器人。步骤如下:
1. 启动 Llama Stack 服务器
我们将在 5000 端口运行服务器。在使用 API 前请确保服务器已启动:
llama stack run local-gpu --port 50002. 使用 Inference API
安装 Llama Stack 后,您可以通过客户端代码与其 API 交互。使用 Inference API 基于用户输入生成回复:
from llama_stack_client import LlamaStackClient
client = LlamaStackClient(base_url="<http://localhost:5000>")
user_input = "Hello! How are you?"
response = client.inference.chat_completion(
model="Llama3.1-8B-Instruct",
messages=[{"role": "user", "content": user_input}],
stream=False
)
print("Bot:", response.text)注意:请将 "Llama3.1-8B-Instruct" 替换为您环境中可用的实际模型名称。
3. 集成 Safety API
实现 Safety API 对回复进行审核,确保其合规适当:
safety_response = client.safety.run_shield(
messages=[{"role": "assistant", "content": response.text}],
shield_type="llama_guard",
params={}
)
if safety_response.violation:
print("Unsafe content detected.")
else:
print("Bot:", response.text)4. 使用 Memory API 增加记忆
通过存储与检索会话历史,让聊天机器人具备上下文感知能力:
### building a memory bank that can be used to store and retrieve context.
bank = client.memory.create_memory_bank(
name="chat_memory",
config=VectorMemoryBankConfig(
type="vector",
embedding_model="all-MiniLM-L6-v2",
chunk_size_in_tokens=512,
overlap_size_in_tokens=64,
)
)5. 将组件串联
我们可以进一步组合这些 API,构建更健壮的聊天机器人:
- Inference API:生成回复。
- Safety API:过滤不当内容。
- Memory API:维护会话上下文。
完整示例
以下是完成上述步骤后的完整代码:
import uuid
client = LlamaStackClient(base_url="<http://localhost:5000>")
### create a memory bank at the start
bank = client.memory.create_memory_bank(
name="chat_memory",
config=VectorMemoryBankConfig(
type="vector",
embedding_model="all-MiniLM-L6-v2",
chunk_size_in_tokens=512,
overlap_size_in_tokens=64,
)
)
def get_bot_response(user_input):
### retrieving conversation history
query_response = client.memory.query_documents(
bank_id=bank.bank_id,
query=[user_input],
params={"max_chunks": 10}
)
history = [chunk.content for chunk in query_response.chunks]
### preparing messages with history
messages = [{"role": "user", "content": user_input}]
if history:
messages.insert(0, {"role": "system", "content": "\\n".join(history)})
### generate response
response = client.inference.chat_completion(
model="llama-2-7b-chat",
messages=messages,
stream=False
)
bot_response = response.text
### safety check
safety_response = client.safety.run_shield(
messages=[{"role": "assistant", "content": bot_response}],
shield_type="llama_guard",
params={}
)
if safety_response.violation:
return "I'm sorry, but I can't assist with that request."
### memory storing
documents = [
MemoryBankDocument(
document_id=str(uuid.uuid4()),
content=user_input,
mime_type="text/plain"
),
MemoryBankDocument(
document_id=str(uuid.uuid4()),
content=bot_response,
mime_type="text/plain"
)
]
client.memory.insert_documents(
bank_id=bank.bank_id,
documents=documents
)
return bot_response
### putting all together
while True:
user_input = input("You: ")
if user_input.lower() == "bye":
break
bot_response = get_bot_response(user_input)
print("Bot:", bot_response)Llama Stack 的示例与社区贡献
若想查看示例并快速启动基于 Llama Stack 的应用实现,Meta 提供了 llama-stack-apps 仓库,您可以在其中查看一些示例应用。请务必查阅并熟悉该框架。
作为开源项目,Llama Stack 依赖社区贡献。API 演进迅速,项目欢迎开发者反馈与参与,共同塑造平台的未来。如果您试用了 Llama Stack,不妨将您的项目作为示例分享,或为文档做出贡献,帮助更多开发者。
结语
本文通过分步说明,介绍了如何开始使用 Llama Stack。
在推进 AI 应用部署时,请持续关注Llama Stack 仓库的最新更新与改进。
想进一步了解 Llama 生态,可参考以下资源:

人工智能硕士生与 AI 技术写作者。我分享最新的 AI 技术见解,让机器学习研究更易理解,并将复杂的 AI 主题加以简化,助您始终走在前沿。
尽管生成式 AI 应用大受欢迎,但如何高效、可靠地构建与部署此类应用仍是一大挑战。
Llama Stack 是 Meta 的一个开源项目,专为解决这一复杂性而生。
Llama Stack 引入了标准化框架与模块化 API,带来更快更顺畅的开发体验。它定义并标准化了将生成式 AI 应用推向市场所需的基础模块。
本文将通过分步指引带您上手 Llama Stack。若您正准备将 AI 应用部署到生产环境,请务必查阅Llama Stack 仓库,因为其仍在持续演进中。