

理解不同类型的 SCD
处理缓慢变化维度的方法不止一种。我们来看看最常见的三种方式。
SCD 类型 1
使用 SCD 类型 1,当维度表中的某条记录发生变化时,会对现有记录进行更新或覆盖。否则,将把新记录插入维度表。也就是说,维度表中的记录始终反映当前状态,不保留历史数据。
一个存储杂货店所售商品信息的表,可能会用 SCD 类型 1 处理变更记录。如果表中已存在目标商品的记录,就用新信息更新;否则将该记录插入维度表。
在数据工程领域,这种存在则更新、否则插入的做法被称为“upsert(更新插入)”。下表包含杂货店中售出商品的信息。
|
item_id |
name |
price |
aisle |
|
93201 |
Potato Chips |
3.99 |
11 |
|
07879 |
Soda |
7.99 |
13 |
如果 Potato Chips 被移到第 6 号过道,使用 SCD 类型 1 在维度表中捕捉这一变更,将得到如下结果:
|
item_id |
name |
price |
aisle |
|
93201 |
Potato Chips |
3.99 |
6 |
|
07879 |
Soda |
7.99 |
13 |
SCD 类型 1 确保表中没有重复记录,并且数据反映最新的当前维度。这对于只关心当前状态的实时看板与预测建模尤其有用。
然而,由于表中只存储最新信息,从业者无法比较维度随时间的变化。例如,没有其他信息的情况下,数据分析师难以判断 Potato Chips 移到第 6 号过道后带来的营收提升。
SCD 类型 1 便于当前状态的报表与分析,但在进行历史分析时存在局限。
SCD 类型 2
仅反映当前状态的表虽然有用,但有时跟踪维度的历史变化也很方便,甚至是必要的。采用 SCD 类型 2,当维度发生变化时,通过新增一行来保留历史数据,并将该新行标记为当前,同时相应地将旧记录标记为历史。
说起来容易,实际是什么样子可能还不够直观。我们来看个例子。
这里有一个与我们讨论 SCD 类型 1 时类似的表。但它多了一列。is_current 存储一个布尔值;若记录反映当前值则为 true,否则为 false。
|
item_id |
name |
price |
aisle |
is_current |
|
93201 |
Potato Chips |
3.99 |
11 |
True |
|
07879 |
Soda |
7.99 |
13 |
True |
如果 Potato Chips 移到第 6 号过道,用 SCD 类型 2 记录这一变化后,表格将如下所示:
|
item_id |
name |
price |
aisle |
is_current |
|
93201 |
Potato Chips |
3.99 |
11 |
False |
|
07879 |
Soda |
7.99 |
13 |
True |
|
93201 |
Potato Chips |
3.99 |
6 |
True |
新增一行以反映 Potato Chips 的位置变化,并在 is_current 列中存储 True。为保留历史数据并准确表示当前状态,将上一条记录的 is_current 列设为 False。至于 SCD 类型 1,
但如果您想研究 Potato Chips 的销量对位置变化的响应呢?当单个商品存在多条历史记录时,仅靠一个标记列会相当困难。幸运的是,有一个简单的方法。
看下面的表。这个维度表包含与之前相同的信息,但不再使用 is_current 列,而是有 start_date 和 end_date 两列。这两个日期表示某个维度作为“当前值”的时间区间。由于该表中的数据是最新的,end_date 被设置为遥远的将来。
|
item_id |
name |
price |
aisle |
start_date |
end_date |
|
93201 |
Potato Chips |
3.99 |
11 |
2023-11-13 |
2099-12-31 |
|
07879 |
Soda |
7.99 |
13 |
2023-08-24 |
2099-12-31 |
如果 Potato Chips 于 2024 年 1 月 4 日移至第 6 号过道,更新后的表如下:
|
item_id |
name |
price |
aisle |
start_date |
end_date |
|
93201 |
Potato Chips |
3.99 |
6 |
2024-01-04 |
2099-12-31 |
|
07879 |
Soda |
7.99 |
13 |
2023-08-24 |
2099-12-31 |
|
93201 |
Potato Chips |
3.99 |
11 |
2023-11-13 |
2024-01-03 |
请注意,第一行的 end_date 已更新为 Potato Chips 最后在第 11 号过道上架的日期。同时新增一条记录,表示该商品已转至第 6 号过道。start_date 与 end_date 有助于展示变更发生的时间,并指示哪条记录是当前的。
使用这种技术来实现 SCD 类型 1 不仅保留了历史数据,还提供了数据变更发生时间的信息,从而使数据分析师和数据科学家能够探索运营变更、进行 A/B 测试,并支撑明智决策。
SCD 类型 3
当处理的数据预期只变更一次,或仅关心最近的一条历史记录时,SCD 类型 3 十分有用。与其对变更后的维度进行“upsert”或将其作为新行存储,SCD 类型 3 通过新增一列来表示变化。这稍微有点拗口,我们直接看例子。
下表包含美国各地球队的体育项目相关信息。这里,表中有两列用于存储当前与历史的球场名称。由于这些球队目前都在使用最初的球场名称,previous_stadium_name 列均为 NULL。
|
team_id |
team_name |
sport |
current_stadium_name |
previous_stadium_name |
|
562819 |
Lafayette Hawks |
Football |
Triple X Stadium |
NULL |
|
930193 |
Fort Niagara Squirrels |
Soccer |
Musket Stadium |
NULL |
如果 Lafayette Hawks 决定与新赞助商签订 25 年的冠名协议,更新后的表可能如下:
|
team_id |
team_name |
sport |
current_stadium_name |
previous_stadium_name |
|
562819 |
Lafayette Hawks |
Football |
Wabash Field |
Triple X Stadium |
|
930193 |
Fort Niagara Squirrels |
Soccer |
Musket Stadium |
NULL |
为反映新的球场名称,将“Triple X Stadium”移至 previous_stadium_name 列,而“Wabash Field”填入 current_stadium_name 列。该为期 25 年的冠名协议很可能会超过当前模型的生命周期,也就意味着这条记录大概率不会再次变更。
使用 SCD 类型 3 可以很方便地将当前数据与历史数据进行对比。每支球队只有一行记录,当前与历史数据并排存放于两列中。不过,这也意味着对于单个维度属性只能保留一条历史记录,如果数据变化比预期更频繁,这将具有一定限制。
除了类型 1、2 和 3 之外,还有其他多种实现缓慢变化维度的技术。类型 0 适用于维度永不变化的场景。类型 4 将历史数据存放在单独的表中,同时在维度表中保留当前数据。类型 6 则是类型 1、2、3 的融合,通常通过结合这些技术的优点来实现。
缓慢变化维度:分步实现指南
数据仓库中的维度数据
我们已经介绍了缓慢变化维度的基础。为了更好地理解如何实现这些技术,我们通过一个示例来说明。
在本示例中,我们将使用 Snowflake 为零售交易实现 SCD 类型 1、2 和 3。如果您需要回顾 Snowflake 的基础,请查看我们的Snowflake 入门课程。
我们有一个名为 sales 的事实表,和三个名为 employees、items、discounts 的维度表。下面是该星型模型的 ERD。
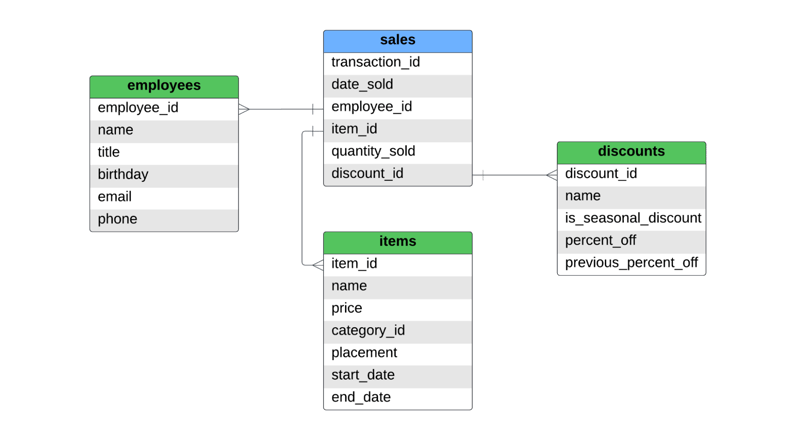
sales 表按商品粒度记录销售。如果顾客买了两件衬衫和一条牛仔裤,事实表中会有两条记录,因为售出了两种不同商品。对于 SCD 类型 1、2、3,我们将涵盖以下内容:
- 维度可能发生变化的常见方式
- 当维度变化时如何更新表
- 使用 Snowflake 实现各类 SCD 技术
我们不会讨论这些表最初如何被填充,但通常是ETL 或 ELT 流水线在数据仓库上游从源系统抽取原始数据、将其转换为目标模型,并加载至最终目的地。
实现 SCD 类型 1
为实践 SCD 类型 1 的实现,我们来看 employee 表。该表包含员工的基本信息,包括姓名、职位和联系方式。它可能包含如下记录。
|
employee_id |
name |
title |
birthday |
|
phone |
|
477379 |
Emily Verplank |
Manager |
1989-07-28 |
928-144-8201 | |
|
392005 |
Josh Murray |
Cashier |
2002-12-11 |
717-304-5547 |
采用 SCD 类型 1 来捕捉这一缓慢变化维度时,现有记录将被最新记录覆盖。如果其中某个维度属性发生变化,应将新记录“upsert”到现有表中。比如,若 Emily 的电话号码变更为 928-652-9704,更新后的表如下:
|
employee_id |
name |
title |
birthday |
|
phone |
|
477379 |
Emily Verplank |
Manager |
1989-07-28 |
928-652-9704 | |
|
392005 |
Josh Murray |
Cashier |
2002-12-11 |
717-304-5547 |
在 Snowflake 中,我们将使用 MERGE INTO 命令来实现。MERGE INTO 允许数据从业者提供一个匹配键和一个条件;若匹配键与条件同时满足,则使用 UPDATE 关键字更新记录;否则可以 INSERT 新记录,或停止执行。
在开始使用 MERGE INTO 命令之前,我们先创建并向一个名为 stage_employees 的表添加记录。它将包含自上次刷新 employees 表以来所有被更新的记录。可使用以下语句完成。
CREATE OR REPLACE TABLE stage_employees (
employee_id INT,
name VARCHAR,
title VARCHAR,
birthday DATE,
email VARCHAR,
phone VARCHAR
);
INSERT INTO stage_employees (
employee_id,
name,
title,
birthday,
email,
phone
) VALUES (
477379,
'Emily Verplank',
'Manager',
'1989-07-28',
'[email protected]',
'928-652-9704'
);
现在,我们可以使用 Snowflake 的 MERGE 功能来“upsert”现有记录。
MERGE INTO employees USING stage_employees
ON employees.employee_id = stage_employees.employee_id
WHEN MATCHED THEN UPDATE SET
employees.name = stage_employees.name,
employees.title = stage_employees.title,
employees.email = stage_employees.email,
employees.phone = stage_employees.phone
WHEN NOT MATCHED THEN INSERT (
employee_id,
name,
title,
birthday,
email,
phone
) VALUES (
stage_employees.employee_id,
stage_employees.name,
stage_employees.title,
stage_employees.birthday,
stage_employees.email,
stage_employees.phone
);
上述示例中,employees 与 stage_employees 表之间用于合并数据的键是 employee_id 字段。没有设置其他条件,这意味着只要 employee_id 匹配,name、title、email 与 phone 等维度属性就会用 stage_employees 表中的值进行更新。若 stage_employees 中的记录与 employees 表中的任何记录都不匹配,该记录就会被插入到 employees 表中。
实现 SCD 类型 2
实现 SCD 类型 2 比类型 1 更棘手一些。虽然它不像覆盖或插入那么简单,但我们仍可以使用 Snowflake 的 MERGE INTO 逻辑来解决。先看看下面这个维度表。
|
item_id |
name |
price |
category_id |
placement |
start_date |
end_date |
|
667812 |
Socks |
8.99 |
156 |
Aisle 11 |
2023-08-24 |
NULL |
|
747295 |
Sports Jersey |
59.99 |
743 |
Aisle 8 |
2023-02-17 |
NULL |
该表包含零售店中特定商品的信息。维度属性包括商品名称、价格、陈列位置,以及指向该商品所属品类的外键。为实现 SCD 类型 2,我们需要进行“upsert”,并通过 start_date 与 end_date 同时维护历史与当前数据。
假设在 NFL(美国国家橄榄球联盟)赛季开始时,为了让顾客进店就能看到,运动球衣被移至店铺入口。同时,该商品的价格下调。为体现这一运营行为并保留历史数据,需要将现有记录补上结束日期,并插入一条新记录。如下所示:
|
item_id |
name |
price |
category_id |
placement |
start_date |
end_date |
|
667812 |
Socks |
8.99 |
156 |
Aisle 11 |
2023-08-24 |
NULL |
|
747295 |
Sports Jersey |
59.99 |
743 |
Aisle 8 |
2023-02-17 |
2023-11-13 |
|
747295 |
Sports Jersey |
49.99 |
743 |
Entry Display |
2023-11-13 |
NULL |
与之前类似,我们先创建一个名为 stage_items 的表。该表将存放用于在对应的 items 维度中实施 SCD 类型 2 的记录,形式如上。创建完 stage_items 后,我们插入一条同时包含球衣陈列位置和价格变化的记录。
CREATE OR REPLACE TABLE stage_items (
item_id INT,
name VARCHAR,
price FLOAT,
category_id INT,
placement VARCHAR,
start_date DATE,
end_date DATE
);
INSERT INTO stage_items (
item_id,
name,
price,
category_id,
placement,
start_date,
end_date
) VALUES (
747295,
'Sports Jersey',
49.99,
743,
'Entry Display',
'2023-11-13',
NULL
);
现在,是时候使用 Snowflake 的 MERGE INTO 来实现 SCD 类型 2 了。这比之前的例子更复杂,需要多想一步。由于只有在匹配条件不满足时才能插入记录,我们需要分两步进行。首先,用下列三个条件构造匹配:
items与stage_items表中的item_id必须匹配stage_items表的start_date必须大于items表中的start_dateitems表的end_date必须为NULL
若这三个条件同时满足,就需要更新 items 表中的原有记录。注意:items.end_date 将不再为 NULL,而是取 stage_items 表中 start_date 的值。第一条语句在未匹配时不包含任何逻辑。
接着,我们用另一条 MERGE INTO 语句插入新记录。这一步更难一些。要插入新记录,必须不满足匹配条件。
在本例中,我们可以通过检查两表的 items_id 是否匹配,以及 items 表中的 end_date 是否为 NULL 来实现。进一步拆解如下:
- 如果
items_id匹配且items.end_date为NULL,说明items表中已存在一条当前记录,因此不应插入新记录。 - 如果两表中没有任何
item_id匹配,匹配条件不成立,将插入一条新行。这将是该item_id在items表中的首条记录。 - 如果
stage_items表中的item_id能与items表中相同的item_id匹配,且end_date非NULL,则会插入一个新值。这样既保留了历史数据,也确保了items表中存在一条当前记录。
下面是实现方式,使用两条 MERGE INTO 语句先更新现有记录,再插入最新数据。
MERGE INTO items USING stage_items
ON items.item_id = stage_items.item_id
AND items.start_date < stage_items.start_date
AND items.end_date IS NULL
WHEN MATCHED
THEN UPDATE SET
-- Update the existing record
items.name = stage_items.name,
items.price = stage_items.price,
items.category_id = stage_items.category_id,
items.placement = stage_items.placement,
items.start_date = items.start_date,
items.end_date = stage_items.start_date
;
MERGE INTO items USING stage_items
ON items.item_id = stage_items.item_id
AND items.end_date IS NULL
WHEN NOT MATCHED THEN INSERT (
item_id,
name,
price,
category_id,
placement,
start_date,
end_date
) VALUES (
stage_items.item_id,
stage_items.name,
stage_items.price,
stage_items.category_id,
stage_items.placement,
stage_items.start_date,
NULL
);
实现 SCD 类型 3
最后,我们用一个新维度来看看如何实现 SCD 类型 3。在示例中,discounts 表存储顾客在结账时可用的部分折扣信息。该表包含折扣 ID、名称、折扣百分比以及是否为季节性折扣。以下是 discounts 表中可能存在的两条记录。
|
discount_id |
name |
is_seasonal |
percent_off |
previous_percent_off |
|
994863 |
Rewards Member |
False |
10 |
NULL |
|
467782 |
Employee Discount |
False |
50 |
NULL |
由于零售商预计折扣不会频繁变更,该维度非常适合采用类型 3 的方法来处理缓慢变化维度。如果折扣的百分比发生变化,先前的折扣百分比将移至 previous_percent_off 列,新值则写入 percent_off 列。
这样既能保留历史数据,又能在 percent_off 列中呈现最新数值。
|
discount_id |
name |
is_seasonal |
percent_off |
previous_percent_off |
|
994863 |
Rewards Member |
False |
10 |
NULL |
|
467782 |
Employee Discount |
False |
35 |
50 |
要在 Snowflake 中实现这一点,我们将创建 stage_discounts 表,并插入一条记录。该记录包含新的 percent_off。
CREATE TABLE stage_discounts (
discount_id INTEGER,
name VARCHAR,
is_seasonal BOOLEAN,
percent_off INTEGER
);
INSERT INTO stage_discounts (
discount_id,
name,
is_seasonal,
percent_off
) VALUES (
467782,
'Rewards Member',
FALSE,
35
);
我们再次使用 MERGE INTO 来实现 SCD 类型 3。匹配条件很简单:如果 discounts 与 stage_discounts 表中的 discount_id 匹配,且 percent_off 的数值不同,就更新 discounts 表中的现有记录。现有的 percent_off 将被移至 previous_percent_off 字段;如果两表的 discount_id 不匹配,则插入一条新记录,并将 previous_percent_off 设为 NULL。请注意,这些记录不受时间范围约束,并且只能保留一条 percent_off 的历史值。
MERGE INTO discounts USING stage_discounts
ON discounts.discount_id = stage_discounts.discount_id
WHEN MATCHED
AND discounts.percent_off <> stage_discounts.percent_off
THEN UPDATE SET
discounts.previous_percent_off = discounts.percent_off,
discounts.percent_off = stage_discounts.percent_off
WHEN NOT MATCHED
THEN INSERT (
discount_id,
name,
is_seasonal,
percent_off,
previous_percent_off
) VALUES (
stage_discounts.discount_id,
stage_discounts.name,
stage_discounts.is_seasonal,
stage_discounts.percent_off,
NULL
);
请记住,SCD 类型 3 最适合用于很少改变的数据,并且只需保留最近一条历史记录。如果预计维度会发生多次变化,最好使用 SCD 类型 2。
实施 SCD 时的常见挑战
重复数据
实施任何缓慢变化维度技术时,都应谨慎对待重复数据的可能性。需要关注两类重复:批内重复与批间重复。我们分开来看。
批内重复
批内重复是指存在于不同批次数据之间的重复。如果已有一个维度表,而两个用于更新该表的文件中包含重复记录,就会出现这种情况。
为此,需要在用于“upsert”与/或加载维度表的数据逻辑中添加约束。在上面的示例中,我们贯穿始终地加入了避免重复的逻辑,包括:
- 在使用 SCD 类型 1 时,仅当不存在匹配
employee_id的记录时才插入数据 - 在 SCD 类型 2 的实现中增加额外条件,确保当表中已存在当前记录时不会再次插入
- 在更新现有记录前,检查
items与stage_items表中的percent_off是否不同
批间重复
批间重复是指同一批次数据中出现的重复。例如,如果一个文件中包含两条针对某一维度表记录的更新,就必须采取预防措施。与批间重复类似,必须在实现 SCD 类型 1、2 或 3 的逻辑中加入约束。
如果同一文件中存在冲突记录,就必须通过某种方式加以区分,比如利用记录的元数据或来源提供的时间戳。无论选择哪种方式,都应记录您的假设并与团队一起审查,以确保生成的维度能准确反映运营数据。
确保数据完整性
有时,数据会在不该变更的时候变更。就我们讨论的三种 SCD 技术而言,这可能导致数据被覆盖、插入新行或在新列中填充数据。
我们已讨论了防止重复数据进入维度表的方法。除了重复数据之外,实施 SCD 技术的从业者还应注意以下问题:
- 变更被错误回滚
- 维度极其频繁或幅度很大的变化
- 记录格式不正确
并非所有上述情况都能在维护维度表的代码中直接捕获,但制定强有力的数据质量规则并对维度进行监控,可以帮助确保数据完整性得到维护。
SCD 进阶主题
为大型数据集优化 SCD 实现
在上面的零售示例中,我们处理的数据集只有几行。在生产环境中,这些维度表可能包含数百甚至数千条记录。若维度变化频繁,在实施 SCD 类型 2 时尤为常见。
随着维度表行数增长,数据从业者在设计与实现时必须将性能置于核心位置。以下是在 Snowflake 中为大型数据集优化 SCD 实现的方法:
- 在目标表上使用主键等约束,以
- 利用微分区与数据聚簇,减少
MERGE语句需要处理的数据量 - 使用 Query Plan 与 Query Profile 识别并解决查询瓶颈
- 在合适场景考虑用
UPDATE与INSERT替代MERGE
在历史准确性与系统性能之间权衡
如果某个维度数据集庞大到影响系统性能,可能需要在历史准确性和系统性能之间做出权衡。正如上文所述,这通常发生在实施 SCD 类型 2 时。
当记录频繁变化时,表中的行数会迅速膨胀。在这种情况下,继续用 SCD 类型 2 维护维度数据可能就不再合适。
转而使用 SCD 类型 1 或类型 3 也许能以可观的系统性能提升换来类似的功能。代价是历史数据表示得不够完整。在更改 SCD 实施方式之前,请与您的团队一起权衡这一取舍。
编排缓慢变化维度
针对某个维度表执行一次性查询以实现 SCD 并不难。但在生产环境中以编程方式周期性运行此过程来维护维度,则需要更多考虑。Apache Airflow 等工具非常适合用于编排这些流程,并提供监控与告警层以确保性能稳定。通过参数化更新维度表的逻辑,Airflow 可以按计划在您的数据平台中启动流程,从而替代数据从业者的手动操作。
除了 Airflow,Mage、Prefect 或 Dagster 等工具也可用于编排缓慢变化维度的实施。如果无法使用此类工具,自研的编排工具也同样可行。
结语
掌握缓慢变化维度(SCD)是一项非常出色的本领,尤其是在您自行构建数据模型时。
本文介绍了星型模型的基础,以及 SCD 的定义与基本概念。我们探索了 SCD 类型 1、2、3,以在捕捉当前状态快照的同时保留历史数据。
借助 Snowflake,我们使用零售示例实现了上述各类 SCD 技术。随后,我们概述了实施 SCD 可能带来的一些技术挑战及应对方法。
要继续提升您的数据建模技能,请学习 DataCamp 提供的数据库设计、数据工程入门与数据仓库入门课程。祝您一切顺利,编码愉快!
星型模型由 Ralph Kimball 于 1996 年在其著作“The Data Warehouse Toolkit”中提出。Kimball 的新建模技术为减少数据仓库中存储的数据量以及提升查询性能提供了方法。将近三十年后的今天,星型模型已成为数以千计现代数据平台中数据仓库设计的基石。
在星型模型中,数据以“事实”表和“维度”表的形式存储。事实表存储反映事件的数据,例如零售店的一笔交易、酒店的一项客人预订或病人的一次就诊。维度表存储用以丰富事实表数据的信息。下图通过几个示例展示了事实表与维度表的对应关系。
事实
维度
零售店的交易
该店中每件售出商品的详细信息
酒店的客人预订
酒店各房间的楼层、床位数、浴室数
病人就诊
病人信息,如地址和电话号码
事实表会不断变化以反映业务事件,而维度表的修改频率并不那么高。但当维度表确实发生变化时会怎样?如果某个维度多次改变呢?历史数据如何保留?
这就引出了“缓慢变化维度”。
缓慢变化维度(Slowly Changing Dimensions,简称 SCD)是一套在维度发生变化时,用于更新与维护维度表中数据的框架。处理变化维度的方法有多种,这些技术通常被称为 SCD “类型”。我们将深入探讨其中三种方法的定义、典型用例,并提供可自行实现这些技术的代码。
传统上,数据架构师与数据工程师会协同规划、开发并维护利用缓慢变化维度的数据模型。随后,数据科学家和分析师会使用构成星型模型的事实与维度表来训练机器学习流水线、驱动仪表盘,或支持一系列以数据为中心的任务。对于整个数据从业者群体,理解缓慢变化维度的基础知识及其使用方式,有助于缩短洞察时间,同时提升效率与可靠性。