

SCD के विभिन्न प्रकारों को समझना
धीरे-धीरे बदलने वाले आयामों को संभालने के कई तरीके हैं। आइए तीन सबसे आम तरीकों पर नज़र डालते हैं।
SCD टाइप 1
SCD टाइप 1 में, यदि किसी डायमेंशन टेबल में कोई रिकॉर्ड बदलता है, तो मौजूदा रिकॉर्ड को अपडेट या ओवरराइट कर दिया जाता है। अन्यथा, नया रिकॉर्ड डायमेंशन टेबल में इन्सर्ट कर दिया जाता है। इसका मतलब है कि डायमेंशन टेबल के रिकॉर्ड हमेशा वर्तमान स्थिति को दर्शाते हैं और कोई ऐतिहासिक डेटा संरक्षित नहीं रहता।
किराना स्टोर में बेची गई वस्तुओं की जानकारी रखने वाली टेबल बदलते रिकॉर्ड्स को SCD टाइप 1 से संभाल सकती है। यदि वांछित आइटम के लिए टेबल में पहले से कोई रिकॉर्ड मौजूद है, तो उसे नई जानकारी से अपडेट कर दिया जाएगा। अन्यथा, रिकॉर्ड डायमेंशन टेबल में इन्सर्ट हो जाएगा।
डेटा इंजीनियरिंग की दुनिया में, मौजूद होने पर डेटा को अपडेट करना या अन्यथा इन्सर्ट करना “अपसर्टिंग” कहलाता है। नीचे दी गई टेबल में किराना स्टोर में बेची गई वस्तुओं की जानकारी है।
|
item_id |
name |
price |
aisle |
|
93201 |
Potato Chips |
3.99 |
11 |
|
07879 |
Soda |
7.99 |
13 |
यदि Potato Chips को आइल 6 में शिफ्ट किया जाता है, तो डायमेंशन टेबल में इस परिवर्तन को SCD टाइप 1 से कैप्चर करने पर नीचे जैसा परिणाम मिलेगा:
|
item_id |
name |
price |
aisle |
|
93201 |
Potato Chips |
3.99 |
6 |
|
07879 |
Soda |
7.99 |
13 |
SCD टाइप 1 यह सुनिश्चित करता है कि टेबल में डुप्लीकेट रिकॉर्ड न हों और डेटा सबसे ताज़ा वर्तमान डायमेंशन को प्रतिबिंबित करे। यह विशेष रूप से रीयल-टाइम डैशबोर्डिंग और प्रेडिक्टिव मॉडलिंग के लिए उपयोगी है, जहाँ केवल वर्तमान स्थिति महत्वपूर्ण होती है।
हालांकि, क्योंकि टेबल में केवल सबसे हालिया जानकारी ही संग्रहीत होती है, डेटा प्रैक्टिशनर्स समय के साथ डायमेंशन्स में हुए बदलावों की तुलना नहीं कर पाते। उदाहरण के लिए, किसी डेटा एनालिस्ट को Potato Chips को आइल 6 में शिफ्ट करने के बाद राजस्व में हुई बढ़ोतरी का पता लगाने में कठिनाई होगी, यदि कुछ और जानकारी उपलब्ध न हो।
SCD टाइप 1 वर्तमान स्थिति की रिपोर्टिंग और एनालिटिक्स को आसान बनाता है, लेकिन ऐतिहासिक विश्लेषण करते समय सीमाएँ रखता है।
SCD टाइप 2
हालाँकि केवल वर्तमान स्थिति को दर्शाने वाली टेबल उपयोगी हो सकती है, कई बार किसी डायमेंशन में हुए ऐतिहासिक बदलावों को ट्रैक करना सुविधाजनक ही नहीं, बल्कि आवश्यक भी होता है। SCD टाइप 2 में, जब कोई डायमेंशन बदलता है तो एक नया रो जोड़ा जाता है और इस नए रो को वर्तमान के रूप में ठीक से दर्शाया जाता है, जबकि पूर्व रिकॉर्ड को ऐतिहासिक के रूप में चिह्नित किया जाता है।
कहना आसान है, पर व्यवहार में यह कैसा दिखता है, यह तुरंत स्पष्ट न हो। आइए एक उदाहरण देखते हैं।
यहाँ, हमारे पास पहले वाले उदाहरण जैसी ही एक टेबल है जिसका उपयोग हमने SCD टाइप 1 समझते समय किया था। हालाँकि, इसमें एक अतिरिक्त कॉलम जोड़ा गया है। is_current एक बूलियन मान रखता है; यदि रिकॉर्ड सबसे वर्तमान मान को दर्शाता है तो true, अन्यथा false।
|
item_id |
name |
price |
aisle |
is_current |
|
93201 |
Potato Chips |
3.99 |
11 |
True |
|
07879 |
Soda |
7.99 |
13 |
True |
यदि Potato Chips को आइल 6 में शिफ्ट किया जाता है, तो इस बदलाव को दस्तावेज़ करने के लिए SCD टाइप 2 का उपयोग करने पर टेबल कुछ इस तरह दिखेगी:
|
item_id |
name |
price |
aisle |
is_current |
|
93201 |
Potato Chips |
3.99 |
11 |
False |
|
07879 |
Soda |
7.99 |
13 |
True |
|
93201 |
Potato Chips |
3.99 |
6 |
True |
Potato Chips के लोकेशन बदलाव को दर्शाने के लिए एक नया रो जोड़ा जाता है, जिसमें is_current कॉलम में True रखा जाता है। ऐतिहासिक डेटा बनाए रखने और वर्तमान स्थिति को सटीक रूप से दर्शाने के लिए, पिछले रिकॉर्ड के is_current कॉलम को False सेट किया जाता है। SCD टाइप 1 के साथ,
लेकिन यदि आप यह जानना चाहें कि लोकेशन बदलने पर Potato Chips की बिक्री ने कैसी प्रतिक्रिया दी? यदि किसी एक आइटम के लिए कई ऐतिहासिक रिकॉर्ड हों तो केवल एक कॉलम का उपयोग करते हुए यह काफी कठिन है। सौभाग्य से, इसका एक आसान तरीका है।
नीचे दी गई टेबल देखें। इस डायमेंशन टेबल में पहले जैसी ही जानकारी है, लेकिन is_current कॉलम के बजाय इसमें start_date और end_date दोनों कॉलम हैं। ये तारीखें उस अवधि का प्रतिनिधित्व करती हैं जब कोई डायमेंशन सबसे वर्तमान था। चूँकि इस टेबल का डेटा सबसे ताज़ा है, इसलिए end_date को भविष्य में बहुत आगे की तारीख पर सेट किया गया है।
|
item_id |
name |
price |
aisle |
start_date |
end_date |
|
93201 |
Potato Chips |
3.99 |
11 |
2023-11-13 |
2099-12-31 |
|
07879 |
Soda |
7.99 |
13 |
2023-08-24 |
2099-12-31 |
यदि Potato Chips को 4 जनवरी, 2024 को आइल 6 में ले जाया गया, तो अपडेटेड टेबल इस तरह दिखेगी:
|
item_id |
name |
price |
aisle |
start_date |
end_date |
|
93201 |
Potato Chips |
3.99 |
6 |
2024-01-04 |
2099-12-31 |
|
07879 |
Soda |
7.99 |
13 |
2023-08-24 |
2099-12-31 |
|
93201 |
Potato Chips |
3.99 |
11 |
2023-11-13 |
2024-01-03 |
ध्यान दें कि पहली पंक्ति के लिए end_date को उस अंतिम दिन पर अपडेट किया गया है जब Potato Chips आइल 11 में उपलब्ध थे। एक नया रिकॉर्ड जोड़ा गया है, जिसमें अब Potato Chips आइल 6 में शेल्व्ड हैं। start_date और end_date यह दिखाने में मदद करते हैं कि बदलाव कब हुआ और कौन सा रिकॉर्ड वर्तमान है।
इस तकनीक का उपयोग करके SCD टाइप 1 को लागू करना न केवल ऐतिहासिक डेटा को संरक्षित करता है, बल्कि यह भी जानकारी देता है कि डेटा कब बदला। यह डेटा एनालिस्ट्स और डेटा साइंटिस्ट्स को ऑपरेशनल बदलावों की पड़ताल करने, A/B टेस्टिंग करने, और सूचित निर्णय लेने में सक्षम बनाता है।
SCD टाइप 3
जब ऐसे डेटा के साथ काम किया जा रहा हो जिसके केवल एक बार बदलने की उम्मीद हो, या जहाँ केवल सबसे हालिया ऐतिहासिक रिकॉर्ड ही दिलचस्पी का हो, SCD टाइप 3 काफ़ी उपयोगी है। बदले हुए डायमेंशन को “अपसर्ट” करने या बदलाव को नए रो के रूप में संग्रहीत करने के बजाय, SCD टाइप 3 बदलाव को दर्शाने के लिए एक कॉलम का उपयोग करता है। इसे समझाना थोड़ा मुश्किल है, तो सीधे एक उदाहरण पर चलते हैं।
नीचे दी गई टेबल में संयुक्त राज्य भर की टीमों के लिए खेलों की जानकारी है। यहाँ, टेबल में वर्तमान और ऐतिहासिक स्टेडियम नाम संग्रहीत करने के लिए दो कॉलम हैं। चूँकि इनमें से प्रत्येक टीम मूल स्टेडियम नाम का उपयोग कर रही है, इसलिए previous_stadium_name कॉलम NULL से भरा है।
|
team_id |
team_name |
sport |
current_stadium_name |
previous_stadium_name |
|
562819 |
Lafayette Hawks |
Football |
Triple X Stadium |
NULL |
|
930193 |
Fort Niagara Squirrels |
Soccer |
Musket Stadium |
NULL |
यदि Lafayette Hawks पच्चीस साल के सौदे के लिए नया स्पॉन्सर लेते हैं, तो अपडेटेड टेबल कुछ इस तरह दिखेगी:
|
team_id |
team_name |
sport |
current_stadium_name |
previous_stadium_name |
|
562819 |
Lafayette Hawks |
Football |
Wabash Field |
Triple X Stadium |
|
930193 |
Fort Niagara Squirrels |
Soccer |
Musket Stadium |
NULL |
नए स्टेडियम नाम को दर्ज करने के लिए, “Triple X Stadium'' को previous_stadium_name column में शिफ्ट कर दिया जाता है, और “Wabash Field'' उसकी जगह current_stadium_name कॉलम में ले लेता है। नया प्रायोजन सौदा, जो पच्चीस वर्षों का है, सबसे अधिक संभावना है कि बनाए जा रहे मॉडल से लंबा चलेगा, यानी रिकॉर्ड के दोबारा बदलने की संभावना कम है।
SCD टाइप 3 का उपयोग करने से वर्तमान स्थिति के डेटा की तुलना ऐतिहासिक डेटा से करना बहुत सरल हो जाता है। प्रत्येक टीम के लिए केवल एक ही पंक्ति होती है, और वर्तमान तथा ऐतिहासिक डेटा दो अलग-अलग कॉलम में साथ-साथ बैठते हैं। हालाँकि, इसका मतलब यह भी है कि किसी एक डायमेंशनल एट्रीब्यूट का केवल एक ही ऐतिहासिक रिकॉर्ड संरक्षित रखा जा सकता है, जो सीमित कर सकता है, खासकर यदि डेटा अपेक्षा से अधिक बार बदलता है।
टाइप 1, 2 और 3 के अलावा, slowly changing dimensions को लागू करने के और भी कई तरीके हैं। टाइप 0 तब उपयोग होता है जब डायमेंशन्स कभी नहीं बदलने चाहिए। टाइप 4 सबसे ताज़ा डेटा को डायमेंशन टेबल में रखते हुए ऐतिहासिक डेटा को एक अलग टेबल में संग्रहीत करता है। टाइप 6, टाइप 1, 2 और 3 का मिश्रण है और आम तौर पर इन तकनीकों की बेहतरीन खूबियों को मिलाकर लागू किया जाता है।
Slowly-Chinging Dimensions: चरण-दर-चरण कार्यान्वयन मार्गदर्शिका
डेटा वेयरहाउस में डायमेंशन डेटा
हमने slowly changing dimensions की बुनियादी बातें कवर कर ली हैं। इन प्रत्येक तकनीकों को कैसे लागू किया जाए, इसे बेहतर समझने के लिए एक उदाहरण देखते हैं।
इस उदाहरण में, हम रिटेल ट्रांज़ैक्शन्स के लिए Snowflake का उपयोग करके SCD टाइप 1, 2, और 3 को लागू करेंगे। यदि आपको Snowflake पर रीफ्रेशर चाहिए, तो हमारा Introduction to Snowflake कोर्स देखें।
एक फैक्ट टेबल है, जिसका नाम sales है, और तीन डायमेंशन टेबल्स हैं, जिनके नाम employees, items, और discounts हैं। नीचे इस स्टार-स्कीमा का ERD दिया गया है।
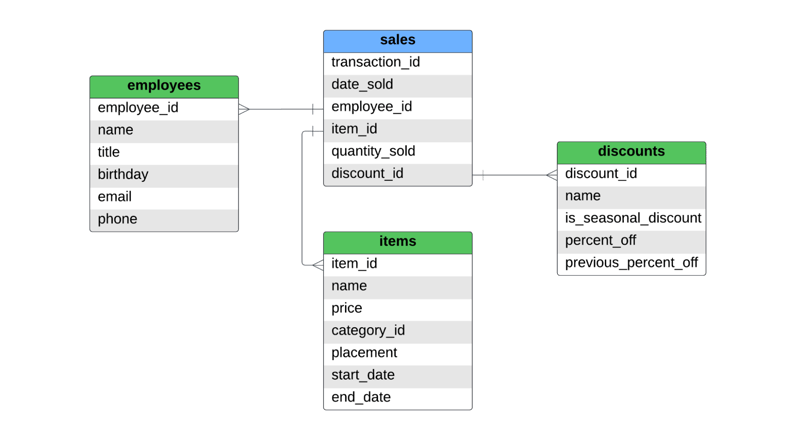
sales टेबल आइटम-स्तरीय बिक्री को कैप्चर करती है। यदि किसी ग्राहक ने दो शर्ट और एक जोड़ी जींस खरीदी, तो फैक्ट टेबल में दो रिकॉर्ड होंगे, क्योंकि दो अलग-अलग आइटम बेचे गए। SCD टाइप 1, टाइप 2 और टाइप 3 के लिए, हम निम्नलिखित कवर करेंगे:
- डायमेंशन के बदलने के सामान्य तरीके
- डायमेंशन बदलने पर टेबल को अपडेट करना
- Snowflake के साथ प्रत्येक SCD तकनीक को लागू करना
हम यह नहीं देखेंगे कि इन टेबल्स को मूल रूप से कैसे भरा गया था, लेकिन आमतौर पर, डेटा वेयरहाउस के अपस्ट्रीम में कोई ETL या ELT पाइपलाइन सोर्स से रॉ डेटा खींचती है, उसे वांछित मॉडल में ट्रांसफॉर्म करती है, और उसकी अंतिम मंज़िल पर लोड करती है।
SCD टाइप 1 लागू करना
SCD टाइप 1 लागू करने का अभ्यास करने के लिए, हम employee टेबल पर नज़र डालेंगे। इस टेबल में किसी कर्मचारी के बारे में बुनियादी जानकारी होती है, जिसमें उसका नाम, पद और संपर्क जानकारी शामिल है। इसमें नीचे जैसे रिकॉर्ड हो सकते हैं।
|
employee_id |
name |
title |
birthday |
|
phone |
|
477379 |
Emily Verplank |
Manager |
1989-07-28 |
928-144-8201 | |
|
392005 |
Josh Murray |
Cashier |
2002-12-11 |
717-304-5547 |
इस slowly changing dimension को कैप्चर करने के लिए SCD टाइप 1 का उपयोग करते हुए, मौजूदा रिकॉर्ड को सबसे हालिया रिकॉर्ड द्वारा ओवरराइट कर दिया जाएगा। यदि इन डायमेंशनल एट्रीब्यूट्स में से कोई बदलता है, तो नए रिकॉर्ड को मौजूदा टेबल में “अपसर्ट” किया जाना चाहिए। उदाहरण के लिए, यदि Emily का फ़ोन नंबर 928-652-9704 हो जाता है, तो नई टेबल इस तरह दिखेगी:
|
employee_id |
name |
title |
birthday |
|
phone |
|
477379 |
Emily Verplank |
Manager |
1989-07-28 |
928-652-9704 | |
|
392005 |
Josh Murray |
Cashier |
2002-12-11 |
717-304-5547 |
Snowflake के साथ यह करने के लिए, हम MERGE INTO कमांड का उपयोग करेंगे। MERGE INTO डेटा प्रैक्टिशनर को एक मैच की और एक शर्त देने की अनुमति देता है। यदि मैच की और शर्त पूरी होती है, तो रिकॉर्ड को UPDATE कीवर्ड से अपडेट किया जा सकता है। अन्यथा, रिकॉर्ड को INSERT किया जा सकता है, या निष्पादन रोका जा सकता है।
MERGE INTO कमांड शुरू करने से पहले, हम पहले stage_employees नामक एक टेबल बनाएँगे और उसमें रिकॉर्ड जोड़ेंगे। इसमें वे सभी रिकॉर्ड होंगे जो employees टेबल के अंतिम रिफ्रेश के बाद अपडेट हुए हैं। हम नीचे दिए गए स्टेटमेंट्स से यह कर सकते हैं।
CREATE OR REPLACE TABLE stage_employees (
employee_id INT,
name VARCHAR,
title VARCHAR,
birthday DATE,
email VARCHAR,
phone VARCHAR
);
INSERT INTO stage_employees (
employee_id,
name,
title,
birthday,
email,
phone
) VALUES (
477379,
'Emily Verplank',
'Manager',
'1989-07-28',
'[email protected]',
'928-652-9704'
);
अब, हम Snowflake की MERGE कार्यक्षमता का उपयोग करके मौजूदा रिकॉर्ड को “अपसर्ट” कर सकते हैं।
MERGE INTO employees USING stage_employees
ON employees.employee_id = stage_employees.employee_id
WHEN MATCHED THEN UPDATE SET
employees.name = stage_employees.name,
employees.title = stage_employees.title,
employees.email = stage_employees.email,
employees.phone = stage_employees.phone
WHEN NOT MATCHED THEN INSERT (
employee_id,
name,
title,
birthday,
email,
phone
) VALUES (
stage_employees.employee_id,
stage_employees.name,
stage_employees.title,
stage_employees.birthday,
stage_employees.email,
stage_employees.phone
);
ऊपर, employees और stage_employees टेबल के बीच डेटा मर्ज करने की कुंजी employee_id फ़ील्ड थी। कोई अन्य शर्त सेट नहीं की गई थी, यानी यदि employee_id मेल खाते, तो name, title, email, और phone डायमेंशनल एट्रीब्यूट्स को उस employee ID के लिए stage_employees टेबल के मानों से अपडेट किया गया। यदि stage_employees के रिकॉर्ड employees टेबल के किसी रिकॉर्ड से मेल नहीं खाते, तो वह रिकॉर्ड employees टेबल में इन्सर्ट हो जाता।
SCD टाइप 2 लागू करना
SCD टाइप 2 को लागू करना SCD टाइप 1 से थोड़ा मुश्किल है। हालाँकि यह मौजूदा रिकॉर्ड को ओवरराइट करना या अन्यथा एक इन्सर्ट करना जितना सरल नहीं है, फिर भी हम Snowflake की MERGE INTO लॉजिक का उपयोग करके समस्या ले सकते हैं। नीचे दिए गए डायमेंशन पर नज़र डालें।
|
item_id |
name |
price |
category_id |
placement |
start_date |
end_date |
|
667812 |
Socks |
8.99 |
156 |
Aisle 11 |
2023-08-24 |
NULL |
|
747295 |
Sports Jersey |
59.99 |
743 |
Aisle 8 |
2023-02-17 |
NULL |
यह टेबल किसी रिटेल स्टोर में बेची गई विशिष्ट वस्तुओं की जानकारी रखती है। डायमेंशनल एट्रीब्यूट्स में आइटम का नाम, कीमत और प्लेसमेंट, साथ ही उस कैटेगरी के लिए एक फ़ॉरेन की शामिल है जिससे आइटम संबंधित है। SCD टाइप 2 लागू करने के लिए, हमें डेटा को “अपसर्ट” करना होगा, इस बार ऐतिहासिक और वर्तमान दोनों डेटा बनाए रखने के लिए start_date और end_date का उपयोग करते हुए।
मान लीजिए NFL (National Football League) सीज़न की शुरुआत में, स्पोर्ट्स जर्सीज़ को स्टोर के सामने ग्राहकों की बेहतर दृश्यता के लिए ले जाया जाता है। नई लोकेशन के साथ, इस आइटम की कीमत भी घटा दी जाती है। इस ऑपरेशनल व्यवहार को दर्शाने और ऐतिहासिक डेटा बनाए रखने के लिए, मौजूदा रिकॉर्ड को एक end date के साथ अपडेट किया जाता है, और एक नया रिकॉर्ड इन्सर्ट किया जाता है। देखें!
|
item_id |
name |
price |
category_id |
placement |
start_date |
end_date |
|
667812 |
Socks |
8.99 |
156 |
Aisle 11 |
2023-08-24 |
NULL |
|
747295 |
Sports Jersey |
59.99 |
743 |
Aisle 8 |
2023-02-17 |
2023-11-13 |
|
747295 |
Sports Jersey |
49.99 |
743 |
Entry Display |
2023-11-13 |
NULL |
पहले की तरह, हम पहले stage_items नामक एक टेबल बनाएँगे। यह टेबल उन रिकॉर्ड्स को संग्रहीत करेगी जिनका उपयोग संबंधित items डायमेंशन में SCD टाइप 2 लागू करने के लिए किया जाएगा, जो ऊपर दिखाए गए रूप में है। stage_items टेबल बनने के बाद, हम एक रिकॉर्ड इन्सर्ट करेंगे जिसमें स्पोर्ट्स जर्सीज़ के प्लेसमेंट और कीमत, दोनों का बदलाव शामिल होगा।
CREATE OR REPLACE TABLE stage_items (
item_id INT,
name VARCHAR,
price FLOAT,
category_id INT,
placement VARCHAR,
start_date DATE,
end_date DATE
);
INSERT INTO stage_items (
item_id,
name,
price,
category_id,
placement,
start_date,
end_date
) VALUES (
747295,
'Sports Jersey',
49.99,
743,
'Entry Display',
'2023-11-13',
NULL
);
अब, SCD टाइप 2 लागू करने के लिए Snowflake की MERGE INTO कार्यक्षमता का उपयोग करने का समय है। यह पिछले उदाहरण से थोड़ा अधिक पेचीदा है, और थोड़ी सोच की ज़रूरत है। चूँकि केवल तब ही रिकॉर्ड इन्सर्ट किया जा सकता है जब मैच कंडीशन पूरी न हो, हमें यह दो चरणों में करना होगा। पहले हम निम्न तीन स्टेटमेंट्स के साथ एक मैच कंडीशन बनाएँगे:
itemsऔरstage_itemsटेबल मेंitem_idमेल खाने चाहिएstage_itemsटेबल मेंstart_date,itemsटेबल केstart_dateसे बड़ा होना चाहिएitemsटेबल मेंend_dateNULLहोना चाहिए
यदि ये तीनों शर्तें पूरी होती हैं, तो items टेबल में मूल रिकॉर्ड को अपडेट किया जाना चाहिए। ध्यान दें कि items.end_date कॉलम अब NULL नहीं रहेगा; यह stage_items टेबल के start_date का मान ले लेगा। इस पहले स्टेटमेंट में अनमैच होने पर कोई लॉजिक नहीं है।
इसके बाद, हम नए रिकॉर्ड को इन्सर्ट करने के लिए अलग से MERGE INTO कॉल का उपयोग करेंगे। यह थोड़ा और कठिन है। नए रिकॉर्ड के इन्सर्ट होने के लिए, मैच कंडीशन पूरी नहीं होनी चाहिए।
इस उदाहरण में, हम यह जाँचकर कर सकते हैं कि दोनों टेबल्स में items_id मेल खाते हैं और items टेबल में end_date NULL है। इसे थोड़ा और तोड़ते हैं।
- यदि
items_idमेल खाते हैं, औरitems.end_dateNULLहै, तोitemsटेबल में पहले से ही सबसे वर्तमान रिकॉर्ड मौजूद है। इसका मतलब नया रिकॉर्ड इन्सर्ट नहीं होना चाहिए। - यदि दोनों टेबल्स में
item_idके बीच कोई मैच नहीं है, तो मैच कंडीशन पूरी नहीं होगी, और नया रो इन्सर्ट हो जाएगा। यहitemsटेबल में उसitem_idका पहला रिकॉर्ड होगा। - यदि
stage_itemsटेबल मेंitem_id,itemsटेबल में उसीitem_idके रिकॉर्ड्स से मैच करता है, औरend_dateNULLनहीं है, तो नया मान इन्सर्ट किया जाएगा। यह ऐतिहासिक डेटा बनाए रखता है और सुनिश्चित करता है किitemsटेबल में वर्तमान रिकॉर्ड मौजूद है।
नीचे इम्प्लीमेंटेशन दिया गया है, जिसमें पहले मौजूदा रिकॉर्ड को अपडेट करने और फिर सबसे वर्तमान डेटा इन्सर्ट करने के लिए दो MERGE INTO स्टेटमेंट्स का उपयोग किया गया है।
MERGE INTO items USING stage_items
ON items.item_id = stage_items.item_id
AND items.start_date < stage_items.start_date
AND items.end_date IS NULL
WHEN MATCHED
THEN UPDATE SET
-- Update the existing record
items.name = stage_items.name,
items.price = stage_items.price,
items.category_id = stage_items.category_id,
items.placement = stage_items.placement,
items.start_date = items.start_date,
items.end_date = stage_items.start_date
;
MERGE INTO items USING stage_items
ON items.item_id = stage_items.item_id
AND items.end_date IS NULL
WHEN NOT MATCHED THEN INSERT (
item_id,
name,
price,
category_id,
placement,
start_date,
end_date
) VALUES (
stage_items.item_id,
stage_items.name,
stage_items.price,
stage_items.category_id,
stage_items.placement,
stage_items.start_date,
NULL
);
SCD टाइप 3 लागू करना
अंत में, हम एक नए डायमेंशन के साथ SCD टाइप 3 लागू करने पर नज़र डालेंगे। हमारे उदाहरण में, discounts टेबल चेकआउट पर ग्राहकों द्वारा रिडीम किए जा सकने वाले कुछ डिस्काउंट्स की जानकारी रखती है। टेबल में डिस्काउंट का ID, नाम, प्रतिशत छूट, और सीज़नल डिस्काउंट के रूप में वर्गीकरण शामिल है। यहाँ discounts टेबल में मौजूद हो सकने वाले दो रिकॉर्ड्स के उदाहरण हैं।
|
discount_id |
name |
is_seasonal |
percent_off |
previous_percent_off |
|
994863 |
Rewards Member |
False |
10 |
NULL |
|
467782 |
Employee Discount |
False |
50 |
NULL |
क्योंकि रिटेलर को उम्मीद नहीं है कि डिस्काउंट्स अक्सर बदलेंगे, यह डायमेंशन slowly changing dimensions के लिए टाइप 3 दृष्टिकोण लागू करने का एक बेहतरीन उम्मीदवार है। यदि डिस्काउंट के जरिए दी जाने वाली प्रतिशत छूट बदलती है, तो पिछली प्रतिशत छूट previous_percent_off कॉलम में चली जाएगी, जबकि नया मान percent_off कॉलम में अपनी जगह ले लेगा।
यह percent_off कॉलम में सबसे हालिया मान को उजागर करते हुए ऐतिहासिक डेटा बनाए रखने की अनुमति देता है।
|
discount_id |
name |
is_seasonal |
percent_off |
previous_percent_off |
|
994863 |
Rewards Member |
False |
10 |
NULL |
|
467782 |
Employee Discount |
False |
35 |
50 |
Snowflake के साथ इसे लागू करने के लिए, हम एक stage_discounts टेबल बनाएँगे, और एक सिंगल रिकॉर्ड इन्सर्ट करेंगे। यह रिकॉर्ड नया percent_off शामिल करेगा।
CREATE TABLE stage_discounts (
discount_id INTEGER,
name VARCHAR,
is_seasonal BOOLEAN,
percent_off INTEGER
);
INSERT INTO stage_discounts (
discount_id,
name,
is_seasonal,
percent_off
) VALUES (
467782,
'Rewards Member',
FALSE,
35
);
फिर से, हम SCD टाइप 3 लागू करने के लिए MERGE INTO का उपयोग करेंगे। मैच कंडीशन सरल है; यदि discounts और stage_discounts टेबल में discount_id मेल खाते हैं, और percent_off मान अलग हैं, तो discounts टेबल में मौजूदा रिकॉर्ड अपडेट हो जाएगा। मौजूदा percent_off मान को previous_percent_off फ़ील्ड में शिफ्ट किया जाएगा, और फिर यदि दोनों टेबल्स में discount_id मेल नहीं खाते, तो NULL मान के साथ नया रिकॉर्ड इन्सर्ट किया जाएगा। ध्यान दें कि ये रिकॉर्ड समय-आधारित नहीं हैं, और percent_off का केवल एक ही ऐतिहासिक मान संरक्षित रखा जा सकता है।
MERGE INTO discounts USING stage_discounts
ON discounts.discount_id = stage_discounts.discount_id
WHEN MATCHED
AND discounts.percent_off <> stage_discounts.percent_off
THEN UPDATE SET
discounts.previous_percent_off = discounts.percent_off,
discounts.percent_off = stage_discounts.percent_off
WHEN NOT MATCHED
THEN INSERT (
discount_id,
name,
is_seasonal,
percent_off,
previous_percent_off
) VALUES (
stage_discounts.discount_id,
stage_discounts.name,
stage_discounts.is_seasonal,
stage_discounts.percent_off,
NULL
);
याद रखें, SCD टाइप 3 उन डेटा के साथ लागू करना सबसे अच्छा है जो शायद ही कभी बदलते हैं, और जहाँ केवल सबसे हालिया ऐतिहासिक प्रविष्टि बनाए रखनी है। यदि डायमेंशन में कई बदलाव अपेक्षित हों, तो SCD टाइप 2 का उपयोग करना संभवतः बेहतर है।
SCD लागू करते समय आम चुनौतियाँ
डुप्लीकेट डेटा
धीरे-धीरे बदलने वाले आयामों के लिए कोई भी तकनीक लागू करते समय, डुप्लीकेट डेटा की संभावना को ध्यान में रखना महत्वपूर्ण है। देखने के लिए डुप्लीकेट्स के दो प्रकार हैं: इंट्रा-बैच और इंटर-बैच डुप्लीकेट्स। आइए इसे समझते हैं।
इंट्रा-बैच डुप्लीकेट्स
इंट्रा-बैच डुप्लीकेट्स अलग-अलग डेटा बैचों के बीच मौजूद डुप्लीकेट्स होते हैं। यदि कोई मौजूदा डायमेंशन टेबल है, तो उसे अपडेट करने के लिए बने दो फ़ाइलों में डुप्लीकेट रिकॉर्ड्स हो सकते हैं।
इसे संभालने के लिए, उस लॉजिक में constraints जोड़ना महत्वपूर्ण है जो डायमेंशन टेबल में डेटा “अपसर्ट” और/या लोड कर रहा है। ऊपर दिए गए उदाहरणों में, हमने डुप्लीकेट्स से बचने के लिए जगह-जगह लॉजिक जोड़ा। इसमें शामिल था:
- SCD टाइप 1 का उपयोग करते समय केवल तभी डेटा इन्सर्ट करना जब मेल खाते
employee_idवाला कोई रिकॉर्ड मौजूद न हो - हमारे SCD टाइप 2 इम्प्लीमेंटेशन में अतिरिक्त शर्तें जोड़ना ताकि यदि टेबल में पहले से वर्तमान रिकॉर्ड मौजूद हो तो डेटा फिर से इन्सर्ट न किया जाए
- मौजूदा रिकॉर्ड को अपडेट करने से पहले items और
stage_itemsटेबल मेंpercent_offमानों के भिन्न होने की जाँच करना
इंटर-बैच डुप्लीकेट्स
इंटर-बैच डुप्लीकेट्स एक ही डेटा बैच में होने वाले डुप्लीकेट्स होते हैं। उदाहरण के लिए, यदि किसी फ़ाइल में डायमेंशन टेबल के किसी एकल रिकॉर्ड को अपडेट करने के लिए दो प्रविष्टियाँ हैं, तो सावधानियाँ बरतनी होंगी। इंट्रा-बैच डुप्लीकेट्स की तरह ही, SCD टाइप 1, 2, या 3 लागू करने के लिए उपयोग किए गए लॉजिक में constraints जोड़ना महत्वपूर्ण है।
यदि एक ही फ़ाइल में परस्पर-विरोधी रिकॉर्ड्स हैं, तो इन रिकॉर्ड्स में किसी तरह अंतर करना होगा। यह रिकॉर्ड के बारे में मेटाडेटा हो सकता है या सोर्स द्वारा प्रदान किया गया टाइमस्टैम्प। डुप्लीकेट्स को संभालने के लिए आप जो भी तरीका चुनें, अपनी धारणाओं का दस्तावेज़ बनाना और अपनी टीम के साथ उनकी समीक्षा करना महत्वपूर्ण है ताकि परिणामी डायमेंशन्स ऑपरेशनल मानों को सटीक रूप से कैप्चर करें।
डेटा इंटीग्रिटी सुनिश्चित करना
कभी-कभी, डेटा तब बदल जाता है जब उसे नहीं बदलना चाहिए। अब तक जिन तीन SCD तकनीकों पर हमने चर्चा की है, उनके साथ यह डेटा के ओवरराइट होने, नया रो जोड़ने, या किसी नए कॉलम में डेटा भरे जाने का कारण बन सकता है।
हमने इस बारे में तरीके बताए हैं कि डुप्लीकेट डेटा डायमेंशन टेबल्स में न पहुँचे। डुप्लीकेट डेटा के अलावा, slowly changing dimensions को संभालने की तकनीकें लागू करने वाले डेटा प्रैक्टिशनर्स को निम्न बातों पर नज़र रखनी चाहिए:
- बदलावों का गलती से उलट जाना
- डायमेंशन्स में अत्यधिक बारंबार या बड़े बदलाव
- ख़राब स्वरूपित रिकॉर्ड्स
हालाँकि ऊपर दिए गए सभी मामलों को सीधे उन कोड में नहीं पकड़ा जा सकता जो डायमेंशन टेबल्स को मेंटेन करते हैं, लेकिन मज़बूत डेटा क्वालिटी नियम और डायमेंशन्स की मॉनिटरिंग प्रक्रियाएँ डेटा इंटीग्रिटी सुनिश्चित करने में मदद कर सकती हैं।
SCD उन्नत विषय
बड़े डेटासेट्स के लिए SCD इम्प्लीमेंटेशन का अनुकूलन
ऊपर दिए गए रिटेल उदाहरण में, जिन डेटासेट्स पर हमने काम किया, वे कुछ ही पंक्तियों के बने थे। प्रोडक्शन सेटिंग में, ये डायमेंशन टेबल्स सैकड़ों या हज़ारों रिकॉर्ड्स भी रख सकती हैं। यह SCD टाइप 2 लागू करते समय काफ़ी सामान्य है, विशेषकर अगर डायमेंशन्स बार-बार बदलते हों।
जैसे-जैसे डायमेंशन टेबल में पंक्तियों की संख्या बढ़ती है, डेटा प्रैक्टिशनर के लिए अपने डिज़ाइन और इम्प्लीमेंटेशन प्लान्स में परफ़ॉर्मेंस को प्राथमिकता पर रखना ज़रूरी है। Snowflake का उपयोग करते हुए बड़े डेटासेट्स के लिए SCD इम्प्लीमेंटेशन को अनुकूलित करने के कुछ तरीके यहाँ हैं:
- टार्गेट टेबल्स पर प्राइमरी की जैसे constraints का उपयोग करें ताकि
- माइक्रो-पार्टिशन्स और डेटा क्लस्टरिंग का लाभ उठाएँ ताकि
MERGEस्टेटमेंट(s) द्वारा प्रोसेस किए जाने वाले डेटा को कम किया जा सके - Query Plan और Query Profile से क्वेरी बॉटलनेक्स की पहचान करें और उन्हें दूर करें
- जहाँ उपयुक्त हो,
MERGEके बजायUPDATEऔरINSERTस्टेटमेंट्स का उपयोग करने पर विचार करें
ऐतिहासिक सटीकता और सिस्टम प्रदर्शन के बीच संतुलन
यदि कोई डायमेंशन डेटासेट इतना बड़ा हो जाता है कि सिस्टम परफ़ॉर्मेंस प्रभावित होती है, तो ऐतिहासिक सटीकता और सिस्टम परफ़ॉर्मेंस के बीच समझौता करने पर निर्णय लेना पड़ सकता है। जैसा कि ऊपर उल्लेख किया गया है, यह आम तौर पर SCD टाइप 2 लागू करते समय होता है।
यदि रिकॉर्ड्स अक्सर बदलते हैं, तो टेबल में पंक्तियों की संख्या तेजी से बढ़ सकती है। ऐसे में, डायमेंशनल डेटा मेंटेन करने के लिए SCD टाइप 2 का उपयोग करना अब विवेकपूर्ण नहीं रह सकता।
SCD टाइप 1 या टाइप 3 का उपयोग करने पर स्विच करना समान कार्यक्षमता प्रदान कर सकता है, साथ ही सिस्टम परफ़ॉर्मेंस में महत्वपूर्ण बढ़त दे सकता है। समझौता यह है कि ऐतिहासिक डेटा का प्रतिनिधित्व अधूरा होगा। SCD लागू करने के दृष्टिकोण को बदलने से पहले अपनी टीम के साथ इस समझौते का मूल्यांकन करें।
धीरे-धीरे बदलने वाले आयामों का ऑर्केस्ट्रेशन
किसी डायमेंशन टेबल के लिए SCD लागू करने हेतु एक बार की क्वेरी चलाना आसान है। हालाँकि, प्रोडक्शन वातावरण में इस डायमेंशन को मेंटेन करने के लिए इस प्रक्रिया को प्रोग्रामेटिक रूप से चलाना थोड़ा सोच-विचार माँगता है। Apache Airflow जैसे टूल्स इन प्रक्रियाओं को ऑर्केस्ट्रेट करने के लिए बेहतरीन हैं और नाममात्र प्रदर्शन सुनिश्चित करने हेतु मॉनिटरिंग और अलर्टिंग की एक परत प्रदान करते हैं। डायमेंशन टेबल्स को अपडेट करने के लिए प्रयुक्त लॉजिक को पैरामीटराइज़ करके, Airflow को आपके डेटा प्लेटफ़ॉर्म में अनुसूचित अवधि के लिए प्रक्रियाएँ शुरू करने में उपयोग किया जा सकता है, जिससे डेटा प्रैक्टिशनर के मैनुअल प्रयासों की जगह ली जा सके।
Airflow के अलावा, Mage, Prefect, या Dagster जैसे टूल्स का उपयोग धीरे-धीरे बदलने वाले आयामों के इम्प्लीमेंटेशन को ऑर्केस्ट्रेट करने के लिए किया जा सकता है। यदि ऐसे टूल आसानी से उपलब्ध नहीं हैं, तो इन-हाउस बने ऑर्केस्ट्रेशन टूल्स भी काम आ सकते हैं।
निष्कर्ष
Slowly changing dimensions (SCD) में महारत हासिल करना आपके टूल बेल्ट में रखने के लिए बेहतरीन कौशल है, खासकर जब आप अपना डेटा मॉडल बना रहे हों।
इस लेख में, हमने स्टार स्कीमा की बुनियादी बातें, साथ ही SCD की परिभाषाएँ और मूल बातें कवर कीं। हमने ऐतिहासिक डेटा को बनाए रखते हुए वर्तमान स्थिति की झलक कैप्चर करने के लिए SCD टाइप 1, 2 और 3 की पड़ताल की।
Snowflake की मदद से, हमने रिटेल उदाहरण के सहारे ऊपर परिभाषित प्रत्येक SCD तकनीक को लागू किया। इसके बाद, हमने SCD लागू करने से जुड़ी कुछ अधिक तकनीकी चुनौतियों और उनसे निपटने के तरीकों का खाका प्रस्तुत किया।
अपने डेटा मॉडलिंग कौशल को लगातार बढ़ाने के लिए, DataCamp पर उपलब्ध Database Design, Introduction to Data Engineering, और Introduction to Data Warehousing कोर्सेज करें। शुभकामनाएँ, और हैप्पी कोडिंग!
स्टार स्कीमा को 1996 में राल्फ किम्बल ने अपनी किताब “The Data Warehouse Toolkit” में पेश किया था। किम्बल की नई मॉडलिंग तकनीक ने डेटा वेयरहाउस में संग्रहीत डेटा की मात्रा को घटाने और क्वेरी प्रदर्शन में सुधार करने का तरीका दिखाया। लगभग तीस साल आगे बढ़ें, और स्टार स्कीमा आज हजारों आधुनिक डेटा प्लेटफ़ॉर्म्स के डेटा वेयरहाउस डिज़ाइन का अहम हिस्सा है।
स्टार स्कीमा में, डेटा “फैक्ट” टेबल और “डायमेंशन” टेबल के रूप में संग्रहीत होता है। फैक्ट टेबल्स वे डेटा रखती हैं जो घटनाओं को कैप्चर करती हैं, जैसे किसी रिटेल स्टोर में लेन-देन, होटल में किसी अतिथि की आरक्षण प्रविष्टि, या किसी मरीज का डॉक्टर के पास जाना। डायमेंशन टेबल्स वह जानकारी रखती हैं जो फैक्ट टेबल्स के डेटा को समृद्ध बनाती है। नीचे दिए गए ग्राफिक में कुछ उदाहरणों के साथ एक फैक्ट टेबल को एक डायमेंशन टेबल से मिलाया गया है।
फैक्ट
डायमेंशन
रिटेल स्टोर में लेन-देन
उस स्टोर में बेची गई हर वस्तु की विस्तृत जानकारी
होटल में अतिथि आरक्षण
होटल के सभी कमरों के लिए फ़्लोर, बिस्तरों की संख्या, बाथरूम
मरीज का डॉक्टर के पास जाना
मरीज की जानकारी, जैसे पता और फ़ोन नंबर
जहाँ फैक्ट टेबल्स लगातार व्यावसायिक घटनाओं को दर्शाने के लिए बदलती रहती हैं, वहीं डायमेंशन टेबल्स उतनी बार संशोधित नहीं होतीं। लेकिन जब वे बदलती हैं तो क्या होता है? अगर कोई डायमेंशन कई बार बदले तो? ऐतिहासिक डेटा कैसे बनाए रखा जाता है?
यहीं काम आते हैं, धीरे-धीरे बदलने वाले आयाम।
धीरे-धीरे बदलने वाले आयाम, जिन्हें प्रायः SCD कहा जाता है, डायमेंशन टेबल्स में संग्रहीत डेटा को, डायमेंशन्स बदलने पर, अपडेट और मेंटेन करने का एक फ्रेमवर्क है। बदलते डायमेंशन्स को संभालने के कई तरीके हैं, और इन तकनीकों को आम तौर पर SCD “टाइप्स” कहा जाता है। हम इन तरीकों में से तीन की परिभाषा, सामान्य उपयोग-परिदृश्य, और स्वयं इन तकनीकों को लागू करने के लिए कोड के साथ विस्तार से पड़ताल करेंगे।
पारंपरिक रूप से, डेटा आर्किटेक्ट और डेटा इंजीनियर साथ मिलकर slowly changing dimensions का लाभ लेने वाला डेटा मॉडल प्लान, डिवेलप और मेंटेन करते हैं। फिर डेटा साइंटिस्ट्स और एनालिस्ट्स स्टार स्कीमा में शामिल इन फैक्ट और डायमेंशन टेबल्स का उपयोग ML पाइपलाइन्स ट्रेन करने, डैशबोर्ड्स को फीड करने, या अन्य कई डेटा-केंद्रित कार्यों में करते हैं। पूरे डेटा प्रोफेशन में, slowly changing dimensions की बुनियादी समझ और ऐसे डेटा का उपयोग करना समय पर इनसाइट्स पाने में मदद करता है, साथ ही दक्षता और विश्वसनीयता बढ़ाता है।