पैरामीटर का आकलन सांख्यिकीय विश्लेषण और मशीन लर्निंग का एक बुनियादी चरण है। उपलब्ध विभिन्न तरीकों में, मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) अपनी सहज समझ, गणितीय ठोसपन, और अलग-अलग प्रकार के डेटा व मॉडलों में व्यापक उपयोग के कारण सबसे अधिक प्रयुक्त तरीकों में से एक है।
इस लेख में, आप जानेंगे कि MLE क्या है, इसके गणितीय आधार को विस्तृत व्युत्पत्तियों और उदाहरणों के माध्यम से समझेंगे, और प्रभावी रूप से MLE लागू करने के व्यावहारिक संगणकीय तरीकों की खोज करेंगे।
मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) क्या है?
मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) एक महत्वपूर्ण सांख्यिकीय विधि है जिसका उपयोग आकलन के लिए पैरामीटरों के, एक प्रायिकता वितरण के, लाइकलीहुड फंक्शन को अधिकतम करके किया जाता है।
जहाँ तक सांख्यिकीय अनुमान में MLE की भूमिका का संबंध है, यह पैरामीटरों का आकलन करने की सबसे सामान्य विधियों में से एक है।
हालाँकि, यहाँ एक और प्रश्न उठ सकता है: लाइकलीहुड फंक्शन क्या है? आइए इसे आगे समझते हैं।
लाइकलीहुड फंक्शन क्या है?
हम लाइकलीहुड फंक्शन को इस तरह समझ सकते हैं कि यह मापता है कि किसी विशेष पैरामीटर सेट द्वारा आपके देखे गए डेटा की व्याख्या कितनी अच्छी तरह होती है।
दूसरे शब्दों में, यह प्रश्न का उत्तर देता है: “इन पैरामीटर मानों के दिए जाने पर, मेरे द्वारा यह डेटा देखे जाने की कितनी संभावना है?” लेकिन यहाँ प्रायिकता (Probability) और लाइकलीहुड (Likelihood) के बीच एक सामान्य गलतफहमी होती है:
प्रायिकता का संबंध डेटा की भविष्यवाणी करने से है, पैरामीटरों के आधार पर
लाइकलीहुड यह मापता है कि देखे गए डेटा के आधार पर अलग-अलग पैरामीटर मान कितने संभव हैं। यह स्थिर डेटा के लिए पैरामीटरों का एक फंक्शन है। इसके विपरीत, प्रायिकता स्थिर पैरामीटरों के लिए डेटा का फंक्शन होती है।
संक्षेप में, लाइकलीहुड फंक्शन आपके मॉडल के पैरामीटरों को इनपुट के रूप में लेता है और आपको एक संख्या देता है जो आपके डेटा के आलोक में उन पैरामीटरों की संभाव्यता दर्शाती है।
लाइकलीहुड फंक्शन का मान जितना अधिक होगा, वे पैरामीटर आपके डेटा को उतना ही बेहतर समझाते हैं।
और सरल शब्दों में, लाइकलीहुड फंक्शन हमें अलग-अलग पैरामीटर विकल्पों को “स्कोर” करने में मदद करता है, ताकि हम वे मान चुन सकें जो हमारे देखे गए डेटा को सबसे अधिक संभाव्य बनाते हैं।
अब जब हमने प्रायिकता और लाइकलीहुड के बीच का अंतर, और MLE के उपयोग को समझ लिया है, तो चलिए आधारभूत गणित की ओर बढ़ते हैं।
MLE सूत्र कैसे व्युत्पन्न करें
विशेष उदाहरणों पर जाने से पहले, देखते हैं कि सामान्य तौर पर मैक्सिमम लाइकलीहुड इस्टीमेटर (MLE) कैसे निकाला जाता है। हम हर चरण से गुजरेंगे और उसके पीछे की तर्क-प्रक्रिया भी समझेंगे।
चरण 1: प्रायिकता मॉडल परिभाषित करें
मान लीजिए हमारे पास एक डेटा सेट है: x₁, x₂, ..., xₙ. हमारा मानना है कि ये बिंदु एक ऐसे प्रायिकता वितरण से उत्पन्न हुए हैं जो किसी अज्ञात पैरामीटर θ (थीटा) पर निर्भर करता है। हमारा मुख्य लक्ष्य θ का आकलन करना है।
उदाहरण के लिए, यदि हमारा डेटा सेट सिक्के उछालने का हो, तो θ हेड आने की प्रायिकता हो सकती है। यदि डेटा सेट सतत हो, जैसे कक्षा के छात्रों की ऊँचाइयाँ, तो θ सामान्य वितरण का माध्य हो सकता है।
चरण 2: लाइकलीहुड फंक्शन लिखें
लाइकलीहुड फंक्शन मापता है कि θ के अलग-अलग मानों के लिए आपका डेटा देखे जाने की कितनी संभावना है। यह इस प्रकार परिभाषित है:
सहज रूप में, हम पूछ रहे हैं कि यदि पैरामीटर θ का कोई विशिष्ट मान हो, तो यह विशेष डेटा सेट देखने की प्रायिकता क्या है?
यह डेटा सेट संयुक्त प्रायिकता के रूप में दर्शाया जाता है, जिसमें व्यक्तिगत डेटा बिंदु (x₁, x₂, ..., xₙ) को देखने की प्रायिकता शामिल है, यह मानते हुए कि वे θ द्वारा पैरामीटराइज्ड मॉडल के अंतर्गत उत्पन्न हुए हैं।
प्रायिकता के चेन नियम का उपयोग करके, हम ऊपर के समीकरण को इस प्रकार विस्तारित कर सकते हैं:
हालाँकि, यह काफी जटिल समीकरण है! इसलिए हम यह मान लेते हैं कि डेटा बिंदु स्वतंत्र हैं—और अधिक सटीक रूप से, शर्तीय रूप से स्वतंत्र हैं।
ऐसा करने पर, हम संयुक्त प्रायिकता को व्यक्तिगत प्रायिकताओं के गुणनफल के रूप में लिख सकते हैं:
क्योंकि हमारे देखे गए डेटा बिंदु θ पर शर्तीय रूप से स्वतंत्र हैं, इसलिए निम्नलिखित समीकरण सत्य है:
क्योंकि हमने मान लिया है कि θ का मान ज्ञात होने पर x₁ और x₂ शर्तीय रूप से स्वतंत्र हैं।
चरण 3: वह θ मान खोजें जो लाइकलीहुड को अधिकतम करे
अब हमें ऐसे θ मान खोजने हैं जो लाइकलीहुड फंक्शन को अधिकतम करें (अर्थात, देखे गए डेटा को सबसे अधिक संभाव्य बनाएँ):
ध्यान दें कि हमारे लाइकलीहुड फंक्शन में गुणनफल है। गुणनफल के साथ काम करना, खासकर बहुत सारे डेटा बिंदुओं के साथ, जटिल हो सकता है। सरल बनाने के लिए हम लॉग लेते हैं लाइकलीहुड फंक्शन का, क्योंकि यह गुणनफल को जोड़ में बदल देता है।
यह हमें लॉग-लाइकलीहुड देता है, जिसके कुछ लाभकारी गुण हैं:
लॉग गुणनफल को जोड़ में बदल देता है, जिसके साथ काम करना, खासकर अलग Differentiation में, बहुत आसान होता है।
लॉग फंक्शन मोनोटोनिक होता है, इसलिए लॉग-लाइकलीहुड को अधिकतम करने से वही θ मिलता है जो लाइकलीहुड को अधिकतम करता है।
चरण 4: इष्टतम मान खोजना
अब हम Differentiation कर सकते हैं, लेकिन मशीन लर्निंग में, हम सामान्यतः अपनी लॉस फंक्शन को न्यूनतम करना चाहते हैं। सौभाग्य से, इसका समाधान सरल है।
अपनी फंक्शन की शुरुआत में माइनस चिह्न जोड़कर (अर्थात -1 से गुणा करके), अब हमें न्यूनतम करना है अपनी लॉस फंक्शन को, जिसे अब नेगेटिव लॉग-लाइकलीहुड लॉस फंक्शन कहा जाता है।
अब हम कैलकुलस का उपयोग करके θ का मान प्राप्त कर सकते हैं। लॉग-लाइकलीहुड का θ के सापेक्ष अवकलन लेकर, उसे शून्य के बराबर रखकर, और θ के लिए हल करके। ऐसा इसलिए क्योंकि किसी फंक्शन का न्यूनतम वह जगह होता है जहाँ उसका अवकलन शून्य (और दूसरा अवकलन धनात्मक) होता है।
अतः, MLE के लिए अंतिम समीकरण यह है:
हल किए गए MLE उदाहरण
चूँकि हमने सफलतापूर्वक MLE समीकरण व्युत्पन्न कर लिया है, समझ को पुख्ता करने के लिए कुछ उदाहरण देखते हैं।
पासा फेंकने का उदाहरण
एक सरल, विविक्त उदाहरण से शुरू करते हैं: एक संभावित पक्षपाती पासे के साथ छह आने की प्रायिकता का आकलन करना।
मान लीजिए हम पासा 12 बार फेंकते हैं और परिणाम दर्ज करते हैं। हम इस डेटा को श्रेणीबद्ध (categorical) वितरण से मॉडल करना चाहते हैं, लेकिन फिलहाल छह आने की प्रायिकता θ का आकलन करने पर ध्यान दें। इस उदाहरण में:
पैरामीटर (θ): वह मान जिसे आप आकलित करना चाहते हैं—छह आने की प्रायिकता
डेटा (x): हमारे देखे गए परिणाम—12 फेंकों में 4 बार छह
अब हम लाइकलीहुड फंक्शन की गणना करते हैं, जो कि 12 फेंकों में 4 बार छह आने के कारण, हमें यह मिलेगा:
इसे हमने इसलिए पाया क्योंकि 12 में से 4 बार छह आया—इसलिए θ⁴ है—और 8 बार छह नहीं आया—इसलिए (1 - θ)⁸ पद है।
ध्यान रखें, हमने इन्हें गुणा इसलिए किया है क्योंकि हमने इन्हें शर्तीय रूप से स्वतंत्र माना है।
अब हम नेगेटिव लॉग-लाइकलीहुड लेते हैं, जैसा कि पहले चर्चा की गई थी, जिससे यह समीकरण मिलता है:
अंत में, हम समीकरण का θ के सापेक्ष अवकलन लेते हैं और उसे 0 के बराबर रखते हैं (क्योंकि हमें न्यूनतम बिंदु खोजना है):
और इस समीकरण से हम निष्कर्ष निकालते हैं कि θ ⅓ के बराबर है।
ध्यान दें: यदि हमें θ के अनेक हल मिलते, तो हमें दूसरी अवकलज भी निकालनी पड़ती और देखना पड़ता कि किन θ मानों पर मान धनात्मक आता है (ताकि पुष्टि हो कि न्यूनतम बिंदु मिला है)। इसे नीचे दिए चित्र में एक उदाहरण फंक्शन से समझा जा सकता है:
ऊँचाइयों का उदाहरण
अब एक सतत उदाहरण देखते हैं—सामान्य (Gaussian) वितरण के माध्य का आकलन।
मान लीजिए हमारे पास 5 लोगों की ऊँचाइयों का डेटा है: 160, 165, 170, 175, 180 (सेमी में)। हम मानेंगे कि ये एक सामान्य वितरण से आए हैं जिसका माध्य μ (म्यू) अज्ञात है और प्रसरण σ² ज्ञात है (सरलता के लिए मान लें σ² = 25)।
पैरामीटर (μ): वह मान जिसे आप आकलित करना चाहते हैं (औसत ऊँचाई)
डेटा (x₁, x₂, ..., x₅): देखी गई ऊँचाइयाँ
ज्ञात प्रसरण वाले सामान्य वितरण के लिए लाइकलीहुड फंक्शन:
यह काफी जटिल दिखता है, लेकिन नेगेटिव लॉग लेने से बातें सरल हो जाती हैं। उम्मीद है अब आप देख पा रहे होंगे कि समीकरण में लॉग का उपयोग कितना शक्तिशाली है। हमें यह समीकरण मिलता है:
यहाँ हमें दो पद मिलते हैं, लेकिन ध्यान दें कि Differentiation करते समय दूसरे पद की उपेक्षा की जा सकती है, क्योंकि हम μ के सापेक्ष अवकलन कर रहे हैं और दूसरे पद में μ नहीं है।
हम लगभग पहुँच चुके हैं, लेकिन ब्रैकेट में μ को देखें।
क्योंकि यह एक स्थिरांक है, हम इसे n से गुणा कर सकते हैं, क्योंकि μ को n बार जोड़ना, n*μ के बराबर है।
अंतिम उत्तर सहज भी लगता है—गणितीय रूप से सभी x मानों का योग लेकर n से भाग देना (जहाँ n अवलोकनों की संख्या है)—और यही तो माध्य की परिभाषा है!
अतः, इस समीकरण में हमारे डेटा मान रखने पर, हमें माध्य 170 सेमी प्राप्त होता है।
इसे और दृश्य बनाने के लिए, यहाँ एक ऐनिमेशन है जो दिखाता है कि μ बदलने पर लाइकलीहुड कैसे बदलता है:
दोनों उदाहरणों में, MLE ने हमें वह पैरामीटर मान दिया जिसने चुने हुए मॉडल के अंतर्गत हमारे देखे गए डेटा को सबसे अधिक संभाव्य बनाया। स्पष्ट है, MLE एकाधिक पैरामीटर मानों के साथ भी काम कर सकता है, हालाँकि गणना थोड़ी लंबी हो जाएगी!
MLE का कोड
अब जब हमने MLE की अंतर्निहित संरचना समझ ली है, तो देखते हैं कि इसे Python में कैसे कोड करें। हम पिछले (ऊँचाइयों वाले) उदाहरण का समाधान कोड करेंगे।
# Importing libraries import numpy as np # used for handling arrays and mathematical operations.from scipy.optimize import minimize # function that minimizes another function# This is our sample data
data = np.array([160,165,170,175,180])# This was the variance we had assumed before
sigma_squared =25# Negative Log-Likelihood functiondefnegative_log_likelihood(mu):
n =len(data)# Number of data pointsreturn0.5* n * np.log(2* np.pi * sigma_squared)+ \
np.sum((data - mu)**2)/(2* sigma_squared)# The NLL is for the Univariate Gaussian Distribution# Optimizing the NLL
result = minimize(negative_log_likelihood, x0=170)# initial guess# Our final estimated mean
estimated_mu = result.x[0]print(f"MLE estimate of mu: {estimated_mu}")संचालित द्वारा
संगणकीय रणनीतियाँ और एल्गोरिदम
ध्यान दें कि पिछले उदाहरण को कोड करते समय, हमने negative_log_likelihood() नामक एक फंक्शन बनाया था जिसमें एक-वेरिएट Gaussian वितरण के MLE की गणना का मुख्य तर्क था।
एक तरफ, यह कहा जा सकता है कि अंततः हमने इस समीकरण को हार्ड-कोड कर दिया, और हमने scipy.optimize का उपयोग उस फंक्शन को न्यूनतम करने के लिए किया। बेशक, यह अभी भी पूरी तरह से व्यावहारिक समाधान है, क्योंकि Gaussian वितरण का क्लोज़्ड-फॉर्म समाधान उपलब्ध है।
आइए MLE के समाधान निकालने के अन्य तरीकों का अन्वेषण करें।
क्लोज़्ड-फॉर्म समाधान और उनका दायरा
जैसा कि ऊपर चर्चा की, कुछ अनुकूल परिस्थितियों में हम MLE समीकरणों को विश्लेषणात्मक रूप से हल कर सकते हैं, यानी हम पैरामीटर अनुमानों के लिए सटीक सूत्र निकाल सकते हैं। इन्हें क्लोज़्ड-फॉर्म समाधान कहा जाता है—ये अक्सर सरल, सहज, और कोड व गणना करने में तेज़ होते हैं।
अब एक महत्वपूर्ण सवाल: क्लोज़्ड-फॉर्म समाधान कब मौजूद होते हैं?
जब लॉग-लाइकलीहुड फंक्शन अवकलनीय, अवतल (concave), और बीजीय रूप से प्रबंधनीय हो।
जब मॉडल पर्याप्त रूप से सरल हो; सामान्यतः एक या दो पैरामीटर शामिल हों और कोई छिपे हुए चर न हों।
वितरण
आकलित पैरामीटर
क्लोज़्ड-फॉर्म MLE समाधान
बर्नौली
p
\hat{p} = सफलता की संख्या/n
बायनोमियल
p
\hat{p} = x/n
पॉइसन
λ
λ = 1/n*Σx_i
Gaussian/Normal
μ
μ = 1/n*Σx_i
संख्यात्मक अनुकूलन तकनीकें
अधिक जटिल मॉडलों के लिए, विश्लेषणात्मक समाधान मौजूद नहीं होते या निकालना अत्यधिक कठिन होता है। ऐसे मामलों में, हम संख्यात्मक अनुकूलन विधियों का उपयोग करते हैं—पुनरावृत्त एल्गोरिदम जो लॉग-लाइकलीहुड को अधिकतम करने वाले पैरामीटर खोजते हैं। संक्षेप में:
न्यूटन-रैफसन विधि: यह विधि दोनों का उपयोग करती है:
पहला अवकलज (ग्रेडिएंट) ढाल जानने के लिए, और
दूसरा अवकलज (हैसियन) वक्रता मापने और उसी अनुरूप स्टेप साइज समायोजित करने के लिए।
अपडेट नियम इस प्रकार होता है:
मुख्य लाभ है कि यह शीघ्र अभिसरण करता है इष्टतम मान के पास।
परंतु, दूसरे अवकलज की गणना उच्च आयामों में अस्थिर या महँगी हो सकती है।
क्वाज़ी-न्यूटन विधियाँ (जैसे, BFGS):
हैसियन मैट्रिक्स का सन्निकटन केवल प्रथम-क्रम अवकलजों से करती हैं
Python में लोकप्रिय लाइब्रेरी जैसे scipy.optimize.minimize में प्रयुक्त (डिफ़ॉल्ट रूप से BFGS)।
न्यूटन-रैफसन की तुलना में अधिक संख्यात्मक रूप से स्थिर और व्यापक रूप से लागू।
एक्सपेक्टेशन-मैक्सिमाइजेशन (EM) एल्गोरिदम:
यह एक विशिष्ट अनुकूलन तकनीक है जब डेटा में अदृश्य (छिपे) चर शामिल हों—ऐसे मान जिन्हें हम सीधे नहीं देखते पर वे डेटा को प्रभावित करते हैं।
इस एल्गोरिदम के दो चरण होते हैं:
E-स्टेप (Expectation): वर्तमान पैरामीटर अनुमानों और देखे गए डेटा का उपयोग करके लॉग-लाइकलीहुड का प्रत्याशित मान निकालें।
M-स्टेप (Maximization): इस प्रत्याशित लॉग-लाइकलीहुड को अधिकतम करके पैरामीटर अनुमान अपडेट करें।
MLE के गुण
हमारे उदाहरणों और गणनाओं से स्पष्ट है कि MLE उपयोगी है। औपचारिक रूप से, MLE के ये गुण हैं:
संगतता (Consistency): नमूना आकार बढ़ने पर, MLE वास्तविक पैरामीटर मान के पास अभिसरित होता है।
असमाप्य सामान्यता (Asymptotic Normality): बड़े नमूनों के लिए, MLE का वितरण वास्तविक पैरामीटर मान के आसपास लगभग सामान्य (घंटी-आकार) हो जाता है। यही विश्वास अंतराल बनाने का आधार है।
दक्षता (Efficiency): सभी निःपक्षपाती (unbiased) इस्टीमेटरों में, MLE न्यूनतम संभव विचरण प्राप्त करता है (कम-से-कम असमाप्य रूप से क्रैमर-राव निम्न बाउंड तक पहुँचता है)।
इनवेरिएंस (Invariance): यदि θ̂, θ का MLE है, तो किसी भी फंक्शन g के लिए, g(θ̂), g(θ) का MLE होगा। अर्थात, MLE रूपांतरणों के अंतर्गत संरक्षित रहता है।
हालाँकि, कुछ परिस्थितियों में MLE सर्वोत्तम विकल्प नहीं होता:
छोटे नमूने: नमूना आकार छोटा होने पर MLE पक्षपाती हो सकता है। उदाहरण के लिए, प्रसरण (σ̂²) के लिए MLE वास्तविक प्रसरण (σ²) को कम आकलित करता है।
रोबस्टनेस: MLE अपवादात्मक मानों (outliers) और मॉडल की गलत-स्पेसिफिकेशन के प्रति संवेदनशील होता है। M-इस्टीमेटर्स जैसे विकल्प अधिक रोबस्ट हो सकते हैं।
बेयज़ियन विकल्प: मैक्सिमम ए पोस्टेरियोरी (MAP) आकलन, पूर्व (prior) जानकारी को लाइकलीहुड के साथ जोड़ता है, जो सीमित डेटा में अधिक स्थिर अनुमान दे सकता है।
सांख्यिकीय मॉडलिंग में उपयोग
इस खंड में देखते हैं कि मशीन लर्निंग और AI में MLE वास्तव में कहाँ-कहाँ उपयोग होता है।
रिग्रेशन और क्लासिफिकेशन
MLE का एक प्रमुख उपयोग लॉजिस्टिक रिग्रेशन में है। यहाँ हम अनुमान लगाते हैं कि कोई आउटकम किसी वर्ग का है (जैसे कस्टमर चर्न), और ऐसा हम उन पैरामीटरों को फिट करके करते हैं जो लाइकलीहुड को अधिकतम करें।
यहाँ तक कि लिनियर रिग्रेशन में भी, यदि हम त्रुटियों को सामान्य-वितरित मानें, तो लीस्ट स्क्वेयर्स समाधान वास्तव में MLE ही निकलता है।
परिकल्पना परीक्षण और मॉडल चयन
MLE का उपयोग मॉडलों की तुलना करने में भी किया जा सकता है।
उदाहरण के लिए, लाइकलीहुड रेशियो टेस्ट (LRT) यह जाँचने में मदद करता है कि किसी मॉडल में अतिरिक्त चर जोड़ने से प्रदर्शन में महत्वपूर्ण सुधार होता है या नहीं। यह दो मॉडलों की लाइकलीहुड की तुलना करके काम करता है: एक सरल (शून्य परिकल्पना), एक अधिक जटिल (वैकल्पिक)।
हमारे पास आकाइके सूचना मापदंड (AIC) भी है, जो ओवरफिटिंग से बचने के लिए जटिलता पर दंड लगाता है। ये औज़ार वित्त, चिकित्सा, और मार्केटिंग जैसे क्षेत्रों में व्यापक रूप से उपयोग होते हैं।
यदि आप केवल लाइकलीहुड से आगे बढ़कर प्रायिकता-वितरणों के बीच अंतर मापने के और तरीकों का अन्वेषण करना चाहते हैं, तो मेरा ट्यूटोरियल देखें: KL-Divergence Explained।
MLE की सीमाएँ और विकल्प
यद्यपि यह शक्तिशाली है, इसकी कुछ कमियाँ भी हैं। संक्षेप में देखें कि यह कहाँ संघर्ष करता है और इसके स्थान पर क्या उपयोग कर सकते हैं।
MLE की मुख्य सीमाएँ
मॉडल मिसस्पेसिफिकेशन के प्रति संवेदनशील: यदि हमारा मॉडल गलत है (जैसे तिरछे डेटा के लिए सामान्य वितरण का उपयोग), तो MLE भ्रामक परिणाम दे सकता है।
आउटलायर संवेदनशीलता: कुछ खराब डेटा बिंदु आपके अनुमानों को पूरी तरह बिगाड़ सकते हैं।
संगणकीय लागत: बड़े मॉडलों में, खासकर कई पैरामीटरों या बाधाओं के साथ, लाइकलीहुड को अनुकूलित करना धीमा या अस्थिर हो सकता है।
एकाधिक समाधान: कभी-कभी लाइकलीहुड सतह पर कई शिखर (स्थानीय अधिकतम) होते हैं, जिससे सर्वोत्तम समाधान खोजना मुश्किल हो जाता है।
मैक्सिमम लाइकलीहुड इस्टीमेशन के विकल्प
जब MLE अच्छा काम नहीं करता, तो ये विकल्प अपनाएँ:
MAP (मैक्सिमम ए पोस्टेरियोरी): MLE जैसा ही, लेकिन पूर्व (prior) जोड़ता है। सीमित डेटा में अनुमान को स्थिर करने में सहायक।
मोमेंट्स की विधि (Method of Moments): सैंपल मोमेंट्स (जैसे माध्य या प्रसरण) को सैद्धांतिक मोमेंट्स से मिलाती है। MLE से कम सटीक पर गणना में बहुत सरल।
लीस्ट स्क्वेयर्स: जैसे मामलों में—Gaussian त्रुटियों के साथ रैखिक प्रतिगमन—लीस्ट स्क्वेयर्स और MLE समान हैं। लेकिन जब MLE बहुत जटिल हो, तब भी लीस्ट स्क्वेयर्स उपयोगी रह सकता है।
अलग-अलग परिस्थितियों में अलग-अलग विधियाँ बेहतर काम करती हैं। MLE हर बार उत्तर न सही हो, पर अक्सर यह एक उत्कृष्ट शुरुआती बिंदु होता है।
निष्कर्ष
मैक्सिमम लाइकलीहुड इस्टीमेशन पैरामीटर आकलन की सबसे स्वाभाविक और व्यापक रूप से प्रयुक्त विधियों में से एक है। इसका सार है देखे गए डेटा को यथासंभव संभाव्य बनाना, और इसलिए इसे कई अलग-अलग परिदृश्यों—जैसे सिक्का उछालना, Gaussian ऊँचाइयाँ, आदि—में उपयोग किया जा सकता है।
MLE अलग-अलग मॉडलों में ढल सकता है और डेटा के साथ स्केल कर सकता है—यह गणितीय सौंदर्य और व्यावहारिक शक्ति दोनों प्रदान करता है। हालाँकि इसकी अपनी कमियाँ हैं, विशेषकर छोटे या अव्यवस्थित डेटा सेट में, फिर भी यह मशीन लर्निंग और AI सीखते समय एक आधारभूत औज़ार बना रहता है।
Maximum Likelihood Estimation की समझ को व्यावहारिक अभ्यासों से और गहरा करना चाहते हैं? ये संसाधन आपके ज्ञान को लागू करने और हाथों-हाथ अनुभव पाने में सहायक होंगे:
OLS Regression: The Key Ideas Explained: Gaussian त्रुटियों को मानते हुए, Ordinary Least Squares और MLE के संबंध का अन्वेषण करें, और मूलभूत सांख्यिकीय अवधारणाओं को सुदृढ़ करें।
प्रायिकता पैरामीटर से शुरू होकर पूछती है, “मुझे कौन-सा डेटा अपेक्षित है?” लाइकलीहुड डेटा से शुरू होकर पूछती है, “कौन-सा पैरामीटर इस डेटा को सबसे अधिक विश्वसनीय बनाता है?”
हम लाइकलीहुड का लॉग क्यों लेते हैं?⌄
लॉग लंबे गुणनफल को साधारण जोड़ में बदल देता है—गणित को साफ-सुथरा बनाते हुए अधिकतम बिंदु को वहीँ रखता है।
क्या MLE हमेशा सही पैरामीटर ढूँढ लेता है?⌄
बहुत-सा स्वच्छ, स्वतंत्र डेटा हो तो यह सत्य मान तक अभिसरित हो जाता है। लेकिन छोटे या अव्यवस्थित नमूनों में यह भटक सकता है या थोड़ा पक्षपाती रह सकता है।
यदि मेरे डेटा बिंदु स्वतंत्र न हों तो?⌄
मानक MLE स्वतंत्रता मान कर चलता है, इसलिए समय-श्रृंखला या स्थानिक डेटा के लिए उन निर्भरताओं को पकड़ने वाला दूसरा मॉडल चाहिए।
MLE का लीस्ट स्क्वेयर्स से क्या संबंध है?⌄
जब रिग्रेशन त्रुटियाँ सामान्य-वितरित मानी जाती हैं, तो वर्ग त्रुटियों को न्यूनतम करना (लीस्ट स्क्वेयर्स) लाइकलीहुड को अधिकतम (MLE) करने के बराबर होता है।
Python के साथ मशीन लर्निंग की खोज करें और मशीन लर्निंग वैज्ञानिक बनने की दिशा में आगे बढ़ें। पर्यवेक्षित, अपर्यवेक्षित, और डीप लर्निंग का अन्वेषण करें।



पैरामीटर का आकलन सांख्यिकीय विश्लेषण और मशीन लर्निंग का एक बुनियादी चरण है। उपलब्ध विभिन्न तरीकों में, मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) अपनी सहज समझ, गणितीय ठोसपन, और अलग-अलग प्रकार के डेटा व मॉडलों में व्यापक उपयोग के कारण सबसे अधिक प्रयुक्त तरीकों में से एक है।
इस लेख में, आप जानेंगे कि MLE क्या है, इसके गणितीय आधार को विस्तृत व्युत्पत्तियों और उदाहरणों के माध्यम से समझेंगे, और प्रभावी रूप से MLE लागू करने के व्यावहारिक संगणकीय तरीकों की खोज करेंगे।
मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) क्या है?
मैक्सिमम लाइकलीहुड इस्टीमेशन (MLE) एक महत्वपूर्ण सांख्यिकीय विधि है जिसका उपयोग आकलन के लिए पैरामीटरों के, एक प्रायिकता वितरण के, लाइकलीहुड फंक्शन को अधिकतम करके किया जाता है।
जहाँ तक सांख्यिकीय अनुमान में MLE की भूमिका का संबंध है, यह पैरामीटरों का आकलन करने की सबसे सामान्य विधियों में से एक है।
हालाँकि, यहाँ एक और प्रश्न उठ सकता है: लाइकलीहुड फंक्शन क्या है? आइए इसे आगे समझते हैं।
लाइकलीहुड फंक्शन क्या है?
हम लाइकलीहुड फंक्शन को इस तरह समझ सकते हैं कि यह मापता है कि किसी विशेष पैरामीटर सेट द्वारा आपके देखे गए डेटा की व्याख्या कितनी अच्छी तरह होती है।
दूसरे शब्दों में, यह प्रश्न का उत्तर देता है: “इन पैरामीटर मानों के दिए जाने पर, मेरे द्वारा यह डेटा देखे जाने की कितनी संभावना है?” लेकिन यहाँ प्रायिकता (Probability) और लाइकलीहुड (Likelihood) के बीच एक सामान्य गलतफहमी होती है:
संक्षेप में, लाइकलीहुड फंक्शन आपके मॉडल के पैरामीटरों को इनपुट के रूप में लेता है और आपको एक संख्या देता है जो आपके डेटा के आलोक में उन पैरामीटरों की संभाव्यता दर्शाती है।
लाइकलीहुड फंक्शन का मान जितना अधिक होगा, वे पैरामीटर आपके डेटा को उतना ही बेहतर समझाते हैं।
और सरल शब्दों में, लाइकलीहुड फंक्शन हमें अलग-अलग पैरामीटर विकल्पों को “स्कोर” करने में मदद करता है, ताकि हम वे मान चुन सकें जो हमारे देखे गए डेटा को सबसे अधिक संभाव्य बनाते हैं।
अब जब हमने प्रायिकता और लाइकलीहुड के बीच का अंतर, और MLE के उपयोग को समझ लिया है, तो चलिए आधारभूत गणित की ओर बढ़ते हैं।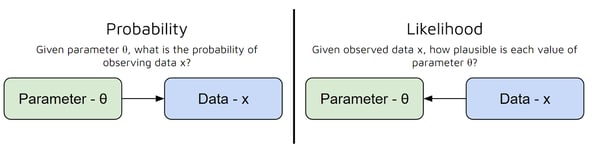
MLE सूत्र कैसे व्युत्पन्न करें
विशेष उदाहरणों पर जाने से पहले, देखते हैं कि सामान्य तौर पर मैक्सिमम लाइकलीहुड इस्टीमेटर (MLE) कैसे निकाला जाता है। हम हर चरण से गुजरेंगे और उसके पीछे की तर्क-प्रक्रिया भी समझेंगे।
चरण 1: प्रायिकता मॉडल परिभाषित करें
मान लीजिए हमारे पास एक डेटा सेट है: x₁, x₂, ..., xₙ. हमारा मानना है कि ये बिंदु एक ऐसे प्रायिकता वितरण से उत्पन्न हुए हैं जो किसी अज्ञात पैरामीटर θ (थीटा) पर निर्भर करता है। हमारा मुख्य लक्ष्य θ का आकलन करना है।
उदाहरण के लिए, यदि हमारा डेटा सेट सिक्के उछालने का हो, तो θ हेड आने की प्रायिकता हो सकती है। यदि डेटा सेट सतत हो, जैसे कक्षा के छात्रों की ऊँचाइयाँ, तो θ सामान्य वितरण का माध्य हो सकता है।
चरण 2: लाइकलीहुड फंक्शन लिखें
लाइकलीहुड फंक्शन मापता है कि θ के अलग-अलग मानों के लिए आपका डेटा देखे जाने की कितनी संभावना है। यह इस प्रकार परिभाषित है:
सहज रूप में, हम पूछ रहे हैं कि यदि पैरामीटर θ का कोई विशिष्ट मान हो, तो यह विशेष डेटा सेट देखने की प्रायिकता क्या है?
यह डेटा सेट संयुक्त प्रायिकता के रूप में दर्शाया जाता है, जिसमें व्यक्तिगत डेटा बिंदु (x₁, x₂, ..., xₙ) को देखने की प्रायिकता शामिल है, यह मानते हुए कि वे θ द्वारा पैरामीटराइज्ड मॉडल के अंतर्गत उत्पन्न हुए हैं।
प्रायिकता के चेन नियम का उपयोग करके, हम ऊपर के समीकरण को इस प्रकार विस्तारित कर सकते हैं:
हालाँकि, यह काफी जटिल समीकरण है! इसलिए हम यह मान लेते हैं कि डेटा बिंदु स्वतंत्र हैं—और अधिक सटीक रूप से, शर्तीय रूप से स्वतंत्र हैं।
ऐसा करने पर, हम संयुक्त प्रायिकता को व्यक्तिगत प्रायिकताओं के गुणनफल के रूप में लिख सकते हैं:
क्योंकि हमारे देखे गए डेटा बिंदु θ पर शर्तीय रूप से स्वतंत्र हैं, इसलिए निम्नलिखित समीकरण सत्य है:
क्योंकि हमने मान लिया है कि θ का मान ज्ञात होने पर x₁ और x₂ शर्तीय रूप से स्वतंत्र हैं।
चरण 3: वह θ मान खोजें जो लाइकलीहुड को अधिकतम करे
अब हमें ऐसे θ मान खोजने हैं जो लाइकलीहुड फंक्शन को अधिकतम करें (अर्थात, देखे गए डेटा को सबसे अधिक संभाव्य बनाएँ):
ध्यान दें कि हमारे लाइकलीहुड फंक्शन में गुणनफल है। गुणनफल के साथ काम करना, खासकर बहुत सारे डेटा बिंदुओं के साथ, जटिल हो सकता है। सरल बनाने के लिए हम लॉग लेते हैं लाइकलीहुड फंक्शन का, क्योंकि यह गुणनफल को जोड़ में बदल देता है।
यह हमें लॉग-लाइकलीहुड देता है, जिसके कुछ लाभकारी गुण हैं:
चरण 4: इष्टतम मान खोजना
अब हम Differentiation कर सकते हैं, लेकिन मशीन लर्निंग में, हम सामान्यतः अपनी लॉस फंक्शन को न्यूनतम करना चाहते हैं। सौभाग्य से, इसका समाधान सरल है।
अपनी फंक्शन की शुरुआत में माइनस चिह्न जोड़कर (अर्थात -1 से गुणा करके), अब हमें न्यूनतम करना है अपनी लॉस फंक्शन को, जिसे अब नेगेटिव लॉग-लाइकलीहुड लॉस फंक्शन कहा जाता है।
अब हम कैलकुलस का उपयोग करके θ का मान प्राप्त कर सकते हैं। लॉग-लाइकलीहुड का θ के सापेक्ष अवकलन लेकर, उसे शून्य के बराबर रखकर, और θ के लिए हल करके। ऐसा इसलिए क्योंकि किसी फंक्शन का न्यूनतम वह जगह होता है जहाँ उसका अवकलन शून्य (और दूसरा अवकलन धनात्मक) होता है।
अतः, MLE के लिए अंतिम समीकरण यह है:
हल किए गए MLE उदाहरण
चूँकि हमने सफलतापूर्वक MLE समीकरण व्युत्पन्न कर लिया है, समझ को पुख्ता करने के लिए कुछ उदाहरण देखते हैं।
पासा फेंकने का उदाहरण
एक सरल, विविक्त उदाहरण से शुरू करते हैं: एक संभावित पक्षपाती पासे के साथ छह आने की प्रायिकता का आकलन करना।
मान लीजिए हम पासा 12 बार फेंकते हैं और परिणाम दर्ज करते हैं। हम इस डेटा को श्रेणीबद्ध (categorical) वितरण से मॉडल करना चाहते हैं, लेकिन फिलहाल छह आने की प्रायिकता θ का आकलन करने पर ध्यान दें। इस उदाहरण में:
अब हम लाइकलीहुड फंक्शन की गणना करते हैं, जो कि 12 फेंकों में 4 बार छह आने के कारण, हमें यह मिलेगा:
इसे हमने इसलिए पाया क्योंकि 12 में से 4 बार छह आया—इसलिए θ⁴ है—और 8 बार छह नहीं आया—इसलिए (1 - θ)⁸ पद है।
ध्यान रखें, हमने इन्हें गुणा इसलिए किया है क्योंकि हमने इन्हें शर्तीय रूप से स्वतंत्र माना है।
अब हम नेगेटिव लॉग-लाइकलीहुड लेते हैं, जैसा कि पहले चर्चा की गई थी, जिससे यह समीकरण मिलता है:
अंत में, हम समीकरण का θ के सापेक्ष अवकलन लेते हैं और उसे 0 के बराबर रखते हैं (क्योंकि हमें न्यूनतम बिंदु खोजना है):
और इस समीकरण से हम निष्कर्ष निकालते हैं कि θ ⅓ के बराबर है।
ध्यान दें: यदि हमें θ के अनेक हल मिलते, तो हमें दूसरी अवकलज भी निकालनी पड़ती और देखना पड़ता कि किन θ मानों पर मान धनात्मक आता है (ताकि पुष्टि हो कि न्यूनतम बिंदु मिला है)। इसे नीचे दिए चित्र में एक उदाहरण फंक्शन से समझा जा सकता है:
ऊँचाइयों का उदाहरण
अब एक सतत उदाहरण देखते हैं—सामान्य (Gaussian) वितरण के माध्य का आकलन।
मान लीजिए हमारे पास 5 लोगों की ऊँचाइयों का डेटा है: 160, 165, 170, 175, 180 (सेमी में)। हम मानेंगे कि ये एक सामान्य वितरण से आए हैं जिसका माध्य μ (म्यू) अज्ञात है और प्रसरण σ² ज्ञात है (सरलता के लिए मान लें σ² = 25)।
ज्ञात प्रसरण वाले सामान्य वितरण के लिए लाइकलीहुड फंक्शन:
यह काफी जटिल दिखता है, लेकिन नेगेटिव लॉग लेने से बातें सरल हो जाती हैं। उम्मीद है अब आप देख पा रहे होंगे कि समीकरण में लॉग का उपयोग कितना शक्तिशाली है। हमें यह समीकरण मिलता है:
यहाँ हमें दो पद मिलते हैं, लेकिन ध्यान दें कि Differentiation करते समय दूसरे पद की उपेक्षा की जा सकती है, क्योंकि हम μ के सापेक्ष अवकलन कर रहे हैं और दूसरे पद में μ नहीं है।
हम लगभग पहुँच चुके हैं, लेकिन ब्रैकेट में μ को देखें।
क्योंकि यह एक स्थिरांक है, हम इसे n से गुणा कर सकते हैं, क्योंकि μ को n बार जोड़ना, n*μ के बराबर है।
अंतिम उत्तर सहज भी लगता है—गणितीय रूप से सभी x मानों का योग लेकर n से भाग देना (जहाँ n अवलोकनों की संख्या है)—और यही तो माध्य की परिभाषा है!
अतः, इस समीकरण में हमारे डेटा मान रखने पर, हमें माध्य 170 सेमी प्राप्त होता है।
इसे और दृश्य बनाने के लिए, यहाँ एक ऐनिमेशन है जो दिखाता है कि μ बदलने पर लाइकलीहुड कैसे बदलता है:
दोनों उदाहरणों में, MLE ने हमें वह पैरामीटर मान दिया जिसने चुने हुए मॉडल के अंतर्गत हमारे देखे गए डेटा को सबसे अधिक संभाव्य बनाया। स्पष्ट है, MLE एकाधिक पैरामीटर मानों के साथ भी काम कर सकता है, हालाँकि गणना थोड़ी लंबी हो जाएगी!
MLE का कोड
अब जब हमने MLE की अंतर्निहित संरचना समझ ली है, तो देखते हैं कि इसे Python में कैसे कोड करें। हम पिछले (ऊँचाइयों वाले) उदाहरण का समाधान कोड करेंगे।
संगणकीय रणनीतियाँ और एल्गोरिदम
ध्यान दें कि पिछले उदाहरण को कोड करते समय, हमने
negative_log_likelihood()नामक एक फंक्शन बनाया था जिसमें एक-वेरिएट Gaussian वितरण के MLE की गणना का मुख्य तर्क था।एक तरफ, यह कहा जा सकता है कि अंततः हमने इस समीकरण को हार्ड-कोड कर दिया, और हमने
scipy.optimizeका उपयोग उस फंक्शन को न्यूनतम करने के लिए किया। बेशक, यह अभी भी पूरी तरह से व्यावहारिक समाधान है, क्योंकि Gaussian वितरण का क्लोज़्ड-फॉर्म समाधान उपलब्ध है।आइए MLE के समाधान निकालने के अन्य तरीकों का अन्वेषण करें।
क्लोज़्ड-फॉर्म समाधान और उनका दायरा
जैसा कि ऊपर चर्चा की, कुछ अनुकूल परिस्थितियों में हम MLE समीकरणों को विश्लेषणात्मक रूप से हल कर सकते हैं, यानी हम पैरामीटर अनुमानों के लिए सटीक सूत्र निकाल सकते हैं। इन्हें क्लोज़्ड-फॉर्म समाधान कहा जाता है—ये अक्सर सरल, सहज, और कोड व गणना करने में तेज़ होते हैं।
अब एक महत्वपूर्ण सवाल: क्लोज़्ड-फॉर्म समाधान कब मौजूद होते हैं?
वितरण
आकलित पैरामीटर
क्लोज़्ड-फॉर्म MLE समाधान
बर्नौली
p
\hat{p} = सफलता की संख्या/n
बायनोमियल
p
\hat{p} = x/n
पॉइसन
λ
λ = 1/n*Σx_i
Gaussian/Normal
μ
μ = 1/n*Σx_i
संख्यात्मक अनुकूलन तकनीकें
अधिक जटिल मॉडलों के लिए, विश्लेषणात्मक समाधान मौजूद नहीं होते या निकालना अत्यधिक कठिन होता है। ऐसे मामलों में, हम संख्यात्मक अनुकूलन विधियों का उपयोग करते हैं—पुनरावृत्त एल्गोरिदम जो लॉग-लाइकलीहुड को अधिकतम करने वाले पैरामीटर खोजते हैं। संक्षेप में:
MLE के गुण
हमारे उदाहरणों और गणनाओं से स्पष्ट है कि MLE उपयोगी है। औपचारिक रूप से, MLE के ये गुण हैं:
हालाँकि, कुछ परिस्थितियों में MLE सर्वोत्तम विकल्प नहीं होता:
सांख्यिकीय मॉडलिंग में उपयोग
इस खंड में देखते हैं कि मशीन लर्निंग और AI में MLE वास्तव में कहाँ-कहाँ उपयोग होता है।
रिग्रेशन और क्लासिफिकेशन
MLE का एक प्रमुख उपयोग लॉजिस्टिक रिग्रेशन में है। यहाँ हम अनुमान लगाते हैं कि कोई आउटकम किसी वर्ग का है (जैसे कस्टमर चर्न), और ऐसा हम उन पैरामीटरों को फिट करके करते हैं जो लाइकलीहुड को अधिकतम करें।
यहाँ तक कि लिनियर रिग्रेशन में भी, यदि हम त्रुटियों को सामान्य-वितरित मानें, तो लीस्ट स्क्वेयर्स समाधान वास्तव में MLE ही निकलता है।
परिकल्पना परीक्षण और मॉडल चयन
MLE का उपयोग मॉडलों की तुलना करने में भी किया जा सकता है।
उदाहरण के लिए, लाइकलीहुड रेशियो टेस्ट (LRT) यह जाँचने में मदद करता है कि किसी मॉडल में अतिरिक्त चर जोड़ने से प्रदर्शन में महत्वपूर्ण सुधार होता है या नहीं। यह दो मॉडलों की लाइकलीहुड की तुलना करके काम करता है: एक सरल (शून्य परिकल्पना), एक अधिक जटिल (वैकल्पिक)।
हमारे पास आकाइके सूचना मापदंड (AIC) भी है, जो ओवरफिटिंग से बचने के लिए जटिलता पर दंड लगाता है। ये औज़ार वित्त, चिकित्सा, और मार्केटिंग जैसे क्षेत्रों में व्यापक रूप से उपयोग होते हैं।
यदि आप केवल लाइकलीहुड से आगे बढ़कर प्रायिकता-वितरणों के बीच अंतर मापने के और तरीकों का अन्वेषण करना चाहते हैं, तो मेरा ट्यूटोरियल देखें: KL-Divergence Explained।
MLE की सीमाएँ और विकल्प
यद्यपि यह शक्तिशाली है, इसकी कुछ कमियाँ भी हैं। संक्षेप में देखें कि यह कहाँ संघर्ष करता है और इसके स्थान पर क्या उपयोग कर सकते हैं।
MLE की मुख्य सीमाएँ
मैक्सिमम लाइकलीहुड इस्टीमेशन के विकल्प
जब MLE अच्छा काम नहीं करता, तो ये विकल्प अपनाएँ:
अलग-अलग परिस्थितियों में अलग-अलग विधियाँ बेहतर काम करती हैं। MLE हर बार उत्तर न सही हो, पर अक्सर यह एक उत्कृष्ट शुरुआती बिंदु होता है।
निष्कर्ष
मैक्सिमम लाइकलीहुड इस्टीमेशन पैरामीटर आकलन की सबसे स्वाभाविक और व्यापक रूप से प्रयुक्त विधियों में से एक है। इसका सार है देखे गए डेटा को यथासंभव संभाव्य बनाना, और इसलिए इसे कई अलग-अलग परिदृश्यों—जैसे सिक्का उछालना, Gaussian ऊँचाइयाँ, आदि—में उपयोग किया जा सकता है।
MLE अलग-अलग मॉडलों में ढल सकता है और डेटा के साथ स्केल कर सकता है—यह गणितीय सौंदर्य और व्यावहारिक शक्ति दोनों प्रदान करता है। हालाँकि इसकी अपनी कमियाँ हैं, विशेषकर छोटे या अव्यवस्थित डेटा सेट में, फिर भी यह मशीन लर्निंग और AI सीखते समय एक आधारभूत औज़ार बना रहता है।
यदि आप अपनी मशीन लर्निंग यात्रा पर हैं, तो हमारा Machine Learning Scientist in Python करियर ट्रैक अवश्य देखें, जिसमें सुपरवाइज़्ड, अनसुपरवाइज़्ड और डीप लर्निंग शामिल हैं।
Maximum Likelihood Estimation की समझ को व्यावहारिक अभ्यासों से और गहरा करना चाहते हैं? ये संसाधन आपके ज्ञान को लागू करने और हाथों-हाथ अनुभव पाने में सहायक होंगे: