

在 Python 中实现均值漂移聚类
现在让我们来实践均值漂移聚类的使用步骤。我们将使用流行的 sci-kit-learn 库中的 MeanShift 类,它可以开箱即用地将该算法应用到数据集上。
基础均值漂移聚类
首先导入实现所需的库。
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt接下来,我们使用 scikit-learn 的 datasets 模块中的 make_blobs() 函数生成一个包含 500 个样本的合成数据集。该数据集有五个中心(即簇),簇的标准差为 0.7。
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)让我们使用 estimate_bandwidth() 函数来估计带宽。
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)现在,我们将使用该带宽数值来初始化 MeanShift 聚类对象,并在先前创建的数据集上进行拟合。
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_现在来可视化原始数据集上的均值漂移簇中心。这里,我们的五个簇用不同颜色表示,均值漂移中心用叉号表示。
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()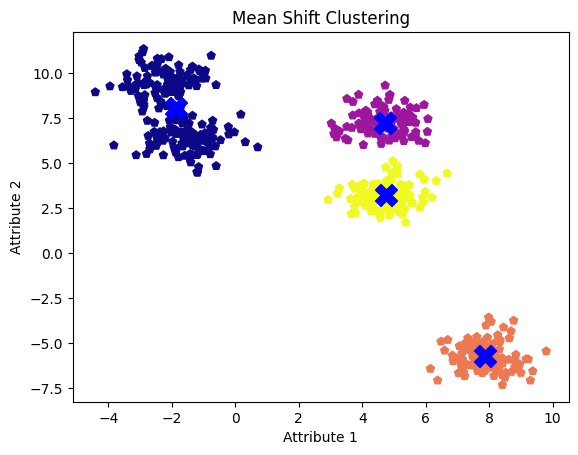
默认带宽值下的均值漂移聚类结果。图片作者自制
尽管我们观察到五个团块或簇,但算法仅识别出四个,因为它将两个相邻簇合并为一个。
调节带宽参数
bandwidth 参数对聚类结果影响很大。让我们对其进行调节,看是否能找到五个簇。我们将测试三个不同的带宽值,并可视化各自的簇中心。
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()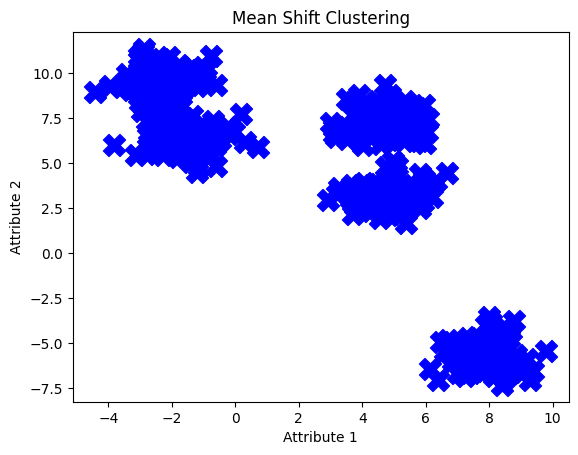
带宽为 0.1 的均值漂移聚类结果。图片作者自制
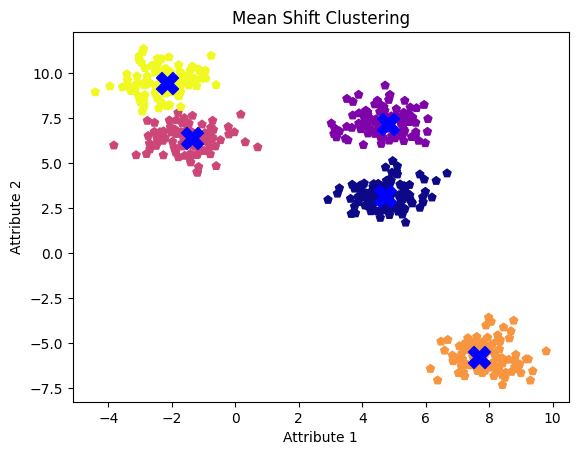
带宽为 1.0 的均值漂移聚类结果。图片作者自制
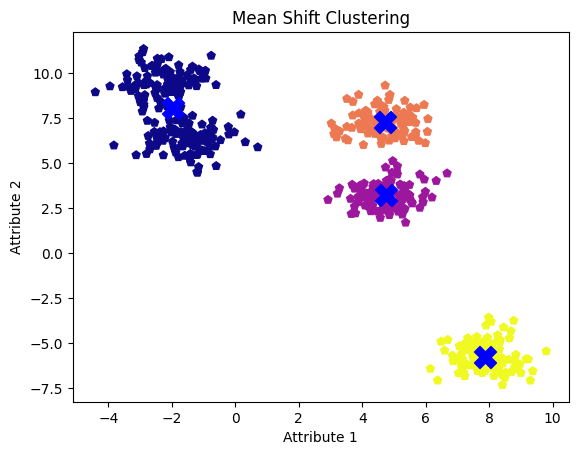
带宽为 2.0 的均值漂移聚类结果。图片作者自制
带宽值 0.1 显然过小,导致算法将每个数据点都视为一个独立簇。另一方面,带宽值 2.0 似乎偏大,因为它在第一次尝试中未能分开两个簇。带宽值 1.0 最为理想,清晰地展示了全部五个簇及其中心。
让我们选择该值并再次可视化结果。
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()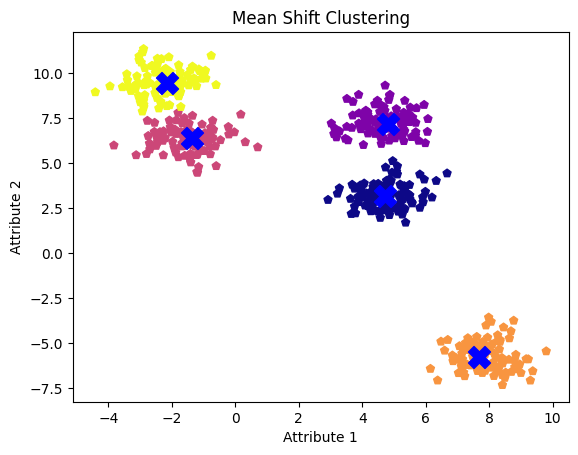
带宽为 1.0 的均值漂移聚类结果
如可观察到,带宽越小,往往产生更多簇;带宽越大,则可能导致簇被合并。
均值漂移与 k-means 的比较
我们在同一数据集上比较均值漂移与 k-means 的结果。 首先,从 sklearn 的 cluster 模块导入 KMeans。接着,我们将簇数设为 3 并拟合模型以获得簇质心。
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_现在,让我们可视化结果,并与均值漂移聚类进行对比。
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()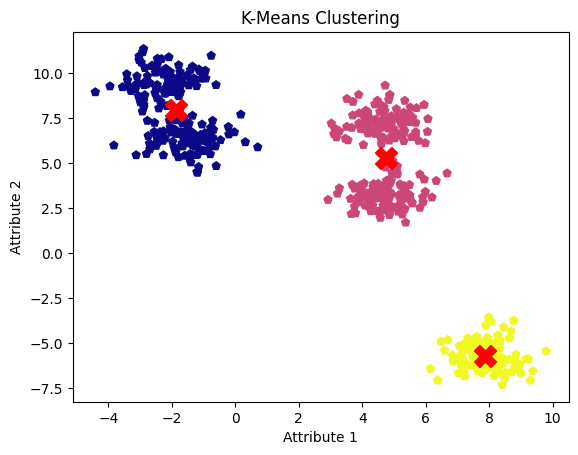
k-means 聚类结果。图片作者自制
k-means 聚类算法的缺点在于需要预先指定簇的数量,这可能导致将相邻簇合并为一类。而经过良好调参的均值漂移聚类模型成功识别出了全部五个簇及其中心。
真实世界的用例
除了图像处理中的目标识别外,均值漂移聚类还应用于多个领域的诸多实际场景:
- 在生物信息学中,它支持基因表达分析和蛋白质结构预测。
- 地理空间分析师利用它进行地理聚类和空间数据中的异常检测。
- 在医学影像中,它用于检测 MRI 与 CT 扫描中的肿瘤,以及进行组织分类。
- 金融行业使用它进行市场细分与欺诈检测。
- 此外,在自然语言处理(NLP)中,它被用于文档聚类和情感分析。
结论
在本文中,我们了解了均值漂移聚类如何在无需预设簇数量的情况下,适应不同的簇形状与大小。
借助这些洞见与实践实现,您已可以在项目中进行尝试。Python 是最受欢迎的编程语言,值得深入学习。您可以参考此Python 开发者职业路径,进一步提升您的 Python 编程技能。也欢迎查看我们的完整Python 机器学习科学家职业路径,向专家学习。

我是一名 AI 策略与伦理专家,致力于在数据科学、产品与工程的交汇处构建可扩展的机器学习系统。曾入选全球“200 位顶尖商业与技术创新者”之一,我的使命是让机器学习走向大众,打破术语壁垒,让每个人都能参与这场变革。
常见问题
什么是均值漂移聚类?
均值漂移聚类是一种非参数算法,通过迭代地将点向数据密度更高的区域移动来识别数据中的簇。它灵活且无需预先设定簇的数量。
均值漂移聚类与 k-means 有何不同?
与需要提前指定簇数量的 k-means 不同,均值漂移聚类基于数据密度自动识别簇的数量,更能适应不同形状的簇。
均值漂移聚类有哪些真实应用?
均值漂移聚类用于图像分割、视频分析中的目标跟踪、营销中的客户分群;在生物信息学、医学影像和金融等领域也用于异常检测与欺诈检测等任务。
如何在均值漂移聚类中选择带宽参数?
可通过 Scott 法则、Silverman 法则、交叉验证或专家知识来选择影响聚类结果的带宽参数。对于密度变化的数据集,还可使用自适应带宽。
在 Python 中实现均值漂移聚类的关键步骤是什么?
在 Python 中实现均值漂移聚类的关键步骤包括:估计带宽、初始化 MeanShift 对象、在数据上进行拟合并可视化结果。您也可以调节带宽参数以获得最佳聚类效果。
聚类是一种无监督机器学习技术,用于识别数据中的隐藏结构,帮助企业做出更明智的决策。最常见的聚类应用包括图像分割、客户分群和社交网络分析。
根据算法是否需要预先输入簇的数量或数据分布,聚类可分为两类——参数化与非参数化。 在本文中,我们将详细介绍一种非参数算法——均值漂移聚类算法。我们将讨论其基本原理,探索其在不同行业中的应用,并提供一个Python实现。最后,我们会将其与常用的k-means 聚类技术进行比较。
什么是均值漂移聚类?
均值漂移聚类用于在事先未知簇数量的数据集中识别簇。它通过迭代地将数据点向特征空间中最密集的区域移动来找到簇。这使其在诸如目标识别等应用中尤为有用——它可以基于像素强度和颜色对图像进行分割,也可用于视频序列中的目标跟踪。
作为一种“寻找模态”的算法,它通过找到数据分布中的模态(峰值)来标记簇,本质上突出显示最密集的区域。它通过迭代地将簇中心向数据密度更高的区域移动来实现。步骤如下:
在迭代过程的最后,数据点会围绕数据分布的模态聚集,形成簇。 均值漂移特别灵活,因为它依赖于实际数据分布,而不是假设簇具有预定义的形状,从而能够处理任意形状的簇。
为何使用均值漂移聚类?
均值漂移聚类能够在不对参数(如簇的数量或形状)作出任何假设的情况下揭示数据的底层结构。由于其基于密度、聚焦于高数据密度区域的方法,它对异常值具有鲁棒性,从而确保噪声数据对聚类过程的影响最小。这种鲁棒性使其非常适合真实世界的数据集,这些数据往往包含不规则性和噪声,同时也适用于需要适应性与精确度的应用。
一些均值漂移聚类表现良好的真实场景包括:
图像分割
均值漂移聚类算法可以根据像素强度或颜色将图像分割为不同区域,而无需事先知道分割的数量。由于均值漂移聚类生成的簇可以是任何形状或大小,这种灵活性使其在图像分割任务中非常有效。
使用均值漂移聚类进行图像分割。来源:ResearchGate
此外,包含噪声的图像,尤其是在低光条件下,难以分割。在此类场景中,均值漂移聚类算法能够提供更自然、更准确的分割,这对于医学影像中检测异常组织类型或计算机视觉中可靠的目标检测至关重要。
视频分析中的目标跟踪
得益于其在图像分割中的优势,均值漂移聚类也常用于视频流中的目标跟踪。它能够在目标跨帧移动时动态识别并跟随目标,对于实时跟踪应用非常有效。
目标跟踪中的均值漂移聚类。来源:ResearchGate
通过关注与目标相关的像素或特征的密度,均值漂移可以有效跟踪不同形状和大小的目标,轻松适应运动与外观的变化。
营销中的客户分群
对于企业而言,既不能预设固定的类别数量,又要考虑离群行为的情况下,理解客户分群至关重要。均值漂移聚类可以分析客户行为、购买模式和人口统计数据,在不受群组规模限制的前提下揭示自然分组。
这有助于制定有针对性的营销策略和个性化体验,从而提升客户参与度与留存率。
均值漂移聚类如何工作?
我们先从一个在窗口中估计数据点密度的函数开始,来理解该算法如何工作。
核密度估计(KDE)
它在每次迭代中使用随机变量的概率密度函数来识别数据密度更高的区域。KDE 的公式为:
其中 h 为带宽参数,常用高斯核。 核函数 k 会平滑每个数据点的贡献,确保距离 x 更近的点对密度估计的影响更大。
选择合适的带宽
带宽参数 h 决定了每个数据点周围邻域的大小,直接影响聚类结果。以下是选择带宽的方法:
Scott 法则
Scott 法则是一种启发式方法,为带宽选择提供经验法则。它在密度估计中的偏差和方差之间取得平衡,是许多应用的良好起点。
其中:
Silverman 法则
与 Scott 法则类似,Silverman 法则提供了另一种带宽选择的启发式方法,特别适用于单峰分布。
交叉验证
通过在留出数据集上评估不同带宽值的表现,我们可以选择使误差最小、聚类效果最佳的带宽值。
专家知识
在特定应用(如图像处理)中,专家知识可为带宽选择提供宝贵见解。专家可能了解图像中典型特征的尺度,从而选择合适的带宽范围,并通过经验测试进行微调。
自适应带宽
对于密度变化较大的数据集,自适应带宽十分有用。它在数据的不同区域应用不同的带宽。方法是先给出全局带宽估计,再根据该区域数据点的密度进行局部调整。
均值漂移向量
均值漂移向量表示将簇中心估计从低密度区域移动到高密度区域所需的位移大小和方向。
对于数据点 xi,均值漂移向量 m(xi) 的计算如下:
其中 N(xi) 表示由带宽定义的 xi 的邻域。
收敛
当簇中心的移动不再超过指定阈值,且算法已识别出密度函数的模态(簇围绕其形成)时,均值漂移聚类算法即收敛。算法会在以下步骤中迭代,直至收敛:
收敛表明数据点已在密度函数的局部极大值附近稳定,随后这些位置作为簇中心。