Le clustering est une technique d’apprentissage automatique non supervisé qui met au jour des structures cachées dans les données afin d’aider les entreprises à prendre de meilleures décisions. Parmi les usages les plus courants figurent la segmentation d’images, la segmentation client et l’analyse de réseaux sociaux.
Selon que l’algorithme exige ou non en entrée un nombre prédéfini de clusters ou une hypothèse sur la distribution des données, on distingue deux familles : paramétrique et non paramétrique. Dans cet article, nous allons détailler un algorithme non paramétrique : le mean shift. Nous en présenterons les principes, ses applications sectorielles et une implémentation en Python. Enfin, nous le comparerons à la méthode populaire de clustering k-means.
Qu’est-ce que le clustering mean shift ?
Le clustering mean shift permet d’identifier des groupes dans des jeux de données lorsque le nombre de clusters n’est pas connu à l’avance. Il détecte les clusters en déplaçant itérativement les points vers les régions les plus denses de l’espace de caractéristiques. Cela le rend particulièrement utile pour la reconnaissance d’objets, où il segmente des images selon l’intensité et la couleur des pixels, ainsi que pour le suivi d’objets dans des séquences vidéo.
En tant qu’algorithme de recherche de modes, il étiquette les clusters en détectant les modes, ou pics, de la distribution. Autrement dit, il met en évidence les zones les plus denses. Il y parvient en déplaçant itérativement les centres de clusters vers les régions de densité plus élevée. Voici les étapes :
- Initialisation : considérer chaque point de données comme candidat potentiel centre de cluster.
- Estimation de la densité : pour chaque point, définir une fenêtre autour de lui (appelée rayon) puis calculer la moyenne des points contenus dans ce rayon.
- Déplacement : déplacer chaque point vers cette position moyenne. Cette étape le rapproche de la zone de plus forte densité.
- Convergence : répéter les étapes 2 et 3 jusqu’à convergence, c’est‑à‑dire lorsque le déplacement devient inférieur à un seuil prédéfini. Un déplacement négligeable signifie que les points se sont stabilisés autour des maxima locaux de la fonction de densité.
Au terme de ce processus itératif, les points se regroupent autour des modes de la distribution, formant ainsi les clusters. Mean shift est particulièrement flexible car il s’appuie sur la distribution réelle des données sans supposer une forme prédéfinie des clusters, ce qui lui permet de gérer des formes arbitraires.
Pourquoi utiliser le clustering mean shift ?
Mean shift est un outil puissant pour révéler la structure sous-jacente des données sans faire d’hypothèses sur des paramètres comme le nombre ou la forme des clusters. Grâce à son approche basée sur la densité, centrée sur les régions de forte concentration, il est robuste aux valeurs aberrantes, ce qui limite l’impact du bruit sur le regroupement. Cette robustesse en fait un excellent choix pour les jeux de données réels, souvent irréguliers et bruités, ainsi que pour des cas d’usage exigeant adaptabilité et précision.
Parmi les situations concrètes où mean shift fonctionne particulièrement bien :
Segmentation d’images
L’algorithme mean shift peut segmenter une image en régions selon l’intensité ou la couleur des pixels, sans connaissance préalable du nombre de segments. Cette flexibilité le rend très efficace : les clusters générés peuvent adopter toute forme ou taille.
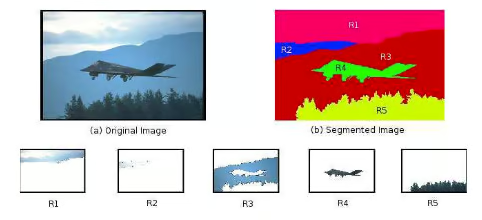
Segmentation d’images avec mean shift. Source : ResearchGate
Par ailleurs, les images bruitées, notamment en faible luminosité, sont difficiles à segmenter. Dans ces cas, mean shift fournit des segmentations plus naturelles et précises — crucial, par exemple, en imagerie médicale pour détecter des tissus anormaux ou en vision par ordinateur pour une détection d’objets fiable.
Suivi d’objets en analyse vidéo
Forte de ses atouts en segmentation, la méthode mean shift est fréquemment utilisée pour le suivi d’objets dans les flux vidéo. Sa capacité à identifier et suivre dynamiquement des objets au fil des images la rend efficace pour le suivi en temps réel.
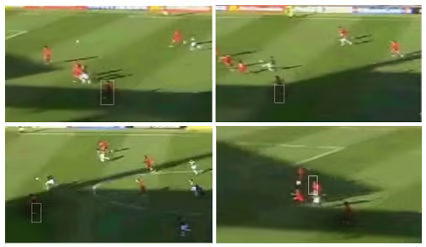
Clustering mean shift pour le suivi d’objets. Source : ResearchGate
En se concentrant sur la densité des pixels ou des caractéristiques associées à l’objet, mean shift suit efficacement des objets de formes et de tailles variées, s’adaptant aisément aux changements de mouvement et d’apparence.
Segmentation client en marketing
Pour les entreprises, il est crucial de comprendre les segments clients sans présupposer un nombre fixe de catégories tout en tenant compte des comportements atypiques. Mean shift peut analyser comportements d’achat, parcours et données démographiques pour révéler des regroupements naturels, quelle que soit leur taille.
Cela permet de concevoir des stratégies marketing ciblées et des expériences personnalisées, améliorant in fine l’engagement et la fidélisation.
Comment fonctionne mean shift ?
Commençons par une fonction qui estime la densité des points dans une fenêtre pour comprendre le fonctionnement de l’algorithme.
Estimation de densité à noyau (KDE)
Elle utilise une fonction de densité de probabilité d’une variable aléatoire pour identifier, à chaque itération, les zones de forte densité. La formule de la KDE est :
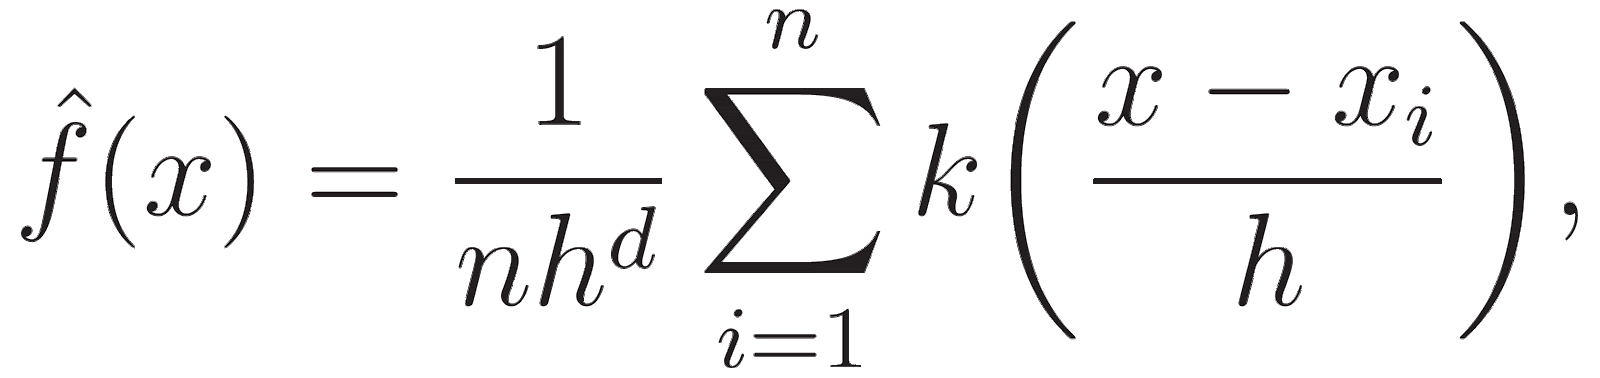
où h est le paramètre de bande passante, et le noyau est le plus souvent gaussien. La fonction noyau k lisse la contribution de chaque point, de sorte que ceux proches de x influencent davantage l’estimation de densité.
Choisir la bonne bande passante
Le paramètre de bande passante h détermine la taille du voisinage autour de chaque point et influe directement sur le résultat du clustering. Voici des méthodes de sélection :
Règle de Scott
La règle de Scott est une heuristique qui propose un ordre de grandeur pour la bande passante. Elle équilibre biais et variance dans l’estimation de densité et constitue un bon point de départ.

où :
- n est le nombre de points.
- d est le nombre de dimensions du jeu de données.
Règle de Silverman
Proche de la règle de Scott, la règle de Silverman est une autre heuristique, particulièrement utile pour des distributions unimodales.
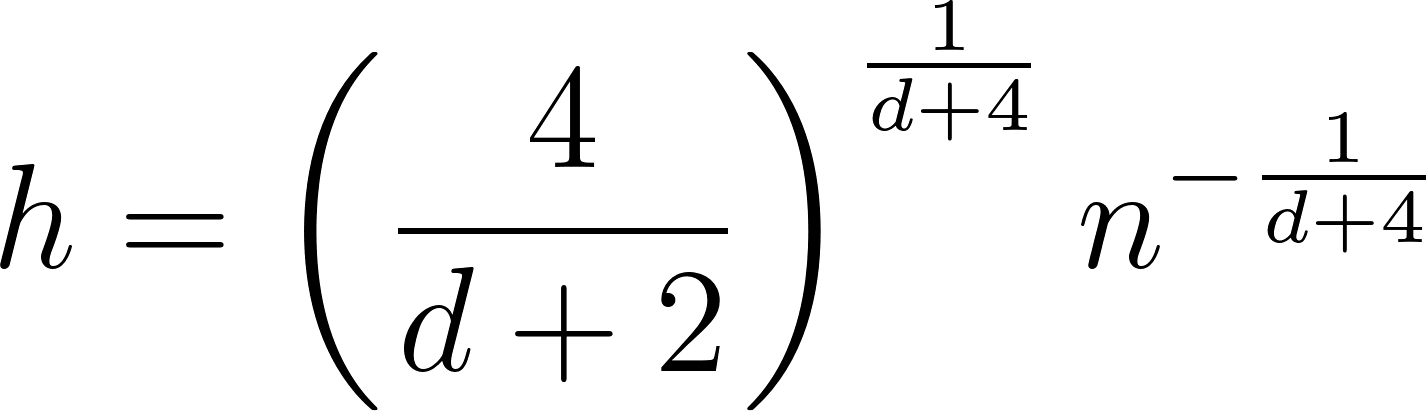
Validation croisée
En évaluant différentes valeurs de bande passante sur des jeux de validation, on retient celle qui minimise l’erreur et offre les meilleurs regroupements.
- Diviser les données en ensembles d’apprentissage et de validation.
- Appliquer mean shift avec différentes bandes passantes sur l’ensemble d’apprentissage.
- Évaluer les performances pour chaque bande passante sur l’ensemble de validation.
- Sélectionner la bande passante qui minimise l’erreur.
Expertise métier
L’avis d’experts est précieux pour choisir une bande passante adaptée, notamment en traitement d’images. Un expert connaissant l’échelle typique des motifs pourra définir une plage optimale puis l’affiner par essais empiriques.
Bande passante adaptative
Utile sur des jeux à densités variables, elle applique des bandes passantes différentes selon les régions. On part d’une estimation globale puis on l’ajuste localement selon la densité.
Vecteur mean shift
Le vecteur mean shift représente l’amplitude et la direction du déplacement nécessaire pour faire passer l’estimation du centre de cluster des zones moins denses vers les régions plus denses.
Pour un point xi, le vecteur m(xi) se calcule comme suit :
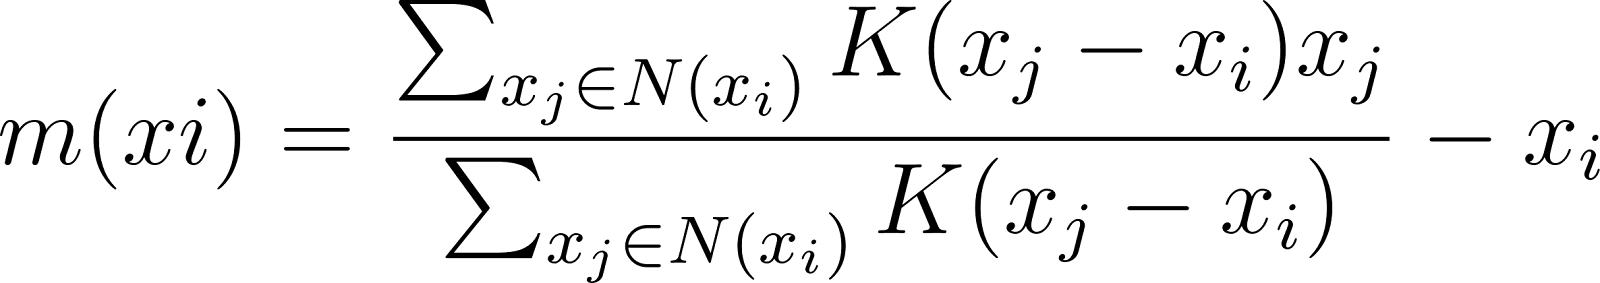
où N(xi) désigne le voisinage de xi défini par la bande passante.
Convergence
L’algorithme converge lorsque les centres de clusters ne se déplacent plus au‑delà d’un seuil donné et que les modes de la fonction de densité, autour desquels se forment les clusters, ont été identifiés. Il itère les étapes suivantes jusqu’à convergence :
- Calculer le vecteur mean shift pour chaque point.
- Déplacer le point vers la moyenne de son voisinage.
- Vérifier la convergence en s’assurant que les déplacements sont inférieurs au seuil prédéfini.
La convergence indique que les points se sont stabilisés autour des maxima locaux de la densité, qui deviennent alors les centres des clusters.
Devenez un scientifique ML
Implémenter mean shift en Python
Passons aux étapes pratiques d’utilisation de mean shift. Nous allons exploiter la classe MeanShift de la bibliothèque sci-kit-learn, disponible nativement pour appliquer cet algorithme à des jeux de données.
Mean shift de base
Commençons par importer les bibliothèques nécessaires.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
Ensuite, générons un jeu de données synthétique de 500 échantillons avec la fonction make_blobs() du module datasets de scikit-learn. Le jeu comprendra cinq centres (clusters) avec un écart type de 0,7.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)
Estimons maintenant la bande passante avec la fonction estimate_bandwidth().
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)
Nous allons utiliser cette valeur pour initialiser l’objet de clustering MeanShift et l’ajuster au jeu de données créé.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_
Visualisons les centres des clusters mean shift sur le jeu initial. Nos cinq clusters apparaissent en différentes couleurs et les centres mean shift sont indiqués par des croix.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()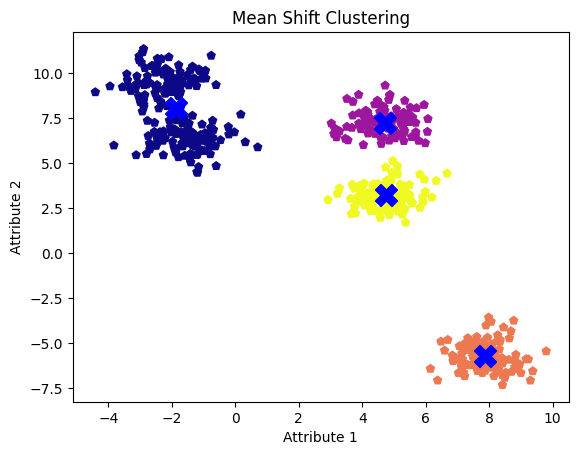
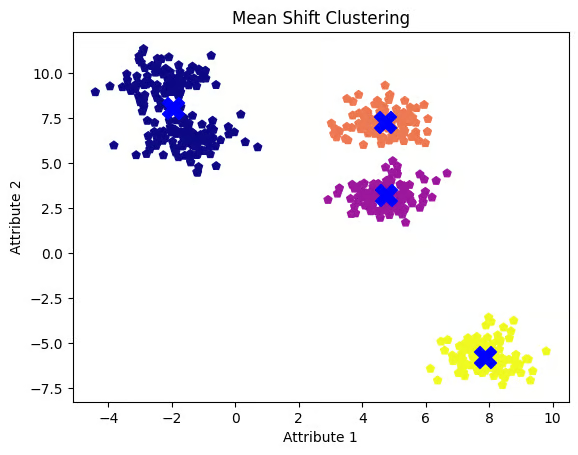
Clusters mean shift avec la bande passante par défaut. Image : auteur
Bien que l’on observe cinq amas (clusters), l’algorithme n’en identifie que quatre en fusionnant deux clusters adjacents.
Ajuster le paramètre de bande passante
Le paramètre bandwidth a un impact majeur sur les résultats. Ajustons‑le pour retrouver nos cinq clusters. Nous allons tester trois valeurs différentes et visualiser les centres obtenus pour chacune.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]

for bw in bandwidth_values:
    ms = MeanShift(bandwidth=bw, bin_seeding=True)
    ms.fit(X)
    labels = ms.labels_
    cluster_centers = ms.cluster_centers_
    print("Bandwidth Value:", bw)
    plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
    plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
    plt.title('mean shift clustering')
    plt.xlabel('Attribute 1')
    plt.ylabel('Attribute 2')
    plt.show()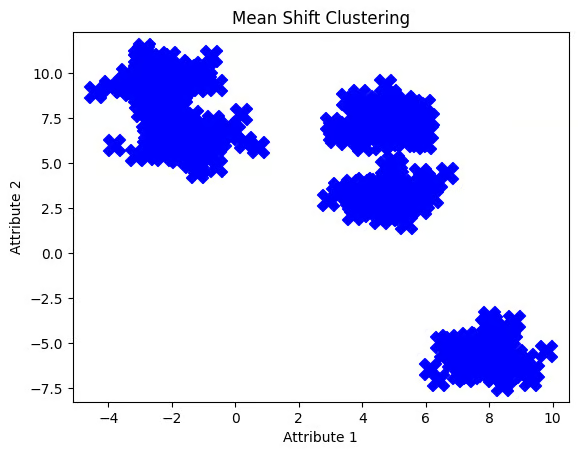
Clusters mean shift avec bande passante 0,1. Image : auteur
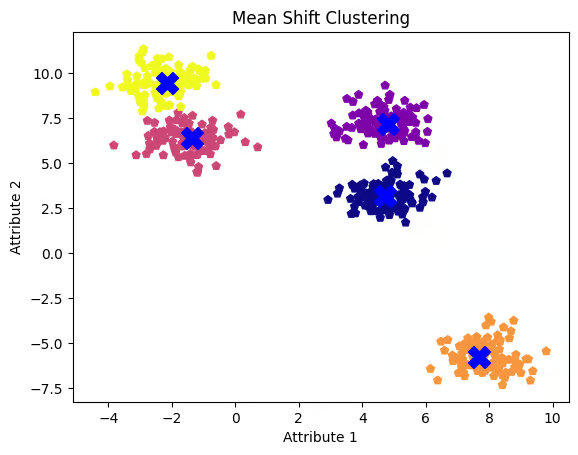
Clusters mean shift avec bande passante 1,0. Image : auteur
Clusters mean shift avec bande passante 2,0. Image : auteur
Une bande passante de 0,1 est trop faible : l’algorithme traite presque chaque point comme un cluster. À l’inverse, 2,0 est trop élevée et ne sépare pas deux clusters vus au départ. La valeur 1,0 s’avère la plus pertinente : elle met clairement en évidence les cinq clusters et leurs centres.
Retenons cette valeur et visualisons à nouveau le résultat.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()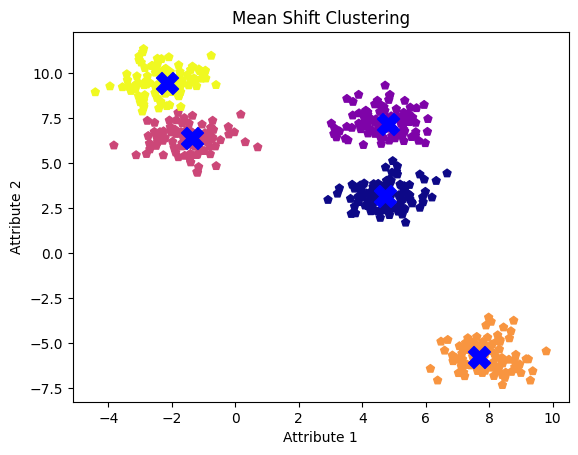
Clusters mean shift avec bande passante 1,0
Comme observé, une bande passante plus faible produit davantage de clusters, tandis qu’une bande plus large peut en fusionner.
Comparer mean shift et k-means
Comparons maintenant mean shift et k-means sur le même jeu de données. Importez d’abord KMeans depuis le module cluster de sklearn. Puis fixons le nombre de clusters à trois et ajustons le modèle pour obtenir les centroïdes.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_
Visualisons ensuite le résultat pour le comparer à mean shift.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()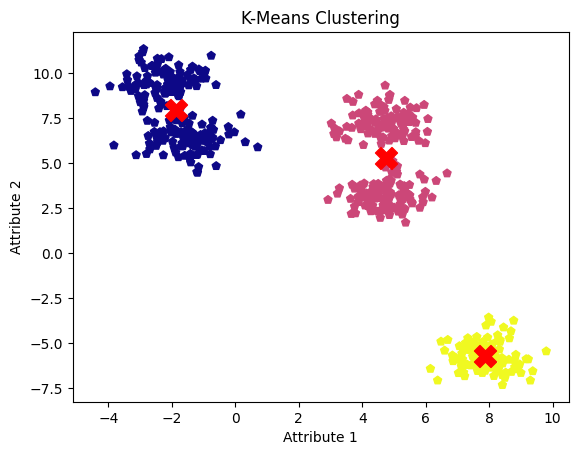
Résultats du clustering k-means. Image : auteur
La limite de k-means est d’exiger la définition préalable du nombre de clusters, ce qui peut conduire à fusionner des groupes adjacents. Un modèle mean shift bien réglé a, lui, identifié avec succès les cinq clusters et leurs centres.
Cas d’usage concrets
Au‑delà de la reconnaissance d’objets en traitement d’images, mean shift est utilisé dans de nombreux domaines :
- En bioinformatique, pour l’analyse d’expression génique et la prédiction de structures protéiques.
- En géospatial, pour le clustering géographique et la détection d’anomalies dans les données spatiales.
- En imagerie médicale, pour détecter des tumeurs sur IRM et scanners, ainsi que pour la classification des tissus.
- Dans la finance, pour la segmentation de marché et la détection de fraudes.
- En traitement automatique du langage (NLP), pour le clustering de documents et l’analyse de sentiments.
Conclusion
Dans cet article, nous avons vu comment mean shift s’adapte à des formes et des tailles de clusters variées, sans nécessiter de nombre prédéfini de groupes.
Avec ces notions et l’implémentation pratique, vous êtes prêt à l’expérimenter dans vos projets. Python est le langage le plus populaire et mérite d’être appris. Pour aller plus loin, suivez le parcours Python Developer pour renforcer vos compétences en programmation Python. Découvrez aussi notre parcours complet Machine Learning Scientist with Python et formez‑vous auprès d’experts.
