

Implementazione del Mean Shift Clustering in Python
È il momento di esplorare i passaggi necessari per usare il mean shift clustering. Useremo la classe MeanShift della popolare libreria sci-kit-learn, disponibile out of the box per applicare questo algoritmo ai dataset.
Mean shift clustering di base
Iniziamo importando le librerie richieste per l’implementazione.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as pltSuccessivamente, genereremo un dataset sintetico di 500 campioni utilizzando la funzione make_blobs() dal modulo datasets di scikit-learn. Il dataset avrà cinque centroidi, cioè cluster, con una deviazione standard del cluster pari a 0,7.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)Stimiamo la larghezza di banda usando la funzione estimate_bandwidth().
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)Ora useremo questo valore di larghezza di banda per inizializzare l’oggetto di clustering MeanShift e adattarlo al dataset creato in precedenza.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_È il momento di visualizzare i centri dei cluster mean shift sul nostro dataset originale. Qui, i nostri cinque cluster sono rappresentati con colori diversi e i centri mean shift sono rappresentati da croci.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()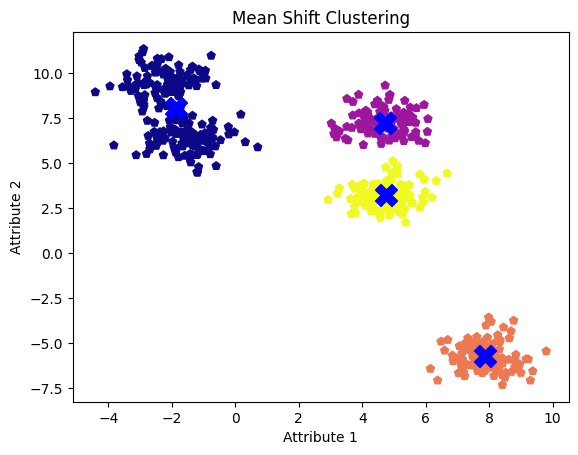
Cluster mean shift con valore di larghezza di banda predefinito. Immagine dell’autrice
Sebbene si osservino cinque blob o cluster, l’algoritmo ne identifica solo quattro, unendo due cluster adiacenti in uno.
Ottimizzare il parametro di larghezza di banda
Il parametro bandwidth ha un impatto significativo sui risultati del clustering. Proviamo a ottimizzarlo per vedere se riusciamo a trovare i cinque cluster. Testeremo tre diversi valori di larghezza di banda e visualizzeremo i centri dei cluster risultanti per ciascuno.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()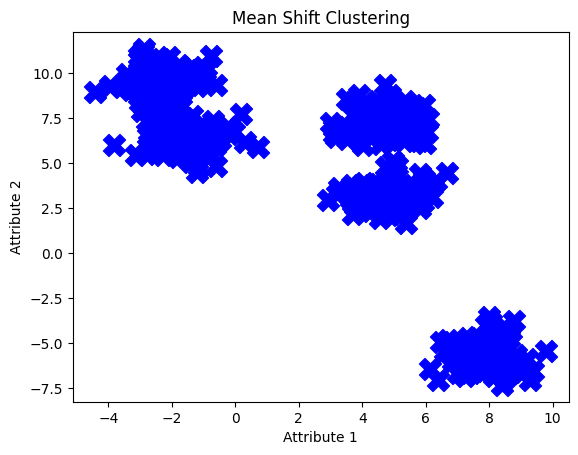
Cluster mean shift con larghezza di banda 0,1. Immagine dell’autrice
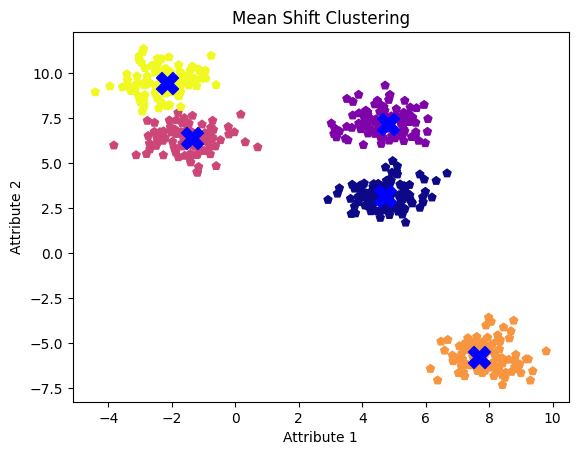
Cluster mean shift con larghezza di banda 1,0. Immagine dell’autrice
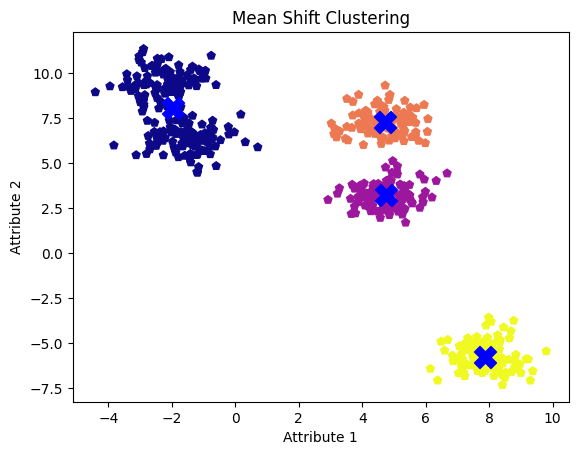
Cluster mean shift con larghezza di banda 2,0. Immagine dell’autrice
Il valore di larghezza di banda 0,1 sembra troppo basso, portando l’algoritmo a trattare ogni punto dati come un cluster separato. D’altra parte, un valore pari a 2,0 appare piuttosto alto, poiché non ha separato i due cluster nel nostro primo tentativo. Un valore di 1,0 si rivela il più ottimale, rivelando chiaramente tutti e cinque i cluster e i rispettivi centri.
Selezioniamo questo valore e visualizziamo nuovamente i risultati.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()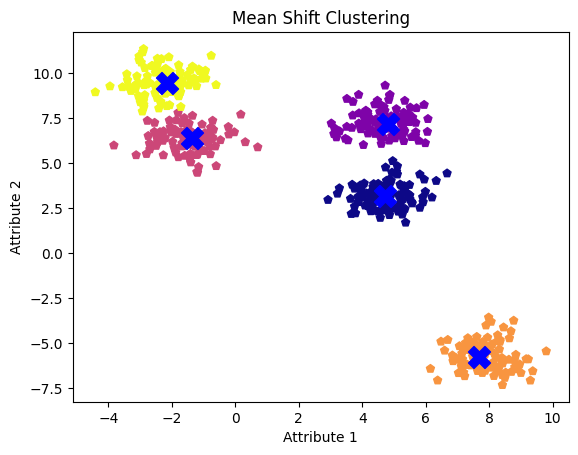
Cluster mean shift con larghezza di banda 1,0
Come osservato, una larghezza di banda più piccola tende a produrre più cluster, mentre una più grande può portare alla fusione dei cluster.
Confronto tra mean shift e k-means
Confrontiamo i risultati di mean shift e k-means sullo stesso dataset. Per prima cosa, importa KMeans dal modulo cluster di sklearn. Poi imposteremo il numero di cluster a tre e adatteremo il modello per ottenere i centroidi.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_Ora visualizziamo i risultati per confrontarli con quelli del mean shift clustering.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()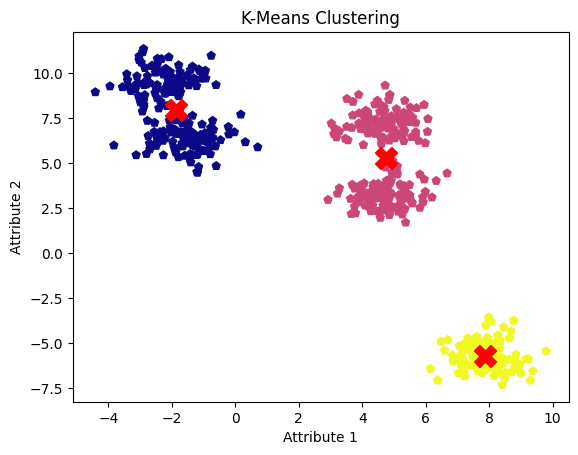
Risultati del clustering k-means. Immagine dell’autrice
Lo svantaggio dell’algoritmo k-means è che richiede di specificare in anticipo il numero di cluster, il che può portare a unire cluster adiacenti in uno solo. Tuttavia, un modello mean shift ben ottimizzato ha identificato con successo tutti e cinque i cluster e i relativi centri.
Casi d’uso reali
Oltre al riconoscimento di oggetti nell’elaborazione delle immagini, il mean shift clustering è utilizzato in numerose applicazioni reali in vari domini:
- Supporta l’analisi dell’espressione genica e la previsione della struttura delle proteine in bioinformatica.
- Gli analisti geospaziali lo sfruttano per il clustering geografico e il rilevamento di anomalie nei dati spaziali.
- Nell’imaging medico, è usato per rilevare tumori in scansioni MRI e CT, oltre che per la classificazione dei tessuti.
- Il settore finanziario lo utilizza per la segmentazione del mercato e il rilevamento delle frodi.
- Inoltre, nel natural language processing (NLP), è applicato al clustering di documenti e all’analisi del sentiment.
Conclusione
In questo post abbiamo visto come il mean shift clustering si adatti a forme e dimensioni di cluster variabili, senza bisogno di un numero di cluster predefinito.
Con tutte le nozioni e l’implementazione pratica di questo algoritmo, sei pronto per sperimentarlo nei tuoi progetti. Python è il linguaggio di programmazione più popolare ed è davvero utile da imparare. Puoi fare riferimento a questo career track Python Developer per portare le tue competenze di programmazione in Python al livello successivo. Dai un’occhiata anche al nostro career track completo Machine Learning Scientist with Python e impara dagli esperti.

Sono una stratega ed eticista dell’AI che lavora all’intersezione tra data science, prodotto e ingegneria per creare sistemi di machine learning scalabili. Inserita tra i "Top 200 Business and Technology Innovators" al mondo, ho la missione di democratizzare il machine learning e di eliminare il gergo tecnico affinché tutti possano partecipare a questa trasformazione.
Domande frequenti
Che cos’è il mean shift clustering?
Il mean shift clustering è un algoritmo non parametrico utilizzato per identificare i cluster nei dati spostando iterativamente i punti verso regioni di maggiore densità. È flessibile e non richiede un numero di cluster predefinito.
In che cosa il mean shift clustering differisce da k-means?
A differenza di k-means, che richiede di specificare in anticipo il numero di cluster, il mean shift clustering identifica automaticamente il numero di cluster in base alla densità dei dati, risultando più adattabile a forme di cluster variabili.
Quali sono le applicazioni reali del mean shift clustering?
Il mean shift clustering è usato nella segmentazione di immagini, nel tracciamento di oggetti nell’analisi video, nella segmentazione dei clienti nel marketing e in ambiti come bioinformatica, imaging medico e finanza per attività come rilevamento di anomalie e frodi.
Come si seleziona il parametro di larghezza di banda nel mean shift clustering?
Il parametro di larghezza di banda, che influenza i risultati del clustering, può essere selezionato con metodi come la regola di Scott, la regola di Silverman, la cross-validation o sulla base della conoscenza esperta. Per dataset con densità variabili si può usare anche una larghezza di banda adattiva.
Quali sono i passaggi chiave per implementare il mean shift clustering in Python?
Per implementare il mean shift clustering in Python, stima la larghezza di banda, inizializza l’oggetto MeanShift, adatta il modello ai dati e visualizza i risultati. Puoi anche ottimizzare il parametro di larghezza di banda per ottenere risultati ottimali.




Il clustering è una tecnica di machine learning non supervisionato che identifica strutture nascoste nei dati per aiutare le aziende a prendere decisioni più informate. Alcune delle applicazioni di clustering più comuni sono la segmentazione di immagini, la segmentazione dei clienti e l’analisi delle reti sociali.
In base al fatto che l’algoritmo richieda in input un numero predeterminato di cluster o la distribuzione dei dati, il clustering può essere di due tipi – parametrico e non parametrico. In questo post, vedremo in dettaglio uno di questi algoritmi non parametrici – il mean shift clustering. Ne discuteremo i principi di base, esploreremo le sue applicazioni in vari settori e forniremo un’implementazione in Python. Alla fine, lo confronteremo con la popolare tecnica di k-means clustering.
Che cos’è il Mean Shift Clustering?
Il mean shift clustering viene utilizzato per identificare i cluster in dataset in cui il numero di cluster non è noto in anticipo. Trova i cluster spostando iterativamente i punti dati verso le regioni più dense nello spazio delle caratteristiche. Ciò lo rende particolarmente utile per applicazioni come il riconoscimento di oggetti, dove può segmentare le immagini in base all’intensità e al colore dei pixel, e anche per il tracciamento di oggetti in sequenze video.
Come algoritmo che cerca le mode, etichetta i cluster trovando le mode, o picchi, nella distribuzione dei dati. In sostanza, evidenzia le aree più dense. Lo fa spostando iterativamente i centri dei cluster verso regioni a maggiore densità di dati. Ecco i passaggi:
Al termine di questo processo iterativo, i punti dati si raggruppano attorno alle mode della distribuzione, formando i cluster. Mean shift è particolarmente flessibile perché si basa sulla distribuzione reale dei dati invece di assumere una forma predefinita per i cluster, il che gli consente di gestire cluster di forme arbitrarie.
Perché usare il Mean Shift Clustering?
Il mean shift clustering è uno strumento potente per scoprire la struttura sottostante dei dati senza fare assunzioni sui suoi parametri, come il numero di cluster o la loro forma. Considerando il suo approccio basato sulla densità, che si concentra sulle regioni di alta densità di dati, è robusto nei confronti degli outlier, assicurando che il rumore abbia un impatto minimo sul processo di clustering. Questa robustezza lo rende adatto ai dataset del mondo reale, che spesso contengono irregolarità e rumore, e alle applicazioni che richiedono adattabilità e precisione.
Alcuni scenari reali in cui il mean shift clustering funziona bene sono:
Segmentazione di immagini
L’algoritmo di mean shift clustering può segmentare le immagini in regioni basate sull’intensità o sul colore dei pixel senza richiedere una conoscenza preventiva del numero di segmenti. Questa flessibilità lo rende molto efficace per i compiti di segmentazione di immagini, perché i cluster generati con il mean shift possono assumere qualsiasi forma o dimensione.
Segmentazione di immagini con mean shift clustering. Fonte: ResearchGate
Inoltre, le immagini che contengono rumore, in particolare in condizioni di scarsa illuminazione, sono difficili da segmentare. In tali scenari, l’algoritmo mean shift fornisce una segmentazione più naturale e accurata, fondamentale in applicazioni come l’imaging medico per rilevare tessuti anomali o nella computer vision per un rilevamento affidabile degli oggetti.
Tracciamento di oggetti nell’analisi video
Forte dei suoi vantaggi nella segmentazione di immagini, il mean shift clustering è spesso utilizzato nel tracciamento degli oggetti all’interno di flussi video. La sua capacità di identificare e seguire dinamicamente gli oggetti mentre si muovono tra i frame lo rende piuttosto efficace per applicazioni di tracciamento in tempo reale.
Mean shift clustering nel tracciamento di oggetti. Fonte: ResearchGate
Concentrandosi sulla densità dei pixel o delle caratteristiche associate all’oggetto, il mean shift può tracciare efficacemente oggetti di forme e dimensioni variabili, adattandosi facilmente ai cambiamenti di movimento e aspetto.
Segmentazione dei clienti nel marketing
Per le aziende è importante comprendere i segmenti di clientela senza assumere un numero fisso di categorie e tenendo conto dei comportamenti anomali. Il mean shift clustering può analizzare il comportamento dei clienti, i modelli di acquisto e i dati demografici per scoprire raggruppamenti naturali indipendentemente dalla dimensione del gruppo.
Questo aiuta a creare strategie di marketing mirate e esperienze personalizzate, migliorando alla fine coinvolgimento e fidelizzazione.
Come funziona il Mean Shift Clustering?
Iniziamo con una funzione per stimare la densità dei punti dati in una finestra e capire come funziona questo algoritmo.
Stima della densità tramite kernel (KDE)
Utilizza una funzione di densità di probabilità di una variabile aleatoria per identificare, a ogni iterazione, le aree di maggiore densità di dati. La formula della KDE è:
Dove h è un parametro di larghezza di banda e il kernel è comunemente una Gaussiana. La funzione kernel k smussa il contributo di ciascun punto dati, garantendo che i punti più vicini a x abbiano un’influenza maggiore sulla stima della densità.
Scegliere la giusta larghezza di banda
Il parametro di larghezza di banda h determina la dimensione del vicinato attorno a ciascun punto dati, influenzando direttamente i risultati del clustering. Ecco alcuni metodi per selezionare la larghezza di banda:
Regola di Scott
La regola di Scott è un approccio euristico che fornisce una regola pratica per la selezione della larghezza di banda. Bilancia bias e varianza nella stima della densità, rendendola un buon punto di partenza per molte applicazioni.
dove:
Regola di Silverman
Simile alla regola di Scott, la regola di Silverman offre un altro approccio euristico per la selezione della larghezza di banda, particolarmente utile per distribuzioni unimodali.
Cross-validation
Valutando le prestazioni di diversi valori di larghezza di banda sui dataset di holdout, possiamo scegliere il valore migliore che minimizza l’errore e produce i risultati di clustering migliori.
Conoscenza esperta
La conoscenza esperta può fornire indicazioni preziose nella scelta della larghezza di banda appropriata, soprattutto in applicazioni specifiche come l’elaborazione di immagini. Un esperto può conoscere la scala tipica delle caratteristiche dell’immagine per scegliere l’intervallo ottimale di larghezza di banda e poi perfezionarlo tramite test empirici.
Larghezza di banda adattiva
La larghezza di banda adattiva è utile per dataset con densità variabili. Applica larghezze di banda diverse a regioni diverse dei dati. Parte da una stima globale e poi la regola localmente in base alla densità dei punti dati in quella regione.
Vettore di mean shift
Il vettore di mean shift rappresenta l’entità e la direzione del movimento necessario a spostare la stima del centro del cluster dalle aree a bassa densità verso regioni più dense.
Per un punto dati xi, il vettore di mean shift m(xi) è calcolato come:
dove N(xi) indica il vicinato attorno a xi definito dalla larghezza di banda.
Convergenza
L’algoritmo mean shift converge quando i centri dei cluster non si muovono più oltre una soglia specificata e quando l’algoritmo ha identificato le mode della funzione di densità, attorno alle quali si formano i cluster. L’algoritmo continua a iterare attraverso i seguenti passaggi fino alla convergenza:
La convergenza indica che i punti dati si sono stabilizzati attorno ai massimi locali della funzione di densità, che diventano poi i centri dei cluster.