

Hiện thực Phân Cụm Mean Shift bằng Python
Đến lúc khám phá các bước sử dụng phân cụm mean shift. Chúng ta sẽ dùng lớp MeanShift từ thư viện sci-kit-learn phổ biến, có sẵn để áp dụng thuật toán này cho các tập dữ liệu.
Phân cụm mean shift cơ bản
Bắt đầu bằng cách nhập các thư viện cần thiết cho phần hiện thực.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as pltTiếp theo, chúng ta sẽ tạo một tập dữ liệu tổng hợp gồm 500 mẫu bằng hàm make_blobs() từ module datasets của scikit-learn. Tập dữ liệu sẽ có năm tâm, tức năm cụm, với độ lệch chuẩn cụm là 0.7.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)Hãy ước lượng băng thông bằng hàm estimate_bandwidth().
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)Giờ chúng ta sẽ dùng giá trị băng thông này để khởi tạo đối tượng phân cụm MeanShift và fit nó trên tập dữ liệu vừa tạo.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_Đến lúc trực quan hóa các tâm cụm mean shift trên tập dữ liệu gốc. Ở đây, năm cụm của chúng ta được hiển thị bằng các màu khác nhau, còn các tâm mean shift được biểu diễn bằng dấu cộng chéo.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()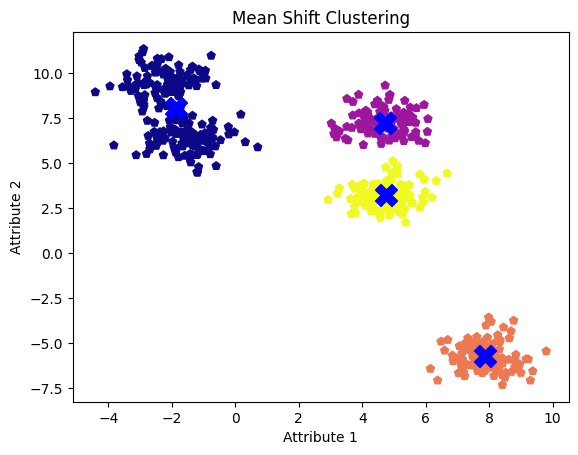
Các cụm mean shift với giá trị băng thông mặc định. Hình minh họa của Tác giả
Mặc dù ta quan sát thấy năm “blob” hay cụm, thuật toán chỉ xác định được bốn do gộp hai cụm liền kề thành một.
Tinh chỉnh tham số băng thông
Tham số bandwidth ảnh hưởng đáng kể tới kết quả phân cụm. Hãy tinh chỉnh nó để xem liệu chúng ta có thể tìm ra năm cụm hay không. Chúng ta sẽ thử ba giá trị băng thông khác nhau và trực quan hóa các tâm cụm thu được cho từng giá trị.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()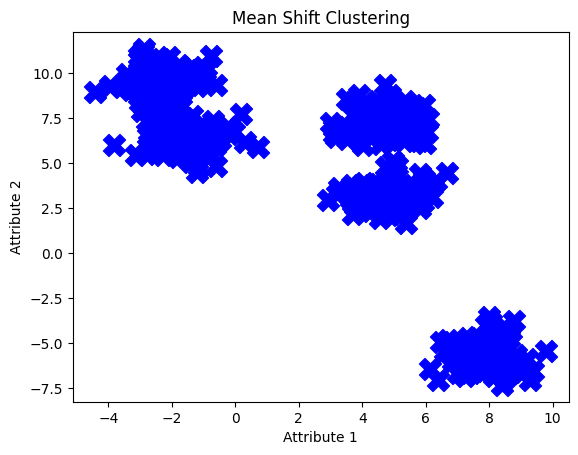
Các cụm mean shift với băng thông 0.1. Hình minh họa của Tác giả
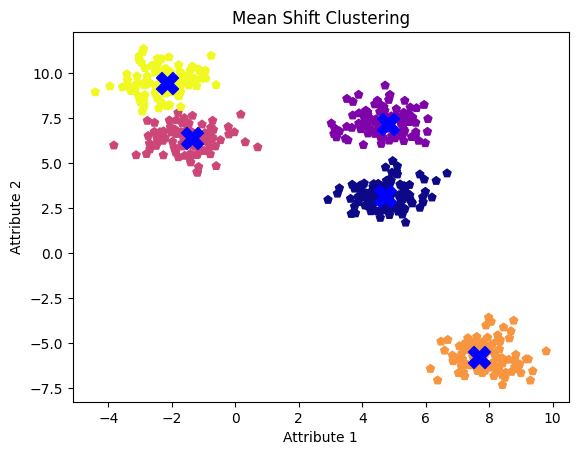
Các cụm mean shift với băng thông 1.0. Hình minh họa của Tác giả
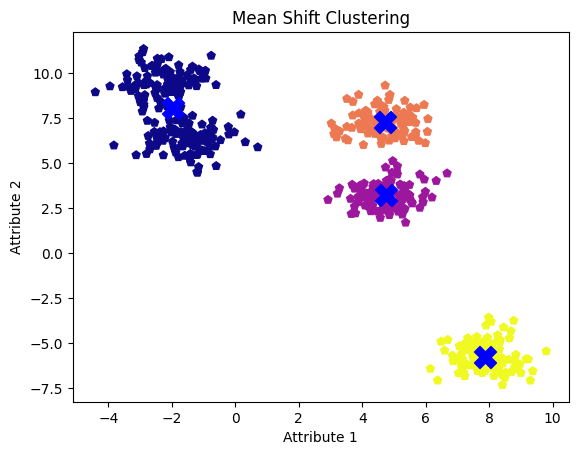
Các cụm mean shift với băng thông 2.0. Hình minh họa của Tác giả
Giá trị băng thông 0.1 có vẻ quá thấp, khiến thuật toán coi mỗi điểm dữ liệu là một cụm riêng. Ngược lại, băng thông 2.0 có vẻ hơi cao, vì nó không tách được hai cụm trong lần thử đầu tiên của chúng ta. Băng thông 1.0 tỏ ra tối ưu nhất, hiển thị rõ ràng cả năm cụm và tâm của chúng.
Hãy chọn giá trị này và trực quan hóa kết quả một lần nữa.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()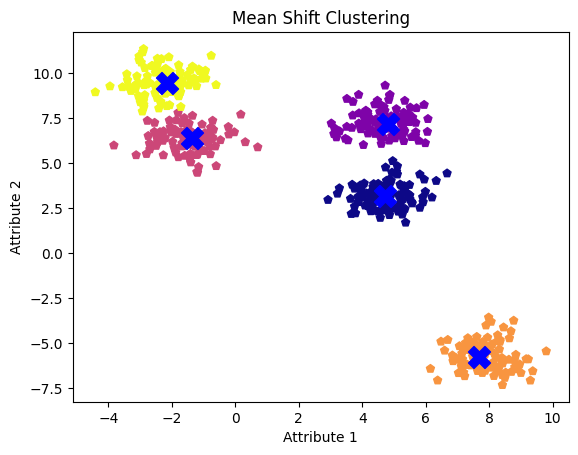
Các cụm mean shift với băng thông 1.0
Như quan sát, băng thông nhỏ có xu hướng tạo ra nhiều cụm hơn, trong khi băng thông lớn có thể dẫn đến gộp cụm.
So sánh mean shift với k-means
Hãy so sánh kết quả của mean shift và k-means trên cùng một tập dữ liệu. Đầu tiên, nhập KMeans từ module cluster của sklearn. Tiếp theo, đặt số cụm là ba và fit mô hình để lấy các centroid của cụm.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_Giờ hãy trực quan hóa kết quả để so sánh với phân cụm mean shift.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()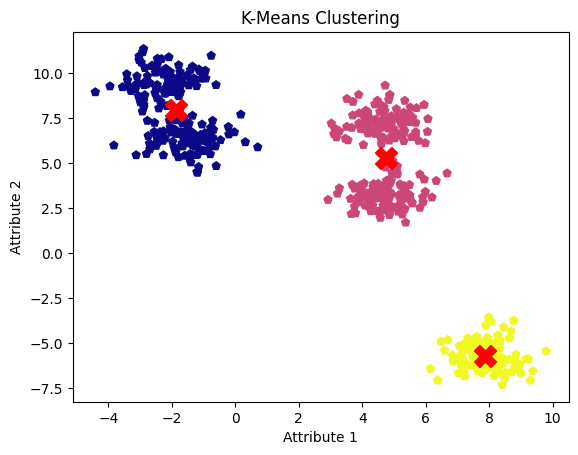
Kết quả phân cụm k-means. Hình minh họa của Tác giả
Hạn chế của k-means là yêu cầu chỉ định trước số lượng cụm, điều này có thể dẫn tới việc gộp các cụm liền kề thành một. Trong khi đó, một mô hình mean shift được tinh chỉnh tốt đã xác định thành công cả năm cụm và tâm của chúng.
Tình Huống Sử Dụng Thực Tế
Ngoài nhận dạng đối tượng trong xử lý ảnh, mean shift còn được dùng trong nhiều ứng dụng thực tế trên nhiều lĩnh vực:
- Hỗ trợ phân tích biểu hiện gen và dự đoán cấu trúc protein trong tin sinh học.
- Các nhà phân tích địa không gian tận dụng nó cho phân cụm địa lý và phát hiện bất thường trong dữ liệu không gian.
- Trong chẩn đoán hình ảnh y khoa, nó được dùng để phát hiện khối u trên ảnh MRI và CT, cũng như phân loại mô.
- Ngành tài chính sử dụng để phân khúc thị trường và phát hiện gian lận.
- Ngoài ra, trong xử lý ngôn ngữ tự nhiên (NLP), nó được áp dụng cho phân cụm tài liệu và phân tích cảm xúc.
Kết luận
Trong bài viết này, chúng ta đã học cách mean shift thích ứng với các hình dạng và kích thước cụm khác nhau mà không cần số lượng cụm xác định trước.
Với những hiểu biết và phần hiện thực thực tiễn của thuật toán này, bạn đã sẵn sàng thử nghiệm nó trong dự án của mình. Python là ngôn ngữ lập trình phổ biến nhất và rất đáng để học. Bạn có thể tham khảo lộ trình nghề nghiệp Python Developer để nâng tầm kỹ năng lập trình Python. Ngoài ra, hãy xem trọn bộ lộ trình Machine Learning Scientist with Python và học hỏi từ các chuyên gia.

Tôi là một Chiến lược gia và Nhà đạo đức học về AI, làm việc tại giao điểm giữa khoa học dữ liệu, sản phẩm và kỹ thuật để xây dựng các hệ thống máy học có khả năng mở rộng. Được xếp hạng trong danh sách “Top 200 Nhà đổi mới trong Kinh doanh và Công nghệ” trên thế giới, tôi theo đuổi sứ mệnh dân chủ hóa máy học và giản lược thuật ngữ chuyên môn để mọi người đều có thể tham gia vào quá trình chuyển đổi này.
Câu hỏi thường gặp
Phân cụm mean shift là gì?
Phân cụm mean shift là một thuật toán phi tham số dùng để nhận diện các cụm trong dữ liệu bằng cách lặp lại việc dịch chuyển các điểm về phía những vùng có mật độ dữ liệu cao hơn. Nó linh hoạt và không cần số lượng cụm xác định trước.
Phân cụm mean shift khác k-means như thế nào?
Không giống k-means, vốn yêu cầu chỉ định trước số lượng cụm, mean shift tự động xác định số cụm dựa trên mật độ dữ liệu, giúp thích ứng tốt hơn với các hình dạng cụm khác nhau.
Những ứng dụng thực tế của phân cụm mean shift là gì?
Mean shift được dùng trong phân đoạn ảnh, theo dõi đối tượng trong phân tích video, phân khúc khách hàng trong marketing, và trong các lĩnh vực như tin sinh học, chẩn đoán hình ảnh y khoa, tài chính cho các tác vụ như phát hiện bất thường và phát hiện gian lận.
Làm thế nào để chọn tham số băng thông trong phân cụm mean shift?
Tham số băng thông, yếu tố ảnh hưởng đến kết quả phân cụm, có thể được chọn bằng các phương pháp như quy tắc Scott, quy tắc Silverman, cross-validation hoặc kiến thức chuyên gia. Băng thông thích nghi cũng có thể dùng cho tập dữ liệu có mật độ biến thiên.
Các bước chính để hiện thực phân cụm mean shift trong Python là gì?
Để hiện thực phân cụm mean shift trong Python, bạn ước lượng băng thông, khởi tạo đối tượng MeanShift, fit với dữ liệu và trực quan hóa kết quả. Bạn cũng có thể tinh chỉnh tham số băng thông để đạt kết quả phân cụm tối ưu.
Phân cụm là một kỹ thuật học máy không giám sát giúp nhận diện các cấu trúc ẩn trong dữ liệu để hỗ trợ doanh nghiệp ra quyết định chính xác hơn. Một số ứng dụng phân cụm phổ biến gồm phân đoạn ảnh, phân khúc khách hàng và phân tích mạng xã hội.
Dựa trên việc thuật toán có yêu cầu đầu vào là số cụm xác định trước hoặc giả định về phân bố dữ liệu hay không, phân cụm được chia thành hai loại – tham số (parametric) và phi tham số (non-parametric). Trong bài viết này, chúng ta sẽ đi sâu vào một thuật toán phi tham số – thuật toán phân cụm mean shift. Chúng ta sẽ thảo luận về các nguyên lý nền tảng, khám phá ứng dụng của nó trong nhiều ngành và cung cấp phần hiện thực bằng Python. Ở phần cuối, chúng ta sẽ so sánh nó với kỹ thuật k-means clustering phổ biến.
Phân Cụm Mean Shift là gì?
Phân cụm mean shift được dùng để nhận diện các cụm trong tập dữ liệu khi số lượng cụm không được biết trước. Nó tìm các cụm bằng cách lặp lại việc dịch chuyển các điểm dữ liệu về phía những vùng dày đặc nhất trong không gian đặc trưng. Điều này đặc biệt hữu ích cho các ứng dụng như nhận dạng đối tượng, nơi nó có thể phân đoạn ảnh dựa trên cường độ điểm ảnh và màu sắc, cũng như theo dõi đối tượng trong chuỗi video.
Là một thuật toán tìm mode (điểm cực đại cục bộ), nó gán nhãn các cụm bằng cách tìm các mode, hay các đỉnh, trong phân bố dữ liệu. Về bản chất, nó làm nổi bật những vùng dày đặc nhất. Nó thực hiện điều đó bằng cách lặp lại việc dịch chuyển tâm cụm về những vùng có mật độ dữ liệu cao hơn. Các bước như sau:
Kết thúc quá trình lặp, các điểm dữ liệu sẽ tụ lại xung quanh các mode của phân bố dữ liệu, hình thành nên các cụm. Mean shift đặc biệt linh hoạt vì nó dựa trên phân bố dữ liệu thực tế thay vì giả định hình dạng cụm định trước, cho phép xử lý các cụm có hình dạng bất kỳ.
Vì sao nên dùng Phân Cụm Mean Shift?
Phân cụm mean shift là công cụ mạnh để khám phá cấu trúc nền của dữ liệu mà không cần giả định về các tham số như số lượng cụm hay hình dạng của chúng. Với cách tiếp cận dựa trên mật độ, tập trung vào các vùng có mật độ dữ liệu cao, nó khá bền vững trước các ngoại lệ, nhờ đó dữ liệu nhiễu có tác động tối thiểu tới quá trình phân cụm. Sự bền vững này rất phù hợp với các tập dữ liệu thực tế, vốn thường chứa bất thường và nhiễu, cũng như với các ứng dụng đòi hỏi khả năng thích ứng và độ chính xác.
Một số kịch bản thực tế nơi mean shift hoạt động hiệu quả bao gồm:
Phân đoạn ảnh
Thuật toán phân cụm mean shift có thể phân đoạn ảnh thành các vùng dựa trên cường độ điểm ảnh hoặc màu sắc mà không cần biết trước số lượng vùng. Tính linh hoạt này khiến nó rất hiệu quả cho bài toán phân đoạn ảnh vì các cụm tạo ra bằng mean shift có thể có bất kỳ hình dạng hay kích thước nào.
Phân đoạn ảnh bằng mean shift. Nguồn: ResearchGate
Ngoài ra, các ảnh chứa nhiễu, đặc biệt trong điều kiện thiếu sáng, rất khó phân đoạn. Trong những trường hợp như vậy, thuật toán mean shift mang lại phân đoạn tự nhiên và chính xác hơn, điều này thiết yếu trong các ứng dụng như chẩn đoán hình ảnh y khoa để phát hiện mô bất thường hoặc trong thị giác máy tính để phát hiện đối tượng tin cậy.
Theo dõi đối tượng trong phân tích video
Phát huy ưu điểm trong phân đoạn ảnh, mean shift thường được dùng để theo dõi đối tượng trong luồng video. Khả năng nhận diện và bám theo đối tượng khi chúng di chuyển qua các khung hình giúp nó hiệu quả cho các ứng dụng theo dõi thời gian thực.
Mean shift trong bài toán theo dõi đối tượng. Nguồn: ResearchGate
Bằng cách tập trung vào mật độ các điểm ảnh hoặc đặc trưng gắn với đối tượng, mean shift có thể theo dõi hiệu quả các đối tượng với hình dạng và kích thước khác nhau, dễ dàng thích ứng với thay đổi chuyển động và diện mạo.
Phân khúc khách hàng trong marketing
Với doanh nghiệp, việc hiểu các phân khúc khách hàng mà không giả định số lượng nhóm cố định, đồng thời tính đến hành vi ngoại lệ, là rất quan trọng. Mean shift có thể phân tích hành vi khách hàng, mẫu mua sắm và dữ liệu nhân khẩu học để phát hiện các nhóm tự nhiên bất kể kích thước nhóm.
Điều này giúp xây dựng chiến lược tiếp thị nhắm mục tiêu và trải nghiệm cá nhân hóa, từ đó nâng cao mức độ gắn kết và giữ chân khách hàng.
Mean Shift hoạt động như thế nào?
Hãy bắt đầu với một hàm để ước lượng mật độ các điểm dữ liệu trong một cửa sổ và hiểu cách thuật toán này vận hành.
Ước lượng mật độ hạt nhân (KDE)
KDE sử dụng hàm mật độ xác suất của một biến ngẫu nhiên để xác định các vùng có mật độ dữ liệu cao hơn ở mỗi vòng lặp. Công thức KDE là:
Trong đó h là tham số băng thông (bandwidth), và kernel thường là Gaussian. Hàm kernel k làm trơn đóng góp của từng điểm dữ liệu, đảm bảo các điểm gần x có ảnh hưởng lớn hơn đến ước lượng mật độ.
Chọn băng thông phù hợp
Tham số băng thông h xác định kích thước vùng lân cận quanh mỗi điểm dữ liệu, tác động trực tiếp đến kết quả phân cụm. Dưới đây là các phương pháp chọn băng thông:
Quy tắc Scott
Quy tắc Scott là một cách tiếp cận heuristic đưa ra quy tắc “kinh nghiệm” để chọn băng thông. Nó cân bằng độ chệch và phương sai trong ước lượng mật độ, phù hợp làm điểm khởi đầu cho nhiều ứng dụng.
trong đó:
Quy tắc Silverman
Tương tự quy tắc Scott, quy tắc Silverman cung cấp một cách heuristic khác để chọn băng thông, đặc biệt hữu ích cho các phân bố đơn đỉnh.
Cross-validation
Bằng cách đánh giá hiệu năng của các giá trị băng thông khác nhau trên tập giữ lại, ta có thể chọn giá trị băng thông tốt nhất giúp tối thiểu hóa lỗi và cho kết quả phân cụm tối ưu.
Kiến thức chuyên gia
Kiến thức chuyên gia có thể mang lại góc nhìn hữu ích khi chọn băng thông phù hợp, đặc biệt trong các ứng dụng cụ thể như xử lý ảnh. Chuyên gia có thể hiểu được thang đo điển hình của các đặc trưng trong ảnh để chọn dải băng thông tối ưu, rồi tinh chỉnh dải này thông qua thử nghiệm thực nghiệm.
Băng thông thích nghi
Băng thông thích nghi hữu ích cho các tập dữ liệu có mật độ biến thiên. Nó áp dụng băng thông khác nhau cho các vùng dữ liệu khác nhau. Bắt đầu với ước lượng băng thông toàn cục rồi điều chỉnh cục bộ dựa trên mật độ điểm dữ liệu trong vùng đó.
Vector mean shift
Vector mean shift biểu diễn độ lớn và hướng dịch chuyển cần thiết để dời ước lượng tâm cụm từ vùng mật độ thấp tới vùng mật độ cao hơn.
Với một điểm dữ liệu xi, vector mean shift m(xi) được tính như sau:
trong đó N(xi) biểu thị vùng lân cận quanh xi được xác định bởi băng thông.
Hội tụ
Thuật toán mean shift hội tụ khi các tâm cụm không còn dịch chuyển vượt quá một ngưỡng xác định và khi thuật toán đã nhận diện các mode của hàm mật độ, quanh đó các cụm được hình thành. Thuật toán tiếp tục lặp các bước sau cho tới khi hội tụ:
Hội tụ cho thấy các điểm dữ liệu đã ổn định quanh cực đại cục bộ của hàm mật độ, những điểm này sau đó đóng vai trò là tâm cụm.