

Implementasi Mean Shift Clustering di Python
Saatnya mengeksplorasi langkah-langkah yang terlibat dalam menggunakan mean shift clustering. Kita akan menggunakan kelas MeanShift dari pustaka sci-kit-learn yang populer, yang tersedia langsung untuk menerapkan algoritma ini pada dataset.
Mean shift clustering dasar
Mari mulai dengan mengimpor pustaka yang diperlukan untuk implementasi.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as pltSelanjutnya, kita akan menghasilkan dataset sintetis berisi 500 sampel menggunakan fungsi make_blobs() dari modul datasets milik scikit-learn. Dataset akan memiliki lima pusat, yaitu klaster, dengan deviasi standar klaster 0,7.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)Mari kita estimasi bandwidth menggunakan fungsi estimate_bandwidth().
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)Sekarang, kita akan menggunakan nilai bandwidth ini untuk menginisialisasi objek clustering MeanShift dan menyesuaikannya pada dataset yang kita buat sebelumnya.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_Saatnya memvisualisasikan pusat klaster mean shift pada dataset asli kita. Di sini, lima klaster kita direpresentasikan dalam warna berbeda dengan pusat mean shift ditandai dengan tanda silang.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()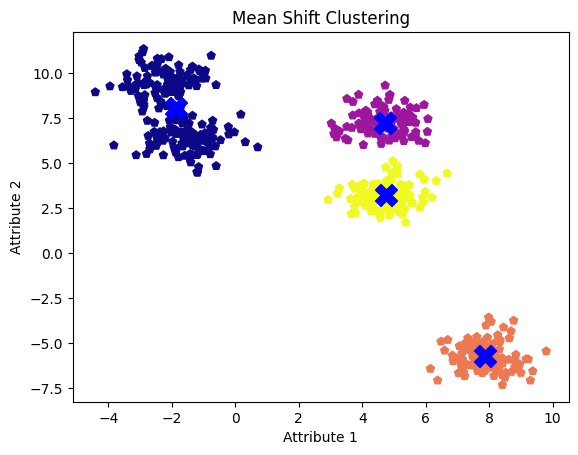
Klaster mean shift dengan nilai bandwidth bawaan. Gambar oleh Penulis
Meskipun kita melihat lima gumpalan atau klaster, algoritma hanya mengidentifikasi empat dengan menggabungkan dua klaster yang berdekatan menjadi satu.
Penyetelan parameter bandwidth
Parameter bandwidth berdampak signifikan pada hasil clustering. Mari kita setel untuk melihat apakah kita dapat menemukan lima klaster. Kita akan menguji tiga nilai bandwidth yang berbeda dan memvisualisasikan pusat klaster yang dihasilkan untuk masing-masing.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()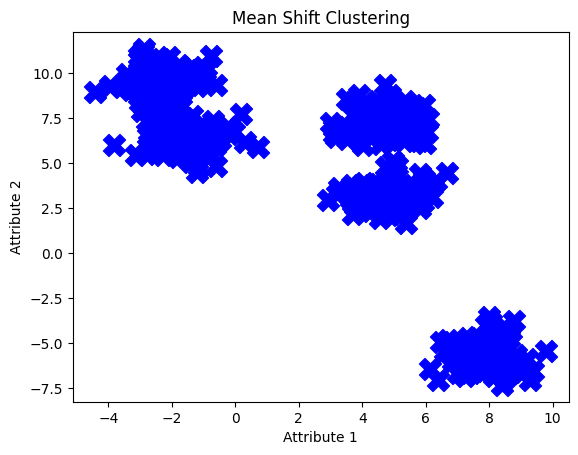
Klaster mean shift dengan nilai bandwidth 0,1. Gambar oleh Penulis
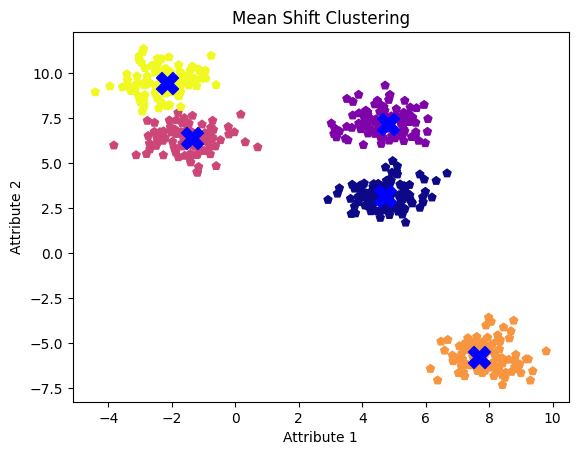
Klaster mean shift dengan nilai bandwidth 1,0. Gambar oleh Penulis
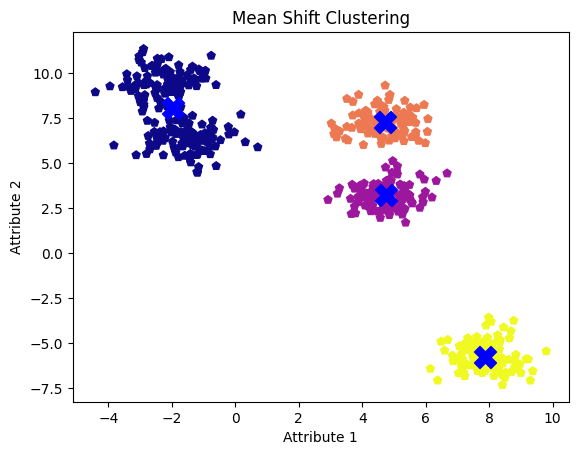
Klaster mean shift dengan nilai bandwidth 2,0. Gambar oleh Penulis
Nilai bandwidth 0,1 tampaknya terlalu rendah, sehingga algoritma memperlakukan setiap titik data sebagai klaster terpisah. Di sisi lain, nilai bandwidth 2,0 tampak agak tinggi, karena tidak memisahkan dua klaster pada percobaan pertama kita. Nilai bandwidth 1,0 terbukti paling optimal, dengan jelas menampilkan semua lima klaster beserta pusatnya.
Mari pilih nilai ini dan visualisasikan hasilnya sekali lagi.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()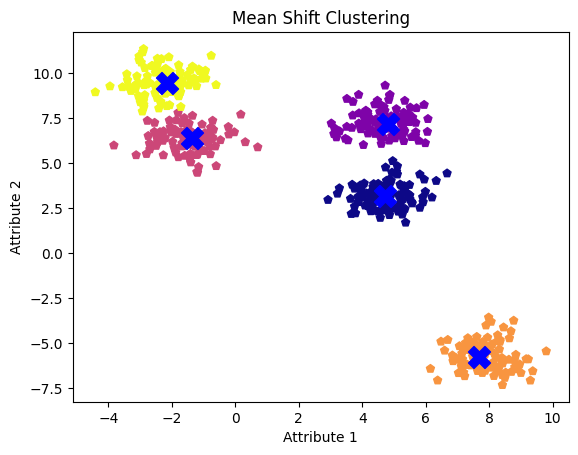
Klaster mean shift dengan nilai bandwidth 1,0
Seperti terlihat, bandwidth yang lebih kecil cenderung menghasilkan lebih banyak klaster, sementara bandwidth yang lebih besar dapat menyebabkan penggabungan klaster.
Membandingkan mean shift dengan k-means
Mari bandingkan hasil mean shift dan k-means clustering pada dataset yang sama. Pertama, impor KMeans dari modul cluster milik sklearn. Selanjutnya, kita akan menetapkan jumlah klaster menjadi tiga dan melatih model untuk mendapatkan centroid klaster.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_Sekarang, mari visualisasikan hasilnya untuk membandingkannya dengan hasil mean shift clustering.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()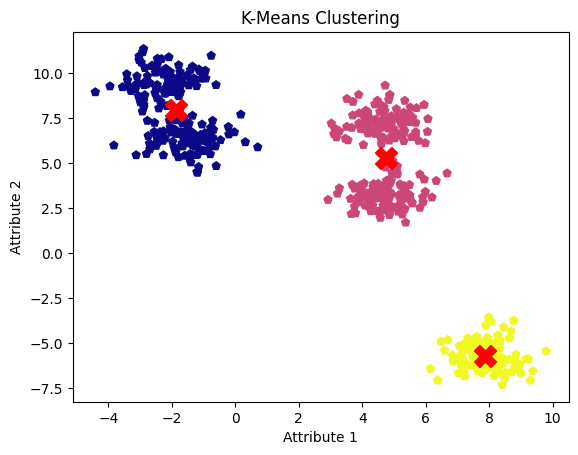
Hasil k-means clustering. Gambar oleh Penulis
Kelemahan algoritma k-means clustering adalah memerlukan penentuan jumlah klaster di awal, yang dapat menyebabkan penggabungan klaster yang berdekatan menjadi satu. Namun, model mean shift clustering yang disetel dengan baik berhasil mengidentifikasi semua lima klaster beserta pusatnya.
Kasus Penggunaan di Dunia Nyata
Selain pengenalan objek dalam pemrosesan citra, mean shift clustering digunakan dalam sejumlah aplikasi dunia nyata di berbagai domain:
- Mendukung analisis ekspresi gen dan prediksi struktur protein dalam bioinformatika.
- Analis geospasial memanfaatkannya untuk clustering geografis dan deteksi anomali dalam data spasial.
- Dalam pencitraan medis, digunakan untuk mendeteksi tumor pada pemindaian MRI dan CT, serta untuk klasifikasi jaringan.
- Sektor keuangan menggunakannya untuk segmentasi pasar dan deteksi penipuan.
- Selain itu, dalam natural language processing (NLP), algoritma ini diterapkan untuk clustering dokumen dan analisis sentimen.
Kesimpulan
Dalam artikel ini, kita mempelajari bagaimana mean shift clustering beradaptasi dengan bentuk dan ukuran klaster yang bervariasi, semuanya tanpa memerlukan jumlah klaster yang sudah ditentukan.
Dengan seluruh wawasan dan implementasi praktis dari algoritma ini, Anda siap untuk bereksperimen dengannya dalam proyek Anda. Python adalah bahasa pemrograman yang paling populer, dan sangat layak untuk dipelajari. Anda dapat merujuk ke jalur karier Python Developer ini untuk meningkatkan keterampilan pemrograman Python Anda. Juga, lihat jalur karier lengkap Machine Learning Scientist with Python, dan belajar dari para ahli.

Saya adalah Penasihat dan Etikus AI yang bekerja di persimpangan ilmu data, produk, dan rekayasa untuk membangun sistem pembelajaran mesin yang dapat diskalakan. Masuk dalam daftar "200 Inovator Bisnis dan Teknologi Teratas" di dunia, saya memiliki misi untuk mendemokratisasi pembelajaran mesin dan menyederhanakan jargon agar semua orang dapat menjadi bagian dari transformasi ini.
Pertanyaan yang Sering Diajukan
Apa itu mean shift clustering?
Mean shift clustering adalah algoritma non-parametrik yang digunakan untuk mengidentifikasi klaster dalam data dengan secara iteratif menggeser titik menuju wilayah dengan kepadatan data yang lebih tinggi. Algoritma ini fleksibel dan tidak memerlukan jumlah klaster yang sudah ditentukan.
Bagaimana perbedaan mean shift clustering dengan k-means?
Berbeda dengan k-means, yang memerlukan penentuan jumlah klaster terlebih dahulu, mean shift clustering secara otomatis mengidentifikasi jumlah klaster berdasarkan kepadatan data, sehingga lebih mudah beradaptasi dengan bentuk klaster yang bervariasi.
Apa saja aplikasi dunia nyata dari mean shift clustering?
Mean shift clustering digunakan dalam segmentasi gambar, pelacakan objek dalam analisis video, segmentasi pelanggan dalam pemasaran, serta di bidang seperti bioinformatika, pencitraan medis, dan keuangan untuk tugas seperti deteksi anomali dan deteksi penipuan.
Bagaimana cara memilih parameter bandwidth dalam mean shift clustering?
Parameter bandwidth, yang memengaruhi hasil clustering, dapat dipilih menggunakan metode seperti aturan Scott, aturan Silverman, cross-validation, atau pengetahuan pakar. Bandwidth adaptif juga dapat digunakan untuk dataset dengan kepadatan yang bervariasi.
Apa saja langkah utama dalam mengimplementasikan mean shift clustering di Python?
Untuk mengimplementasikan mean shift clustering di Python, Anda mengestimasi bandwidth, menginisialisasi objek MeanShift, menyesuaikannya pada data, dan memvisualisasikan hasilnya. Anda juga dapat menyetel parameter bandwidth untuk mencapai hasil clustering yang optimal.




Clustering adalah teknik pembelajaran mesin tanpa pengawasan yang mengidentifikasi struktur tersembunyi dalam data untuk membantu bisnis mengambil keputusan yang lebih tepat. Beberapa penerapan clustering yang paling umum adalah segmentasi gambar, segmentasi pelanggan, dan analisis jejaring sosial.
Bergantung pada apakah algoritma memerlukan masukan berupa jumlah klaster yang sudah ditentukan atau distribusi data, clustering terbagi menjadi dua jenis – parametrik dan non-parametrik. Dalam artikel ini, kita akan membahas secara rinci salah satu algoritma non-parametrik – algoritma mean shift clustering. Kita akan membahas prinsip dasarnya, mengeksplorasi penerapannya di berbagai industri, dan menyediakan implementasi Python. Di bagian akhir, kita akan membandingkannya dengan teknik k-means clustering yang populer.
Apa itu Mean Shift Clustering?
Mean shift clustering digunakan untuk mengidentifikasi klaster dalam dataset ketika jumlah klaster belum diketahui sebelumnya. Algoritma ini menemukan klaster dengan secara iteratif menggeser titik data menuju wilayah terpadat dalam ruang fitur. Hal ini membuatnya sangat berguna untuk aplikasi seperti pengenalan objek, di mana ia dapat melakukan segmentasi gambar berdasarkan intensitas dan warna piksel, serta untuk pelacakan objek dalam rangkaian video.
Sebagai algoritma pencari modus, algoritma ini memberi label pada klaster dengan menemukan modus, atau puncak, dalam distribusi data. Intinya, ia menyoroti area yang paling padat. Ini dilakukan dengan secara iteratif menggeser pusat klaster menuju wilayah dengan kepadatan data yang lebih tinggi. Berikut langkah-langkahnya:
Di akhir proses iteratif ini, titik-titik data mengelompok di sekitar modus distribusi data, membentuk klaster. Mean shift sangat fleksibel karena bergantung pada distribusi data aktual alih-alih mengasumsikan bentuk klaster yang sudah ditentukan, sehingga dapat menangani klaster dengan bentuk apa pun.
Mengapa Menggunakan Mean Shift Clustering?
Mean shift clustering adalah alat yang kuat untuk mengungkap struktur dasar data tanpa membuat asumsi apa pun tentang parameternya seperti jumlah klaster atau bentuknya. Dengan pendekatan berbasis kepadatan yang berfokus pada wilayah dengan kepadatan data tinggi, algoritma ini tangguh terhadap pencilan, sehingga data berisik memiliki dampak minimal pada proses clustering. Ketangguhan seperti ini membuatnya cocok untuk dataset dunia nyata, yang sering kali mengandung ketidakteraturan dan noise, serta untuk aplikasi yang memerlukan kemampuan beradaptasi dan presisi.
Beberapa skenario dunia nyata di mana mean shift clustering bekerja dengan baik adalah:
Segmentasi gambar
Algoritma mean shift clustering dapat membagi gambar menjadi beberapa wilayah berdasarkan intensitas atau warna piksel tanpa memerlukan pengetahuan awal tentang jumlah segmen. Fleksibilitas ini membuatnya sangat efektif untuk tugas segmentasi gambar karena klaster yang dihasilkan menggunakan mean shift clustering dapat memiliki bentuk atau ukuran apa pun.
Segmentasi gambar menggunakan mean shift clustering. Sumber: ResearchGate
Selain itu, gambar yang mengandung noise, khususnya dalam kondisi cahaya rendah, sulit untuk disegmentasi. Untuk skenario seperti ini, algoritma mean shift clustering memberikan segmentasi yang lebih alami dan akurat, yang penting dalam aplikasi seperti pencitraan medis untuk mendeteksi jenis jaringan abnormal atau dalam visi komputer untuk deteksi objek yang andal.
Pelacakan objek dalam analisis video
Sejalan dengan keunggulannya dalam segmentasi gambar, mean shift clustering sering digunakan dalam pelacakan objek di dalam aliran video. Kemampuannya untuk secara dinamis mengidentifikasi dan mengikuti objek saat bergerak antar frame menjadikannya cukup efektif untuk aplikasi pelacakan waktu nyata.
Mean shift clustering dalam pelacakan objek. Sumber: ResearchGate
Dengan berfokus pada kepadatan piksel atau fitur yang terkait dengan objek, mean shift dapat secara efektif melacak objek dengan bentuk dan ukuran yang bervariasi, sehingga mudah beradaptasi terhadap perubahan gerakan dan tampilan.
Segmentasi pelanggan dalam pemasaran
Bagi bisnis, penting untuk memahami segmen pelanggan tanpa mengasumsikan jumlah kategori tetap sekaligus memperhitungkan perilaku pencilan. Mean shift clustering dapat menganalisis perilaku pelanggan, pola pembelian, dan data demografis untuk mengungkap pengelompokan alami terlepas dari ukuran kelompok.
Hal ini membantu menciptakan strategi pemasaran yang tepat sasaran dan pengalaman yang dipersonalisasi, sehingga pada akhirnya meningkatkan keterlibatan dan retensi pelanggan.
Bagaimana Cara Kerja Mean Shift Clustering?
Mari mulai dengan sebuah fungsi untuk memperkirakan kepadatan titik data dalam sebuah jendela dan memahami bagaimana algoritma ini bekerja.
Kernel density estimation (KDE)
Algoritma ini menggunakan fungsi kepadatan peluang dari variabel acak untuk mengidentifikasi area dengan kepadatan data lebih tinggi pada setiap iterasi. Rumus untuk KDE adalah:
Di mana h adalah parameter bandwidth, dan kernel umumnya berupa Gaussian. Fungsi kernel k menghaluskan kontribusi setiap titik data, memastikan titik yang lebih dekat ke x memiliki pengaruh lebih besar pada estimasi kepadatan.
Memilih bandwidth yang tepat
Parameter bandwidth h menentukan ukuran lingkungan di sekitar setiap titik data, yang secara langsung memengaruhi hasil clustering. Berikut metode untuk memilih bandwidth:
Aturan Scott
Aturan Scott adalah pendekatan heuristik yang memberikan aturan praktis untuk pemilihan bandwidth. Aturan ini menyeimbangkan bias dan varians dalam estimasi kepadatan, sehingga menjadi titik awal yang baik untuk banyak aplikasi.
dengan:
Aturan Silverman
Serupa dengan aturan Scott, aturan Silverman menawarkan pendekatan heuristik lain untuk pemilihan bandwidth yang sangat berguna untuk distribusi unimodal.
Cross-validation
Dengan mengevaluasi kinerja berbagai nilai bandwidth pada dataset holdout, kita dapat memilih nilai bandwidth terbaik yang meminimalkan kesalahan dan menghasilkan hasil clustering terbaik.
Pengetahuan pakar
Pengetahuan pakar dapat memberikan wawasan berharga dalam memilih bandwidth yang tepat, terutama pada aplikasi spesifik seperti pemrosesan citra. Pakar mungkin memahami skala fitur yang umum dalam gambar untuk memilih rentang bandwidth yang optimal dan kemudian menyetelnya melalui pengujian empiris.
Bandwidth adaptif
Bandwidth adaptif berguna untuk dataset dengan kepadatan yang bervariasi. Pendekatan ini menerapkan bandwidth yang berbeda untuk wilayah yang berbeda dari data. Dimulai dengan estimasi bandwidth global lalu disesuaikan secara lokal berdasarkan kepadatan titik data di wilayah tersebut.
Vektor mean shift
Vektor mean shift merepresentasikan besar dan arah pergerakan yang diperlukan untuk menggeser estimasi pusat klaster dari area berkepadatan rendah ke wilayah dengan kepadatan lebih tinggi.
Untuk sebuah titik data xi, vektor mean shift m(xi) dihitung sebagai:
di mana N(xi) menyatakan lingkungan sekitar xi yang didefinisikan oleh bandwidth.
Konvergensi
Algoritma mean shift clustering mencapai konvergensi ketika pusat klaster tidak lagi bergerak melebihi ambang batas tertentu dan ketika algoritma telah mengidentifikasi modus dari fungsi kepadatan, yang di sekelilingnya klaster terbentuk. Algoritma terus beriterasi melalui langkah-langkah berikut hingga konvergen:
Konvergensi menunjukkan bahwa titik data telah stabil di sekitar maksimum lokal dari fungsi kepadatan, yang kemudian berfungsi sebagai pusat klaster.