

Python'da Mean Shift Kümelemesinin Uygulanması
Şimdi mean shift kümelemeyi kullanmanın adımlarını keşfetme zamanı. Bu algoritmayı veri kümelerine uygulamak için, kutudan çıktığı gibi sunulan popüler sci-kit-learn kütüphanesindeki MeanShift sınıfını kullanacağız.
Temel mean shift kümeleme
Uygulama için gerekli kütüphaneleri içe aktararak başlayalım.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as pltArdından, scikit-learn’ün datasets modülündeki make_blobs() fonksiyonunu kullanarak 500 örnekten oluşan sentetik bir veri kümesi oluşturacağız. Veri kümesi beş merkezli, yani kümeli olacak ve küme standart sapması 0,7 olacaktır.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)Bant genişliğini estimate_bandwidth() fonksiyonunu kullanarak tahmin edelim.
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)Şimdi bu bant genişliği değerini MeanShift kümeleme nesnesini başlatmak ve önce oluşturduğumuz veri kümesi üzerinde eğitmek için kullanacağız.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_Şimdi mean shift küme merkezlerini orijinal veri kümemiz üzerinde görselleştirme zamanı. Burada beş kümemiz farklı renklerle, mean shift merkezleri ise çarpılarla gösterilmektedir.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()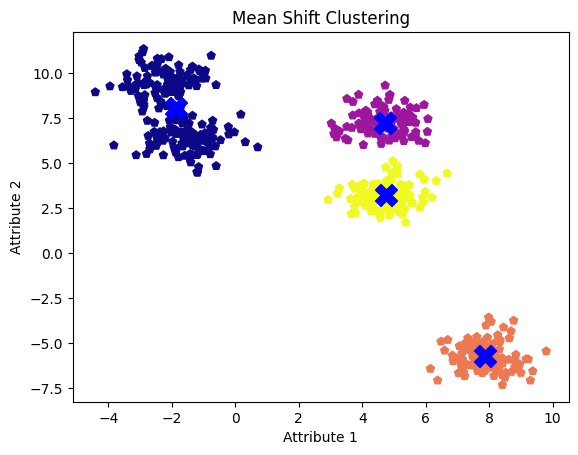
Varsayılan bant genişliği değeriyle mean shift kümeleri. Görsel: Yazar
Beş leke ya da küme gözlemlesek de, algoritma iki bitişik kümeyi birleştirerek yalnızca dördünü tanımladı.
Bant genişliği parametresinin ayarlanması
bandwidth parametresi kümeleme sonuçları üzerinde önemli bir etkiye sahiptir. Beş kümeyi bulup bulamayacağımızı görmek için bunu ayarlayalım. Üç farklı bant genişliği değerini test edecek ve her biri için ortaya çıkan küme merkezlerini görselleştireceğiz.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()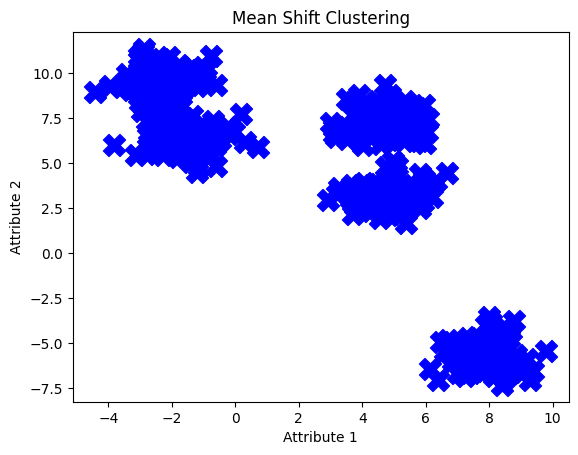
0,1 bant genişliği değeriyle mean shift kümeleri. Görsel: Yazar
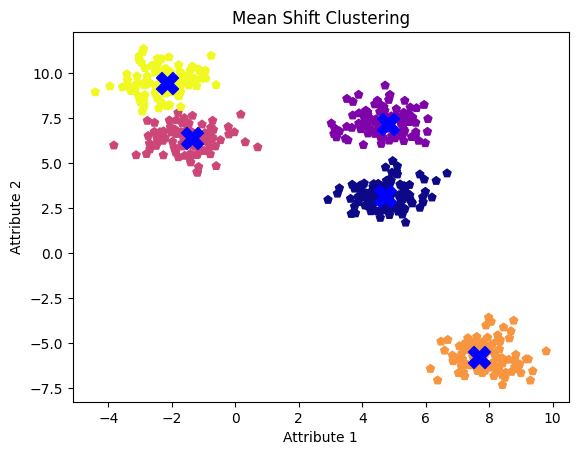
1,0 bant genişliği değeriyle mean shift kümeleri. Görsel: Yazar
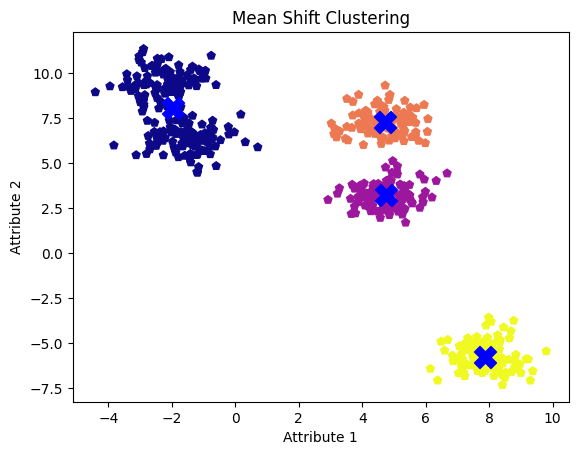
2,0 bant genişliği değeriyle mean shift kümeleri. Görsel: Yazar
0,1 bant genişliği değeri çok düşük görünmekte ve algoritmanın her veri noktasını ayrı bir küme olarak ele almasına neden olmaktadır. Öte yandan 2,0’lık bant genişliği değeri biraz yüksek görünmektedir; ilk denememizdeki iki kümeyi ayıramamıştır. 1,0’lık bant genişliği değeri ise en uygun olanı olup tüm beş kümeyi ve merkezlerini açıkça ortaya koymaktadır.
Bu değeri seçelim ve sonuçları bir kez daha görselleştirelim.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()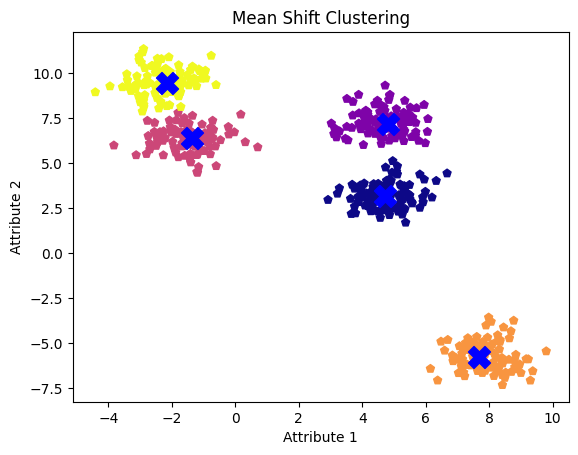
1,0 bant genişliği değeriyle mean shift kümeleri
Gözlemlendiği üzere, daha küçük bir bant genişliği daha fazla küme üretme eğilimindeyken, daha büyük bir bant genişliği kümelerin birleşmesine yol açabilir.
Mean shift ile k-means karşılaştırması
Aynı veri kümesi üzerinde mean shift ve k-means kümelemenin sonuçlarını karşılaştıralım. Önce, sklearn’ün cluster modülünden KMeansi içe aktarın. Ardından küme sayısını üç olarak ayarlayıp modeli eğiterek küme kütle merkezlerini elde edeceğiz.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_Şimdi, sonuçları mean shift kümeleme sonuçlarıyla karşılaştırmak için görselleştirelim.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()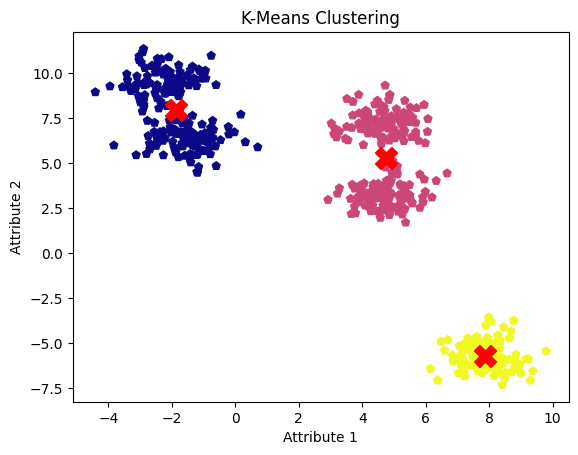
k-means kümeleme sonuçları. Görsel: Yazar
K-means kümeleme algoritmasının dezavantajı, küme sayısını önceden belirtmeyi gerektirmesidir; bu da bitişik kümelerin birleştirilmesine yol açabilir. Buna karşın, iyi ayarlanmış bir mean shift kümeleme modeli tüm beş kümeyi ve merkezlerini başarıyla belirlemiştir.
Gerçek Dünya Kullanım Alanları
Görüntü işlemede nesne tanımanın yanı sıra mean shift kümeleme, bir dizi alandaki pek çok gerçek dünya uygulamasında kullanılır:
- Biyoinformatikte gen ifade analizi ve protein yapı tahminini destekler.
- CBS analistleri, coğrafi kümeleme ve mekânsal veride anomali tespiti için bundan yararlanır.
- Tıbbi görüntülemede, MRI ve BT taramalarında tümör tespiti ve doku sınıflandırması için kullanılır.
- Finans sektörü, pazar segmentasyonu ve sahtecilik tespiti için kullanır.
- Ayrıca, doğal dil işleme (NLP) alanında belge kümeleme ve duygu analizi için uygulanır.
Sonuç
Bu yazıda, mean shift kümelemenin önceden tanımlı bir küme sayısına ihtiyaç duymadan değişen küme şekil ve boyutlarına nasıl uyum sağladığını öğrendik.
Bu algoritmanın tüm içgörüleri ve pratik uygulamasıyla projelerinizde denemeye hazırsınız. Python en popüler programlama dilidir ve öğrenmeye kesinlikle değerdir. Python programlama becerilerinizi bir üst seviyeye taşımak için bu Python Developer kariyer yoluna başvurabilirsiniz. Ayrıca uzmanlardan öğrenmek için tam Machine Learning Scientist with Python kariyer yolumuza da göz atın.

Veri bilimi, ürün ve mühendisliğin kesişiminde çalışarak ölçeklenebilir makine öğrenimi sistemleri geliştiren bir Yapay Zeka Stratejisti ve Etik Uzmanıyım. Dünyadaki "En İyi 200 İş ve Teknoloji Yenilikçisinden" biri olarak listelenmiş bulunuyorum; makine öğrenimini demokratikleştirmek ve bu dönüşümün parçası olabilmeleri için herkes adına jargonu sadeleştirmek misyonuyla çalışıyorum.
Sıkça Sorulan Sorular
Mean shift kümeleme nedir?
Mean shift kümeleme, noktaları yinelemeli olarak daha yüksek veri yoğunluğu bölgelerine kaydırarak verideki kümeleri belirlemek için kullanılan parametrik olmayan bir algoritmadır. Esnektir ve önceden tanımlı bir küme sayısı gerektirmez.
Mean shift kümeleme k-means’ten nasıl farklıdır?
Önceden küme sayısını belirtmeyi gerektiren k-means’in aksine mean shift kümeleme, veri yoğunluğuna dayanarak küme sayısını otomatik olarak belirler; bu da değişen küme şekillerine daha uyarlanabilir olmasını sağlar.
Mean shift kümelemenin gerçek dünya uygulamaları nelerdir?
Mean shift kümeleme; görüntü bölütleme, video analizinde nesne takibi, pazarlamada müşteri segmentasyonu gibi alanlarda ve ayrıca biyoinformatik, tıbbi görüntüleme ve finansta anomali ve sahtecilik tespiti gibi görevlerde kullanılır.
Mean shift kümelemede bant genişliği parametresi nasıl seçilir?
Kümeleme sonuçlarını etkileyen bant genişliği parametresi; Scott kuralı, Silverman kuralı, çapraz doğrulama veya uzman bilgisi gibi yöntemlerle seçilebilir. Değişen yoğunluklara sahip veri kümeleri için uyarlamalı bant genişliği de kullanılabilir.
Python’da mean shift kümelemenin uygulanmasındaki temel adımlar nelerdir?
Python’da mean shift kümeleme uygulamak için bant genişliğini tahmin eder, MeanShift nesnesini başlatır, veriye uydurur ve sonuçları görselleştirirsiniz. Ayrıca en iyi kümeleme sonuçlarına ulaşmak için bant genişliği parametresini ayarlayabilirsiniz.





Kümeleme, veride gizli yapıları ortaya çıkaran ve işletmelerin daha bilinçli kararlar almasına yardımcı olan gözetimsiz bir makine öğrenmesi tekniğidir. En yaygın kümeleme uygulamalarından bazıları görüntü bölütleme, müşteri segmentasyonu ve sosyal ağ analizidir.
Algoritmanın önceden belirlenmiş küme sayısı veya verinin dağılımına ilişkin bir girdi gerektirip gerektirmediğine bağlı olarak kümeleme iki türe ayrılır – parametrik ve parametrik olmayan. Bu yazıda, bu parametrik olmayan algoritmalardan biri olan mean shift kümeleme algoritmasını ayrıntılı olarak ele alacağız. Temel prensiplerini tartışacak, farklı sektörlerdeki kullanım alanlarını inceleyecek ve bir Python uygulaması sunacağız. Sonunda ise popüler k-means kümeleme tekniğiyle karşılaştıracağız.
Mean Shift Kümeleme Nedir?
Mean shift kümeleme, küme sayısının önceden bilinmediği veri kümelerinde kümeleri belirlemek için kullanılır. Özellik uzayındaki en yoğun bölgelere veri noktalarını yinelemeli olarak kaydırarak kümeleri bulur. Bu, özellikle piksel yoğunluğu ve renge göre görüntüleri bölütleyebildiği nesne tanıma gibi uygulamalar ve video dizilerinde nesne takibi için oldukça kullanışlıdır.
Bir tepe-aramalı algoritma olarak, veri dağılımındaki modları ya da zirveleri bularak kümeleri etiketler. Özünde, en yoğun alanları vurgular. Bunu, küme merkezlerini yinelemeli olarak daha yüksek veri yoğunluğuna sahip bölgelere kaydırarak yapar. Adımlar şunlardır:
Bu yinelemeli sürecin sonunda, veri noktaları veri dağılımının modları etrafında kümelenerek kümeleri oluşturur. Mean shift, kümeler için önceden tanımlı bir şekil varsaymak yerine gerçek veri dağılımına dayandığı için özellikle esnektir; bu sayede keyfi şekillerdeki kümeleri de işleyebilir.
Neden Mean Shift Kümeleme Kullanılır?
Mean shift kümeleme, küme sayısı veya şekli gibi parametreleri hakkında herhangi bir varsayımda bulunmadan verinin altında yatan yapıyı ortaya çıkarmak için güçlü bir araçtır. Yüksek veri yoğunluklu bölgelere odaklanan yoğunluk tabanlı yaklaşımı sayesinde aykırı değerlere karşı sağlamdır; böylece gürültülü verinin kümeleme süreci üzerindeki etkisini en aza indirir. Bu tür bir sağlamlık, sıklıkla düzensizlikler ve gürültü içeren gerçek dünya veri kümeleri ve uyarlanabilirlik ile hassasiyet gerektiren uygulamalar için onu uygun kılar.
Mean shift kümelemenin iyi çalıştığı gerçek dünya senaryolarından bazıları şunlardır:
Görüntü bölütleme
Mean shift kümeleme algoritması, segment sayısına dair ön bilgi gerektirmeden piksel yoğunluğu veya renge göre görüntüleri bölgelere ayırabilir. Bu esneklik, mean shift kümelemenin ürettiği kümeler her şekil ve boyutta olabildiği için görüntü bölütleme görevlerinde oldukça etkilidir.
Mean shift kümeleme kullanılarak görüntü bölütleme. Kaynak: ResearchGate
Ayrıca, özellikle düşük ışık koşullarında gürültü içeren görüntüleri bölütlemek zordur. Bu tür durumlarda mean shift kümeleme algoritması, tıbbi görüntülemede anormal doku türlerini tespit etmek veya bilgisayarlı görüde güvenilir nesne tespiti gibi uygulamalar için kritik olan daha doğal ve doğru bir bölütleme sağlar.
Video analizinde nesne takibi
Görüntü bölütlemedeki avantajlarının bir devamı olarak mean shift kümeleme, video akışlarında nesne takibinde sıklıkla kullanılır. Nesneler kareler arasında hareket ederken onları dinamik olarak belirleyip takip edebilmesi, gerçek zamanlı takip uygulamaları için oldukça etkilidir.
Nesne takibinde mean shift kümeleme. Kaynak: ResearchGate
Nesneyle ilişkili piksellerin veya özelliklerin yoğunluğuna odaklanarak mean shift, farklı şekil ve boyutlardaki nesneleri etkili bir şekilde takip edebilir; hareket ve görünümdeki değişimlere kolayca uyum sağlar.
Pazarlamada müşteri segmentasyonu
İşletmeler için, sabit sayıda kategori varsaymadan müşteri segmentlerini anlamak ve aynı zamanda aykırı davranışları hesaba katmak önemlidir. Mean shift kümeleme, müşteri davranışlarını, satın alma kalıplarını ve demografik verileri analiz ederek grup büyüklüğünden bağımsız doğal kümelenmeleri ortaya çıkarabilir.
Bu da hedefli pazarlama stratejileri ve kişiselleştirilmiş deneyimler oluşturmayı kolaylaştırır, sonuçta müşteri etkileşimi ve sadakatini artırır.
Mean Shift Kümeleme Nasıl Çalışır?
Bu algoritmanın nasıl çalıştığını anlamak için bir penceredeki veri noktalarının yoğunluğunu tahmin eden bir işleve başlayalım.
Çekirdek yoğunluk tahmini (KDE)
Her yinelemede daha yüksek veri yoğunluğuna sahip alanları belirlemek için bir rastgele değişkenin olasılık yoğunluk fonksiyonunu kullanır. KDE formülü şöyledir:
Burada h bir bant genişliği parametresidir ve çekirdek genellikle Gauss’tur. Çekirdek fonksiyonu k her bir veri noktasının katkısını yumuşatarak, x’e daha yakın noktaların yoğunluk tahmini üzerindeki etkisinin daha yüksek olmasını sağlar.
Doğru bant genişliğini seçmek
Bant genişliği parametresi h, her veri noktası etrafındaki komşuluğun boyutunu belirler ve kümeleme sonuçlarını doğrudan etkiler. Bant genişliğini seçmek için yöntemler şunlardır:
Scott kuralı
Scott kuralı, bant genişliği seçimi için bir başvuru niteliğinde sezgisel bir yaklaşımdır. Yoğunluk tahminindeki yanlılık ve varyans arasında denge kurar; birçok uygulama için iyi bir başlangıç noktasıdır.
burada:
Silverman kuralı
Scott kuralına benzer şekilde, Silverman kuralı da özellikle tek tepeli dağılımlar için faydalı bir başka sezgisel bant genişliği seçim yaklaşımı sunar.
Çapraz doğrulama
Farklı bant genişliği değerlerinin yedek veri kümeleri üzerindeki performansını değerlendirerek hatayı en aza indiren ve en iyi kümeleme sonuçlarını veren bant genişliği değerini seçebiliriz.
Uzman bilgisi
Özellikle görüntü işleme gibi belirli uygulamalarda, uygun bant genişliğini seçmede uzman bilgisi değerli içgörüler sunabilir. Bir uzman, görüntü içindeki özelliklerin tipik ölçeğini anlayarak optimal bant genişliği aralığını seçebilir ve ardından bu aralığı ampirik testlerle ince ayar yapabilir.
Uyarlamalı bant genişliği
Uyarlamalı bant genişliği, yoğunlukları değişen veri kümeleri için kullanışlıdır. Verinin farklı bölgeleri için farklı bant genişlikleri uygular. Küresel bir bant genişliği tahminiyle başlar ve ardından o bölgedeki veri noktalarının yoğunluğuna göre yerel olarak ayarlar.
Mean shift vektörü
Mean shift vektörü, küme merkezi tahminini daha düşük yoğunluklu alanlardan daha yüksek yoğunluklu bölgelere kaydırmak için gereken hareketin büyüklüğünü ve yönünü temsil eder.
Bir xi veri noktası için mean shift vektörü m(xi) şu şekilde hesaplanır:
burada N(xi), bant genişliğiyle tanımlanan xi etrafındaki komşuluğu gösterir.
Yakınsama
Mean shift kümeleme algoritması, küme merkezleri belirli bir eşiğin ötesinde artık hareket etmediğinde ve algoritma, kümelerin oluştuğu yoğunluk fonksiyonunun modlarını belirlediğinde yakınsar. Algoritma yakınsamaya kadar aşağıdaki adımları yineleyerek devam eder:
Yakınsama, veri noktalarının yoğunluk fonksiyonunun yerel maksimumları etrafında dengelendiğini gösterir; bu noktalar küme merkezleri olarak hizmet eder.