

Python में मीन शिफ्ट क्लस्टरिंग का इम्प्लीमेंटेशन
अब मीन शिफ्ट क्लस्टरिंग का उपयोग करने में शामिल चरणों को एक्सप्लोर करने का समय है। हम लोकप्रिय sci-kit-learn लाइब्रेरी की MeanShift क्लास का उपयोग करेंगे, जो इस एल्गोरिद्म को डेटासेट्स पर लागू करने के लिए तैयार मिलती है।
बेसिक मीन शिफ्ट क्लस्टरिंग
इम्प्लीमेंटेशन के लिए आवश्यक लाइब्रेरीज़ इम्पोर्ट करके शुरू करें।
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as pltअगले चरण में, हम scikit-learn के datasets मॉड्यूल की make_blobs() फंक्शन का उपयोग करके 500 सैंपल्स का एक सिंथेटिक डेटासेट जनरेट करेंगे। इस डेटासेट में पाँच सेंटर्स, यानी क्लस्टर्स, होंगे, और क्लस्टर का स्टैंडर्ड डेविएशन 0.7 होगा।
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)आइए estimate_bandwidth() फंक्शन का उपयोग करके बैंडविड्थ का अनुमान लगाएँ।
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)अब, हम इस बैंडविड्थ संख्या का उपयोग MeanShift क्लस्टरिंग ऑब्जेक्ट को इनिशियलाइज़ करने और इसे पहले बनाए गए डेटासेट पर फिट करने के लिए करेंगे।
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_अब हमारे मूल डेटासेट पर मीन शिफ्ट क्लस्टर सेंटर्स को विज़ुअलाइज़ करने का समय है। यहाँ, हमारे पाँच क्लस्टर्स अलग-अलग रंगों में दर्शाए गए हैं और मीन शिफ्ट सेंटर्स क्रॉस के रूप में दिखाए गए हैं।
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()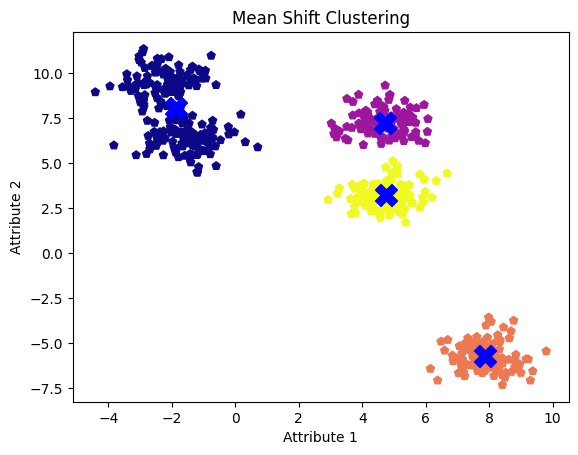
डिफॉल्ट बैंडविड्थ मान के साथ मीन शिफ्ट क्लस्टर्स। इमेज: लेखक द्वारा
हालाँकि हमें पाँच ब्लॉब्स या क्लस्टर्स दिखाई देते हैं, एल्गोरिद्म केवल चार की पहचान करता है और दो सटे हुए क्लस्टर्स को एक में मिला देता है।
बैंडविड्थ पैरामीटर ट्यून करना
bandwidth पैरामीटर का क्लस्टरिंग परिणामों पर महत्वपूर्ण प्रभाव पड़ता है। आइए इसे ट्यून करें और देखें कि क्या हम पाँचों क्लस्टर्स पा सकते हैं। हम तीन अलग-अलग बैंडविड्थ मानों का परीक्षण करेंगे और प्रत्येक के लिए प्राप्त क्लस्टर सेंटर्स को विज़ुअलाइज़ करेंगे।
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]
for bw in bandwidth_values:
ms = MeanShift(bandwidth=bw, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
print("Bandwidth Value:", bw)
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()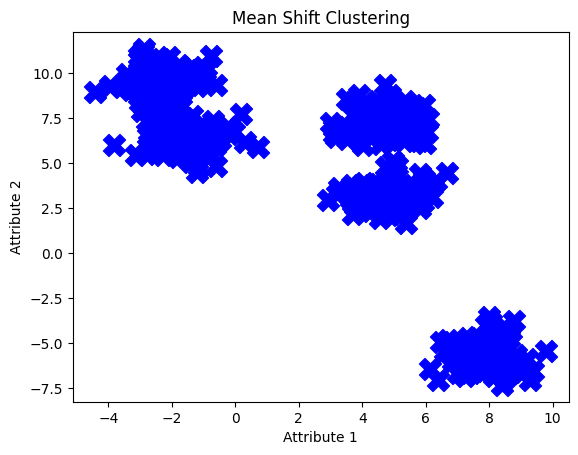
0.1 बैंडविड्थ मान के साथ मीन शिफ्ट क्लस्टर्स। इमेज: लेखक द्वारा
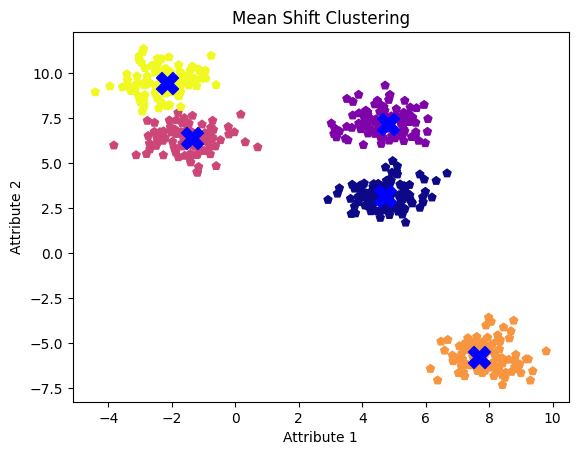
1.0 बैंडविड्थ मान के साथ मीन शिफ्ट क्लस्टर्स। इमेज: लेखक द्वारा
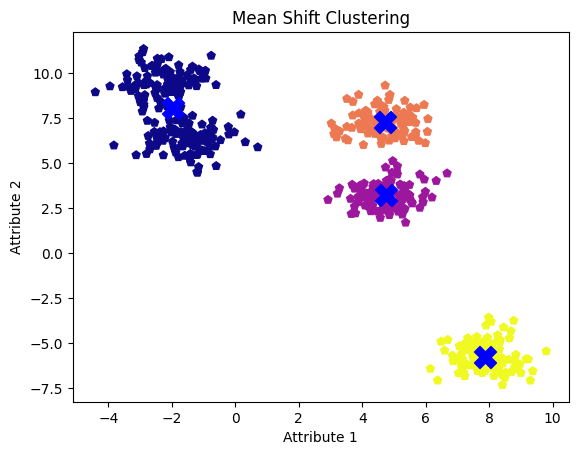
2.0 बैंडविड्थ मान के साथ मीन शिफ्ट क्लस्टर्स। इमेज: लेखक द्वारा
0.1 का बैंडविड्थ मान बहुत कम प्रतीत होता है, जिससे एल्गोरिद्म प्रत्येक डेटा बिंदु को अलग क्लस्टर मान लेता है। दूसरी ओर, 2.0 का बैंडविड्थ कुछ अधिक लगता है, क्योंकि इसने हमारे पहले प्रयास में दो क्लस्टर्स को अलग नहीं किया। 1.0 का बैंडविड्थ सबसे इष्टतम सिद्ध होता है, जो सभी पाँच क्लस्टर्स और उनके सेंटर्स को स्पष्ट रूप से दिखाता है।
आइए इस मान का चयन करें और परिणामों को एक बार फिर विज़ुअलाइज़ करें।
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()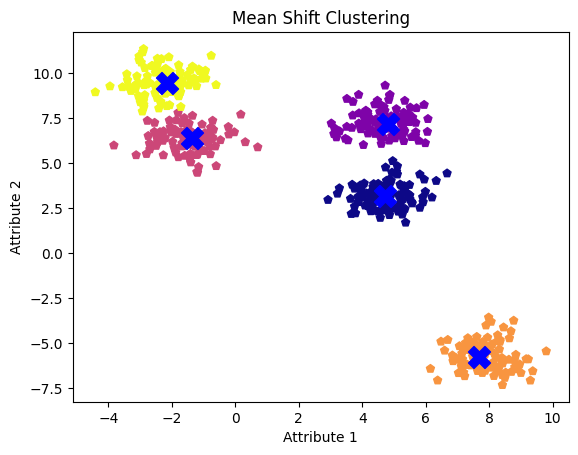
1.0 बैंडविड्थ मान के साथ मीन शिफ्ट क्लस्टर्स
जैसा देखा गया, छोटा बैंडविड्थ अधिक क्लस्टर्स उत्पन्न करने की प्रवृत्ति रखता है, जबकि बड़ा बैंडविड्थ क्लस्टर्स के मर्ज होने का कारण बन सकता है।
मीन शिफ्ट बनाम k-means की तुलना
आइए उसी डेटासेट पर मीन शिफ्ट और k-means क्लस्टरिंग के परिणामों की तुलना करें। पहले, sklearn के cluster मॉड्यूल से KMeans इम्पोर्ट करें। इसके बाद, हम क्लस्टर्स की संख्या तीन सेट करेंगे और मॉडल को फिट करके क्लस्टर सेंट्रॉइड्स प्राप्त करेंगे।
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_अब, परिणामों को विज़ुअलाइज़ करें और इन्हें मीन शिफ्ट क्लस्टरिंग के परिणामों से तुलना करें।
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()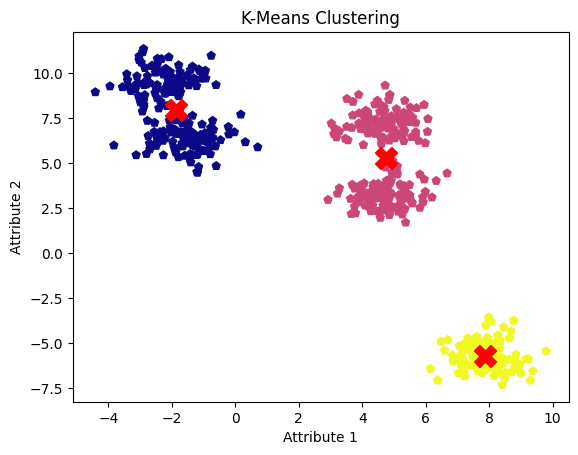
k-means क्लस्टरिंग के परिणाम। इमेज: लेखक द्वारा
k-means क्लस्टरिंग एल्गोरिद्म की कमी यह है कि इसमें क्लस्टर्स की संख्या पहले से बतानी पड़ती है, जो सटे हुए क्लस्टर्स को एक में मिलाने का कारण बन सकती है। हालाँकि, अच्छी तरह ट्यून किया गया मीन शिफ्ट क्लस्टरिंग मॉडल सभी पाँच क्लस्टर्स और उनके सेंटर्स की सफलतापूर्वक पहचान कर लेता है।
वास्तविक दुनिया के उपयोग मामले
इमेज प्रोसेसिंग में ऑब्जेक्ट रिकॉग्निशन के अलावा, मीन शिफ्ट क्लस्टरिंग कई डोमेन्स में वास्तविक दुनिया के अनेक अनुप्रयोगों में उपयोग होती है:
- बायोइन्फॉर्मेटिक्स में यह जीन एक्सप्रेशन विश्लेषण और प्रोटीन संरचना भविष्यवाणी का समर्थन करती है।
- जियोस्पेशियल विश्लेषक इसे भौगोलिक क्लस्टरिंग और स्पेशियल डेटा में एनॉमली डिटेक्शन के लिए उपयोग करते हैं।
- मेडिकल इमेजिंग में, इसका उपयोग MRI और CT स्कैन में ट्यूमर का पता लगाने और टिश्यू क्लासिफिकेशन के लिए किया जाता है।
- वित्त क्षेत्र इसे मार्केट सेगमेंटेशन और फ्रॉड डिटेक्शन के लिए उपयोग करता है।
- इसके अलावा, नेचुरल लैंग्वेज प्रोसेसिंग (NLP) में, इसे डॉक्यूमेंट क्लस्टरिंग और सेंटिमेंट एनालिसिस में लागू किया जाता है।
निष्कर्ष
इस पोस्ट में, हमने देखा कि मीन शिफ्ट क्लस्टरिंग बदलते क्लस्टर आकार और साइज के अनुसार खुद को कैसे अनुकूलित करती है, वह भी बिना पहले से तय क्लस्टर्स की संख्या की आवश्यकता के।
इस एल्गोरिद्म की सभी अंतर्दृष्टियों और व्यावहारिक इम्प्लीमेंटेशन के साथ, आप अपने प्रोजेक्ट्स में इसे आज़माने के लिए तैयार हैं। Python सबसे लोकप्रिय प्रोग्रामिंग भाषा है और सीखने लायक है। आप अपनी Python प्रोग्रामिंग स्किल्स को अगले स्तर पर ले जाने के लिए इस Python Developer करियर ट्रैक का संदर्भ ले सकते हैं। साथ ही, हमारा पूरा Machine Learning Scientist with Python करियर ट्रैक देखें, और विशेषज्ञों से सीखें।

मैं एक एआई रणनीतिकार और नैतिकतावादी हूं, जो डेटा साइंस, प्रोडक्ट और इंजीनियरिंग के संगम पर स्केलेबल मशीन लर्निंग सिस्टम बनाने का काम करता/करती हूं। दुनिया के "टॉप 200 बिज़नेस और टेक्नोलॉजी इनोवेटर्स" में सूचीबद्ध, मेरा लक्ष्य मशीन लर्निंग को सबके लिए सुलभ बनाना और जटिल शब्दावली को सरल करना है, ताकि हर कोई इस परिवर्तन का हिस्सा बन सके।
अक्सर पूछे जाने वाले प्रश्न
मीन शिफ्ट क्लस्टरिंग क्या है?
मीन शिफ्ट क्लस्टरिंग एक नॉन-पैरामीट्रिक एल्गोरिद्म है जो डेटा में उच्च घनत्व वाले क्षेत्रों की ओर बिंदुओं को क्रमिक रूप से शिफ्ट करके क्लस्टर्स की पहचान करता है। यह लचीला है और पहले से तय क्लस्टर्स की संख्या की आवश्यकता नहीं होती।
मीन शिफ्ट क्लस्टरिंग k-means से कैसे भिन्न है?
k-means के विपरीत, जिसमें क्लस्टर्स की संख्या पहले से बतानी पड़ती है, मीन शिफ्ट क्लस्टरिंग डेटा घनत्व के आधार पर स्वचालित रूप से क्लस्टर्स की संख्या पहचानती है, जिससे यह बदलते क्लस्टर आकारों के प्रति अधिक अनुकूल हो जाती है।
मीन शिफ्ट क्लस्टरिंग के वास्तविक दुनिया के अनुप्रयोग क्या हैं?
मीन शिफ्ट क्लस्टरिंग का उपयोग इमेज सेगमेंटेशन, वीडियो विश्लेषण में ऑब्जेक्ट ट्रैकिंग, मार्केटिंग में कस्टमर सेगमेंटेशन, और बायोइन्फॉर्मेटिक्स, मेडिकल इमेजिंग तथा वित्त जैसे क्षेत्रों में एनॉमली डिटेक्शन और फ्रॉड डिटेक्शन जैसे कार्यों के लिए किया जाता है।
मीन शिफ्ट क्लस्टरिंग में बैंडविड्थ पैरामीटर कैसे चुना जाता है?
बैंडविड्थ पैरामीटर, जो क्लस्टरिंग परिणामों को प्रभावित करता है, का चयन Scott का नियम, Silverman का नियम, क्रॉस-वैलिडेशन या विशेषज्ञ ज्ञान जैसी विधियों से किया जा सकता है। विभिन्न घनत्व वाले डेटासेट्स के लिए एडेप्टिव बैंडविड्थ का भी उपयोग किया जा सकता है।
Python में मीन शिफ्ट क्लस्टरिंग इम्प्लीमेंट करने के प्रमुख चरण क्या हैं?
Python में मीन शिफ्ट क्लस्टरिंग को इम्प्लीमेंट करने के लिए, आप बैंडविड्थ का अनुमान लगाते हैं, MeanShift ऑब्जेक्ट इनिशियलाइज़ करते हैं, इसे डेटा पर फिट करते हैं, और परिणामों को विज़ुअलाइज़ करते हैं। आप इष्टतम क्लस्टरिंग परिणाम पाने के लिए बैंडविड्थ पैरामीटर को ट्यून भी कर सकते हैं।
क्लस्टरिंग एक अनसुपरवाइज्ड मशीन लर्निंग तकनीक है जो डेटा में छिपी संरचनाओं की पहचान करती है, ताकि व्यवसाय अधिक सूचित निर्णय ले सकें। क्लस्टरिंग के कुछ सबसे आम अनुप्रयोग हैं इमेज सेगमेंटेशन, कस्टमर सेगमेंटेशन, और सोशल नेटवर्क विश्लेषण।
इस आधार पर कि एल्गोरिद्म को पहले से तय क्लस्टर्स की संख्या या डेटा के वितरण का इनपुट चाहिए या नहीं, क्लस्टरिंग दो प्रकार की होती है – पैरामीट्रिक और नॉन-पैरामीट्रिक। इस पोस्ट में, हम ऐसे ही एक नॉन-पैरामीट्रिक एल्गोरिद्म को विस्तार से कवर करेंगे – मीन शिफ्ट क्लस्टरिंग एल्गोरिद्म। हम इसके आधारभूत सिद्धांतों पर चर्चा करेंगे, विभिन्न उद्योगों में इसके अनुप्रयोगों का पता लगाएंगे, और एक Python इम्प्लीमेंटेशन प्रदान करेंगे। अंत में, हम इसकी तुलना लोकप्रिय k-means क्लस्टरिंग तकनीक से करेंगे।
मीन शिफ्ट क्लस्टरिंग क्या है?
मीन शिफ्ट क्लस्टरिंग का उपयोग उन डेटासेट्स में क्लस्टर्स की पहचान करने के लिए किया जाता है जहाँ क्लस्टर्स की संख्या पहले से ज्ञात नहीं होती। यह फीचर स्पेस में सबसे घने क्षेत्रों की ओर डेटा बिंदुओं को क्रमिक रूप से शिफ्ट करके क्लस्टर्स ढूंढता है। यह इसे विशेष रूप से ऑब्जेक्ट रिकॉग्निशन जैसे अनुप्रयोगों के लिए उपयोगी बनाता है, जहाँ यह पिक्सेल इंटेंसिटी और रंग के आधार पर इमेज का सेगमेंटेशन कर सकता है, और वीडियो सीक्वेंसेज़ में ऑब्जेक्ट्स को ट्रैक करने के लिए भी।
एक मोड-सीकिंग एल्गोरिद्म के रूप में, यह डेटा वितरण में मोड्स या पीक्स ढूंढकर क्लस्टर्स को लेबल करता है। मूलतः, यह सबसे घने क्षेत्रों को उजागर करता है। यह ऐसा क्लस्टर सेंटर्स को उच्च डेटा घनत्व वाले क्षेत्रों की ओर क्रमिक रूप से शिफ्ट करके करता है। चरण इस प्रकार हैं:
इस क्रमिक प्रक्रिया के अंत में, डेटा बिंदु डेटा वितरण के मोड्स के आसपास इकट्ठा हो जाते हैं और क्लस्टर्स बनाते हैं। मीन शिफ्ट विशेष रूप से लचीला है क्योंकि यह क्लस्टर्स के लिए पूर्व-परिभाषित आकार मानने के बजाय वास्तविक डेटा वितरण पर निर्भर करता है, जिससे यह मनमाने आकार के क्लस्टर्स को संभाल सकता है।
मीन शिफ्ट क्लस्टरिंग का उपयोग क्यों करें?
मीन शिफ्ट क्लस्टरिंग डेटा की अंतर्निहित संरचना का पता लगाने के लिए एक शक्तिशाली उपकरण है, जो इसके पैरामीटर्स जैसे क्लस्टर्स की संख्या या उनके आकार के बारे में कोई धारणा बनाए बिना काम करता है। उच्च डेटा घनत्व वाले क्षेत्रों पर केंद्रित इसकी डेंसिटी-आधारित पद्धति इसे आउट्लायर के प्रति मजबूत बनाती है, जिससे शोरयुक्त डेटा का क्लस्टरिंग प्रक्रिया पर न्यूनतम प्रभाव पड़ता है। ऐसी मजबूती इसे वास्तविक दुनिया के डेटासेट्स के लिए उपयुक्त बनाती है, जिनमें अक्सर अनियमितताएँ और शोर होता है, और उन अनुप्रयोगों के लिए भी जो अनुकूलनशीलता और परिशुद्धता की मांग करते हैं।
कुछ वास्तविक दुनिया के परिदृश्य जहाँ मीन शिफ्ट क्लस्टरिंग अच्छी तरह काम करती है:
इमेज सेगमेंटेशन
मीन शिफ्ट क्लस्टरिंग एल्गोरिद्म पिक्सेल इंटेंसिटी या रंग के आधार पर, सेगमेंट्स की संख्या की पूर्व जानकारी के बिना, इमेज को क्षेत्रों में विभाजित कर सकता है। यह लचीलापन इमेज सेगमेंटेशन कार्यों के लिए इसे अत्यधिक प्रभावी बनाता है क्योंकि मीन शिफ्ट क्लस्टरिंग से बने क्लस्टर्स किसी भी आकार या आकार के हो सकते हैं।
मीन शिफ्ट क्लस्टरिंग का उपयोग करके इमेज सेगमेंटेशन। स्रोत: ResearchGate
इसके अलावा, शोर वाली इमेज, खासकर कम रोशनी की स्थिति में, सेगमेंट करना कठिन होता है। ऐसे परिदृश्यों में, मीन शिफ्ट क्लस्टरिंग एल्गोरिद्म अधिक प्राकृतिक और सटीक सेगमेंटेशन प्रदान करता है, जो कि मेडिकल इमेजिंग में असामान्य ऊतक प्रकारों का पता लगाने या कंप्यूटर विज़न में विश्वसनीय ऑब्जेक्ट डिटेक्शन के लिए आवश्यक है।
वीडियो विश्लेषण में ऑब्जेक्ट ट्रैकिंग
इमेज सेगमेंटेशन में अपने लाभों के चलते, मीन शिफ्ट क्लस्टरिंग का अक्सर वीडियो स्ट्रीम्स में ऑब्जेक्ट ट्रैकिंग के लिए उपयोग होता है। फ्रेम्स के बीच चलते हुए ऑब्जेक्ट्स की गतिशील पहचान और उनका अनुसरण करने की इसकी क्षमता इसे रियल-टाइम ट्रैकिंग अनुप्रयोगों के लिए काफी प्रभावी बनाती है।
ऑब्जेक्ट ट्रैकिंग में मीन शिफ्ट क्लस्टरिंग। स्रोत: ResearchGate
ऑब्जेक्ट से जुड़े पिक्सेल्स या फीचर्स की घनत्व पर केंद्रित होकर, मीन शिफ्ट विभिन्न आकार और आकार के ऑब्जेक्ट्स को प्रभावी ढंग से ट्रैक कर सकता है, जिससे यह मूवमेंट और रूप-रंग में बदलावों के प्रति आसानी से अनुकूल हो जाता है।
मार्केटिंग में कस्टमर सेगमेंटेशन
व्यवसायों के लिए, यह महत्वपूर्ण है कि वे कस्टमर सेगमेंट्स को समझें बिना किसी तय श्रेणी संख्या को मानकर, और साथ ही आउट्लायर व्यवहार को भी ध्यान में रखें। मीन शिफ्ट क्लस्टरिंग कस्टमर व्यवहार, खरीदारी पैटर्न, और जनसांख्यिकीय डेटा का विश्लेषण करके समूह आकार की परवाह किए बिना प्राकृतिक समूहों का पता लगा सकती है।
यह लक्षित मार्केटिंग रणनीतियाँ और व्यक्तिगत अनुभव बनाने में मदद करता है, जो अंततः ग्राहक जुड़ाव और प्रतिधारण को बढ़ाता है।
मीन शिफ्ट क्लस्टरिंग कैसे काम करती है?
आइए एक ऐसी फंक्शन से शुरू करें जो एक विंडो में डेटा बिंदुओं की घनत्व का अनुमान लगाए और समझें कि यह एल्गोरिद्म कैसे काम करता है।
कर्नेल डेंसिटी एस्टीमेशन (KDE)
यह प्रत्येक इटरेशन में उच्च डेटा घनत्व वाले क्षेत्रों की पहचान करने के लिए एक रैंडम वेरिएबल के प्रॉबेबिलिटी डेंसिटी फंक्शन का उपयोग करता है। KDE का फॉर्मूला यह है:
जहाँ h एक बैंडविड्थ पैरामीटर है, और कर्नेल सामान्यतः Gaussian होता है। कर्नेल फंक्शन k प्रत्येक डेटा बिंदु के योगदान को स्मूथ करता है, यह सुनिश्चित करते हुए कि x के करीब के बिंदुओं का डेंसिटी एस्टीमेट पर अधिक प्रभाव हो।
उचित बैंडविड्थ चुनना
बैंडविड्थ पैरामीटर h प्रत्येक डेटा बिंदु के आसपास के नेबरहुड के आकार को निर्धारित करता है, जो सीधे क्लस्टरिंग परिणामों को प्रभावित करता है। बैंडविड्थ चुनने के तरीके इस प्रकार हैं:
Scott का नियम
Scott का नियम एक ह्यूरिस्टिक तरीका है जो बैंडविड्थ चयन के लिए एक thumb-rule देता है। यह डेंसिटी एस्टीमेट में बायस और वैरिएंस के बीच संतुलन बनाता है, जिससे यह कई अनुप्रयोगों के लिए एक अच्छा शुरुआती बिंदु बनता है।
जहाँ:
Silverman का नियम
Scott के नियम के समान, Silverman का नियम बैंडविड्थ चयन के लिए एक अन्य ह्यूरिस्टिक तरीका प्रदान करता है, जो विशेष रूप से यूनिमोडल डिस्ट्रीब्यूशन्स के लिए उपयोगी है।
क्रॉस-वैलिडेशन
होल्डआउट डेटासेट्स पर विभिन्न बैंडविड्थ मानों के प्रदर्शन का आकलन करके, हम वह सर्वश्रेष्ठ बैंडविड्थ मान चुन सकते हैं जो त्रुटि को न्यूनतम करता है और सर्वोत्तम क्लस्टरिंग परिणाम देता है।
विशेषज्ञ की जानकारी
विशेषज्ञ ज्ञान, विशेष रूप से इमेज प्रोसेसिंग जैसी विशिष्ट अनुप्रयोगों में, उपयुक्त बैंडविड्थ चुनने पर महत्वपूर्ण अंतर्दृष्टि दे सकता है। कोई विशेषज्ञ इमेज के भीतर फीचर्स के सामान्य स्केल को समझकर इष्टतम बैंडविड्थ रेंज चुन सकता है और फिर अनुभवजन्य परीक्षण के माध्यम से इस रेंज को फाइन-ट्यून कर सकता है।
एडेप्टिव बैंडविड्थ
एडेप्टिव बैंडविड्थ, विभिन्न घनत्व वाले डेटासेट्स के लिए उपयोगी है। यह डेटा के अलग-अलग क्षेत्रों के लिए अलग-अलग बैंडविड्थ लागू करता है। यह एक ग्लोबल बैंडविड्थ अनुमान से शुरू करता है और फिर उस क्षेत्र में डेटा बिंदुओं की घनत्व के आधार पर इसे स्थानीय रूप से समायोजित करता है।
मीन शिफ्ट वेक्टर
मीन शिफ्ट वेक्टर उस मूवमेंट की परिमाण और दिशा का प्रतिनिधित्व करता है जो क्लस्टर सेंटर अनुमान को कम-घनत्व वाले क्षेत्रों से उच्च-घनत्व वाले क्षेत्रों तक शिफ्ट करने के लिए आवश्यक है।
किसी डेटा बिंदु xi के लिए, मीन शिफ्ट वेक्टर m(xi) इस प्रकार निकाला जाता है:
जहाँ N(xi) बैंडविड्थ द्वारा परिभाषित xi के आसपास के नेबरहुड को निरूपित करता है।
कन्वर्जेन्स
मीन शिफ्ट क्लस्टरिंग एल्गोरिद्म तब कन्वर्ज करता है जब क्लस्टर सेंटर्स पहले से निर्दिष्ट थ्रेशोल्ड से अधिक नहीं सरकते, और जब एल्गोरिद्म डेंसिटी फंक्शन के मोड्स की पहचान कर लेता है, जिनके आसपास क्लस्टर्स बनते हैं। एल्गोरिद्म निम्नलिखित चरणों से गुजरता रहता है जब तक कि कन्वर्जेन्स न हो:
कन्वर्जेन्स इंगित करता है कि डेटा बिंदु डेंसिटी फंक्शन के स्थानीय मैक्सिमा के आसपास स्थिर हो गए हैं, जो तब क्लस्टर सेंटर्स के रूप में काम करते हैं।