Clustering is een unsupervised machine learning-techniek die verborgen structuren in data ontdekt om bedrijven te helpen beter onderbouwde beslissingen te nemen. Enkele veelvoorkomende toepassingen zijn beeldsegmentatie, klantsegmentatie en sociale-netwerkanalyse.
Afhankelijk van of het algoritme vooraf het aantal clusters of de verdeling van de data als invoer vereist, onderscheiden we twee typen clustering: parametrisch en niet-parametrisch. In dit artikel behandelen we zo'n niet-parametrisch algoritme in detail: het mean shift-clusteringalgoritme. We bespreken de onderliggende principes, verkennen toepassingen in verschillende sectoren en geven een Python-implementatie. Tot slot vergelijken we het met de populaire k-means-clustering-techniek.
Wat is mean shift-clustering?
Mean shift-clustering wordt gebruikt om clusters te identificeren in datasets waarbij het aantal clusters niet vooraf bekend is. Het vindt clusters door datapunten iteratief te verschuiven naar de dichtste regio's in de feature space. Dit maakt het bijzonder nuttig voor toepassingen zoals objectherkenning, waar het beelden kan segmenteren op basis van pixelintensiteit en kleur, en voor het volgen van objecten in videoreeksen.
Als mode-seekend algoritme labelt het de clusters door de modi, of pieken, in de dataverdeling te vinden. In essentie markeert het de meest dichte gebieden. Dit doet het door de clustercentra iteratief te verschuiven naar regio's met een hogere datadichtheid. De stappen zijn:
- Initialisatie: Begin met elk datapunt te beschouwen als een potentiële kandidaat voor het clustercentrum.
- Dichtheids schatting: Definieer voor elk datapunt een venster eromheen, de radius, en bereken vervolgens het gemiddelde van de datapunten binnen deze radius.
- Verschuiven: Verschuif elk punt naar deze gemiddelde positie. Deze stap verplaatst het punt richting de regio met hogere dichtheid.
- Convergentie: Herhaal stap 2 en 3 iteratief tot convergentie, d.w.z. wanneer de verschuiving kleiner is dan een vooraf ingestelde drempel. De geringe verandering impliceert dat de punten zijn gestabiliseerd rond de lokale maxima van de dichtheidsfunctie.
Aan het einde van dit iteratieve proces clusteren datapunten rond de modi van de dataverdeling en vormen zo de clusters. Mean shift is bijzonder flexibel omdat het vertrouwt op de feitelijke dataverdeling in plaats van een vooraf gedefinieerde vorm van clusters aan te nemen, waardoor het clusters met willekeurige vormen aankan.
Waarom mean shift-clustering gebruiken?
Mean shift-clustering is een krachtig hulpmiddel om de onderliggende structuur van data te onthullen zonder aannames te doen over parameters zoals het aantal clusters of hun vorm. Dankzij de dichtheidsbenadering, die zich richt op regio's met hoge datadichtheid, is het robuust tegen uitschieters, waardoor ruis in de data minimale invloed heeft op het clusteringsproces. Die robuustheid maakt het geschikt voor real-world datasets, die vaak onregelmatigheden en ruis bevatten, en voor toepassingen die aanpasbaarheid en precisie vereisen.
Enkele praktijksituaties waarin mean shift-clustering goed werkt:
Beeldsegmentatie
Het mean shift-clusteringalgoritme kan beelden segmenteren in regio's op basis van pixelintensiteit of kleur zonder voorafgaande kennis van het aantal segmenten. Deze flexibiliteit maakt het zeer effectief voor beeldsegmentatietaken, omdat de clusters die met mean shift worden gegenereerd elke vorm of grootte kunnen hebben.
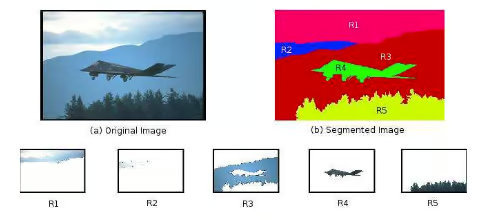
Beeldsegmentatie met mean shift-clustering. Bron: ResearchGate
Bovendien zijn beelden met ruis, met name bij weinig licht, lastig te segmenteren. Voor zulke scenario's levert het mean shift-algoritme een natuurlijkere en nauwkeurigere segmentatie, wat essentieel is in toepassingen als medische beeldvorming voor het detecteren van afwijkende weefseltypen of in computervisie voor betrouwbare objectdetectie.
Objecttracking in videoanalyse
Dankzij de voordelen bij beeldsegmentatie wordt mean shift-clustering vaak gebruikt voor het volgen van objecten in videostreams. De mogelijkheid om objecten dynamisch te identificeren en te volgen terwijl ze tussen frames bewegen, maakt het zeer effectief voor real-time trackingtoepassingen.
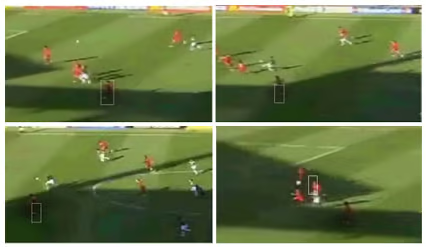
Mean shift-clustering bij objecttracking. Bron: ResearchGate
Door te focussen op de dichtheid van pixels of features die bij het object horen, kan mean shift objecten met uiteenlopende vormen en groottes effectief volgen en zich gemakkelijk aanpassen aan veranderingen in beweging en uiterlijk.
Klantsegmentatie in marketing
Voor bedrijven is het belangrijk om klantsegmenten te begrijpen zonder een vast aantal categorieën aan te nemen en tegelijk rekening te houden met outliergedrag. Mean shift-clustering kan klantgedrag, koopgedrag en demografische data analyseren om natuurlijke groeperingen bloot te leggen, ongeacht de groepsgrootte.
Dit helpt bij het creëren van gerichte marketingstrategieën en gepersonaliseerde ervaringen, wat uiteindelijk de betrokkenheid en retentie van klanten vergroot.
Hoe werkt mean shift-clustering?
Laten we beginnen met een functie om de dichtheid van datapunten in een venster te schatten en begrijpen hoe dit algoritme werkt.
Kernel density estimation (KDE)
Het gebruikt een kansdichtheidsfunctie van een willekeurige variabele om in elke iteratie gebieden met hogere datadichtheid te identificeren. De formule voor KDE is:
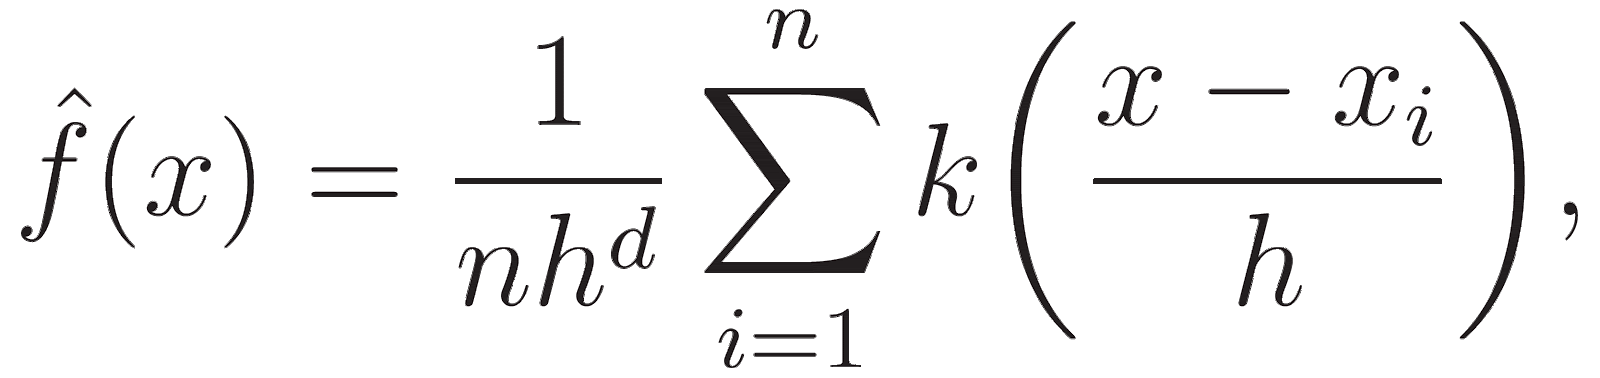
Waarbij h een bandwidth-parameter is en de kernel doorgaans Gaussisch is. De kernelfunctie k verzacht de bijdrage van elk datapunt, zodat punten dichter bij x meer invloed hebben op de dichtheidsschatting.
De juiste bandwidth kiezen
De bandwidth-parameter h bepaalt de grootte van de buurt rond elk datapunt en beïnvloedt direct de clusteringsresultaten. Dit zijn methoden om de bandwidth te kiezen:
Regel van Scott
De regel van Scott is een heuristische aanpak die een vuistregel biedt voor het kiezen van de bandwidth. Het balanceert bias en variantie in de dichtheidsschatting en is een goed startpunt voor veel toepassingen.

waarbij:
- n het aantal datapunten is.
- d het aantal dimensies in de dataset is.
Regel van Silverman
Net als de regel van Scott biedt de regel van Silverman een andere heuristische aanpak voor het kiezen van de bandwidth, met name nuttig voor unimodale verdelingen.
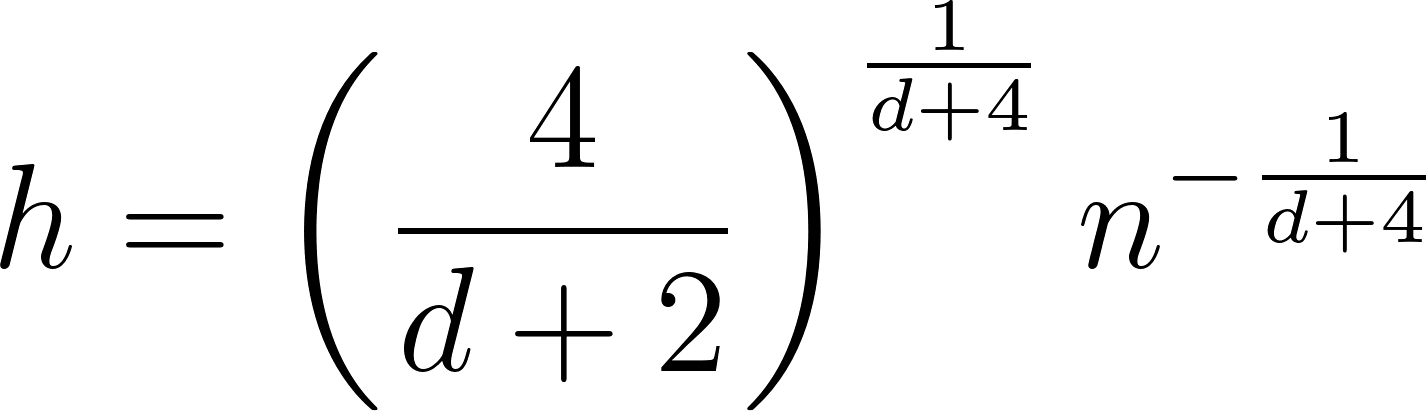
Cross-validatie
Door de prestaties van verschillende bandwidth-waarden te evalueren op holdout-datasets, kunnen we de beste waarde kiezen die de fout minimaliseert en de beste clusteringsresultaten oplevert.
- Splits de data in trainings- en validatiesets.
- Pas mean shift-clustering met verschillende bandwidth-waarden toe op de trainingsset.
- Evalueer de prestaties die bij elke bandwidth horen op de validatieset.
- Kies de bandwidth die de fout minimaliseert.
Domeinkennis
Domeinkennis kan waardevolle inzichten geven bij het kiezen van een geschikte bandwidth, vooral in specifieke toepassingen, zoals beeldverwerking. Een expert kan de typische schaal van features in een beeld kennen om een optimale bandbreedterange te kiezen en deze vervolgens verfijnen via empirische tests.
Adaptieve bandwidth
Adaptieve bandwidth is nuttig voor datasets met variërende dichtheden. Het past verschillende bandwidths toe voor verschillende regio's in de data. Het begint met een globale schatting en past deze lokaal aan op basis van de dichtheid van datapunten in die regio.
Mean shift-vector
De mean shift-vector vertegenwoordigt de grootte en richting van de verplaatsing die nodig is om de schatting van het clustercentrum van lager- naar hoger-dichtheidsgebieden te verschuiven.
Voor een datapunt xi wordt de mean shift-vector m(xi) als volgt berekend:
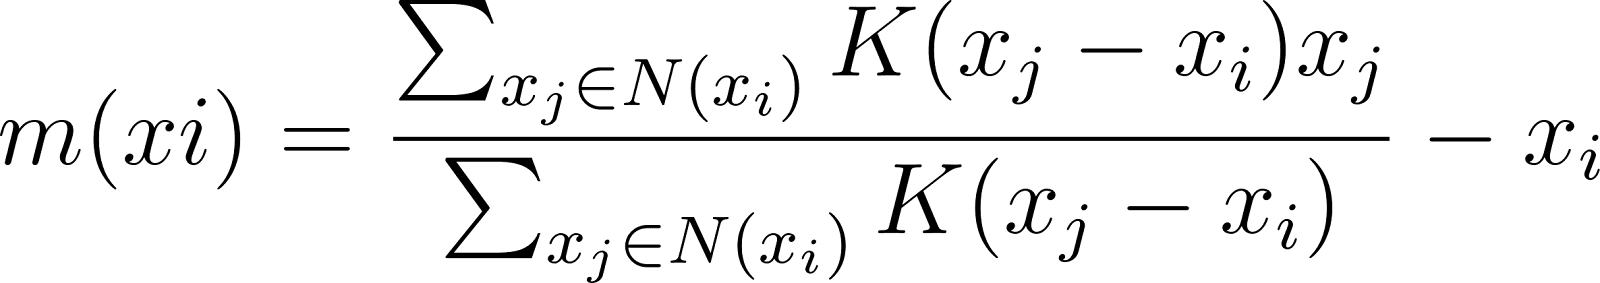
waarbij N(xi) de buurt rond xi aangeeft, gedefinieerd door de bandwidth.
Convergentie
Het mean shift-clusteringalgoritme convergeert wanneer clustercentra niet meer verder bewegen dan een gespecificeerde drempel en wanneer het algoritme de modi van de dichtheidsfunctie heeft geïdentificeerd, waar de clusters zich omheen vormen. Het algoritme blijft de volgende stappen herhalen tot convergentie:
- Bereken de mean shift-vector voor elk datapunt.
- Verschuif het datapunt richting het gemiddelde van zijn buurt.
- Controleer op convergentie door na te gaan of de verschuivingen kleiner zijn dan een vooraf ingestelde drempel.
Convergentie geeft aan dat datapunten zijn gestabiliseerd rond de lokale maxima van de dichtheidsfunctie, die vervolgens dienen als clustercentra.
Implementatie van mean shift-clustering in Python
Tijd om de stappen te verkennen voor het gebruik van mean shift-clustering. We gebruiken de MeanShift-klasse uit de populaire sci-kit-learn-bibliotheek, die out of the box beschikbaar is om dit algoritme op datasets toe te passen.
Basis mean shift-clustering
Laten we beginnen met het importeren van de vereiste bibliotheken voor de implementatie.
from sklearn.cluster import MeanShift, estimate_bandwidth
from sklearn.datasets import make_blobs
import matplotlib.pyplot as plt
Vervolgens genereren we een synthetische dataset van 500 samples met de functie make_blobs() uit de module datasets van scikit-learn. De dataset krijgt vijf centra (clusters) met een cluster-standaarddeviatie van 0,7.
# Create a sample dataset
X, _ = make_blobs(n_samples=500, centers=5, cluster_std=0.7, random_state=27)
Laten we de bandwidth schatten met de functie estimate_bandwidth().
# Estimate the bandwidth of the input data
bandwidth = estimate_bandwidth(X, quantile=0.2, n_samples=500)
Nu gebruiken we deze bandwidth om het MeanShift-clusteringsobject te initialiseren en te fitten op de eerder gemaakte dataset.
# Perform mean shift clustering
ms_model = MeanShift(bandwidth=bandwidth, bin_seeding=True)
ms_model.fit(X)
labels = ms_model.labels_
mean_shift_centers = ms_model.cluster_centers_
Tijd om de mean shift-clustercentra te visualiseren over onze originele dataset. Hier worden onze vijf clusters weergegeven in verschillende kleuren, met mean shift-centra aangeduid met kruisen.
# Plot the results
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(mean_shift_centers[:, 0], mean_shift_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()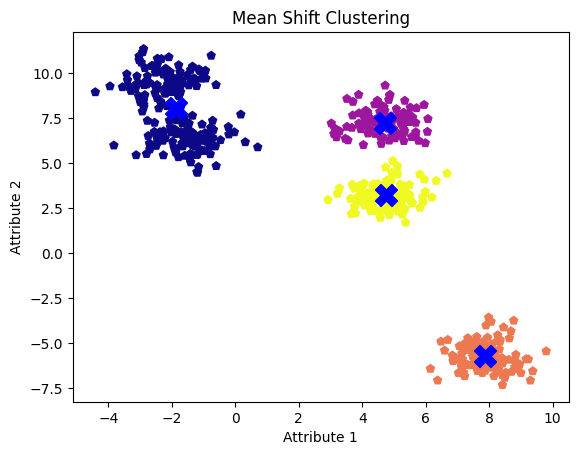
Mean shift-clusters met standaard bandwidth-waarde. Afbeelding door de auteur
Hoewel we vijf vlekken (clusters) zien, identificeert het algoritme er maar vier door twee aangrenzende clusters samen te voegen.
Afstellen van de bandwidth-parameter
De parameter bandwidth heeft grote invloed op de clusteringsresultaten. Laten we deze afstellen om te zien of we de vijf clusters kunnen vinden. We testen drie verschillende waarden en visualiseren de resulterende clustercentra voor elk van hen.
# Try different bandwidth values
bandwidth_values = [0.1, 1.0, 2.0]

for bw in bandwidth_values:
    ms = MeanShift(bandwidth=bw, bin_seeding=True)
    ms.fit(X)
    labels = ms.labels_
    cluster_centers = ms.cluster_centers_
    print("Bandwidth Value:", bw)
    plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
    plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
    plt.title('mean shift clustering')
    plt.xlabel('Attribute 1')
    plt.ylabel('Attribute 2')
    plt.show()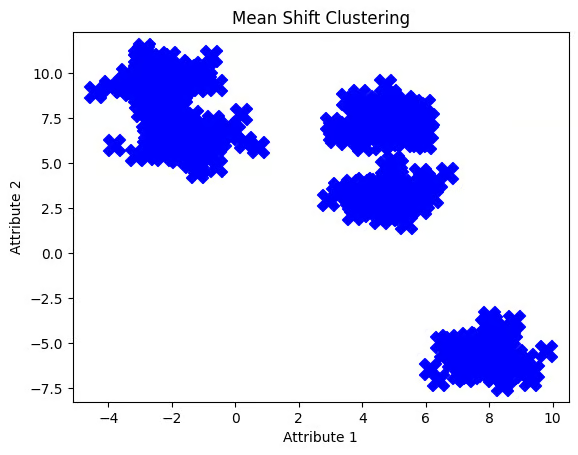
Mean shift-clusters met bandwidth-waarde 0,1. Afbeelding door de auteur
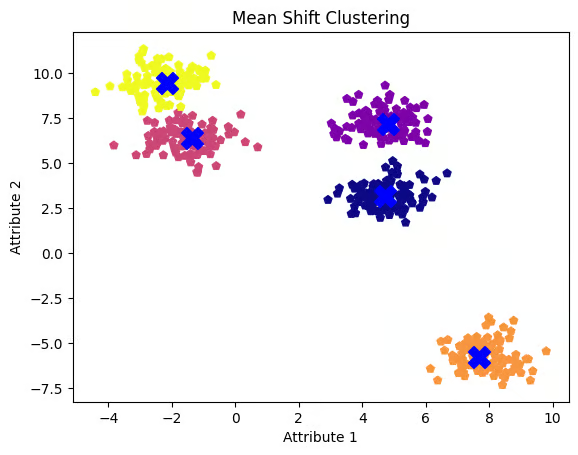
Mean shift-clusters met bandwidth-waarde 1,0. Afbeelding door de auteur
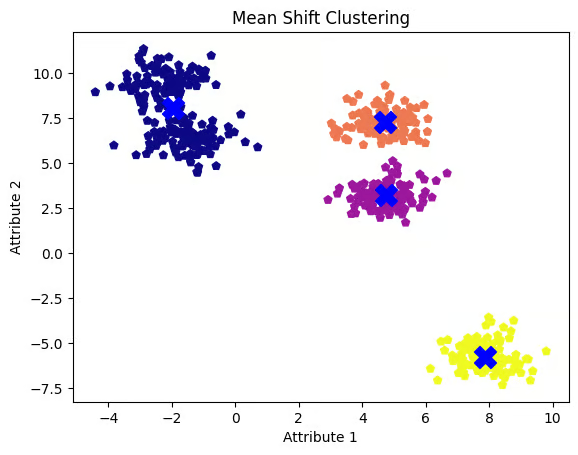
Mean shift-clusters met bandwidth-waarde 2,0. Afbeelding door de auteur
De waarde 0,1 lijkt te laag, waardoor het algoritme elk datapunt als een aparte cluster beschouwt. Een waarde van 2,0 is daarentegen wat hoog, want deze scheidde de twee clusters in onze eerste poging niet. Een waarde van 1,0 blijkt het meest optimaal en laat alle vijf de clusters en hun centra duidelijk zien.
Laten we deze waarde kiezen en de resultaten nog eens visualiseren.
ms = MeanShift(bandwidth=1.0, bin_seeding=True)
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='plasma', marker='p')
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1], s=250, c='blue', marker='X')
plt.title('mean shift clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()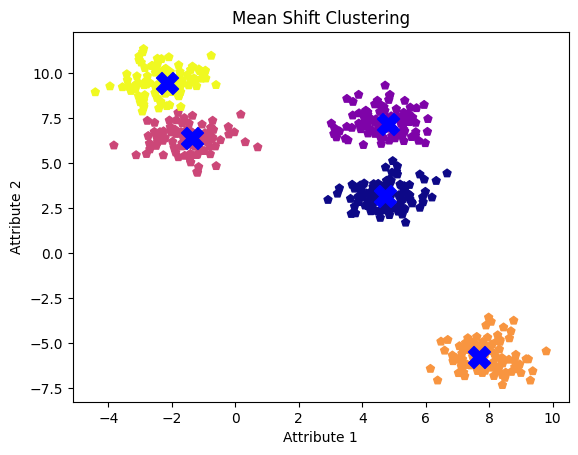
Mean shift-clusters met bandwidth-waarde 1,0
Zoals te zien is, levert een kleinere bandwidth meer clusters op, terwijl een grotere bandwidth kan leiden tot het samenvoegen van clusters.
Mean shift vergelijken met k-means
Laten we de resultaten van mean shift en k-means-clustering op dezelfde dataset vergelijken. Importeer eerst KMeans uit de module sklearn’s cluster. Vervolgens stellen we het aantal clusters in op drie en fitten we het model om de clustercentra te verkrijgen.
from sklearn.cluster import KMeans
# Perform k-means Clustering
kmeans = KMeans(n_clusters=3, random_state=0, n_init='auto')
kmeans.fit(X)
kmeans_labels = kmeans.labels_
kmeans_centers = kmeans.cluster_centers_
Visualiseren we nu de resultaten om ze te vergelijken met de mean shift-clusteringresultaten.
plt.scatter(X[:, 0], X[:, 1], c=kmeans_labels, cmap='plasma', marker='p')
plt.scatter(kmeans_centers[:, 0], kmeans_centers[:, 1], s=250, c='red', marker='X')
plt.title('K-means Clustering')
plt.xlabel('Attribute 1')
plt.ylabel('Attribute 2')
plt.show()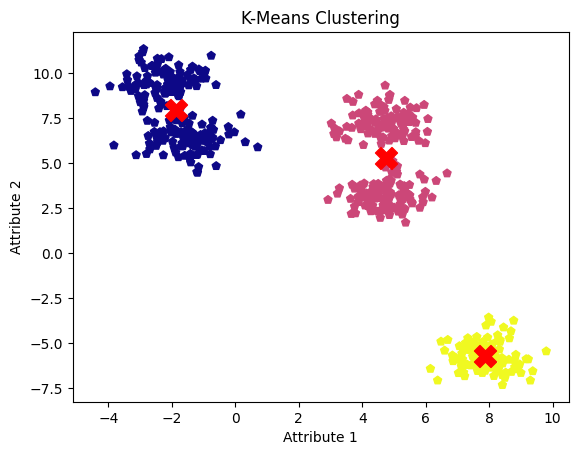
k-means-clusteringresultaten. Afbeelding door de auteur
Het nadeel van het k-means-algoritme is dat je het aantal clusters vooraf moet specificeren, wat ertoe kan leiden dat aangrenzende clusters worden samengevoegd. Een goed afgesteld mean shift-model identificeerde echter alle vijf de clusters en hun centra.
Use cases in de praktijk
Naast objectherkenning in beeldverwerking wordt mean shift-clustering gebruikt in tal van real-world toepassingen in meerdere domeinen:
- Het ondersteunt genexpressie-analyse en de voorspelling van eiwitstructuren in bio-informatica.
- Geospatiale analisten gebruiken het voor geografische clustering en anomaliedetectie in ruimtelijke data.
- In medische beeldvorming wordt het gebruikt om tumoren in MRI- en CT-scans te detecteren en voor weefselclassificatie.
- De financiële sector gebruikt het voor marktsegmentatie en fraudedetectie.
- Daarnaast wordt het in natural language processing (NLP) toegepast op documentclustering en sentimentanalyse.
Conclusie
In dit artikel zagen we hoe mean shift-clustering zich aanpast aan uiteenlopende clustervormen en -groottes, zonder een vooraf gedefinieerd aantal clusters nodig te hebben.
Met alle inzichten en de praktische implementatie van dit algoritme ben je klaar om ermee te experimenteren in je projecten. Python is de populairste programmeertaal en zeker de moeite waard om te leren. Raadpleeg dit Python Developer-carrièrepad om je Python-programmeervaardigheden naar een hoger niveau te tillen. Bekijk ook ons volledige carrièrepad Machine Learning Scientist with Python en leer van experts.


