

Naive Bayes क्लासिफायर क्या है?
Naive Bayes, Bayes प्रमेय पर आधारित एक सांख्यिकीय वर्गीकरण तकनीक है। यह सबसे सरल सुपरवाइज़्ड लर्निंग एल्गोरिद्मों में से एक है। Naive Bayes क्लासिफायर एक तेज़, सटीक और भरोसेमंद एल्गोरिद्म है। बड़े डेटासेट्स पर Naive Bayes क्लासिफायर्स उच्च सटीकता और गति प्रदान करते हैं।
Naive Bayes क्लासिफायर यह मानता है कि किसी वर्ग में किसी विशेष फीचर का प्रभाव अन्य फीचर्स से स्वतंत्र है। उदाहरण के लिए, कोई लोन आवेदक उपयुक्त है या नहीं, यह उसकी आय, पिछले लोन और ट्रांज़ैक्शन हिस्ट्री, आयु और लोकेशन पर निर्भर करता है। भले ही ये फीचर्स परस्पर निर्भर हों, फिर भी इन्हें स्वतंत्र माना जाता है। यह मान्यता गणना को सरल बनाती है, और इसी वजह से इसे naive कहा जाता है। इस मान्यता को वर्ग सापेक्ष स्वतंत्रता (class conditional independence) कहते हैं।
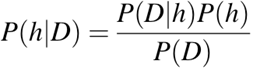
-
P(h): परिकल्पनाhके सत्य होने की प्रायिकता (डेटा से स्वतंत्र)। इसेhकी पूर्व प्रायिकता (prior probability) कहते हैं। -
P(D): डेटा की प्रायिकता (परिकल्पना से स्वतंत्र)। इसे पूर्व प्रायिकता कहते हैं। -
P(h|D): डेटाDदिए जाने पर परिकल्पनाhकी प्रायिकता। इसे पश्च प्रायिकता (posterior probability) कहते हैं। -
P(D|h): यह प्रायिकता कि परिकल्पनाhसत्य होने पर डेटाdमिले। इसे भी पश्च प्रायिकता कहते हैं।
Naive Bayes वर्गीकरण वर्कफ़्लो
जब भी आप वर्गीकरण करते हैं, पहला कदम समस्या को समझना और संभावित फीचर्स और लेबल की पहचान करना होता है। फीचर्स वे गुण या विशेषताएँ हैं जो लेबल के परिणाम को प्रभावित करती हैं। उदाहरण के लिए, लोन वितरण के मामले में, बैंक मैनेजर ग्राहक का पेशा, आय, आयु, स्थान, पूर्व लोन हिस्ट्री, ट्रांज़ैक्शन हिस्ट्री और क्रेडिट स्कोर पहचानते हैं। ये विशेषताएँ फीचर्स कहलाती हैं जो मॉडल को ग्राहकों को वर्गीकृत करने में मदद करती हैं।
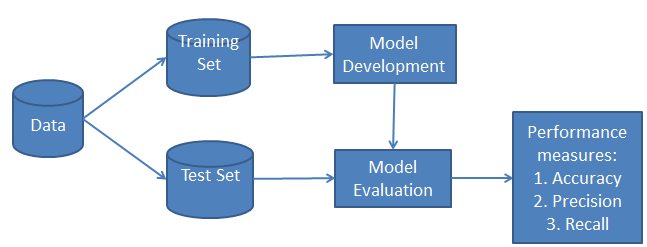
वर्गीकरण में दो चरण होते हैं: लर्निंग चरण और मूल्यांकन चरण। लर्निंग चरण में, क्लासिफायर दिए गए डेटासेट पर अपना मॉडल ट्रेन करता है, और मूल्यांकन चरण में, वह क्लासिफायर के प्रदर्शन का परीक्षण करता है। प्रदर्शन का आकलन सटीकता (accuracy), त्रुटि (error), प्रिसिशन और रिकॉल जैसे विभिन्न मानकों के आधार पर किया जाता है।
Naive Bayes क्लासिफायर कैसे काम करता है?
आइए एक उदाहरण से Naive Bayes का काम समझते हैं। मौसम की स्थिति और खेल खेलने के उदाहरण को लें। आपको खेल खेलने की प्रायिकता की गणना करनी है। अब, आपको मौसम की स्थिति के आधार पर यह वर्गीकृत करना है कि खिलाड़ी खेलेंगे या नहीं।
पहला तरीका (सिंगल फीचर के मामले में)
Naive Bayes क्लासिफायर निम्न चरणों में किसी घटना की प्रायिकता निकालता है:
- चरण 1: दिए गए क्लास लेबल्स के लिए पूर्व प्रायिकता (prior probability) की गणना करें
- चरण 2: प्रत्येक क्लास के लिए प्रत्येक एट्रिब्यूट के साथ लाइकलिहुड प्रायिकता निकालें
- चरण 3: इन मानों को Bayes फ़ॉर्मूला में रखें और पश्च प्रायिकता (posterior probability) निकालें।
- चरण 4: देखें कि किस क्लास की प्रायिकता अधिक है; इनपुट उसी उच्च प्रायिकता वाले क्लास का होगा।
पूर्व और पश्च प्रायिकता की गणना को सरल बनाने के लिए, आप दो टेबल्स—फ्रीक्वेंसी और लाइकलिहुड टेबल्स—का उपयोग कर सकते हैं। ये दोनों टेबल्स पूर्व और पश्च प्रायिकता निकालने में मदद करेंगी। फ्रीक्वेंसी टेबल सभी फीचर्स के लिए लेबल्स की आवृत्ति दिखाती है। दो लाइकलिहुड टेबल्स होती हैं। लाइकलिहुड टेबल 1 लेबल्स की पूर्व प्रायिकताओं को दिखाती है और लाइकलिहुड टेबल 2 पश्च प्रायिकता दिखाती है।
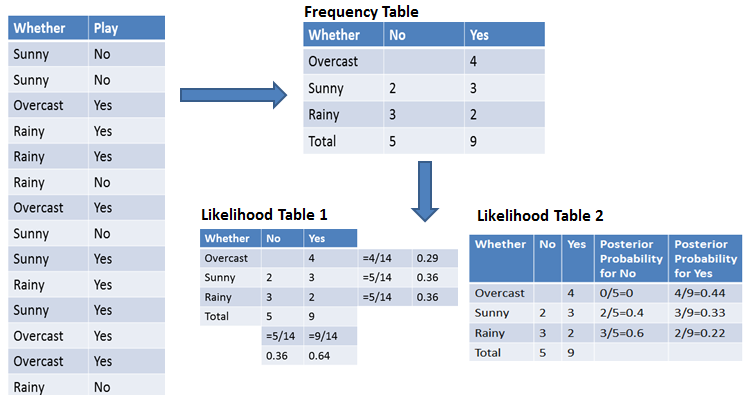
अब मान लीजिए आप ओवरकास्ट (बादल) मौसम में खेलने की प्रायिकता निकालना चाहते हैं।
खेलने की प्रायिकता:
P(Yes | Overcast) = P(Overcast | Yes) × P(Yes) / P(Overcast)
चरण 1: पूर्व प्रायिकताएँ निकालें
- P(Overcast) = 4/14 = 0.29
- P(Yes) = 9/14 = 0.64
चरण 2: पश्च प्रायिकता निकालें
- P(Overcast | Yes) = 4/9 = 0.44
चरण 3: Bayes फ़ॉर्मूला लागू करें
यहाँ, हम पहले समीकरण में पूर्व और पश्च प्रायिकताएँ रखते हैं।
P(Yes | Overcast) = 0.44 × 0.64 / 0.29 = 0.98
इसी प्रकार, आप न खेलने की प्रायिकता निकाल सकते हैं:
न खेलने की प्रायिकता:
P(No | Overcast) = P(Overcast | No) × P(No) / P(Overcast)
चरण 1: पूर्व प्रायिकताएँ निकालें
- P(Overcast) = 4/14 = 0.29
- P(No) = 5/14 = 0.36
चरण 2: लाइकलिहुड निकालें
- P(Overcast | No) = 0/5 = 0
चरण 3: Bayes फ़ॉर्मूला लागू करें
यहाँ, हम समीकरण में पूर्व और लाइकलिहुड प्रायिकताएँ रखते हैं ताकि पश्च प्रायिकता मिले।
P(No | Overcast) = 0 × 0.36 / 0.29 = 0
'Yes' क्लास की प्रायिकता अधिक है। अतः यह निर्धारित किया जा सकता है कि यदि मौसम ओवरकास्ट है, तो खिलाड़ी खेलेंगे।
दूसरा तरीका (एकाधिक फीचर्स के मामले में)
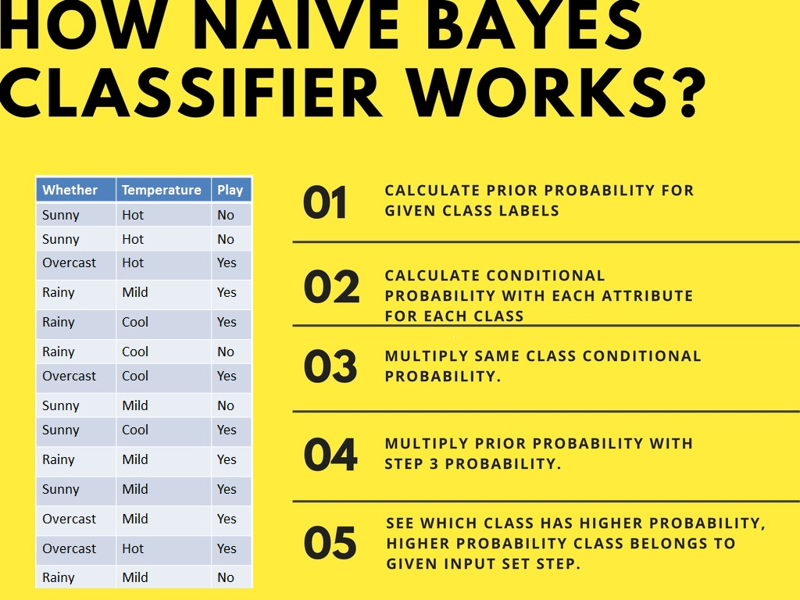
अब मान लीजिए आप तब खेलने की प्रायिकता निकालना चाहते हैं जब मौसम ओवरकास्ट है और तापमान माइल्ड है।
खेलने की प्रायिकता:
P(Play = Yes | Weather = Overcast, Temp = Mild) = P(Weather = Overcast, Temp = Mild | Play = Yes) × P(Play = Yes)
Naive Bayes की स्वतंत्रता मान्यता का उपयोग करते हुए:
P(Weather = Overcast, Temp = Mild | Play = Yes) = P(Overcast | Yes) × P(Mild | Yes)
चरण 1: पूर्व प्रायिकता निकालें
- P(Yes) = 9/14 = 0.64
चरण 2: लाइकलिहुड्स निकालें
- P(Overcast | Yes) = 4/9 = 0.44
- P(Mild | Yes) = 4/9 = 0.44
चरण 3: संयुक्त लाइकलिहुड निकालें
P(Weather = Overcast, Temp = Mild | Play = Yes) = 0.44 × 0.44 = 0.1936
चरण 4: Bayes फ़ॉर्मूला लागू करें
P(Play = Yes | Weather = Overcast, Temp = Mild) = 0.1936 × 0.64 = 0.124
इसी प्रकार, आप न खेलने की प्रायिकता निकाल सकते हैं:
न खेलने की प्रायिकता:
P(Play = No | Weather = Overcast, Temp = Mild) = P(Weather = Overcast, Temp = Mild | Play = No) × P(Play = No)
Naive Bayes की स्वतंत्रता मान्यता का उपयोग करते हुए:
P(Weather = Overcast, Temp = Mild | Play = No) = P(Overcast | No) × P(Mild | No)
चरण 1: पूर्व प्रायिकता निकालें
- P(No) = 5/14 = 0.36
चरण 2: लाइकलिहुड्स निकालें
- P(Overcast | No) = 0/5 = 0
- P(Mild | No) = 2/5 = 0.4
चरण 3: संयुक्त लाइकलिहुड निकालें
P(Weather = Overcast, Temp = Mild | Play = No) = 0 × 0.4 = 0
चरण 4: Bayes फ़ॉर्मूला लागू करें
P(Play = No | Weather = Overcast, Temp = Mild) = 0 × 0.36 = 0
'Yes' क्लास की प्रायिकता अधिक है (0.124 बनाम 0), इसलिए यदि मौसम ओवरकास्ट है और तापमान माइल्ड है, तो खिलाड़ी खेलेंगे।
Scikit-learn में क्लासिफायर बनाना
सिंथेटिक डेटासेट के साथ Naive Bayes क्लासिफायर
पहले उदाहरण में, हम scikit-learn का उपयोग करके सिंथेटिक डेटा जनरेट करेंगे और Gaussian Naive Bayes एल्गोरिद्म को ट्रेन और इवैल्युएट करेंगे।
डेटासेट जनरेट करना
Scikit-learn हमें ऐसा मशीन लर्निंग इकोसिस्टम देता है जिससे हम डेटासेट बना सकें और विभिन्न मशीन लर्निंग एल्गोरिद्म का मूल्यांकन कर सकें।
हमारे मामले में, हम make_classification() फ़ंक्शन का उपयोग करके छह फीचर्स, तीन क्लासेज और 800 सैंपल्स वाला डेटासेट बना रहे हैं।
from sklearn.datasets import make_classification
X, y = make_classification(
n_features=6,
n_classes=3,
n_samples=800,
n_informative=2,
random_state=1,
n_clusters_per_class=1,
)हम matplotlib.pyplot के scatter() फ़ंक्शन का उपयोग डेटासेट को विज़ुअलाइज़ करने के लिए करेंगे।
import matplotlib.pyplot as plt
plt.scatter(X[:, 0], X[:, 1], c=y, marker="*");जैसा कि हम देख सकते हैं, लक्षित लेबल्स के तीन प्रकार हैं, और हम एक मल्टीक्लास क्लासिफिकेशन मॉडल ट्रेन करेंगे।
ट्रेन–टेस्ट स्प्लिट
ट्रेनिंग शुरू करने से पहले, हमें मॉडल मूल्यांकन के लिए डेटासेट को ट्रेनिंग और टेस्टिंग में बाँटना होगा।
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.33, random_state=125
)मॉडल बनाना और ट्रेनिंग
एक सामान्य Gaussian Naive Bayes बनाएं और उसे ट्रेनिंग डेटासेट पर ट्रेन करें। उसके बाद, किसी यादृच्छिक टेस्ट सैंपल को मॉडल में दें ताकि पूर्वानुमानित मान प्राप्त हो सके।
from sklearn.naive_bayes import GaussianNB
# Build a Gaussian Classifier
model = GaussianNB()
# Model training
model.fit(X_train, y_train)
# Predict Output
predicted = model.predict([X_test[6]])
print("Actual Value:", y_test[6])
print("Predicted Value:", predicted[0])वास्तविक और पूर्वानुमानित दोनों मान समान हैं।
Actual Value: 0
Predicted Value: 0मॉडल मूल्यांकन
अब हम मॉडल का मूल्यांकन एक अनदेखे टेस्ट डेटासेट पर करेंगे। पहले, हम टेस्ट डेटासेट के लिए मानों का पूर्वानुमान लगाएंगे और उनका उपयोग सटीकता और F1 स्कोर निकालने में करेंगे।
from sklearn.metrics import (
accuracy_score,
confusion_matrix,
ConfusionMatrixDisplay,
f1_score,
)
y_pred = model.predict(X_test)
accuray = accuracy_score(y_pred, y_test)
f1 = f1_score(y_pred, y_test, average="weighted")
print("Accuracy:", accuray)
print("F1 Score:", f1)डिफ़ॉल्ट हाइपरपैरामीटर्स के साथ हमारा मॉडल काफ़ी अच्छा प्रदर्शन कर रहा है।
Accuracy: 0.8484848484848485
F1 Score: 0.8491119695890328कन्फ्यूज़न मैट्रिक्स को विज़ुअलाइज़ करने के लिए, हम confusion_matrix से ट्रू पॉज़िटिव्स और ट्रू नेगेटिव्स निकालेंगे और ConfusionMatrixDisplay से लेबल्स के साथ मैट्रिक्स दिखाएँगे।
labels = [0,1,2]
cm = confusion_matrix(y_test, y_pred, labels=labels)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=labels)
disp.plot();हमारा मॉडल काफ़ी अच्छा चला है, और हम स्केलिंग, प्रीप्रोसेसिंग, क्रॉस-वैलिडेशन और हाइपरपैरामीटर ऑप्टिमाइज़ेशन से प्रदर्शन और बेहतर कर सकते हैं।
लोन डेटासेट के साथ Naive Bayes क्लासिफायर
आइए वास्तविक डेटासेट पर Naive Bayes क्लासिफायर ट्रेन करें। हम अधिकतर कार्यों को दोहराएँगे, सिवाय प्रीप्रोसेसिंग और डेटा एक्सप्लोरेशन के।
डेटा लोडिंग
इस उदाहरण में, हम pandas की read_csv फ़ंक्शन का उपयोग करके DataLab से Loan Data लोड करेंगे।
import pandas as pd
df = pd.read_csv('loan_data.csv')
df.head()डेटा एक्सप्लोरेशन
डेटासेट के बारे में और समझने के लिए हम .info() का उपयोग करेंगे।
-
डेटासेट में 14 कॉलम और 9578 पंक्तियाँ हैं।
-
purposeको छोड़कर, कॉलम या तो फ़्लोट्स हैं या इंटीजर्स। -
हमारा टार्गेट कॉलम
not.fully.paidहै।
df.info()RangeIndex: 9578 entries, 0 to 9577
Data columns (total 14 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 credit.policy 9578 non-null int64
1 purpose 9578 non-null object
2 int.rate 9578 non-null float64
3 installment 9578 non-null float64
4 log.annual.inc 9578 non-null float64
5 dti 9578 non-null float64
6 fico 9578 non-null int64
7 days.with.cr.line 9578 non-null float64
8 revol.bal 9578 non-null int64
9 revol.util 9578 non-null float64
10 inq.last.6mths 9578 non-null int64
11 delinq.2yrs 9578 non-null int64
12 pub.rec 9578 non-null int64
13 not.fully.paid 9578 non-null int64
dtypes: float64(6), int64(7), object(1)
memory usage: 1.0+ MBइस उदाहरण में, हम उन ग्राहकों की भविष्यवाणी करने के लिए मॉडल बनाएँगे जिन्होंने लोन पूरी तरह से अदा नहीं किया है। आइए seaborn के काउंटप्लॉट का उपयोग कर purpose और टार्गेट कॉलम की जाँच करें।
import seaborn as sns
import matplotlib.pyplot as plt
sns.countplot(data=df,x='purpose',hue='not.fully.paid')
plt.xticks(rotation=45, ha='right');हमारा डेटासेट असंतुलित (imbalanced) है, जो मॉडल के प्रदर्शन को प्रभावित करेगा। असंतुलित डेटासेट को संभालने का व्यावहारिक अनुभव लेने के लिए आप Resample an Imbalanced Dataset ट्यूटोरियल देख सकते हैं।
डेटा प्रोसेसिंग
अब हम pandas की get_dummies() फ़ंक्शन का उपयोग करके purpose कॉलम को श्रेणीबद्ध (categorical) से इंटीज़र में बदलेंगे।
pre_df = pd.get_dummies(df,columns=['purpose'],drop_first=True)
pre_df.head()इसके बाद, हम फीचर (X) और टार्गेट (y) वेरिएबल्स परिभाषित करेंगे और डेटासेट को ट्रेनिंग और टेस्टिंग सेट्स में बाँटेंगे।
from sklearn.model_selection import train_test_split
X = pre_df.drop('not.fully.paid', axis=1)
y = pre_df['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.33, random_state=125
)मॉडल बनाना और ट्रेनिंग
मॉडल बनाना और ट्रेनिंग काफ़ी सरल है। हम डिफ़ॉल्ट हाइपरपैरामीटर्स के साथ ट्रेनिंग डेटासेट पर मॉडल ट्रेन करेंगे।
from sklearn.naive_bayes import GaussianNB
model = GaussianNB()
model.fit(X_train, y_train);मॉडल मूल्यांकन
हम मॉडल के प्रदर्शन का निर्धारण करने के लिए सटीकता और F1 स्कोर का उपयोग करेंगे, और लगता है कि Gaussian Naive Bayes एल्गोरिद्म ने काफ़ी अच्छा प्रदर्शन किया है।
from sklearn.metrics import (
accuracy_score,
confusion_matrix,
ConfusionMatrixDisplay,
f1_score,
classification_report,
)
y_pred = model.predict(X_test)
accuray = accuracy_score(y_pred, y_test)
f1 = f1_score(y_pred, y_test, average="weighted")
print("Accuracy:", accuray)
print("F1 Score:", f1)Accuracy: 0.8206263840556786
F1 Score: 0.8686606980013266डेटा की असंतुलित प्रकृति के कारण, हम देख सकते हैं कि कन्फ्यूज़न मैट्रिक्स एक अलग तस्वीर दिखाता है। अल्पसंख्यक टार्गेट: not fully paid पर हमारी गलत लेबलिंग अधिक है।
labels = ["Fully Paid", "Not fully Paid"]
cm = confusion_matrix(y_test, y_pred)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=labels)
disp.plot();यदि आपको ट्रेनिंग या मॉडल मूल्यांकन के दौरान समस्याएँ आ रही हैं, तो आप Scikit-learn का उपयोग करते हुए Naive Bayes Classification ट्यूटोरियल का DataLab वर्कबुक देख सकते हैं। इसमें डेटासेट, सोर्स कोड और आउटपुट शामिल हैं।
शून्य प्रायिकता (Zero Probability) समस्या
मान लीजिए डेटासेट में जोखिम भरे लोन के लिए कोई ट्यूपल नहीं है; ऐसे में पश्च प्रायिकता शून्य होगी और मॉडल भविष्यवाणी नहीं कर पाएगा। इस समस्या को शून्य प्रायिकता कहा जाता है क्योंकि उस विशेष क्लास की उपस्थिति शून्य है।
ऐसी समस्या का समाधान लैप्लेशियन करेक्शन या लैप्लेस ट्रांसफॉर्मेशन है। लैप्लेशियन करेक्शन स्मूथिंग तकनीकों में से एक है। यहाँ आप मान सकते हैं कि डेटासेट इतना बड़ा है कि प्रत्येक क्लास की एक-एक पंक्ति जोड़ने से अनुमानित प्रायिकता पर कोई महत्वपूर्ण प्रभाव नहीं पड़ेगा। इससे प्रायिकता मानों के शून्य हो जाने की समस्या दूर हो जाती है।
उदाहरण के लिए: मान लें कि जोखिम भरे लोन क्लास के लिए डेटाबेस में 1000 ट्रेनिंग ट्यूपल हैं। इस डेटाबेस में, आय (income) कॉलम में लो इनकम के लिए 0 ट्यूपल, मीडियम इनकम के लिए 990 ट्यूपल और हाई इनकम के लिए 10 ट्यूपल हैं। लैप्लेशियन करेक्शन के बिना इन घटनाओं की प्रायिकताएँ क्रमशः 0, 0.990 (990/1000 से), और 0.010 (10/1000 से) हैं।
अब दिए गए डेटासेट पर लैप्लेशियन करेक्शन लागू करें। आइए प्रत्येक income-वैल्यू जोड़ी के लिए 1 ट्यूपल और जोड़ दें। इन घटनाओं की प्रायिकताएँ:
Naive Bayes के फायदे
- यह न केवल सरल विधि है बल्कि भविष्यवाणी के लिए तेज़ और सटीक तरीका भी है।
- Naive Bayes की गणनात्मक लागत बहुत कम है।
- यह बड़े डेटासेट पर कुशलतापूर्वक काम कर सकता है।
- सतत (continuous) वेरिएबल की तुलना में विविक्त (discrete) रिस्पॉन्स वेरिएबल के मामले में यह बेहतर प्रदर्शन करता है।
- इसे मल्टीपल क्लास प्रेडिक्शन समस्याओं में इस्तेमाल किया जा सकता है।
- टेक्स्ट एनालिटिक्स समस्याओं के मामले में भी यह अच्छा प्रदर्शन करता है।
- जब स्वतंत्रता की मान्यता सही बैठती है, तो Naive Bayes क्लासिफायर लॉजिस्टिक रिग्रेशन जैसे अन्य मॉडलों की तुलना में बेहतर प्रदर्शन करता है।
Naive Bayes की सीमाएँ
- फीचर्स के स्वतंत्र होने की मान्यता। व्यवहार में, पूरी तरह से स्वतंत्र प्रेडिक्टर्स का सेट मिलना लगभग असंभव है।
- यदि किसी विशेष क्लास का कोई ट्रेनिंग ट्यूपल नहीं है, तो इससे पश्च प्रायिकता शून्य हो जाती है। ऐसी स्थिति में मॉडल भविष्यवाणी करने में असमर्थ होता है। इसे शून्य प्रायिकता/आवृत्ति (Zero Probability/Frequency) समस्या कहते हैं।
निष्कर्ष
बधाई हो, आप इस ट्यूटोरियल के अंत तक पहुँच गए हैं!
इस ट्यूटोरियल में, आपने Naive Bayes एल्गोरिद्म, उसका कार्य, Naive Bayes की मान्यताएँ, समस्याएँ, इम्प्लीमेंटेशन, फायदे और सीमाएँ सीखी। साथ ही, आपने scikit-learn में बाइनरी और मल्टीनोमियल क्लासेज के लिए मॉडल बनाना और मूल्यांकन करना भी सीखा।
Naive Bayes सबसे सरल और प्रभावशाली एल्गोरिद्म है। पिछले कुछ वर्षों में मशीन लर्निंग में उल्लेखनीय प्रगति के बावजूद, इसने अपनी उपयोगिता साबित की है। इसे टेक्स्ट एनालिटिक्स से लेकर रिकमेंडेशन इंजन तक अनेक एप्लिकेशंस में सफलतापूर्वक लागू किया गया है।
यदि आप Python में scikit-learn के बारे में और सीखना चाहते हैं, तो हमारा Supervised Learning with scikit-learn कोर्स लें और Scikit-Learn ट्यूटोरियल: Baseball Analytics भाग 1 देखें।
मान लीजिए आप एक प्रोडक्ट मैनेजर हैं और ग्राहक समीक्षाओं को सकारात्मक और नकारात्मक वर्गों में वर्गीकृत करना चाहते हैं। या एक लोन मैनेजर के रूप में, आप पहचानना चाहते हैं कि कौन से लोन आवेदक सुरक्षित हैं या जोखिम भरे? एक हेल्थकेयर विश्लेषक के रूप में, आप यह पूर्वानुमान लगाना चाहते हैं कि कौन से मरीजों में डायबिटीज़ की समस्या हो सकती है। इन सभी उदाहरणों में समीक्षा, लोन आवेदक और मरीजों को वर्गीकृत करने जैसी ही समस्या है।
Naive Bayes सबसे सरल और तेज़ वर्गीकरण एल्गोरिद्म है, जो बड़े डेटा पर उपयुक्त है। Naive Bayes क्लासिफायर का सफलतापूर्वक उपयोग स्पैम फ़िल्टरिंग, टेक्स्ट वर्गीकरण, सेंटिमेंट एनालिसिस और रिकमेंडर सिस्टम जैसी कई एप्लिकेशंस में किया जाता है। यह अज्ञात वर्ग की भविष्यवाणी के लिए प्रायिकता के Bayes प्रमेय का प्रयोग करता है।
इस ट्यूटोरियल में, आप निम्न सभी के बारे में सीखेंगे:
इस ट्यूटोरियल के सभी उदाहरण कोड को स्वयं आसानी से चलाने के लिए, आप मुफ़्त में एक DataLab वर्कबुक बनाएं जिसमें Python पहले से इंस्टॉल है और सभी कोड नमूने मौजूद हैं। scikit-learn पर और अभ्यास के लिए, हमारा Supervised Learning with Scikit-learn कोर्स देखें!