

理解特征缩放
归一化和标准化都属于特征缩放这一概念。特征缩放是为机器学习模型准备数据的重要步骤。它通过将数据集中的特征值转换到相近的尺度,确保所有特征在模型的学习过程中贡献均衡。
特征缩放之所以重要,是因为当特征处于截然不同的尺度时,例如一个特征范围为 1 到 10,另一个为 1,000 到 10,000,模型可能会优先考虑较大的数值,从而在预测中产生偏差。这会导致模型性能不佳,并在训练时收敛更慢。
特征缩放通过调整数据范围而不扭曲数值间差异来解决这些问题。常见的缩放技术有多种,其中归一化与标准化最为常用。两者都能通过平衡特征影响、降低异常值影响,并在某些情况下提升收敛速度,帮助机器学习模型达到更优表现。
什么是归一化?
归一化是个广义概念,存在不同的实现方式。一般而言,归一化指将不同量纲的数值调整到一个共同尺度。有时用例子更直观。下面每种归一化方式中,我们都以一个模型为例,来理解房价与房屋面积之间的关系。
归一化的类型
来看一些主要类型。请注意,这并非完整清单:
最小-最大归一化
使用最小-最大归一化时,我们可能将房屋面积缩放到 0 到 1 的区间。这意味着最小的房屋面积表示为 0,最大的表示为 1。
对数归一化
对数归一化是另一种归一化技术。通过对数归一化,我们对房价应用对数变换。该技术有助于降低较大价格的影响,尤其当价格差异显著时。
小数定标
小数定标是另一种归一化技术。在本例中,我们可以通过移动小数点来缩小房屋面积的数值。这样既能将面积转换到更易处理的尺度,又能保持相对差异不变。
均值归一化(均值中心化)
在这里,均值归一化是指从每套房子的价格中减去平均价格。该过程将价格中心化到 0,展示每套房屋面积相对平均值的差异。这样我们可以分析哪些房屋面积高于或低于平均水平,从而更容易解读其相对价格。
何时应进行归一化?
正如上述示例所示,当数据分布未知或不符合高斯分布时,归一化尤为有用。房价就是很好的例子,因为有些房子非常非常昂贵,而模型并不总能很好地处理异常值。
因此,归一化的目标是构建更好的模型。我们可以对因变量进行归一化,使误差分布更均匀;也可以对自变量进行归一化,防止尺度更大的特征主导尺度较小的特征。
归一化在以下情形最为有效:
- 分布未知或非高斯分布:当数据分布未知或不符合正态(高斯)模式时。例如在线性回归中,我们可能希望对因变量进行归一化,使其更像钟形曲线,从而提升估计的置信度。
- 基于距离的算法:在使用依赖数据点间距离的算法(如k 近邻(k-NN))时需要归一化,以防止尺度较大的特征主导距离计算。
什么是标准化?
归一化将特征缩放到特定区间,而标准化(也称 z 分数缩放)则将数据转换为均值为 0、标准差为 1。该过程通过减去均值并除以标准差来调整特征值。您也许听过“中心化与缩放”。事实上,标准化说的就是这个:先中心化,再缩放。
标准化的公式为:
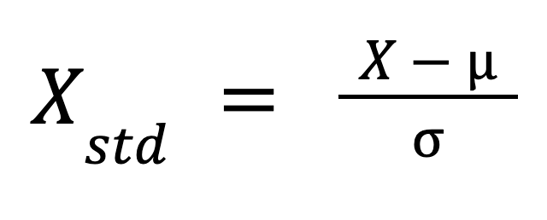
其中:
- X 为原始值,
- mu 为该特征的均值,且
- sigma 为该特征的标准差。
该公式将数据重新缩放,使其分布具有均值 0 和标准差 1。
何时应进行标准化?
标准化在以下情形最为合适:
- 基于梯度的算法:支持向量机(SVM)需要标准化数据才能获得最佳性能。虽然线性回归和逻辑回归并不强制要求标准化,但当特征量级差异较大时,标准化依然有益,可帮助均衡各特征的贡献并改进优化。
- 降维:在诸如PCA等降维技术中需要标准化,因为 PCA 识别的是数据方差最大的方向。仅做均值归一化并不足够,因为 PCA 同时考虑均值与方差,而不同的特征尺度会扭曲分析。
归一化 vs. 标准化:关键差异
有时,区分归一化和标准化并不容易。一方面,“归一化”有时被用作更通用的术语,而“标准化”的含义更具体、更技术化。另一方面,即便熟悉这些术语的数据分析师和数据科学家,也可能在适用场景上拿不准。
二者同为特征缩放技术,但在方法与应用上存在差异。理解这些差异有助于为您的机器学习模型选对技术。
重缩放方法
归一化将特征值缩放到预定义区间,通常为 0 到 1,这对特征尺度差异很大的模型尤其有用。相比之下,标准化将数据围绕均值(0)进行中心化,并按标准差(1)进行缩放。
对异常值的敏感性
不同的归一化技术在处理异常值时效果各异。均值归一化在某些场景下可有效调整异常值,但其他技术可能不如意。总体而言,归一化对异常值问题的处理不如标准化稳定,因为标准化明确依赖均值与标准差。
适用场景
归一化广泛用于诸如 k 近邻(k-NN)等基于距离的算法中,此类算法要求特征处于同一尺度以确保距离计算的准确性。另一方面,标准化对支持向量机(SVM)等基于梯度的算法至关重要,并常用于 PCA 等降维技术中,在这些场景下保持正确的特征方差很重要。
差异总结表
下面用一张总结表来梳理这些关键差异,便于比较归一化与标准化:
| 类别 | 归一化 | 标准化 |
|---|---|---|
| 重缩放方法 | 基于最小值和最大值将数据缩放到某一区间(通常为 0 到 1)。 | 将数据以均值(0)为中心,并按标准差(1)缩放。 |
| 对异常值的敏感性 | 若使用得当,归一化可在一定程度上调整异常值,具体取决于所用技术。 | 标准化在解决异常值问题上通常更为一致。 |
| 常见算法 | 常用于 k-NN 和神经网络等需要数据尺度一致的算法。 | 更适合需要特征具有共同尺度的算法,如逻辑回归、SVM 和 PCA。 |
差异可视化
为了理解归一化与标准化的差异,直观地查看它们的效果以及对模型性能的影响很有帮助。这里我展示了箱线图来对比不同的特征缩放技术。在这幅图中,我对数据集中的每个变量使用了最小-最大归一化。可以看到,没有任何值小于 0 或大于 1。
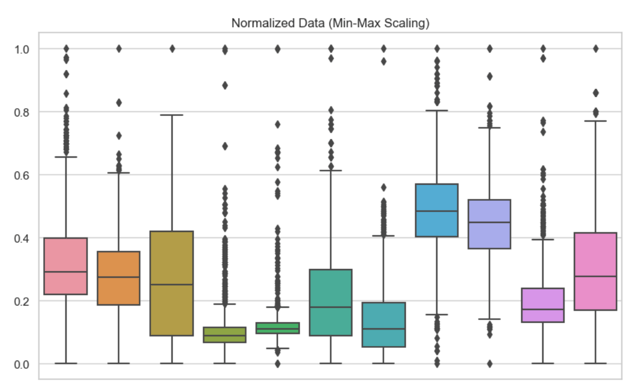
归一化后的数据。作者制图
在第二幅图中,我对每个变量使用了标准化。可以看到数据以 0 为中心分布。
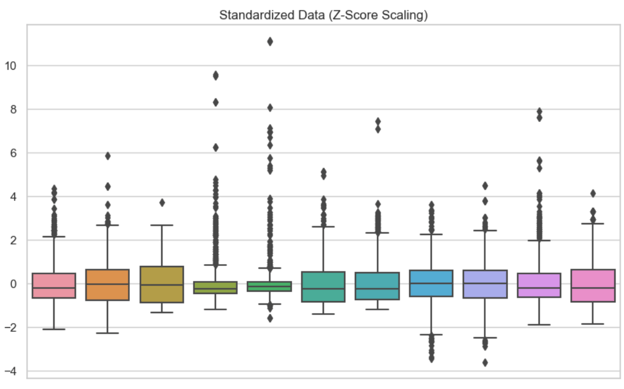 标准化后的数据。作者制图
优缺点
优点包括提升模型性能与平衡特征贡献。然而,归一化由于固定尺度,可能限制可解释性;而标准化同样会让解释变难,因为数值不再反映其原始单位。模型复杂度与准确性之间始终存在权衡。
线性回归中的归一化与标准化
我们来看看归一化(此处为均值归一化)和标准化如何改变简单线性回归模型的解读。各模型的 R 平方或调整后 R 平方将保持相同,因此这里的特征缩放主要影响对模型的解释。
| 应用的变换 | 自变量(房屋面积) | 因变量(房屋价格) | 解读 |
|---|---|---|---|
| 均值归一化 | 均值归一化 | 原始 | 您在预测的是:相对于平均面积的每一次变化,对原始房价的影响。 |
| 标准化 | 标准化 | 原始 | 您在预测的是:房屋面积每增加一个标准差,对原始房价的影响。 |
| 均值归一化 | 原始 | 均值归一化 | 您在预测的是:原始房屋面积每增加一个单位,对相对于平均值的房价的影响。 |
| 标准化 | 原始 | 标准化 | 您在预测的是:原始房屋面积每增加一个单位,对标准化后房价的影响。 |
| 均值归一化(双变量) | 均值归一化 | 均值归一化 | 您在预测的是:相对于平均面积的每一次变化,对相对于平均值的房价的影响。 |
| 标准化(双变量) | 标准化 | 标准化 | 您在预测的是:房屋面积每增加一个标准差,对标准化后房价的影响。 |
另一个重要说明是,在线性回归中,如果您对自变量和因变量都进行标准化,R 平方将保持不变。这是因为 R 平方衡量的是 y 的方差中由 x 解释的比例,而这一比例不随是否标准化而改变。不过,标准化因变量会改变 RMSE,因为 RMSE 的单位与因变量相同。由于 y 已被标准化,标准化后 RMSE 会更低。具体而言,它将以标准化变量的标准差为单位来反映误差,而非原始单位。如果您对回归特别感兴趣,欢迎学习我们的Python 中使用 statsmodels 的回归入门课程以精进技能。
结语
特征缩放(包含归一化与标准化)是机器学习数据预处理的关键组成部分。理解各自适用的场景,能显著提升模型的性能与准确性。
如果您希望拓展并加深对特征缩放及其在机器学习中作用的理解,DataCamp 提供多项优质资源助您起步。您可以先阅读我们的机器学习中的归一化文章打好基础,或选修我们的端到端机器学习课程,了解真实应用。
资深数据从业者与写作者,热衷于帮助有志于数据领域的专业人士成长与精进。
准确地准备数据对于模型性能和结果解读都至关重要。这正是归一化与标准化发挥作用的核心场景——这两种关键的特征缩放技术可用于调整数据以提升性能,或帮助更好地解读结果。
本文将带您理清相关术语,并帮助您了解归一化与标准化在实践中的差异。读完后,您将知道在数据预处理流程中何时使用哪一种。熟悉归一化和标准化将有助于提升模型表现、更好地解释结果,并避免未缩放数据常见的陷阱。这些细微差别在机器学习领域非常重要。如果您认真想成为专家,欢迎报名我们的Python 机器学习科学家职业路径。