{count, plural, one {कोर्स} other {कोर्स}}
R परिचय
{hours} घंटा
3.1M

scale() से अपना डेटा सामान्यीकृत करें ताकि सभी वेरिएबल्स का योगदान समान रहेFactoMineR और factoextra पैकेजों के साथ princomp() या prcomp() का उपयोग करेंइस ट्यूटोरियल के साथ आगे बढ़ने के लिए आपके पास होना चाहिए:
corrr, ggcorrplot, FactoMineR, factoextra (इंस्टॉलेशन ट्यूटोरियल में कवर है)भले ही हमारा फोकस PCA पर है, आइए उन पाँच प्रमुख प्रिंसिपल कंपोनेंट तकनीकों को याद रखें जिनका लक्ष्य बहुविविक (मल्टिवेरिएट) डेटा को सारांशित और विज़ुअलाइज़ करना है। अन्य तकनीकों के विपरीत, PCA केवल मात्रात्मक वेरिएबल्स के साथ काम करता है।

प्रिंसिपल कंपोनेंट विधियाँ
हम यहाँ जटिल गणितीय अवधारणा का विवरण नहीं देंगे। लेकिन निम्नलिखित पाँच चरण समझने से PCA की गणना का बेहतर अंदाज़ा मिलेगा।

प्रिंसिपल कंपोनेंट्स की गणना के पाँच मुख्य चरण
परिचय में दिए उदाहरण के अनुसार, किसी एक ग्राहक के लिए मान लें हमारे पास निम्न जानकारी है।
यह जानकारी अलग-अलग स्केल पर है और इस तरह के डेटा पर PCA करने से पूर्वाग्रहित परिणाम मिल सकते हैं। यही वह जगह है जहाँ डेटा सामान्यीकरण उपयोगी है। यह सुनिश्चित करता है कि हर विशेषता का योगदान एक जैसा हो, ताकि कोई एक वेरिएबल दूसरों पर हावी न हो। प्रत्येक वेरिएबल के लिए, सामान्यीकरण उसके औसत को घटाकर और मानक विचलन से भाग देकर किया जाता है।
नाम से स्पष्ट है कि यह चरण सामान्यीकृत डेटा से कोवैरेअंस मैट्रिक्स निकालने का है। यह एक सममित मैट्रिक्स है और प्रत्येक तत्व (i, j) वेरिएबल i और j के बीच कोवैरेअंस को दर्शाता है।
ज्यामितीय रूप से, आइजनवेक्टर एक दिशा दर्शाता है, जैसे “वर्टिकल” या “90 डिग्री”। दूसरी ओर, आइजनवैल्यू किसी दी गई दिशा में डेटा में उपस्थित वैरिएंस की मात्रा को दर्शाने वाली संख्या है। प्रत्येक आइजनवेक्टर का एक संबंधित आइजनवैल्यू होता है।
डेटा में जितने वेरिएबल होते हैं, उतनी ही जोड़ी आइजनवेक्टर और आइजनवैल्यू की होती है। केवल मासिक खर्च, आयु और रेट के डेटा में तीन जोड़ियाँ होंगी। सभी जोड़ियाँ प्रासंगिक नहीं होतीं। इसलिए, सबसे बड़े आइजनवैल्यू वाला आइजनवेक्टर पहला प्रिंसिपल कंपोनेंट होता है। दूसरा प्रिंसिपल कंपोनेंट दूसरे सबसे बड़े आइजनवैल्यू वाला आइजनवेक्टर होता है, और इसी तरह आगे।
इस चरण में मूल डेटा को प्रिंसिपल कंपोनेंट्स द्वारा परिभाषित नए सबस्पेस पर फिर से उन्मुख (re-orient) किया जाता है। यह पहले से निकाले आइजनवेक्टर से मूल डेटा को गुणा करके किया जाता है।
यह याद रखना महत्वपूर्ण है कि यह रूपांतरण मूल डेटा को बदलता नहीं है, बल्कि डेटा का बेहतर प्रतिनिधित्व देने के लिए एक नया दृष्टिकोण प्रदान करता है।
प्रिंसिपल कंपोनेंट एनालिसिस के हमारे रोज़मर्रा के जीवन में कई उपयोग हैं, जैसे वित्त, इमेज प्रोसेसिंग, हेल्थकेयर और सुरक्षा—पर सीमित नहीं।
पिछली कीमतों से स्टॉक कीमतों का पूर्वानुमान लगाना वर्षों से शोध का विषय रहा है। PCA का उपयोग डायमेंशनलिटी रिडक्शन और डेटा विश्लेषण के लिए किया जा सकता है ताकि विशेषज्ञ उन प्रमुख कंपोनेंट्स को खोज सकें जो डेटा की अधिकांश विविधता को समझाते हैं। आप हमारे समर्पित कोर्स में R में डायमेंशनलिटी रिडक्शन के बारे में और जान सकते हैं।
एक इमेज कई फीचर्स से बनी होती है। PCA मुख्यतः इमेज कंप्रेशन में लागू होता है ताकि आयाम घटाते हुए किसी तस्वीर के आवश्यक विवरण बनाए रखे जा सकें। इसके अलावा, PCA का उपयोग इमेज रिकग्निशन जैसे अधिक जटिल कार्यों में भी किया जा सकता है।
इमेज कंप्रेशन की ही तर्ज पर, PCA का उपयोग मैग्नेटिक रेज़ोनेंस इमेजिंग (MRI) स्कैन में इमेज की डायमेंशनलिटी घटाने के लिए किया जाता है ताकि बेहतर विज़ुअलाइज़ेशन और चिकित्सीय विश्लेषण हो सके। इसे उन चिकित्सा तकनीकों में भी एकीकृत किया जा सकता है जो, उदाहरण के लिए, इमेज स्कैन से किसी बीमारी की पहचान करती हैं।
फिंगरप्रिंट रिकग्निशन के लिए उपयोग होने वाली बायोमेट्रिक प्रणालियाँ, फिंगरप्रिंट की बनावट और अन्य जानकारी जैसे सबसे प्रासंगिक फीचर्स निकालने के लिए प्रिंसिपल कंपोनेंट एनालिसिस का उपयोग करने वाली तकनीकों को शामिल कर सकती हैं।
अब जब आप PCA के बुनियादी सिद्धांत समझ गए हैं, तो आइए इसे व्यवहार में देखते हैं।
इस भाग में संबंधित पैकेज इंस्टॉल करने से लेकर डेटा लोड और तैयार करना, R में प्रिंसिपल कंपोनेंट एनालिसिस लागू करना, और परिणामों की व्याख्या करना—सभी चरण शामिल हैं।
सोर्स कोड DataLab पर उपलब्ध है।
इस ट्यूटोरियल को सफलतापूर्वक करने के लिए आपको निम्न लाइब्रेरीज़ चाहिए होंगी, और हर एक को प्रभावी उपयोग के लिए दो मुख्य चरणों की ज़रूरत होगी:
यह सहसंबंध विश्लेषण के लिए R पैकेज है। यह मुख्यतः R डेटा फ़्रेम्स बनाने और हैंडल करने पर केंद्रित है। नीचे लाइब्रेरी इंस्टॉल और लोड करने के चरण दिए गए हैं।
install.packages("corrr")
library('corrr')ggcorrplot पैकेज कई फ़ंक्शंस देता है, जिनमें ggplot2 पर आधारित फ़ंक्शंस भी हैं, जो कोरिलेशन मैट्रिक्स को विज़ुअलाइज़ करना आसान बनाते हैं। ऊपर की तरह, इसका इंस्टॉलेशन भी सीधा है।
install.packages("ggcorrplot")
library(ggcorrplot)मुख्यतः मल्टिवेरिएट एक्सप्लोरेटरी डेटा एनालिसिस के लिए उपयोग होता है; factoMineR पैकेज PCA मॉड्यूल तक पहुँच देता है जिससे प्रिंसिपल कंपोनेंट एनालिसिस की जा सके।
install.packages("FactoMineR")
library("FactoMineR")यह अंतिम पैकेज प्रिंसिपल कंपोनेंट एनालिसिस के आउटपुट्स को विज़ुअलाइज़ करने के लिए सभी प्रासंगिक फ़ंक्शंस देता है। इनमें स्क्री प्लॉट, बाइप्लॉट शामिल हैं—जिनमें से दो तकनीकों को आगे कवर किया गया है।
install.packages("factoextra")
library(factoextra)
डेटा लोड करने और आगे की जाँच से पहले, जिस डेटा पर आप काम करेंगे उससे संबंधित बुनियादी जानकारी समझ लेना अच्छा रहता है।
प्रोटीन डेटासेट 25 यूरोपीय देशों के नागरिकों द्वारा औसत प्रोटीन खपत का वास्तविक मानों वाला बहुविविक डेटासेट है।
प्रत्येक देश के लिए दस कॉलम हैं। पहले आठ विभिन्न प्रकार के प्रोटीन को दर्शाते हैं। आखिरी कॉलम प्रोटीन के औसत मानों के कुल मान से संबंधित है।
आइए डेटा का एक त्वरित अवलोकन करें।
पहले हम read.csv() फ़ंक्शन से डेटा लोड करते हैं, फिर str() चलाते हैं, जो नीचे दी गई इमेज जैसा आउटपुट देता है।
protein_data <- read.csv("protein.csv")
str(protein_data)
हम देखते हैं कि डेटासेट में 25 ऑब्ज़र्वेशंस और 11 कॉलम हैं। Country कॉलम को छोड़कर हर वेरिएबल संख्यात्मक है, Country एक कैरेक्टर स्ट्रिंग है।

प्रोटीन डेटा का विवरण
मिसिंग वैल्यूज़ की मौजूदगी PCA के परिणाम को पक्षपाती बना सकती है। इसलिए, उन मानों से निपटने के लिए उपयुक्त तरीका अपनाना अत्यधिक अनुशंसित है। हमारा Top Techniques to Handle Missing Values Every Data Scientist Should Know ट्यूटोरियल आपके लिए सही विकल्प चुनने में मदद कर सकता है।
colSums(is.na(protein_data))colSums() फ़ंक्शन को is.na() के साथ मिलाकर हर कॉलम में मिसिंग वैल्यूज़ की संख्या देता है। जैसा कि नीचे दिखता है, किसी भी कॉलम में मिसिंग वैल्यू नहीं है।

हर कॉलम में मिसिंग वैल्यूज़ की संख्या
जैसा कि लेख में पहले बताया गया, PCA केवल संख्यात्मक मानों के साथ काम करता है। इसलिए, हमें Country कॉलम हटाना होगा। साथ ही, Total कॉलम विश्लेषण में प्रासंगिक नहीं है क्योंकि यह बाकी संख्यात्मक वेरिएबल्स का रैखिक संयोजन है।
नीचे दिया कोड केवल संख्यात्मक कॉलम्स वाला नया डेटा बनाता है।
numerical_data <- protein_data[,2:10]

head(numerical_data)
डेटा के सामान्यीकरण से पहले (केवल पहली पाँच कॉलम दिखाई गई हैं)
अब, scale() फ़ंक्शन से सामान्यीकरण लागू किया जा सकता है।
data_normalized <- scale(numerical_data)
head(data_normalized)
सामान्यीकृत डेटा (केवल पहली पाँच कॉलम दिखाई गई हैं)
PCA चलाने से पहले वेरिएबल्स के बीच सहसंबंधों को विज़ुअलाइज़ करना इस बात की पुष्टि करता है कि PCA प्रभावी होगा। उच्च पार-सहसंबंध इंगित करते हैं कि अनावश्यकता है, जिसे PCA संकुचित कर सकता है। मैं ऊपर इंस्टॉल किए गए corrr और ggcorrplot पैकेजों का उपयोग करूँगा।
corr_matrix <- cor(data_normalized)
ggcorrplot(corr_matrix,
           hc.order = TRUE,
           type = "lower",
           lab = TRUE)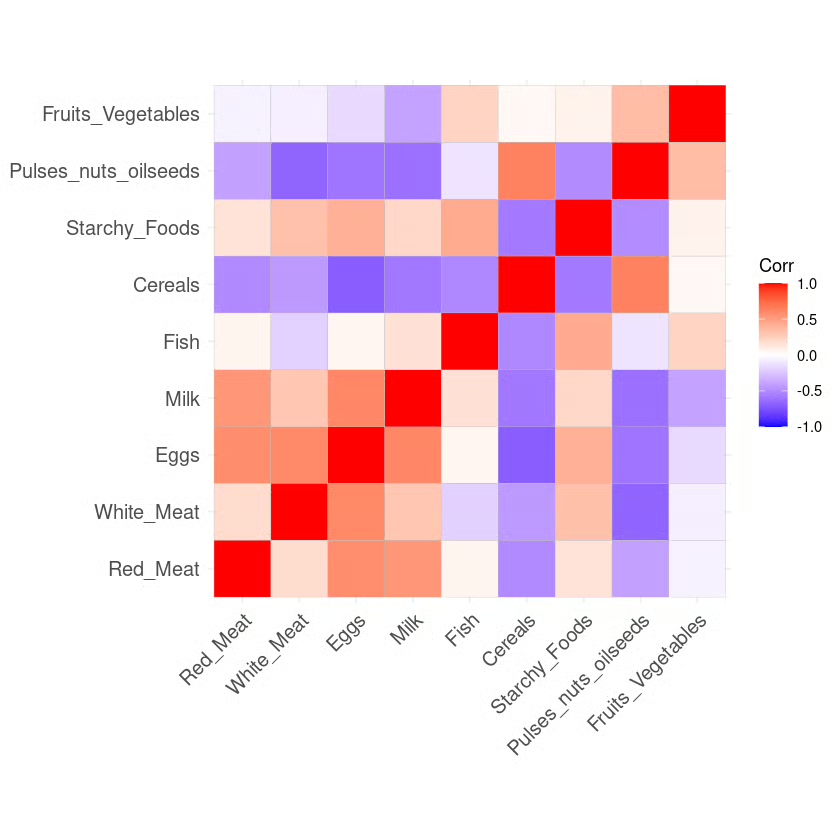
हीटमैप से पशु-आधारित प्रोटीन स्रोतों (रेड मीट, व्हाइट मीट, एग्स और मिल्क) के बीच प्रबल सकारात्मक सहसंबंध दिखते हैं, जो बताता है कि पहला प्रिंसिपल कंपोनेंट कुल वैरिएंस का लगभग 77% क्यों पकड़ता है। यही सहसंबंध संरचना है जिसका लाभ उठाने के लिए PCA डिज़ाइन किया गया है।
R में PCA फ़ंक्शंस पर टिप्पणी: यह ट्यूटोरियल princomp() का उपयोग करता है, जो कोवैरेअंस मैट्रिक्स पर स्पेक्ट्रल डीकंपोज़िशन लागू करता है। अधिकांश व्यावहारिक मामलों में prcomp() अधिक उपयुक्त विकल्प है — यह सिंगुलर वैल्यू डीकंपोज़िशन (SVD) का उपयोग करता है, जो बहुत से वेरिएबल्स वाले डेटासेट्स के लिए संख्यात्मक रूप से अधिक स्थिर है। मुख्य आउटपुट अंतर: princomp() लोडिंग्स को $loadings में रखता है, जबकि prcomp() $rotation का उपयोग करता है। अच्छे-कंडीशन्ड डेटा (जैसे यह प्रोटीन डेटासेट) पर दोनों समतुल्य परिणाम देते हैं।
अब PCA विश्लेषण करने के लिए सब संसाधन उपलब्ध हैं। पहले princomp() PCA की गणना करता है, और summary() फ़ंक्शन परिणाम दिखाता है।
data.pca <- princomp(data_normalized)
summary(data.pca)
R PCA सारांश
पिछले स्क्रीनशॉट से हम देखते हैं कि नौ प्रिंसिपल कंपोनेंट्स बने हैं (Comp.1 से Comp.9), जो डेटा में वेरिएबल्स की संख्या के बराबर हैं।
प्रत्येक कंपोनेंट डेटा सेट की कुल वैरिएंस का एक प्रतिशत समझाता है। Cumulative Proportion सेक्शन में, पहला प्रिंसिपल कंपोनेंट कुल वैरिएंस का लगभग 77% समझाता है। इसका अर्थ है कि 9 वेरिएबल्स के सेट का लगभग दो-तिहाई हिस्सा केवल पहले प्रिंसिपल कंपोनेंट से दर्शाया जा सकता है। दूसरा 12.08% कुल वैरिएंस समझाता है।
Comp.1 और Comp.2 का समेकित अनुपात कुल वैरिएंस का करीब 89% समझाता है। यानी पहले दो प्रिंसिपल कंपोनेंट्स डेटा का सटीक प्रतिनिधित्व कर सकते हैं।
पहले दो कंपोनेंट्स मिल गए, लेकिन वे वास्तव में मतलब क्या रखते हैं?
इसका उत्तर प्रत्येक कॉलम से उनके संबंधों को, प्रत्येक प्रिंसिपल कंपोनेंट की लोडिंग्स के ज़रिये देखकर मिल सकता है।
data.pca$loadings[, 1:2]
पहले दो प्रिंसिपल कंपोनेंट्स की लोडिंग मैट्रिक्स
लोडिंग मैट्रिक्स दर्शाती है कि पहले प्रिंसिपल कंपोनेंट में रेड मीट, व्हाइट मीट, एग्स और मिल्क के लिए उच्च धनात्मक मान हैं। जबकि सीरियल्स, पल्सेज़, नट्स और ऑयलसीड्स, तथा फ्रूट्स और वेजिटेबल्स के मान अपेक्षाकृत ऋणात्मक हैं। यह संकेत देता है कि जिन देशों में पशु-आधारित प्रोटीन का सेवन अधिक है वे अधिशेष में हैं, जबकि कम सेवन वाले देश घाटे में हैं।
दूसरे प्रिंसिपल कंपोनेंट की बात करें तो इसमें फिश, स्टार्ची फूड्स और फ्रूट्स-एंड-वेजिटेबल्स के लिए उच्च ऋणात्मक मान हैं। यह दर्शाता है कि देशों के आहार पर उनके भौगोलिक स्थान का गहरा प्रभाव है—जैसे तटीय क्षेत्रों में मछली, और अंतर्देशीय क्षेत्रों में सब्ज़ियों व आलू पर आधारित आहार।
लोडिंग मैट्रिक्स के पिछले विश्लेषण ने पहले दो प्रिंसिपल कंपोनेंट्स और डेटा की विशेषताओं के बीच संबंधों की अच्छी समझ दी, पर यह दृश्य रूप से बहुत आकर्षक न लगे।
कुछ मानक विज़ुअलाइज़ेशन रणनीतियाँ उपयोगकर्ता को डेटा से अंतर्दृष्टि निकालने में मदद करती हैं, और यह खंड स्क्री प्लॉट से शुरू करते हुए उन तरीकों में से कुछ को कवर करता है।
सूची का पहला तरीका स्क्री प्लॉट है। इसका उपयोग हर प्रिंसिपल कंपोनेंट के महत्व को दर्शाने और यह तय करने के लिए किया जाता है कि कितने कंपोनेंट रखने चाहिए। स्क्री प्लॉट fviz_eig() फ़ंक्शन से बनाया जा सकता है।
fviz_eig(data.pca, addlabels = TRUE)
कंपोनेंट्स का स्क्री प्लॉट
यह प्लॉट सबसे बड़े से सबसे छोटे तक घटती वक्र में आइजनवैल्यूज़ दिखाता है। पहले दो कंपोनेंट्स को सबसे महत्वपूर्ण माना जा सकता है क्योंकि इनमें डेटा की कुल जानकारी का लगभग 89% समाहित है।
बाइप्लॉट के साथ सैंपल्स के बीच समानताएँ और असमानताएँ देखी जा सकती हैं, और यह प्रत्येक एट्रिब्यूट का प्रत्येक प्रिंसिपल कंपोनेंट पर प्रभाव भी दिखाता है।
# वेरिएबल्स का ग्राफ
fviz_pca_var(data.pca, col.var = "black")
प्रिंसिपल कंपोनेंट्स के संदर्भ में वेरिएबल्स का बाइप्लॉट
पिछले प्लॉट से तीन मुख्य जानकारियाँ देखी जा सकती हैं।
तीसरे विज़ुअलाइज़ेशन का लक्ष्य यह निर्धारित करना है कि किसी दिए गए कंपोनेंट में प्रत्येक वेरिएबल कितना प्रस्तुत होता है। इस प्रतिनिधित्व की गुणवत्ता को Cos2 कहा जाता है और यह स्क्वेयर कोसाइन के अनुरूप है; इसे fviz_cos2() फ़ंक्शन से निकाला जाता है।
fviz_cos2(data.pca, choice = "var", axes = 1:2)ऊपर दिया कोड पहले दो प्रिंसिपल कंपोनेंट्स के संदर्भ में प्रत्येक वेरिएबल के लिए स्क्वेयर कोसाइन मान की गणना करता है।
नीचे के चित्र से, cereals, pulse nut oilseeds, eggs और milk वे शीर्ष चार वेरिएबल्स हैं जिनके cos2 सबसे अधिक हैं, अतः वे PC1 और PC2 में सबसे अधिक योगदान देते हैं।

प्रिंसिपल कंपोनेंट्स में वेरिएबल्स का योगदान
आखिरी दो विज़ुअलाइज़ेशन—बाइप्लॉट और एट्रिब्यूट्स का महत्व—को मिलाकर एक ही बाइप्लॉट बनाया जा सकता है, जहाँ समान cos2 स्कोर वाले एट्रिब्यूट्स के रंग भी समान होंगे। यह fviz_pca_var फ़ंक्शन को इस प्रकार फाइन-ट्यून करके किया जाता है:
fviz_pca_var(data.pca, col.var = "cos2",
            gradient.cols = c("black", "orange", "green"),
            repel = TRUE)
नीचे दिए बाइप्लॉट से:

बाइप्लॉट और cos2 स्कोर का संयोजन
दो व्यवहारिक नियम यह तय करने में मदद करते हैं कि कितने प्रिंसिपल कंपोनेंट्स रखने हैं:
इस ट्यूटोरियल में, मैंने प्रिंसिपल कंपोनेंट एनालिसिस क्या है और डेटा एनालिटिक्स में इसकी महत्ता को कवर किया। गणितीय नींव से लेकर हाथ-से-हाथ R कोड तक, हमने प्रोटीन डेटासेट पर एक संपूर्ण PCA वर्कफ़्लो देखा — सामान्यीकरण और princomp() लागू करने से लेकर स्क्री प्लॉट, बाइप्लॉट और cos2 विज़ुअलाइज़ेशन की व्याख्या तक — ताकि प्रिंसिपल कंपोनेंट्स और मूल वेरिएबल्स के बीच संबंध समझ सकें।
इन तकनीकों को लागू कर अपनी डायमेंशनलिटी घटाएँ, छिपी संरचना उजागर करें, और अपने डेटासेट्स के साथ क्लीनर मशीन लर्निंग पाइपलाइंस बनाएँ।
और आगे बढ़ने के लिए, ये संबंधित संसाधन देखें:
R के लिए कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}