Cursus
Introductie tot R
4 uur
3.1M
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenWil je meer leren over het manipuleren van data in R met dplyr? Bekijk dan onze cursus Data Manipulation in R with dplyr.
Om te begrijpen wat de pipe-operator in R is en wat je ermee kunt, is het nodig om het volledige plaatje te bekijken en de geschiedenis erachter te leren kennen. Vragen als "waar komt deze vreemde combinatie van symbolen vandaan en waarom is die zo gemaakt?" komen misschien als eerste bij je op. In dit onderdeel ontdek je de antwoorden op deze en meer vragen.
Je kunt die geschiedenis vanuit drie perspectieven bekijken: vanuit een wiskundig standpunt, vanuit een holistisch perspectief op programmeertalen en vanuit het standpunt van de R-taal zelf. Je komt alle drie aan bod in wat volgt!
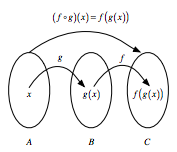
Als je twee functies hebt, stel $f : B → C$ en $g : A → B$, dan kun je deze functies aan elkaar schakelen door de output van de ene functie in de volgende te stoppen. Kort gezegd betekent "chaining" dat je een tussentijds resultaat doorgeeft aan de volgende functie, maar daar zie je later meer over.
Je kunt bijvoorbeeld zeggen $f(g(x))$: $g(x)$ dient als input voor f(), terwijl $x$ natuurlijk als input voor g() dient.
Als je dit wilt noteren, gebruik je de notatie $f ◦ g$, wat je leest als "f volgt op g". Je kunt dit ook visueel voorstellen als:
Zoals in de inleiding van dit onderdeel al vermeld, is deze operator niet nieuw in programmeren: in de Shell of Terminal kun je commando’s doorgeven met het pipeline-teken |. Op een vergelijkbare manier heeft F# een forward pipe-operator, die later nog belangrijk zal blijken! Tot slot is het goed om te weten dat Haskell veel piping-operaties bevat die zijn afgeleid van de Shell of Terminal.
Nu je wat geschiedenis van de pipe-operator in andere programmeertalen hebt gezien, is het tijd om je op R te richten. De geschiedenis van deze operator in R begint op 17 januari 2012, toen een anonieme gebruiker de volgende vraag stelde in deze Stack Overflow-post:
Hoe kun je de forward pipe-operator van F# in R implementeren? Met de operator kun je eenvoudig een reeks berekeningen aan elkaar schakelen. Als je bijvoorbeeld inputdata hebt en de functies
fooenbarachtereenvolgens wilt aanroepen, kun je dandata |> foo |> barschrijven?
Het antwoord kwam van Ben Bolker, professor aan McMaster University, die reageerde:
Ik weet niet hoe goed dit echt gebruik zou doorstaan, maar dit lijkt (?) te doen wat je wilt, in elk geval voor functies met één argument ...
"%>%" <- function(x,f) do.call(f,list(x))
pi %>% sin
[1] 1.224606e-16
pi %>% sin %>% cos
[1] 1
cos(sin(pi))
[1] 1
Ongeveer negen maanden later startte Hadley Wickham het dplyr-pakket op GitHub. Je kent Hadley, Chief Scientist bij RStudio, waarschijnlijk als de auteur van veel populaire R-pakketten (zoals dit laatste pakket!) en als docent van onze cursus Introduction to Writing Functions in R.
Maar pas in 2013 verscheen de eerste pipe %.% in dit pakket. Zoals Adolfo Álvarez terecht vermeldt in zijn blogpost, heette de functie chain(), met als doel de notatie te vereenvoudigen voor het toepassen van meerdere functies op één data frame in R.
De %.%-pipe bleef niet lang bestaan, want op 29 december 2013 stelde Stefan Bache een alternatief voor dat de operator bevatte zoals je die nu wellicht kent:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Bache werkte verder met deze pipe-operatie en eind 2013 ontstond het magrittr-pakket. Ondertussen werkte Hadley Wickham verder aan dplyr en in april 2014 werd de %.%-operator vervangen door de operator die je nu kent, %>%.
Later dat jaar publiceerde Kun Ren het pipeR-pakket op GitHub, met een andere pipe-operator, %>>%, die ontworpen was om meer flexibiliteit toe te voegen aan het pipingproces. Toch kun je gerust stellen dat %>% inmiddels ingeburgerd is in de R-taal, zeker met de recente populariteit van de Tidyverse.
De geschiedenis kennen is één ding, maar dat vertelt nog niet wat de forward pipe-operator van F# is, noch wat die precies doet in R.
In F# is de pipe-forward-operator |> syntactische suiker voor aaneengeschakelde methode-aanroepen. Simpeler gezegd: hij laat je een tussentijds resultaat doorgeven aan de volgende functie.
Onthoud dat "chaining" betekent dat je meerdere methode-aanroepen achter elkaar uitvoert. Omdat elke methode een object retourneert, kun je de aanroepen in één statement aan elkaar rijgen, zonder variabelen nodig te hebben om tussentijdse resultaten op te slaan.
In R is de pipe-operator, zoals je al zag, %>%. Als je F# niet kent, kun je deze operator zien als vergelijkbaar met de + in een ggplot2-statement. De functie is erg vergelijkbaar met die van de F#-operator: hij neemt de output van het ene statement en maakt die de input van het volgende statement. Je kunt hem bij het beschrijven zien als een "DAN".
Neem bijvoorbeeld de volgende codeblok en lees die hardop:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Precies, de bovenstaande code komt neer op zoiets als: "je neemt de Iris-data, dan subsett je de data en dan aggregeer je de data".
Dit is een van de krachtigste dingen aan de Tidyverse. Een gestandaardiseerde keten van bewerkingen heet een "pipeline". Pipelines maken voor een dataformaat is geweldig, want je kunt die pipeline toepassen op binnenkomende data met dezelfde opmaak en bijvoorbeeld laten uitkomen in een ggplot2-vriendelijk formaat.
R is een functionele taal, wat betekent dat je code vaak veel haakjes bevat, ( en ). Bij complexe code moet je die haakjes vaak nesten. Dat maakt je R-code moeilijk te lezen en te begrijpen. Hier komt %>% goed van pas!
Kijk naar het volgende voorbeeld, een typisch voorbeeld van geneste code:
# Initialiseer `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)

# Bereken de logaritme van `x`, geef geschikt vertragings- en differentieerresultaat,
# bereken de exponentiële functie en rond het resultaat af
round(exp(diff(log(x))), 1)
Met behulp van %<% kun je de bovenstaande code als volgt herschrijven:
# Importeer `magrittr`
library(magrittr)

# Voer dezelfde berekeningen op `x` uit als hierboven
x %>% log() %>%
    diff() %>%
    exp() %>%
    round(1)
Lijkt dit moeilijk? Geen zorgen! Later in deze tutorial leer je hier meer over.
Let op dat je de magrittr-bibliotheek moet importeren om de bovenstaande code te laten werken. Dat komt omdat de pipe-operator, zoals je hierboven las, onderdeel is van de magrittr-bibliotheek en sinds 2014 ook onderdeel van dplyr. Als je vergeet de bibliotheek te importeren, krijg je een fout als Error in eval(expr, envir, enclos): could not find function "%>%".
Merk ook op dat het geen formele vereiste is om haakjes toe te voegen na log, diff en exp, maar binnen de R-community gebruiken sommigen ze om de leesbaarheid te vergroten.
Kort samengevat, hier zijn vier redenen om pipes in R te gebruiken:
Deze redenen zijn overgenomen uit de magrittr-documentatie zelf. Impliciet zie je de argumenten van leesbaarheid en flexibiliteit terugkomen.
Hoewel %>% de (hoofd)pipe-operator van het magrittr-pakket is, zijn er nog een paar andere operators die je moet kennen en die deel uitmaken van hetzelfde pakket:
%<>%;# Initialiseer `x`
x <- rnorm(100)
# Werk de waarde van `x` bij en wijs die toe aan `x`
x %<>% abs %>% sort
%T>%;rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Let op dat het goed is om te weten dat het bovenstaande codeblok eigenlijk een verkorte notatie is voor:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
Maar daar zie je later meer over!
%$%.data.frame(z = rnorm(100)) %$%
ts.plot(z)
Natuurlijk werken deze drie operators net iets anders dan de hoofdoperator %>%. Later in deze tutorial zie je meer over hun functionaliteit en gebruik.
Let op dat je, hoewel je meestal de magrittr-pipes zult zien, ook andere pipes kunt tegenkomen! Enkele voorbeelden zijn de dot arrow pipe %.>% of to dot pipe %>.% van wrapr, of de Bizarro-pipe ->.;.
Nu je weet hoe de %>%-operator is ontstaan, wat het precies is en waarom je hem zou moeten gebruiken, is het tijd om te ontdekken hoe je hem in je voordeel gebruikt. Je zult zien dat er best wat manieren zijn om hem te gebruiken!
Voordat je ingaat op de meer geavanceerde toepassingen van de operator, is het goed om eerst de meest basale voorbeelden te bekijken die de operator gebruiken. In essentie zijn er drie regels die je kunt volgen als je net begint:
f(x) kan worden herschreven als x %>% fKort gezegd betekent dit dat functies die één argument nemen, functie(argument), als volgt herschreven kunnen worden: argument %>% functie(). Bekijk het volgende, meer praktische voorbeeld om te begrijpen hoe deze twee gelijkwaardig zijn:
# Bereken de logaritme van `x`
log(x)
# Bereken de logaritme van `x`
x %>% log()
f(x, y) kan worden herschreven als x %>% f(y)Er zijn natuurlijk veel functies die niet slechts één argument nemen, maar meerdere. Dat is hier het geval: je ziet dat de functie twee argumenten neemt, x en y. Vergelijkbaar met wat je in het eerste voorbeeld zag, kun je de functie herschrijven volgens de structuur argument1 %>% functie(argument2), waarbij argument1 de magrittr-placeholder is en argument2 de functiebel.
Dit lijkt allemaal vrij theoretisch. Laten we een praktischer voorbeeld bekijken:
# Rond pi af
round(pi, 6)
# Rond pi af
pi %>% round(6)
x %>% f %>% g %>% h kan worden herschreven als h(g(f(x)))Dit lijkt misschien complex, maar in een R-voorbeeld uit de praktijk valt dat mee:
# Importeer `babynames`-data
library(babynames)
# Importeer `dplyr`-bibliotheek
library(dplyr)
# Laad de data
data(babynames)
# Tel hoeveel jongetjes met de naam "Taylor" zijn geboren
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# Doe hetzelfde maar nu met `%>%`
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
Let op hoe je van binnen naar buiten werkt wanneer je de geneste code herschrijft: je stopt eerst de babynames erin, dan gebruik je %>% om eerst de data te filter()en. Daarna selecteer je n en tot slot sum() je alles.
Onthoud ook dat je eerder in deze tutorial al een ander voorbeeld zag van zulke geneste code die werd omgezet naar leesbaardere code, waar je de functies log(), diff(), exp() en round() gebruikte om berekeningen op x uit te voeren.
Helaas zijn er enkele uitzonderingen op de algemene regels uit de vorige sectie. Laten we er hier een paar bekijken.
Bekijk dit voorbeeld, waarin je de functie assign() gebruikt om de waarde 10 toe te wijzen aan de variabele x.
# Wijs `10` toe aan `x`
assign("x", 10)
# Wijs `100` toe aan `x`
"x" %>% assign(100)
# Geef `x` terug
x
10
Je ziet dat de tweede aanroep met de functie assign(), in combinatie met de pipe, niet goed werkt. De waarde van x wordt niet bijgewerkt.
Waarom is dat?
Omdat de functie de nieuwe waarde 100 toewijst aan een tijdelijke omgeving die door %>% wordt gebruikt. Als je assign() met de pipe wilt gebruiken, moet je expliciet zijn over de omgeving:
# Definieer je omgeving
env <- environment()
# Voeg de omgeving toe aan `assign()`
"x" %>% assign(100, envir = env)
# Geef `x` terug
x
100
Argumenten binnen functies worden in R pas berekend wanneer de functie ze gebruikt. Dat betekent dat er geen argumenten berekend worden voordat je je functie aanroept. Dat betekent ook dat de pipe elk element van de functie om de beurt berekent.
Een plek waar dit een probleem is, is tryCatch(), waarmee je fouten kunt opvangen en afhandelen, zoals in dit voorbeeld:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
Je ziet dat de geneste manier om deze regel code op te schrijven perfect werkt, terwijl het alternatief met pipes een fout teruggeeft. Andere functies met hetzelfde gedrag zijn try(), suppressMessages() en suppressWarnings() in base R.
Er zijn ook gevallen waarin je de pipe-operator als argument-placeholder kunt gebruiken. Bekijk de volgende voorbeelden:
f(x, y) kan worden herschreven als y %>% f(x, .)In sommige gevallen wil je niet dat de waarde of de magrittr-placeholder op de eerste positie in de functiebel komt, wat tot nu toe in elk voorbeeld het geval was. Bekijk deze coderegel opnieuw:
pi %>% round(6)
Als je deze regel zou herschrijven, zou pi het eerste argument in je round()-functie zijn. Maar wat als je het tweede, derde, ... argument wilt vervangen en dat als magrittr-placeholder in je functiebel wilt gebruiken?
Bekijk dit voorbeeld, waarin de waarde eigenlijk op de derde positie in de functiebel staat:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x) kan worden herschreven als x %>% f(y, z = .)Evenzo wil je misschien de waarde van een specifiek argument binnen je functiebel de magrittr-placeholder laten zijn. Bekijk de volgende coderegel:
6 %>% round(pi, digits=.)
Het is eenvoudig om de placeholder meerdere keren te gebruiken in een expressie aan de rechterkant. Maar wanneer de placeholder alleen in een geneste expressie voorkomt, past magrittr nog steeds de eerste-argument-regel toe. De reden is dat dit in de meeste gevallen schonere code oplevert.
Hier zijn enkele algemene "regels" die je kunt hanteren wanneer je met argument-placeholders in geneste functie-aanroepen werkt:
f(x, y = nrow(x), z = ncol(x)) kan worden herschreven als x %>% f(y = nrow(.), z = ncol(.))# Initialiseer een matrix `ma`
ma <- matrix(1:12, 3, 4)
# Geef het maximum van de ingevoerde waarden terug
max(ma, nrow(ma), ncol(ma))
# Geef het maximum van de ingevoerde waarden terug
ma %>% max(nrow(ma), ncol(ma))
12
12
Dit gedrag kan worden overschreven door de rechterkant tussen accolades te zetten:
f(y = nrow(x), z = ncol(x)) kan worden herschreven als x %>% {f(y = nrow(.), z = ncol(.))}# Geef alleen het maximum van de invoerwaarden `nrow(ma)` en `ncol(ma)` terug
ma %>% {max(nrow(ma), ncol(ma))}
4
Bekijk tot slot ook het volgende voorbeeld, waarin je mogelijk het gedrag van de argument-placeholder in de geneste functiebell wilt aanpassen:
# De functie die je wilt herschrijven
paste(1:5, letters[1:5])
# De geneste functiebell met dot-placeholder
1:5 %>%
paste(., letters[.])
Je ziet dat als de placeholder alleen in een geneste functiebell wordt gebruikt, de magrittr-placeholder ook als eerste argument wordt geplaatst! Als je wilt voorkomen dat dit gebeurt, kun je de accolades { en } gebruiken:
# De geneste functiebell met dot-placeholder en accolades
1:5 %>% {
paste(letters[.])
}
# Herschrijf de bovenstaande functiebell
paste(letters[1:5])
Unary-functies zijn functies die één argument nemen. Elke pipeline die je maakt en die bestaat uit een punt ., gevolgd door functies en aaneengeschakeld met %>%, kun je later gebruiken als je die op waarden wilt toepassen. Bekijk het volgende voorbeeld van zo’n pipeline:
. %>% cos %>% sin
Deze pipeline neemt input, waarna zowel de functies cos() als sin() erop worden toegepast.
Maar je bent er nog niet! Als je wilt dat deze pipeline precies doet wat je net las, moet je hem eerst toewijzen aan een variabele, bijvoorbeeld f. Daarna kun je hem opnieuw gebruiken om de bewerkingen in de pipeline op andere waarden toe te passen.
# Unary-functie
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))Onthoud ook dat je haakjes achter de functies cos() en sin() kunt zetten in de coderegel als je de leesbaarheid wilt verbeteren. Overweeg hetzelfde voorbeeld met haakjes: . %>% cos() %>% sin().
Je ziet: functies bouwen in magrittr lijkt erg op functies bouwen met base R! Als je niet zeker weet hoe vergelijkbaar ze zijn, bekijk dan de regel hierboven en vergelijk die met de volgende coderegel; Beide regels leveren hetzelfde resultaat op!
# is equivalent aan
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))Er zijn situaties waarin je de waarde aan de linkerkant wilt overschrijven, zoals in het voorbeeld hieronder. Intuïtief gebruik je daar de assignment-operator <- voor.
# Laad de Iris-data
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# Voeg kolomnamen toe aan de Iris-data
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# Bereken de wortel van `iris$Sepal.Length` en wijs het toe aan de variabele
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
Er is echter een samengestelde assignment-pipe-operator, waarmee je een verkorte notatie kunt gebruiken om het resultaat van je pipeline direct toe te wijzen aan de linkerkant:
# Bereken de wortel van `iris$Sepal.Length` en wijs het toe aan de variabele
iris$Sepal.Length %<>% sqrt
# Geef `Sepal.Length` terug
iris$Sepal.Length
Let op dat de samengestelde assignment-operator %<>% de eerste pipe-operator in de keten moet zijn om dit te laten werken. Dit is volledig in lijn met wat je net las over de operator als verkorte notatie voor een langere notatie met herhaling, waarbij je de reguliere assignment-operator <- gebruikt.
Als resultaat zal deze operator een pipeline-resultaat toewijzen in plaats van het te retourneren.
De tee-operator werkt precies zoals %>%, maar retourneert de waarde aan de linkerkant in plaats van het potentiële resultaat van de bewerkingen aan de rechterkant.
Dit betekent dat de tee-operator handig kan zijn in situaties waarin je functies opneemt die je gebruikt om hun neveneffect, zoals plotten met plot() of naar een bestand schrijven.
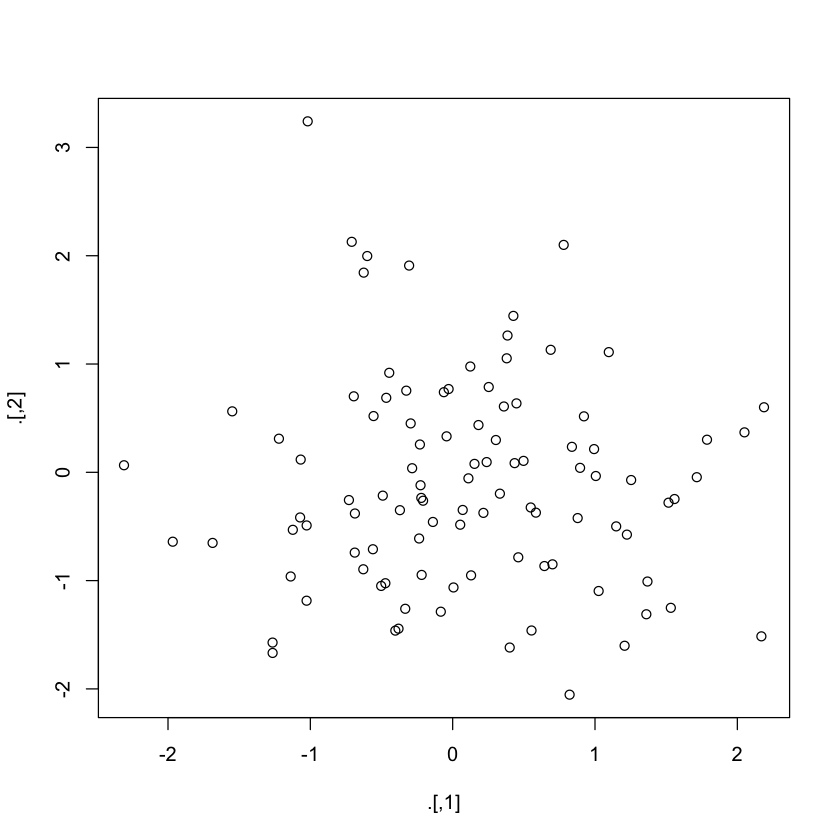
Met andere woorden, functies zoals plot() retourneren doorgaans niets. Dat betekent dat je pipeline na het aanroepen van plot() bijvoorbeeld zou eindigen. In het volgende voorbeeld maakt de tee-operator %T>% het echter mogelijk om je pipeline voort te zetten, zelfs nadat je plot() hebt gebruikt:
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Als je met R werkt, zul je merken dat veel functies een data-argument nemen. Denk bijvoorbeeld aan de lm()-functie of de with()-functie. Deze functies zijn handig in een pipeline waarin je data eerst wordt verwerkt en dan aan de functie wordt doorgegeven.
Voor functies die geen data-argument hebben, zoals de functie cor(), is het nog steeds handig als je de variabelen in de data kunt exposen. Daarvoor dient de %$%-operator. Bekijk het volgende voorbeeld:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
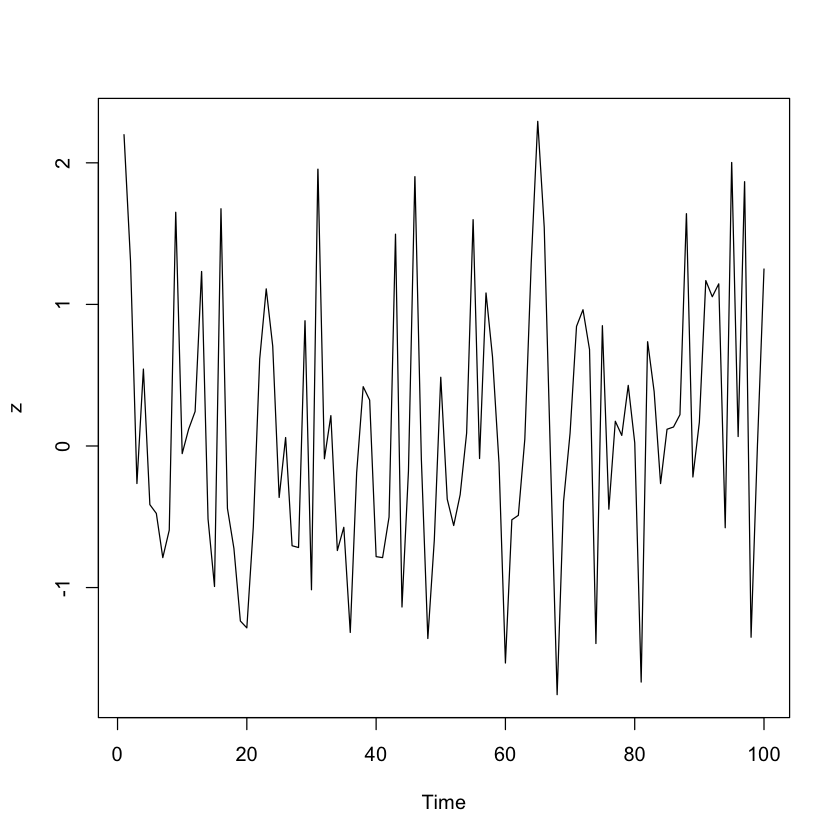
Met behulp van %$% zorg je ervoor dat Sepal.Length en Sepal.Width worden geëxposed aan cor(). Evenzo zie je dat de data in de functie data.frame() wordt doorgegeven aan ts.plot() om meerdere tijdreeksen in één grafiek te plotten:
data.frame(z = rnorm(100)) %$%
  ts.plot(z)
dplyr en magrittrIn de inleiding van deze tutorial las je al dat de ontwikkeling van dplyr en magrittr ongeveer in dezelfde periode plaatsvond, namelijk rond 2013-2014. En, zoals je hebt gelezen, maakt het magrittr-pakket ook deel uit van de Tidyverse.
In dit onderdeel ontdek je hoe krachtig het kan zijn als je beide pakketten in je R-code combineert.
Voor wie nieuw is met het dplyr-pakket: dit R-pakket is opgebouwd rond vijf werkwoorden, namelijk "select", "filter", "arrange", "mutate" en "summarize". Als je al eens data hebt gemanipuleerd voor een data science-project, weet je dat deze werkwoorden het merendeel vormen van de datamanipulatie-taken die je doorgaans op je data moet uitvoeren.
Neem een voorbeeld van wat traditionele code die deze dplyr-functies gebruikt:
library(hflights)

grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
                arr = mean(ArrDelay, na.rm = TRUE),
                dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)

final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
Als je naar dit voorbeeld kijkt, begrijp je meteen waarom dplyr en magrittr zo goed samenwerken:
hflights %>%
    group_by(Year, Month, DayofMonth) %>%
    select(Year:DayofMonth, ArrDelay, DepDelay) %>%
    summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
    filter(arr > 30 | dep > 30)
Beide codeblokken zijn vrij lang, maar je kunt stellen dat het tweede blok duidelijker is als je alle bewerkingen wilt volgen. Door de creatie van tussentijdse variabelen in het eerste codeblok kun je mogelijk de "flow" van de code kwijtraken. Met %>% krijg je een beter overzicht van de bewerkingen die op de data worden uitgevoerd!
Kortom, dplyr en magrittr zijn je droomteam voor datamanipulatie in R!
Al die pipes aan je R-code toevoegen kan een uitdaging zijn! Om het je makkelijker te maken, heeft John Mount, medeoprichter en Principal Consultant bij Win-Vector, LLC en DataCamp-instructeur, een pakket uitgebracht met enkele RStudio-add-ins waarmee je sneltoetsen voor pipes in R kunt maken. Addins zijn eigenlijk R-functies met een beetje speciale registratiemetadata. Een voorbeeld van een eenvoudige add-in kan bijvoorbeeld een functie zijn die een veelgebruikte tekstsnippet invoegt, maar ze kunnen ook behoorlijk complex worden!
Met deze add-ins kun je R-functies interactief uitvoeren vanuit de RStudio IDE, ofwel via sneltoetsen of via het Addins-menu.
Let op dat dit pakket eigenlijk een fork is van RStudio’s originele add-in-pakket. Wees voorzichtig; ondersteuning voor addins is alleen beschikbaar in de meest recente release van RStudio! Lees dit artikel over RStudio-addins om meer over het onderwerp te weten te komen.
Je kunt de add-ins en sneltoetsen van GitHub downloaden.
Hierboven heb je gezien dat pipes zeker iets zijn dat je zou moeten gebruiken als je in R programmeert. Meer specifiek zag je dit aan de hand van gevallen waarin pipes erg nuttig blijken! Toch zijn er situaties, uiteengezet door Hadley Wickham in "R for Data Science", waarin je ze beter kunt vermijden:
In zulke gevallen is het beter om tussentijdse objecten met betekenisvolle namen te maken. Dat maakt het niet alleen makkelijker om je code te debuggen, maar je begrijpt je code ook beter en het wordt voor anderen makkelijker om je code te begrijpen.
Als je niet één primair object transformeert, maar twee of meer objecten samenvoegt, gebruik dan liever geen pipe.
Pipes zijn fundamenteel lineair en complexe relaties ermee uitdrukken resulteert alleen in complexe code die moeilijk te lezen en te begrijpen is.
Gebruik van pipes bij interne pakketontwikkeling is af te raden, omdat het debuggen lastiger wordt!
Voor meer reflecties over dit onderwerp, bekijk deze Stack Overflow-discussie. Andere situaties die daar worden genoemd, zijn loops, pakketafhankelijkheden, argumentvolgorde en leesbaarheid.
Kortom, je kunt het als volgt samenvatten: houd de twee dingen in gedachten die deze constructie zo goed maken, namelijk leesbaarheid en flexibiliteit. Zodra een van deze twee grote voordelen in het gedrang komt, kun je alternatieven overwegen in plaats van pipes.
Na alles wat je hebt gelezen, ben je misschien ook benieuwd naar alternatieven die bestaan in de programmeertaal R. Enkele oplossingen die je in deze tutorial hebt gezien, zijn de volgende:
In plaats van alle bewerkingen aan elkaar te rijgen en één enkel resultaat uit te geven, breek je de keten op en zorg je dat je tussentijdse resultaten in aparte variabelen opslaat. Wees zorgvuldig met de naamgeving van deze variabelen: het doel moet altijd zijn om je code zo begrijpelijk mogelijk te maken!
Een mogelijk bezwaar tegen pipes is dat ze ingaan tegen de "flow" waaraan je gewend bent met base R. De oplossing is dan om bij geneste code te blijven! Maar wat als je geen fan bent van pipes, en je nesting ook verwarrend vindt? De oplossing kan zijn om tabs te gebruiken om de hiërarchie te accentueren.
Je hebt in deze R-pipes-tutorial veel behandeld: je hebt gezien waar %>% vandaan komt, wat het precies is, waarom je het zou moeten gebruiken en hoe je het moet gebruiken. Je hebt gezien dat de pakketten dplyr en magrittr prachtig samenwerken, en dat er nog meer operators zijn. Tot slot heb je ook gevallen gezien waarin je het beter niet gebruikt bij het programmeren in R, en welke alternatieven je in zulke gevallen kunt inzetten.
Als je meer wilt leren over de Tidyverse, bekijk dan DataCamps cursus Introduction to the Tidyverse.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

