

Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mãBạn muốn tìm hiểu thêm về thao tác dữ liệu trong R với dplyr? Hãy xem khóa học Data Manipulation in R with dplyr của chúng tôi.
Toán tử Pipe trong R: Giới thiệu
Để hiểu toán tử pipe trong R là gì và bạn có thể làm gì với nó, bạn cần nhìn toàn cảnh và tìm hiểu lịch sử đằng sau. Những câu hỏi như "tổ hợp ký hiệu kỳ lạ này đến từ đâu và vì sao lại được tạo như vậy?" có thể đang xuất hiện trong đầu bạn. Bạn sẽ khám phá câu trả lời cho những câu hỏi này và nhiều hơn nữa trong phần này.
Bạn có thể nhìn lịch sử từ ba góc độ: quan điểm toán học, quan điểm tổng quát về ngôn ngữ lập trình, và góc nhìn từ chính ngôn ngữ R. Phần tiếp theo sẽ đề cập cả ba!
Lịch sử của Toán tử Pipe trong R
Lịch sử Toán học
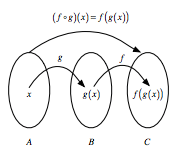
Nếu bạn có hai hàm, giả sử $f : B → C$ và $g : A → B$, bạn có thể xâu chuỗi các hàm này bằng cách lấy đầu ra của một hàm đưa vào làm đầu vào của hàm kế tiếp. Nói ngắn gọn, "xâu chuỗi" nghĩa là bạn truyền kết quả trung gian sang hàm tiếp theo, nhưng bạn sẽ thấy thêm về điều này sau.
Ví dụ, bạn có thể viết $f(g(x))$: $g(x)$ đóng vai trò đầu vào cho $f()$, còn $x$ dĩ nhiên là đầu vào cho $g()$.
Nếu muốn ký hiệu điều này, bạn dùng $f ◦ g$, đọc là "f theo sau g". Hoặc bạn có thể biểu diễn trực quan như sau:
Pipe trong các ngôn ngữ lập trình khác
Như đã đề cập, toán tử này không mới trong lập trình: trong Shell hoặc Terminal, bạn có thể truyền lệnh từ lệnh này sang lệnh khác bằng ký tự pipeline |. Tương tự, F# có toán tử pipe tiến, điều này sẽ quan trọng về sau! Cuối cùng, cũng nên biết rằng Haskell có nhiều thao tác piping được lấy cảm hứng từ Shell hoặc Terminal.
Pipe trong R
Sau khi đã xem qua lịch sử của pipe ở các ngôn ngữ khác, giờ là lúc tập trung vào R. Lịch sử của toán tử này trong R bắt đầu vào ngày 17 tháng 1 năm 2012, khi một người dùng ẩn danh đặt câu hỏi sau trong bài viết Stack Overflow này:
Làm thế nào để hiện thực hóa toán tử pipe tiến của F# trong R? Toán tử giúp xâu chuỗi một chuỗi phép tính một cách dễ dàng. Ví dụ, khi bạn có dữ liệu đầu vào và muốn gọi lần lượt các hàm
foovàbar, bạn có thể viếtdata |> foo |> bar?
Câu trả lời đến từ Ben Bolker, giáo sư tại Đại học McMaster, người đã hồi đáp:
Tôi không biết nó sẽ trụ vững thế nào trong thực tế, nhưng có vẻ (?) như thế này làm điều bạn muốn, ít nhất với các hàm một tham số ...
"%>%" <- function(x,f) do.call(f,list(x)) pi %>% sin [1] 1.224606e-16 pi %>% sin %>% cos [1] 1 cos(sin(pi)) [1] 1
Khoảng chín tháng sau, Hadley Wickham bắt đầu gói dplyr trên GitHub. Có lẽ bạn biết Hadley, Nhà khoa học trưởng tại RStudio, là tác giả của nhiều gói R phổ biến (trong đó có gói này!) và là giảng viên khóa Introduction to Writing Functions in R của chúng tôi.
Tuy nhiên, phải đến năm 2013 thì pipe đầu tiên %.% mới xuất hiện trong gói này. Như Adolfo Álvarez đã đề cập đúng trong bài blog của mình, hàm được đặt tên là chain(), nhằm đơn giản hóa ký pháp khi áp dụng nhiều hàm lên một data frame trong R.
Pipe %.% không tồn tại lâu, vì Stefan Bache đã đề xuất một lựa chọn khác vào ngày 29 tháng 12 năm 2013, bao gồm toán tử mà bạn có lẽ đã biết đến hiện nay:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
Bache tiếp tục phát triển thao tác pipe này, và cuối năm 2013, gói magrittr ra đời. Trong lúc đó, Hadley Wickham vẫn tiếp tục làm việc trên dplyr và đến tháng 4 năm 2014, toán tử %.% được thay thế bằng toán tử bạn đang biết, %>%.
Cuối năm đó, Kun Ren công bố gói pipeR trên GitHub, tích hợp một toán tử pipe khác, %>>%, được thiết kế để tăng tính linh hoạt cho quá trình piping. Tuy vậy, có thể nói %>% nay đã trở thành chuẩn mực trong R, nhất là với sự phổ biến gần đây của Tidyverse.
Toán tử Pipe trong R là gì?
Biết lịch sử là một chuyện, nhưng điều đó vẫn chưa cho bạn ý niệm rõ ràng về toán tử pipe tiến của F# là gì hay nó thực sự làm gì trong R.
Trong F#, toán tử pipe tiến |> là cú pháp rút gọn cho các lời gọi phương thức xâu chuỗi. Nói đơn giản, nó cho phép bạn truyền kết quả trung gian sang hàm kế tiếp.
Hãy nhớ rằng "xâu chuỗi" nghĩa là bạn gọi nhiều phương thức liên tiếp. Mỗi phương thức trả về một đối tượng, và bạn có thể cho phép các lời gọi được xâu chuỗi trong một câu lệnh duy nhất, không cần biến để lưu kết quả trung gian.
Trong R, toán tử pipe như bạn đã thấy là %>%. Nếu bạn không quen với F#, bạn có thể nghĩ toán tử này tương tự + trong câu lệnh ggplot2. Chức năng của nó rất giống toán tử F#: lấy đầu ra của câu lệnh này làm đầu vào cho câu lệnh tiếp theo. Khi mô tả, bạn có thể nghĩ đến từ "RỒI".
Hãy lấy ví dụ đoạn mã sau và đọc thành lời:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
Đúng vậy, đoạn mã trên có thể hiểu là "bạn lấy dữ liệu Iris, rồi bạn lấy tập con dữ liệu, rồi bạn gom nhóm dữ liệu".
Đây là một trong những điểm mạnh nhất của Tidyverse. Thực tế, có một chuỗi hành động xử lý được chuẩn hóa được gọi là "pipeline". Tạo pipeline cho một định dạng dữ liệu là rất hữu ích, vì bạn có thể áp dụng pipeline đó cho dữ liệu đầu vào có cùng định dạng và cho ra đầu ra phù hợp với ggplot2, chẳng hạn.
Vì sao dùng Pipe trong R?
R là ngôn ngữ hàm, nghĩa là mã của bạn thường có nhiều dấu ngoặc, ( và ). Khi mã phức tạp, bạn sẽ phải lồng nhiều lớp ngoặc. Điều này khiến mã R khó đọc và khó hiểu. Đây là lúc %>% cứu nguy!
Hãy xem ví dụ sau, ví dụ điển hình của mã lồng nhau:
# Khởi tạo `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)
# Tính log của `x`, trả về sai phân trễ và lặp phù hợp,
# tính hàm mũ và làm tròn kết quả
round(exp(diff(log(x))), 1)
- 3.3
- 1.8
- 1.6
- 0.5
- 0.3
- 0.1
- 48.8
- 1.1
Với %<%, bạn có thể viết lại như sau:
# Nạp `magrittr`
library(magrittr)
# Thực hiện cùng phép tính trên `x` như trên
x %>% log() %>%
diff() %>%
exp() %>%
round(1)
Thấy khó không? Đừng lo! Bạn sẽ học cách thực hiện trong phần sau của hướng dẫn này.
Lưu ý bạn cần nạp thư viện magrittr để đoạn mã trên hoạt động. Vì toán tử pipe như bạn đã đọc là một phần của magrittr và từ năm 2014 cũng là một phần của dplyr. Nếu quên nạp thư viện, bạn sẽ gặp lỗi như Error in eval(expr, envir, enclos): could not find function "%>%".
Cũng lưu ý rằng không bắt buộc phải thêm dấu ngoặc sau log, diff và exp, nhưng trong cộng đồng R, một số người dùng để tăng khả năng đọc mã.
Tóm lại, bốn lý do bạn nên dùng pipe trong R:
- Bạn sẽ sắp xếp chuỗi thao tác dữ liệu từ trái sang phải, thay vì từ trong ra ngoài;
- Bạn sẽ tránh được các lời gọi hàm lồng nhau;
- Bạn sẽ giảm tối thiểu nhu cầu về biến cục bộ và định nghĩa hàm; Và
- Bạn sẽ dễ dàng chèn thêm bước ở bất cứ đâu trong chuỗi thao tác.
Những lý do này được trích từ tài liệu của magrittr. Ngầm hiểu là các lập luận về khả năng đọc và tính linh hoạt.
Các Pipe bổ sung
Mặc dù %>% là toán tử pipe (chính) của gói magrittr, vẫn còn một vài toán tử khác mà bạn nên biết và thuộc cùng gói:
- Toán tử gán tổng hợp
%<>%;
# Khởi tạo `x`
x <- rnorm(100)
# Cập nhật giá trị của `x` và gán lại cho `x`
x %<>% abs %>% sort
- Toán tử tee
%T>%;
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Lưu ý hiện giờ bạn nên biết rằng đoạn mã trên thực ra là dạng rút gọn của:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
Nhưng bạn sẽ xem thêm về điều này sau!
- Toán tử phơi lộ dữ liệu
%$%.
data.frame(z = rnorm(100)) %$%
ts.plot(z)
Dĩ nhiên, ba toán tử này hoạt động hơi khác so với toán tử %>% chính. Bạn sẽ tìm hiểu thêm về chức năng và cách dùng của chúng trong phần sau.
Lưu ý dù bạn thường thấy pipe của magrittr, bạn cũng có thể gặp những pipe khác! Ví dụ như pipe mũi tên chấm %.>% hoặc pipe tới chấm %>.% của wrapr, hoặc Bizarro pipe ->.;.
Cách sử dụng Pipe trong R
Giờ bạn đã biết nguồn gốc của %>%, nó là gì và vì sao nên dùng, đã đến lúc tìm hiểu cách tận dụng nó. Bạn sẽ thấy có khá nhiều cách dùng!
Piping cơ bản trong R
Trước khi đi vào cách dùng nâng cao, hãy xem các ví dụ cơ bản nhất. Về bản chất, có ba quy tắc bạn có thể theo khi mới bắt đầu:
f(x)có thể viết lại thànhx %>% f
Tức là các hàm nhận một đối số, function(argument), có thể viết lại thành: argument %>% function(). Xem ví dụ thực tế sau để hiểu vì sao hai cách tương đương:
# Tính log của `x`
log(x)
# Tính log của `x`
x %>% log()
f(x, y)có thể viết lại thànhx %>% f(y)
Tất nhiên có nhiều hàm nhận nhiều hơn một đối số. Trường hợp này: hàm nhận hai đối số, x và y. Tương tự ví dụ đầu, bạn có thể viết lại theo cấu trúc argument1 %>% function(argument2), trong đó argument1 là vị trí giữ chỗ của magrittr và argument2 là lời gọi hàm.
Nghe có vẻ lý thuyết. Hãy xem ví dụ thực tiễn:
# Làm tròn pi
round(pi, 6)
# Làm tròn pi
pi %>% round(6)
x %>% f %>% g %>% hcó thể viết lại thànhh(g(f(x)))
Nghe có vẻ phức tạp, nhưng khi xem ví dụ R thực tế thì không:
# Nạp dữ liệu `babynames`
library(babynames)
# Nạp thư viện `dplyr`
library(dplyr)
# Tải dữ liệu
data(babynames)
# Đếm số bé trai tên "Taylor" được sinh
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# Làm tương tự nhưng dùng `%>%`
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
Lưu ý cách bạn làm việc từ trong ra ngoài khi viết lại mã lồng nhau: đầu tiên đưa babynames vào, rồi dùng %>% để filter() dữ liệu. Sau đó, bạn chọn n và cuối cùng là sum() tất cả.
Nhớ rằng bạn đã thấy một ví dụ khác về mã lồng nhau được chuyển thành mã dễ đọc hơn ở phần đầu hướng dẫn này, nơi bạn dùng các hàm log(), diff(), exp() và round() để tính toán trên x.
Các hàm dùng môi trường hiện tại
Đáng tiếc, có một số ngoại lệ với các quy tắc tổng quát ở phần trước. Hãy xem vài trường hợp.
Xét ví dụ này, bạn dùng hàm assign() để gán giá trị 10 cho biến x.
# Gán `10` cho `x`
assign("x", 10)
# Gán `100` cho `x`
"x" %>% assign(100)
# Trả về `x`
x
10
Bạn thấy lời gọi thứ hai với assign() kết hợp pipe không hoạt động đúng. Giá trị của x không được cập nhật.
Tại sao?
Vì hàm gán giá trị mới 100 vào một môi trường tạm do %>% dùng. Do đó, nếu muốn dùng assign() với pipe, bạn phải chỉ rõ môi trường:
# Xác định môi trường của bạn
env <- environment()
# Thêm môi trường vào `assign()`
"x" %>% assign(100, envir = env)
# Trả về `x`
x
100
Các hàm đánh giá lười
Các đối số trong hàm chỉ được tính khi hàm sử dụng chúng trong R. Điều này nghĩa là không có đối số nào được tính trước khi bạn gọi hàm. Đồng thời pipe sẽ tính từng phần tử của hàm theo thứ tự.
Một nơi gây vấn đề là tryCatch(), cho phép bạn bắt và xử lý lỗi, như ví dụ sau:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
Bạn sẽ thấy cách viết lồng nhau hoạt động hoàn hảo, trong khi cách dùng pipe trả về lỗi. Các hàm có hành vi tương tự gồm try(), suppressMessages() và suppressWarnings() trong base R.
Vị trí giữ chỗ cho đối số
Có những trường hợp bạn có thể dùng pipe như một vị trí giữ chỗ cho đối số. Xem các ví dụ sau:
f(x, y)có thể viết lại thànhy %>% f(x, .)
Đôi khi bạn không muốn đặt giá trị hay vị trí giữ chỗ của magrittr ở vị trí đầu tiên của lời gọi hàm, như các ví dụ trước. Xem lại dòng mã này:
pi %>% round(6)
Nếu viết lại dòng trên, pi sẽ là đối số đầu tiên của hàm round(). Nhưng nếu bạn muốn thay thế đối số thứ hai, thứ ba, ... và dùng nó làm vị trí giữ chỗ của magrittr thì sao?
Xem ví dụ sau, giá trị thực tế ở vị trí thứ ba trong lời gọi hàm:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x)có thể viết lại thànhx %>% f(y, z = .)
Tương tự, bạn có thể muốn giá trị của một đối số cụ thể trong lời gọi hàm trở thành vị trí giữ chỗ của magrittr. Xem dòng mã sau:
6 %>% round(pi, digits=.)
Tái sử dụng vị trí giữ chỗ cho thuộc tính
Việc dùng vị trí giữ chỗ nhiều lần trong một biểu thức phía bên phải là trực quan. Tuy nhiên, khi vị trí giữ chỗ chỉ xuất hiện trong biểu thức lồng nhau, magrittr vẫn sẽ áp dụng quy tắc đối số đầu tiên. Lý do là trong hầu hết trường hợp điều này giúp mã sạch hơn.
Dưới đây là vài "quy tắc" tổng quát bạn có thể cân nhắc khi làm việc với vị trí giữ chỗ trong các lời gọi hàm lồng nhau:
f(x, y = nrow(x), z = ncol(x))có thể viết lại thànhx %>% f(y = nrow(.), z = ncol(.))
# Khởi tạo ma trận `ma`
ma <- matrix(1:12, 3, 4)
# Trả về giá trị lớn nhất trong các giá trị đầu vào
max(ma, nrow(ma), ncol(ma))
# Trả về giá trị lớn nhất trong các giá trị đầu vào
ma %>% max(nrow(ma), ncol(ma))
12
12
Hành vi này có thể bị ghi đè bằng cách bao phần bên phải trong ngoặc nhọn:
f(y = nrow(x), z = ncol(x))có thể viết lại thànhx %>% {f(y = nrow(.), z = ncol(.))}
# Chỉ trả về giá trị lớn nhất giữa `nrow(ma)` và `ncol(ma)`
ma %>% {max(nrow(ma), ncol(ma))}
4
Cuối cùng, xem thêm ví dụ sau, nơi bạn có thể muốn điều chỉnh cách hoạt động của vị trí giữ chỗ trong lời gọi hàm lồng nhau:
# Hàm bạn muốn viết lại
paste(1:5, letters[1:5])
# Lời gọi hàm lồng nhau với vị trí giữ chỗ là dấu chấm
1:5 %>%
paste(., letters[.])
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
Bạn thấy nếu vị trí giữ chỗ chỉ dùng trong lời gọi lồng nhau, vị trí giữ chỗ của magrittr cũng sẽ được đặt làm đối số đầu tiên! Nếu muốn tránh điều này, bạn có thể dùng ngoặc nhọn { và }:
# Lời gọi hàm lồng nhau với dấu chấm và ngoặc nhọn
1:5 %>% {
paste(letters[.])
}
# Viết lại lời gọi hàm trên
paste(letters[1:5])
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
Xây dựng hàm một ngôi (Unary)
Hàm một ngôi là hàm nhận một đối số. Bất kỳ pipeline nào bạn tạo gồm dấu chấm ., theo sau là các hàm và được xâu chuỗi bằng %>% có thể dùng sau này để áp dụng cho giá trị. Xem ví dụ một pipeline như vậy:
. %>% cos %>% sin
Pipeline này sẽ nhận một đầu vào, sau đó áp dụng cả cos() và sin() lên đó.
Nhưng chưa xong! Nếu muốn pipeline này thực hiện đúng như vậy, bạn cần gán nó trước vào một biến, ví dụ f. Sau đó bạn có thể tái sử dụng để thực hiện các phép trong pipeline cho các giá trị khác.
# Hàm một ngôi
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))Nhớ rằng bạn có thể thêm dấu ngoặc sau cos() và sin() nếu muốn tăng khả năng đọc. Cùng ví dụ với dấu ngoặc: . %>% cos() %>% sin().
Bạn thấy đấy, xây dựng hàm trong magrittr rất giống với việc xây dựng hàm trong base R! Nếu chưa chắc chúng giống nhau thế nào, hãy xem dòng trên và so sánh với dòng tiếp theo; Cả hai cho cùng kết quả!
# tương đương với
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))Các thao tác pipe gán tổng hợp
Có tình huống bạn muốn ghi đè giá trị ở vế trái, như ví dụ ngay dưới. Theo trực giác, bạn sẽ dùng toán tử gán <-.
# Nạp dữ liệu Iris
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# Thêm tên cột cho dữ liệu Iris
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# Tính căn bậc hai của `iris$Sepal.Length` và gán cho biến
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
Tuy nhiên, có toán tử pipe gán tổng hợp, cho phép bạn dùng cú pháp rút gọn để gán ngay kết quả pipeline cho vế trái:
# Tính căn bậc hai của `iris$Sepal.Length` và gán lại
iris$Sepal.Length %<>% sqrt
# Trả về `Sepal.Length`
iris$Sepal.Length
Lưu ý toán tử gán tổng hợp %<>% cần là toán tử pipe đầu tiên trong chuỗi để hoạt động. Điều này hoàn toàn phù hợp với việc nó là cú pháp rút gọn cho cách viết dài hơn với lặp lại, nơi bạn dùng toán tử gán <- thông thường.
Kết quả là toán tử này sẽ gán kết quả của pipeline thay vì trả về nó.
Thao tác tee với toán tử Tee
Toán tử tee hoạt động y hệt %>%, nhưng nó trả về giá trị vế trái thay vì kết quả tiềm năng của các thao tác vế phải.
Điều này có nghĩa toán tử tee hữu ích trong tình huống bạn dùng các hàm có tác dụng phụ, như vẽ với plot() hoặc ghi ra tệp.
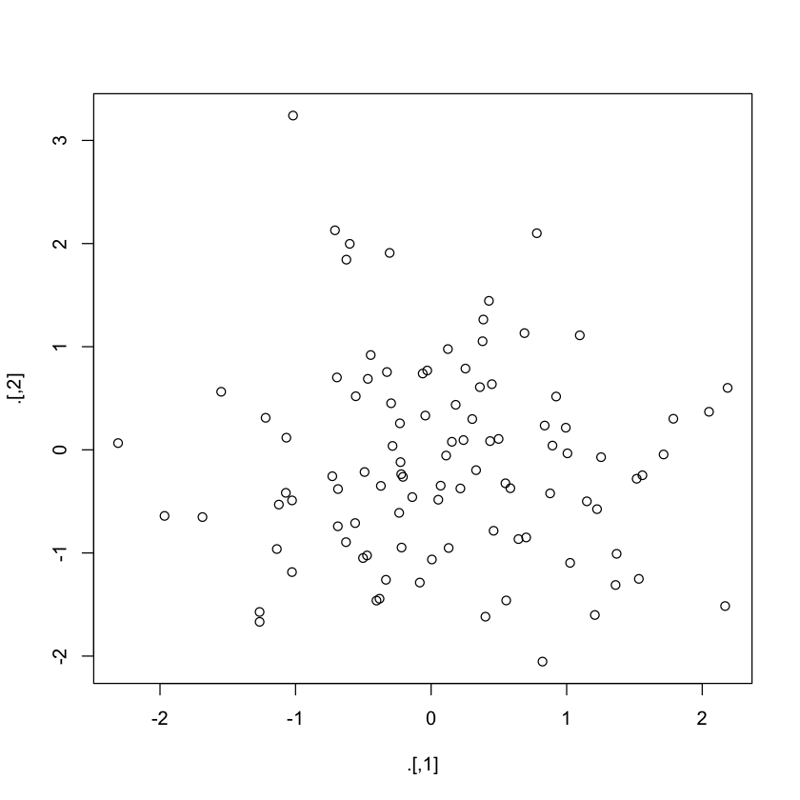
Nói cách khác, các hàm như plot() thường không trả về gì. Điều đó có nghĩa là sau khi gọi plot(), pipeline của bạn sẽ kết thúc. Tuy nhiên, trong ví dụ sau, toán tử tee %T>% cho phép bạn tiếp tục pipeline ngay cả sau khi dùng plot():
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Phơi lộ biến dữ liệu với toán tử Exposition
Khi làm việc với R, bạn sẽ thấy nhiều hàm nhận đối số data. Ví dụ, lm() hoặc with(). Các hàm này hữu ích trong pipeline, nơi dữ liệu của bạn được xử lý trước rồi truyền vào hàm.
Với những hàm không có đối số data, như cor(), vẫn tiện nếu bạn có thể phơi lộ các biến trong dữ liệu. Đó là lúc toán tử %$% phát huy tác dụng. Xem ví dụ sau:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
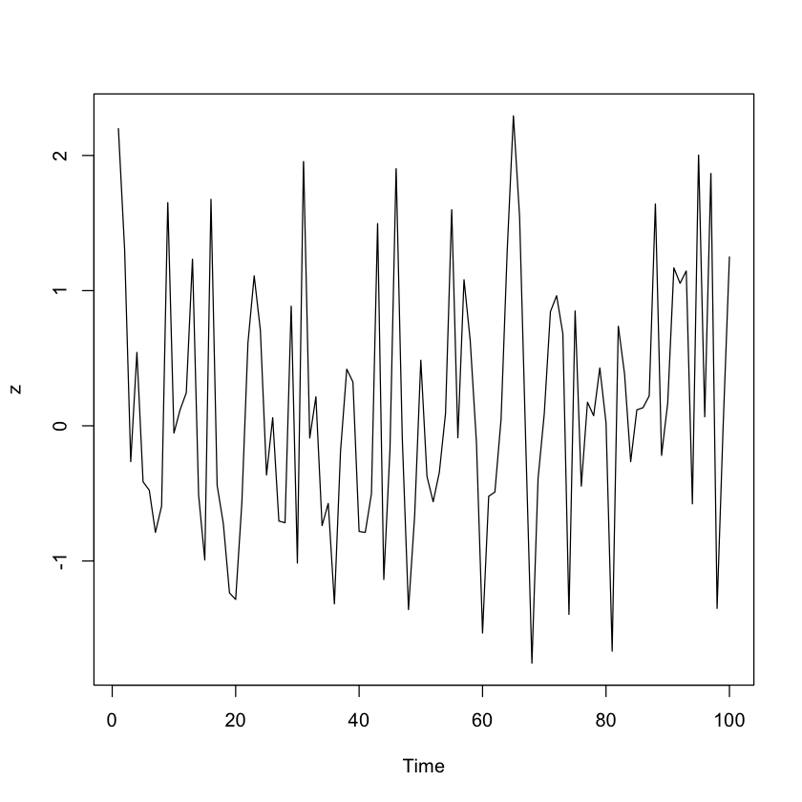
Với %$% bạn đảm bảo Sepal.Length và Sepal.Width được phơi lộ cho cor(). Tương tự, bạn thấy dữ liệu trong data.frame() được truyền cho ts.plot() để vẽ nhiều chuỗi thời gian trên cùng đồ thị:
data.frame(z = rnorm(100)) %$%
ts.plot(z)
dplyr và magrittr
Trong phần mở đầu, bạn đã biết rằng việc phát triển dplyr và magrittr diễn ra cùng thời điểm, khoảng 2013-2014. Và như đã đọc, gói magrittr cũng là một phần của Tidyverse.
Trong phần này, bạn sẽ khám phá việc kết hợp cả hai gói trong mã R thú vị thế nào.
Với những bạn mới làm quen với dplyr, bạn nên biết gói R này được xây dựng quanh năm động từ: "select", "filter", "arrange", "mutate" và "summarize". Nếu bạn từng thao tác dữ liệu cho một dự án khoa học dữ liệu, bạn sẽ biết các động từ này chiếm phần lớn tác vụ xử lý dữ liệu bạn thường phải làm.
Hãy xem ví dụ mã truyền thống dùng các hàm dplyr này:
library(hflights)
grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
arr = mean(ArrDelay, na.rm = TRUE),
dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)
final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
Khi xem ví dụ này, bạn sẽ hiểu ngay vì sao dplyr và magrittr phối hợp tốt với nhau:
hflights %>%
group_by(Year, Month, DayofMonth) %>%
select(Year:DayofMonth, ArrDelay, DepDelay) %>%
summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
filter(arr > 30 | dep > 30)
Cả hai đoạn mã đều khá dài, nhưng bạn có thể cho rằng đoạn thứ hai rõ ràng hơn nếu muốn theo dõi tất cả thao tác. Với việc tạo biến trung gian trong đoạn đầu, bạn có thể đánh mất "dòng chảy" của mã. Dùng %>%, bạn có cái nhìn rõ ràng hơn về các thao tác được thực hiện trên dữ liệu!
Tóm lại, dplyr và magrittr là bộ đôi hoàn hảo để thao tác dữ liệu trong R!
Phím tắt RStudio cho Pipes
Thêm tất cả các pipe vào mã R có thể là một nhiệm vụ không dễ! Để giúp bạn, John Mount, đồng sáng lập và Cố vấn trưởng tại Win-Vector, LLC và là giảng viên DataCamp, đã phát hành một gói với vài add-in cho RStudio cho phép bạn tạo phím tắt cho pipes trong R. Addin thực chất là các hàm R với một chút metadata đăng ký đặc biệt. Ví dụ một addin đơn giản có thể là một hàm chèn một đoạn văn bản thường dùng, nhưng cũng có thể rất phức tạp!
Với các addin này, bạn có thể thực thi các hàm R tương tác ngay trong RStudio IDE, bằng phím tắt hoặc qua menu Addins.
Lưu ý gói này thực ra là fork từ gói add-in gốc của RStudio. Hãy cẩn thận; hỗ trợ addin chỉ có trong bản phát hành RStudio mới nhất! Xem bài viết về RStudio addins để tìm hiểu thêm.
Bạn có thể tải add-in và phím tắt từ GitHub.
Khi nào không nên dùng Pipe trong R
Ở trên, bạn đã thấy pipes chắc chắn là điều nên dùng khi lập trình với R. Cụ thể, bạn đã thấy qua những trường hợp pipes tỏ ra rất hữu ích! Tuy nhiên, có một số tình huống, được Hadley Wickham nêu trong "R for Data Science", mà bạn nên tránh dùng:
- Pipeline của bạn dài hơn (ví dụ) mười bước.
Trong các trường hợp này, tốt hơn là tạo các đối tượng trung gian với tên có ý nghĩa. Như vậy không chỉ giúp bạn gỡ lỗi dễ hơn, mà bạn cũng hiểu mã của mình hơn và người khác cũng dễ hiểu hơn.
- Bạn có nhiều đầu vào hoặc đầu ra.
Nếu bạn không chỉ biến đổi một đối tượng chính, mà đang kết hợp hai hay nhiều đối tượng, tốt nhất không dùng pipe.
- Bạn bắt đầu nghĩ về một đồ thị có hướng với cấu trúc phụ thuộc phức tạp.
Pipes về bản chất là tuyến tính và việc diễn đạt các quan hệ phức tạp bằng chúng sẽ chỉ tạo ra mã rối rắm, khó đọc và khó hiểu.
- Bạn đang phát triển gói nội bộ
Dùng pipes trong phát triển gói nội bộ là điều nên tránh, vì nó khiến việc gỡ lỗi khó hơn!
Để suy ngẫm thêm, xem thảo luận Stack Overflow này. Các tình huống khác được nhắc đến gồm vòng lặp, phụ thuộc gói, thứ tự đối số và khả năng đọc.
Tóm lại, bạn có thể gói gọn như sau: ghi nhớ hai điều làm cho cấu trúc này tuyệt vời, đó là khả năng đọc và tính linh hoạt. Ngay khi một trong hai ưu điểm lớn này bị ảnh hưởng, bạn có thể cân nhắc các lựa chọn khác thay cho pipes.
Các lựa chọn thay thế cho Pipes trong R
Sau tất cả những gì đã đọc, bạn có thể quan tâm đến các lựa chọn khác trong R. Một số giải pháp đã được đề cập trong hướng dẫn này gồm:
- Tạo biến trung gian với tên có ý nghĩa;
Thay vì xâu chuỗi tất cả thao tác và cho ra một kết quả duy nhất, hãy tách chuỗi và lưu kết quả trung gian vào các biến riêng. Hãy cẩn thận với việc đặt tên: mục tiêu luôn là làm cho mã của bạn dễ hiểu nhất có thể!
- Lồng mã để bạn đọc từ trong ra ngoài;
Một phản đối có thể có với pipes là nó đi ngược lại "dòng chảy" quen thuộc của base R. Giải pháp là tiếp tục lồng mã! Nhưng nếu bạn không thích pipes, đồng thời thấy lồng nhau cũng khó theo dõi? Giải pháp là dùng thụt dòng để làm nổi bật thứ bậc.
Kết luận
Bạn đã bao quát khá nhiều trong hướng dẫn pipe R này: bạn đã thấy %>% đến từ đâu, chính xác là gì, vì sao nên dùng và cách dùng. Bạn đã thấy các gói dplyr và magrittr hoạt động tuyệt vời cùng nhau, và còn có nhiều toán tử khác nữa. Cuối cùng, bạn cũng đã thấy một số trường hợp không nên dùng khi lập trình R và các lựa chọn thay thế trong những trường hợp đó.
Nếu bạn quan tâm tìm hiểu thêm về Tidyverse, hãy cân nhắc khóa học Introduction to the Tidyverse của DataCamp.
Câu hỏi thường gặp về R Pipes
R pipes là gì và hoạt động như thế nào?
R pipes là cách xâu chuỗi nhiều thao tác lại với nhau một cách ngắn gọn và dễ diễn đạt. Chúng được biểu diễn bằng toán tử %>%, toán tử này lấy đầu ra của biểu thức bên trái và truyền làm đối số đầu tiên cho hàm ở bên phải. Dùng pipes trong R cho phép chúng ta liên kết một chuỗi bước phân tích.
Sự khác nhau giữa %>% và %<>% là gì?
Toán tử %>% lấy đầu ra của biểu thức bên trái và truyền làm đối số đầu tiên cho hàm bên phải. Toán tử %<>% cũng làm như vậy, nhưng đồng thời cập nhật giá trị ở bên trái pipe ngay tại chỗ.
Vì sao nên dùng R pipes?
R pipes cho phép bạn viết mã ngắn gọn và diễn đạt hơn, giúp mã dễ đọc và dễ hiểu. Chúng cũng cho phép xâu chuỗi các thao tác theo cách giống như bạn đọc hoặc viết bằng ngôn ngữ tự nhiên, khiến mã trực quan hơn và dễ cho người khác nắm bắt.
R pipes có nhược điểm không?
Một nhược điểm tiềm ẩn khi dùng R pipes là có thể không quen thuộc với một số người dùng R, nên cần thêm một chút thời gian học và thực hành để dùng hiệu quả.


Có thể bạn đã từng thấy hoặc dùng toán tử pipe khi làm việc với các gói như
dplyr,magrittr,... Nhưng bạn có biết pipes và toán tử nổi tiếng%>%xuất phát từ đâu, chúng thực sự là gì, hoặc cách, khi nào và vì sao bạn nên dùng chúng không? Bạn cũng có thể đưa ra vài lựa chọn thay thế chứ?Hướng dẫn này sẽ giới thiệu về pipes trong R và bao gồm các chủ đề sau: