

इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंक्या आप dplyr के साथ R में डेटा को और बेहतर तरीके से बदलना सीखना चाहते हैं? हमारा Data Manipulation in R with dplyr कोर्स देखें।
R में पाइप ऑपरेटर: परिचय
R में पाइप ऑपरेटर क्या है और आप इससे क्या कर सकते हैं, यह समझने के लिए आपको इसकी पूरी पृष्ठभूमि देखनी होगी—इसका इतिहास जानना होगा। आपके मन में यह सवाल आ सकता है कि "ये अजीब से प्रतीकों का संयोजन कहां से आया और इसे ऐसे क्यों बनाया गया?" इस खंड में आपको इन और अन्य सवालों के जवाब मिलेंगे।
आप इतिहास को तीन दृष्टिकोणों से देख सकते हैं: गणितीय दृष्टिकोण से, प्रोग्रामिंग भाषाओं के समग्र दृष्टिकोण से, और स्वयं R भाषा के दृष्टिकोण से। आगे आप इन तीनों को कवर करेंगे!
R में पाइप ऑपरेटर का इतिहास
गणितीय इतिहास
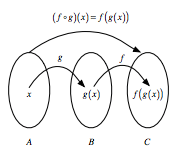
मान लें कि आपके पास दो फंक्शन हैं, $f : B → C$ और $g : A → B$। आप इन फंक्शनों को चेन कर सकते हैं: एक फंक्शन के आउटपुट को अगले फंक्शन के इनपुट के रूप में देते हैं। संक्षेप में, "चेनिंग" का मतलब है कि आप मध्यवर्ती परिणाम को अगले फंक्शन को पास करते हैं—इसके बारे में आप आगे और देखेंगे।
उदाहरण के लिए, आप लिखते हैं $f(g(x))$: यहाँ $g(x)$, $f()$ के लिए इनपुट का काम करता है, जबकि $x$ स्वाभाविक रूप से $g()$ का इनपुट है।
यदि आप इसे लिखना चाहें, तो आप संकेतन $f ◦ g$ का उपयोग करेंगे, जिसे "f follows g" पढ़ा जाता है। वैकल्पिक रूप से, आप इसे इस प्रकार दृश्य रूप में दिखा सकते हैं:
अन्य प्रोग्रामिंग भाषाओं में पाइप ऑपरेटर्स
जैसा कि इस खंड के परिचय में बताया गया, यह ऑपरेटर प्रोग्रामिंग में नया नहीं है: शेल या टर्मिनल में, आप पाइपलाइन कैरेक्टर | से कमांड एक से दूसरे तक भेज सकते हैं। इसी तरह, F# में एक फॉरवर्ड पाइप ऑपरेटर होता है, जो आगे आपके लिए महत्वपूर्ण साबित होगा! अंत में, यह जानना भी उपयोगी है कि Haskell में भी शेल/टर्मिनल से प्रेरित कई पाइपिंग ऑपरेशन्स हैं।
R में पाइप्स
अब जब आपने अन्य प्रोग्रामिंग भाषाओं में पाइप ऑपरेटर का इतिहास देखा, तो R पर ध्यान केंद्रित करने का समय है। R में इस ऑपरेटर का इतिहास 17 जनवरी, 2012 से शुरू होता है, जब एक अनाम उपयोगकर्ता ने इस Stack Overflow पोस्ट में निम्न प्रश्न पूछा:
आप R में F# का फॉरवर्ड पाइप ऑपरेटर कैसे लागू कर सकते हैं? यह ऑपरेटर गणनाओं की एक श्रृंखला को आसानी से चेन करना संभव बनाता है। उदाहरण के लिए, जब आपके पास इनपुट डेटा हो और आप क्रम में
fooऔरbarफंक्शन कॉल करना चाहें, तो आपdata |> foo |> barलिख सकते हैं?
जवाब McMaster University के प्रोफेसर Ben Bolker ने दिया:
मुझे नहीं पता कि यह वास्तविक उपयोग में कितना टिकेगा, लेकिन यह (शायद?) वही करता दिखता है जो आप चाहते हैं, कम से कम single-argument फंक्शनों के लिए ...
"%>%" <- function(x,f) do.call(f,list(x)) pi %>% sin [1] 1.224606e-16 pi %>% sin %>% cos [1] 1 cos(sin(pi)) [1] 1
करीब नौ महीने बाद, Hadley Wickham ने GitHub पर dplyr पैकेज शुरू किया। आप Hadley, जो RStudio के Chief Scientist हैं, को कई लोकप्रिय R पैकेजों (जैसे यह) के लेखक और हमारे Introduction to Writing Functions in R कोर्स के प्रशिक्षक के रूप में जानते होंगे।
हालांकि, 2013 तक इस पैकेज में पहला पाइप %.% दिखाई दिया। जैसा कि Adolfo Álvarez ने अपने ब्लॉग पोस्ट में सही कहा है, उस फंक्शन का नाम chain() था, जिसका उद्देश्य एक ही R डेटा फ्रेम पर कई फंक्शनों के अनुप्रयोग के लिए संकेतन को सरल बनाना था।
%.% पाइप अधिक समय तक नहीं रहा, क्योंकि 29 दिसंबर 2013 को Stefan Bache ने एक वैकल्पिक प्रस्ताव रखा, जिसमें वही ऑपरेटर शामिल था जिसे आप अब जानते हैं:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
Bache ने इस पाइप ऑपरेशन पर काम जारी रखा, और 2013 के अंत में magrittr पैकेज अस्तित्व में आया। इस बीच, Hadley Wickham dplyr पर काम करते रहे और अप्रैल 2014 में %.% ऑपरेटर को बदलकर वह कर दिया गया जिसे आप आज जानते हैं, %>%।
उसी वर्ष बाद में, Kun Ren ने GitHub पर pipeR पैकेज प्रकाशित किया, जिसमें एक अलग पाइप ऑपरेटर %>>% शामिल था, जिसे पाइपिंग प्रक्रिया में और अधिक लचीलापन जोड़ने के लिए डिज़ाइन किया गया था। हालांकि, यह कहना सुरक्षित है कि आज %>% R में स्थापित हो चुका है, खासकर Tidyverse की हालिया लोकप्रियता के साथ।
R पाइप ऑपरेटर क्या है?
इतिहास जानना एक बात है, लेकिन इससे यह पता नहीं चलता कि F# का फॉरवर्ड पाइप ऑपरेटर क्या है और R में यह वास्तव में क्या करता है।
F# में, pipe-forward ऑपरेटर |> chained method calls के लिए syntactic sugar है। सरल शब्दों में, यह आपको मध्यवर्ती परिणाम अगले फंक्शन को पास करने देता है।
याद रखें कि "चेनिंग" का अर्थ है कि आप कई method calls को invoke करते हैं। जैसे-जैसे हर method एक ऑब्जेक्ट लौटाता है, आप बिना मध्यवर्ती परिणामों को स्टोर करने के लिए वेरिएबल्स की जरूरत के, कॉल्स को एक ही स्टेटमेंट में चेन कर सकते हैं।
R में, जैसा कि आपने देखा, पाइप ऑपरेटर %>% है। यदि आप F# से परिचित नहीं हैं, तो आप इसे ggplot2 स्टेटमेंट में + जैसा समझ सकते हैं। इसका काम F# ऑपरेटर जैसा ही है: यह एक स्टेटमेंट के आउटपुट को अगले स्टेटमेंट के इनपुट में बदल देता है। आप इसे "THEN" के रूप में सोच सकते हैं।
उदाहरण के लिए, निम्न कोड खंड को लें और इसे ज़ोर से पढ़ें:
iris %>%
subset(Sepal.Length > 5) %>%
aggregate(. ~ Species, ., mean)
सही कहा, ऊपर का कोड कुछ यूँ पढ़ा जाता है: "Iris डेटा लें, फिर डेटा को subset करें और फिर डेटा को aggregate करें"।
यह Tidyverse की सबसे शक्तिशाली बातों में से एक है। वास्तव में, प्रोसेसिंग क्रियाओं की एक मानकीकृत श्रृंखला को "pipeline" कहा जाता है। किसी डेटा फॉर्मेट के लिए pipelines बनाना बढ़िया है, क्योंकि आप उसी फॉर्मेट वाले आने वाले डेटा पर वह pipeline लागू कर सकते हैं और, उदाहरण के लिए, उसे ggplot2 के अनुकूल फॉर्मेट में आउटपुट करा सकते हैं।
R पाइप्स का उपयोग क्यों करें?
R एक functional भाषा है, जिसका मतलब है कि आपके कोड में अक्सर बहुत सारी parentheses, ( और ), होती हैं। जब कोड जटिल होता है, तो आपको इनको नेस्ट करना पड़ता है। इससे आपका R कोड पढ़ने और समझने में कठिन हो जाता है। यहीं %>% मदद करता है!
निम्न उदाहरण देखें, जो नेस्टेड कोड का एक सामान्य उदाहरण है:
# Initialize `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)
# Compute the logarithm of `x`, return suitably lagged and iterated differences,
# compute the exponential function and round the result
round(exp(diff(log(x))), 1)
- 3.3
- 1.8
- 1.6
- 0.5
- 0.3
- 0.1
- 48.8
- 1.1
%<% की मदद से, आप ऊपर के कोड को इस प्रकार लिख सकते हैं:
# Import `magrittr`
library(magrittr)
# Perform the same computations on `x` as above
x %>% log() %>%
diff() %>%
exp() %>%
round(1)
यह कठिन लग रहा है? चिंता न करें! इस ट्यूटोरियल में आगे आप विस्तार से सीखेंगे कि इसे कैसे अपनाना है।
ध्यान दें कि ऊपर का कोड काम कराने के लिए आपको magrittr लाइब्रेरी इम्पोर्ट करनी होगी। क्योंकि पाइप ऑपरेटर, जैसा कि ऊपर पढ़ा, magrittr लाइब्रेरी का हिस्सा है और 2014 से dplyr का भी हिस्सा है। अगर आप लाइब्रेरी इम्पोर्ट करना भूल जाते हैं, तो आपको ऐसा एरर मिलेगा: Error in eval(expr, envir, enclos): could not find function "%>%"।
यह भी ध्यान रखें कि log, diff और exp के बाद कोष्ठक लगाना औपचारिक आवश्यकता नहीं है, लेकिन R कम्युनिटी में कुछ लोग पठनीयता बढ़ाने के लिए ऐसा करते हैं।
संक्षेप में, R में पाइप्स इस्तेमाल करने के चार कारण ये हैं:
- आप अपने डेटा ऑपरेशन्स का क्रम बाएँ से दाएँ लिखेंगे, अंदर से बाहर नहीं;
- आप nested function calls से बचेंगे;
- आपको लोकल वेरिएबल्स और function definitions की जरूरत कम होगी; और
- आप ऑपरेशन्स की श्रृंखला में कहीं भी स्टेप्स जोड़ना आसान पाएंगे।
ये वजहें सीधे magrittr डॉक्यूमेंटेशन से ली गई हैं। अप्रत्यक्ष रूप से, आप पठनीयता और लचीलेपन के तर्कों को लौटते हुए देखते हैं।
अतिरिक्त पाइप्स
हालाँकि %>% magrittr पैकेज का (मुख्य) पाइप ऑपरेटर है, इसी पैकेज के कुछ और ऑपरेटर भी हैं जिन्हें आपको जानना चाहिए:
- compound assignment ऑपरेटर
%<>%;
# Initialize `x`
x <- rnorm(100)
# Update value of `x` and assign it to `x`
x %<>% abs %>% sort
- tee ऑपरेटर
%T>%;
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
ध्यान दें कि ऊपर का कोड वास्तव में इस शॉर्टकट का रूप है:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
लेकिन इसके बारे में आप आगे और देखेंगे!
- exposition पाइप ऑपरेटर
%$%।
data.frame(z = rnorm(100)) %$%
ts.plot(z)
स्वाभाविक रूप से, ये तीनों ऑपरेटर मुख्य %>% ऑपरेटर से थोड़ा अलग काम करते हैं। आप आगे इनके फीचर्स और उपयोग के बारे में अधिक देखेंगे।
ध्यान दें कि भले ही आप अक्सर magrittr के पाइप्स देखेंगे, रास्ते में आपको अन्य पाइप्स भी मिल सकते हैं! उदाहरण के लिए wrapr के dot arrow पाइप %.>% या to dot पाइप %>.%, या Bizarro पाइप ->.;।
R में पाइप्स का उपयोग कैसे करें
अब जब आप जानते हैं कि %>% कैसे आया, यह क्या है, और क्यों उपयोगी है, तो अब बारी है इसे प्रभावी ढंग से इस्तेमाल करना सीखने की। आप देखेंगे कि इसे कई तरीकों से उपयोग किया जा सकता है!
बेसिक R पाइपिंग
एडवांस्ड उपयोग से पहले, ऑपरेटर के सबसे बुनियादी उदाहरणों को देखना अच्छा है। मूल रूप से, शुरुआत में आप ये तीन नियम अपना सकते हैं:
f(x)कोx %>% fके रूप में लिखा जा सकता है
संक्षेप में, जिन फंक्शनों में एक आर्ग्युमेंट होता है, function(argument), उन्हें आप इस तरह लिख सकते हैं: argument %>% function()। नीचे व्यावहारिक उदाहरण देखें:
# Compute the logarithm of `x`
log(x)
# Compute the logarithm of `x`
x %>% log()
f(x, y)कोx %>% f(y)के रूप में लिखा जा सकता है
स्वाभाविक है, कई फंक्शंस एक से अधिक आर्ग्युमेंट लेते हैं। यहाँ भी आप argument1 %>% function(argument2) जैसी संरचना अपनाते हैं, जहाँ argument1 magrittr placeholder है और argument2 फंक्शन कॉल।
चलिये, एक व्यावहारिक उदाहरण देखें:
# Round pi
round(pi, 6)
# Round pi
pi %>% round(6)
x %>% f %>% g %>% hकोh(g(f(x)))के रूप में लिखा जा सकता है
यह जटिल लग सकता है, पर वास्तविक R उदाहरण में ऐसा नहीं है:
# Import `babynames` data
library(babynames)
# Import `dplyr` library
library(dplyr)
# Load the data
data(babynames)
# Count how many young boys with the name "Taylor" are born
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# Do the same but now with `%>%`
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
ध्यान दें कि नेस्टेड कोड को फिर से लिखते समय आप अंदर से बाहर की बजाय बाएँ से दाएँ काम करते हैं: पहले babynames देते हैं, फिर %>% से पहले filter() करते हैं। उसके बाद n को select() करते हैं और अंत में sum() लेते हैं।
याद रखें कि आपने शुरुआत में log(), diff(), exp() और round() का उदाहरण भी देखा था, जहाँ नेस्टेड कोड को अधिक पठनीय रूप में बदला गया था।
ऐसे फंक्शंस जो वर्तमान environment का उपयोग करते हैं
दुर्भाग्य से, पिछली धारा के सामान्य नियमों के कुछ अपवाद भी हैं। आइए कुछ देखें।
मान लीजिए आप assign() फंक्शन का उपयोग करके वैरिएबल x को मान 10 असाइन करते हैं:
# Assign `10` to `x`
assign("x", 10)
# Assign `100` to `x`
"x" %>% assign(100)
# Return `x`
x
10
आप देखते हैं कि पाइप के साथ assign() का दूसरा कॉल ठीक से काम नहीं करता। x का मान अपडेट नहीं होता।
ऐसा क्यों?
क्योंकि फंक्शन नया मान 100 उस अस्थायी environment में असाइन करता है जिसे %>% उपयोग करता है। इसलिए, अगर आप पाइप के साथ assign() इस्तेमाल करना चाहते हैं, तो आपको environment स्पष्ट करना होगा:
# Define your environment
env <- environment()
# Add the environment to `assign()`
"x" %>% assign(100, envir = env)
# Return `x`
x
100
लेज़ी इवैल्यूएशन वाले फंक्शंस
R में फंक्शंस के आर्ग्युमेंट्स तब ही compute होते हैं जब फंक्शन उनका उपयोग करता है। यानी, फंक्शन कॉल से पहले कोई आर्ग्युमेंट compute नहीं होता। इसका मतलब यह भी है कि पाइप फंक्शन के प्रत्येक हिस्से को क्रम से compute करता है।
जहाँ यह समस्या बनता है उनमें से एक है tryCatch(), जो त्रुटियों को पकड़ने और संभालने देता है, जैसे इस उदाहरण में:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
आप देखेंगे कि नेस्टेड तरीके से लिखी लाइन ठीक काम करती है, जबकि पाइप वाला विकल्प एरर देता है। base R में इसी तरह के व्यवहार वाले अन्य फंक्शंस हैं try(), suppressMessages() और suppressWarnings()।
आर्ग्युमेंट प्लेसहोल्डर
ऐसे मामले भी होते हैं जहाँ आप पाइप ऑपरेटर को आर्ग्युमेंट प्लेसहोल्डर के रूप में उपयोग कर सकते हैं। निम्न उदाहरण देखें:
f(x, y)कोy %>% f(x, .)के रूप में लिखा जा सकता है
कभी-कभी, आप नहीं चाहेंगे कि मान या magrittr प्लेसहोल्डर फंक्शन कॉल में पहले स्थान पर जाए, जैसा अब तक के हर उदाहरण में हुआ है। इस लाइन पर फिर से विचार करें:
pi %>% round(6)
यदि आप इसे फिर से लिखेंगे, तो pi आपके round() के पहले आर्ग्युमेंट में होगा। लेकिन अगर आप दूसरे, तीसरे, ... आर्ग्युमेंट को बदलना चाहें और उसे ही फंक्शन कॉल के लिए magrittr प्लेसहोल्डर बनाना चाहें?
यह उदाहरण देखें, जहाँ मान वास्तव में फंक्शन कॉल में तीसरे स्थान पर है:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x)कोx %>% f(y, z = .)के रूप में लिखा जा सकता है
इसी तरह, आप अपने फंक्शन कॉल के किसी विशेष आर्ग्युमेंट के मान को magrittr प्लेसहोल्डर बनाना चाह सकते हैं। यह लाइन देखें:
6 %>% round(pi, digits=.)
एट्रिब्यूट्स के लिए प्लेसहोल्डर को फिर से उपयोग करना
दाएँ तरफ के expression में प्लेसहोल्डर को कई बार उपयोग करना सीधा है। हालाँकि, जब प्लेसहोल्डर केवल nested expressions में आता है तो magrittr फिर भी first-argument rule लागू करेगा। ज्यादातर मामलों में इससे कोड अधिक साफ बनता है।
nested function calls में आर्ग्युमेंट प्लेसहोल्डर के साथ काम करते समय कुछ सामान्य "नियम" ये हैं:
f(x, y = nrow(x), z = ncol(x))कोx %>% f(y = nrow(.), z = ncol(.))के रूप में लिखा जा सकता है
# Initialize a matrix `ma`
ma <- matrix(1:12, 3, 4)
# Return the maximum of the values inputted
max(ma, nrow(ma), ncol(ma))
# Return the maximum of the values inputted
ma %>% max(nrow(ma), ncol(ma))
12
12
इस व्यवहार को आप दाएँ तरफ कर्ली ब्रेसेस लगाकर ओवररूल कर सकते हैं:
f(y = nrow(x), z = ncol(x))कोx %>% {f(y = nrow(.), z = ncol(.))}के रूप में लिखा जा सकता है
# Only return the maximum of the `nrow(ma)` and `ncol(ma)` input values
ma %>% {max(nrow(ma), ncol(ma))}
4
अंत में, यह उदाहरण भी देखें, जहाँ आप nested function call में प्लेसहोल्डर के काम करने के तरीके को समायोजित करना चाह सकते हैं:
# The function that you want to rewrite
paste(1:5, letters[1:5])
# The nested function call with dot placeholder
1:5 %>%
paste(., letters[.])
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
- '1 a'
- '2 b'
- '3 c'
- '4 d'
- '5 e'
आप देखते हैं कि यदि प्लेसहोल्डर केवल nested function call में उपयोग होता है, तो magrittr प्लेसहोल्डर को पहले आर्ग्युमेंट के रूप में भी रख देगा! यदि आप ऐसा नहीं होने देना चाहते, तो कर्ली ब्रेसेस { और } का उपयोग करें:
# The nested function call with dot placeholder and curly brackets
1:5 %>% {
paste(letters[.])
}
# Rewrite the above function call
paste(letters[1:5])
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
- 'a'
- 'b'
- 'c'
- 'd'
- 'e'
यूनरी फंक्शंस बनाना
यूनरी फंक्शंस वे होते हैं जो एक आर्ग्युमेंट लेते हैं। कोई भी pipeline जो डॉट . से शुरू होती है, फिर फंक्शंस आते हैं और जिन्हें %>% से जोड़ा गया है, उसे आप बाद में मानों पर लागू करने के लिए उपयोग कर सकते हैं। ऐसा ही एक pipeline नीचे है:
. %>% cos %>% sin
यह pipeline कुछ इनपुट लेगी, जिसके बाद उस पर cos() और sin() दोनों लागू होंगे।
पर अभी काम बाकी है! यदि आप चाहते हैं कि यह pipeline वही करे जो आपने पढ़ा, तो पहले इसे किसी वैरिएबल, जैसे f, में असाइन करें। फिर आप इसे अन्य मानों पर दोबारा उपयोग कर सकते हैं।
# Unary function
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))याद रखें कि पठनीयता बढ़ाने के लिए आप cos() और sin() के बाद कोष्ठक भी लगा सकते हैं। वही उदाहरण कोष्ठकों के साथ: . %>% cos() %>% sin()।
देखा, magrittr में फंक्शन बनाना base R में फंक्शन बनाने जैसा ही है! यदि आप सुनिश्चित नहीं हैं कि ये कितने समान हैं, तो ऊपर की लाइन की तुलना नीचे की लाइन से करें; दोनों का परिणाम एक जैसा है!
# is equivalent to
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))Compound असाइनमेंट पाइप ऑपरेशन्स
कई बार आप बाएँ तरफ के मान को overwrite करना चाहेंगे, जैसे नीचे के उदाहरण में। सहज रूप से, आप इसके लिए असाइनमेंट ऑपरेटर <- उपयोग करेंगे।
# Load in the Iris data
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# Add column names to the Iris data
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# Compute the square root of `iris$Sepal.Length` and assign it to the variable
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
हालाँकि, एक compound assignment पाइप ऑपरेटर भी है, जो आपको शॉर्टहैंड में पाइपलाइन के परिणाम को सीधे बाएँ तरफ असाइन करने देता है:
# Compute the square root of `iris$Sepal.Length` and assign it to the variable
iris$Sepal.Length %<>% sqrt
# Return `Sepal.Length`
iris$Sepal.Length
ध्यान दें कि compound assignment ऑपरेटर %<>% को चेन में पहला पाइप ऑपरेटर होना चाहिए। यह पूरी तरह उसी शॉर्टहैंड विचार के अनुरूप है, जहाँ आप लंबे दोहराव वाली लिखावट के बजाय सामान्य <- असाइनमेंट का संक्षिप्त रूप लेते हैं।
नतीजा यह कि यह ऑपरेटर किसी पाइपलाइन के परिणाम को लौटाने के बजाए उसे असाइन करता है।
Tee ऑपरेटर के साथ Tee ऑपरेशन्स
Tee ऑपरेटर %>% की तरह ही काम करता है, पर यह दाएँ तरफ के संभावित परिणाम के बजाय बाएँ तरफ का मान वापस लौटाता है।
इसका उपयोग तब उपयोगी है जब आपने ऐसे फंक्शंस शामिल किए हैं जिनका प्रयोग उनके side effect के लिए होता है, जैसे plot() से प्लॉट बनाना या फाइल पर प्रिंट करना।
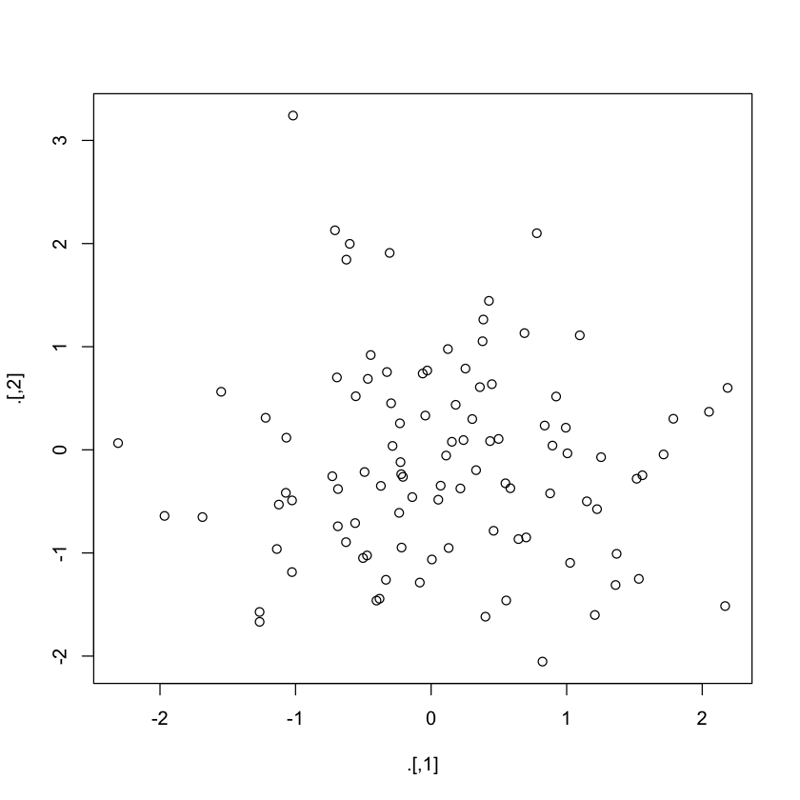
दूसरे शब्दों में, plot() जैसे फंक्शंस प्रायः कुछ वापस नहीं लौटाते। यानी, plot() कॉल के बाद आपकी पाइपलाइन खत्म हो जाएगी। लेकिन नीचे के उदाहरण में tee ऑपरेटर %T>% आपको plot() के बाद भी पाइपलाइन जारी रखने देता है:
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Exposition ऑपरेटर से डेटा वेरिएबल्स को एक्सपोज़ करना
R में काम करते समय आप पाएँगे कि कई फंक्शंस में data आर्ग्युमेंट होता है। उदाहरण के लिए lm() फंक्शन या with() फंक्शन। ये फंक्शंस ऐसी पाइपलाइन में उपयोगी हैं जहाँ आपका डेटा पहले प्रोसेस होता है और फिर फंक्शन में पास होता है।
जिन फंक्शंस में data आर्ग्युमेंट नहीं होता, जैसे cor(), वहाँ भी अगर आप डेटा के वेरिएबल्स को एक्सपोज़ कर सकें तो अच्छा है। यहीं %$% काम आता है। यह उदाहरण देखें:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
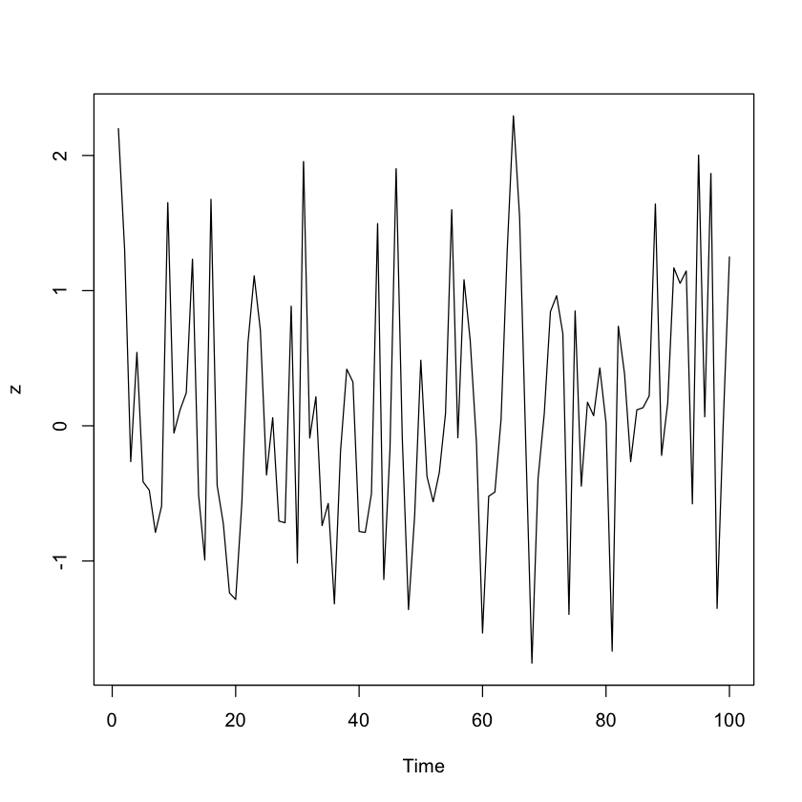
%$% की मदद से आप सुनिश्चित करते हैं कि Sepal.Length और Sepal.Width cor() को एक्सपोज़ हों। इसी तरह, आप देखते हैं कि data.frame() का डेटा ts.plot() को दिया जाता है ताकि एक ही प्लॉट पर कई टाइम सीरीज़ प्लॉट हों:
data.frame(z = rnorm(100)) %$%
ts.plot(z)
dplyr और magrittr
इस ट्यूटोरियल के परिचय में आपने सीखा कि dplyr और magrittr का विकास लगभग एक ही समय (2013–2014) में हुआ। और जैसा कि आपने पढ़ा, magrittr पैकेज Tidyverse का भी हिस्सा है।
इस खंड में, आप देखेंगे कि जब आप अपने R कोड में दोनों पैकेजों को जोड़ते हैं तो यह कितना उपयोगी हो सकता है।
जो लोग dplyr में नए हैं, उनके लिए जानना ज़रूरी है कि यह R पैकेज पाँच क्रियाओं पर बना है: "select", "filter", "arrange", "mutate" और "summarize"। यदि आपने कभी किसी डेटा साइंस प्रोजेक्ट के लिए डेटा बदला है, तो आप जानते होंगे कि ये क्रियाएँ अधिकांश डेटा मैनिपुलेशन कार्यों का आधार हैं।
इन dplyr फंक्शंस का उपयोग करने वाला परंपरागत कोड उदाहरण देखें:
library(hflights)
grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
arr = mean(ArrDelay, na.rm = TRUE),
dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)
final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
जब आप इस उदाहरण को देखते हैं, तो तुरंत समझ आता है कि dplyr और magrittr साथ में इतनी अच्छी तरह क्यों काम करते हैं:
hflights %>%
group_by(Year, Month, DayofMonth) %>%
select(Year:DayofMonth, ArrDelay, DepDelay) %>%
summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
filter(arr > 30 | dep > 30)
दोनों कोड खंड काफ़ी लंबे हैं, लेकिन कहा जा सकता है कि दूसरा खंड ऑपरेशन्स को चरण-दर-चरण फॉलो करने के लिए अधिक स्पष्ट है। पहले खंड में मध्यवर्ती वैरिएबल्स बनाने से आप कोड का "flow" खो सकते हैं। %>% का उपयोग करके, आपको डेटा पर हो रही प्रक्रियाओं का अधिक स्पष्ट अवलोकन मिलता है!
संक्षेप में, R में डेटा मैनिपुलेशन के लिए dplyr और magrittr आपकी ड्रीम टीम हैं!
RStudio में पाइप्स के लिए कीबोर्ड शॉर्टकट
अपने R कोड में इतने सारे पाइप्स जोड़ना चुनौतीपूर्ण हो सकता है! आपकी सहूलियत के लिए, Win-Vector, LLC के सह-संस्थापक और Principal Consultant तथा DataCamp इंस्ट्रक्टर John Mount ने कुछ RStudio ऐड-इन्स वाला एक पैकेज जारी किया है, जो आपको R में पाइप्स के लिए कीबोर्ड शॉर्टकट बनाने देता है। Addins वास्तव में थोड़े से रजिस्ट्रेशन मेटाडेटा के साथ R फंक्शंस होते हैं। एक सरल addin का उदाहरण अक्सर इस्तेमाल होने वाला टेक्स्ट स्निपेट insert करने वाला फंक्शन हो सकता है—और यह बहुत जटिल भी हो सकता है!
इन addins के साथ, आप RStudio IDE के भीतर से इंटरैक्टिव तरीके से R फंक्शंस चला पाएँगे, या तो कीबोर्ड शॉर्टकट से या Addins मेन्यू के जरिए।
ध्यान दें कि यह पैकेज वास्तव में RStudio के मूल add-in पैकेज का एक fork है। सावधान रहें; addins का सपोर्ट केवल RStudio के नवीनतम संस्करण में उपलब्ध है! अधिक जानने के लिए RStudio addins पर यह लेख देखें।
आप add-ins और कीबोर्ड शॉर्टकट्स GitHub से डाउनलोड कर सकते हैं।
R में पाइप ऑपरेटर कब न इस्तेमाल करें
ऊपर आपने देखा कि R में प्रोग्रामिंग करते समय पाइप्स ज़रूर इस्तेमाल करने लायक हैं—खासतौर पर जिन मामलों को कवर किया गया उनमें ये बहुत उपयोगी साबित होते हैं! हालांकि, Hadley Wickham ने "R for Data Science" में कुछ स्थितियाँ बताई हैं, जहाँ पाइप्स से बचना बेहतर है:
- जब आपकी पाइप्स (मान लें) दस से अधिक स्टेप्स लंबी हों।
ऐसे में अर्थपूर्ण नामों के साथ मध्यवर्ती ऑब्जेक्ट्स बनाना बेहतर है। इससे डिबग करना आसान होगा, आप अपने कोड को बेहतर समझेंगे और दूसरों के लिए भी समझना आसान होगा।
- जब आपके पास कई इनपुट या आउटपुट हों।
यदि आप एक मुख्य ऑब्जेक्ट को ट्रांसफॉर्म नहीं कर रहे हैं, बल्कि दो या अधिक ऑब्जेक्ट्स को जोड़ रहे हैं, तो पाइप का उपयोग बेहतर नहीं है।
- जब आप जटिल निर्भरता संरचना वाले directed graph के बारे में सोचने लगें।
पाइप्स मूलतः रैखिक (linear) हैं और उनसे जटिल रिश्ते व्यक्त करना कोड को जटिल और अपठनीय बना देगा।
- जब आप आंतरिक पैकेज डेवलपमेंट कर रहे हों
आंतरिक पैकेज डेवलपमेंट में पाइप्स का इस्तेमाल उचित नहीं, क्योंकि इससे डिबग करना कठिन हो जाता है!
इस विषय पर और विचारों के लिए यह Stack Overflow चर्चा देखें। वहाँ उल्लिखित अन्य स्थितियाँ हैं loops, पैकेज डिपेंडेंसी, आर्ग्युमेंट क्रम और पठनीयता।
संक्षेप में, दो बातों को ध्यान में रखें जो इस निर्माण (construct) को बेहतरीन बनाती हैं—पठनीयता और लचीलापन। जैसे ही इनमें से किसी एक से समझौता हो, पाइप्स के बजाय वैकल्पिक तरीकों पर विचार करें।
R में पाइप्स के विकल्प
यह सब पढ़ने के बाद आप R में उपलब्ध विकल्पों में भी रुचि ले सकते हैं। इस ट्यूटोरियल में आपने कुछ समाधान देखे:
- अर्थपूर्ण नामों के साथ मध्यवर्ती वैरिएबल्स बनाना;
सभी ऑपरेशन्स को एक साथ जोड़कर एक ही परिणाम आउटपुट करने के बजाय, चेन को तोड़ें और मध्यवर्ती परिणामों को अलग-अलग वैरिएबल्स में सहेजें। इन वैरिएबल्स का नाम सावधानी से रखें: लक्ष्य हमेशा कोड को यथासंभव समझने योग्य बनाना होना चाहिए!
- अपने कोड को नेस्ट करें ताकि आप उसे अंदर से बाहर पढ़ें;
पाइप्स पर एक संभावित आपत्ति यह हो सकती है कि यह base R के आपके अभ्यस्त "flow" के विपरीत जाता है। तब समाधान है—नेस्टिंग पर टिके रहें! लेकिन यदि आपको पाइप्स पसंद नहीं और नेस्टिंग भी उलझाती है? तब hierarchy को हाईलाइट करने के लिए टैब्स का उपयोग करें।
निष्कर्ष
आपने इस R पाइप्स ट्यूटोरियल में बहुत कुछ कवर किया: आपने देखा कि %>% कहाँ से आया, यह क्या है, क्यों और कैसे इसका उपयोग करना चाहिए। आपने देखा कि dplyr और magrittr साथ मिलकर शानदार काम करते हैं, और यह भी कि और ऑपरेटर भी मौजूद हैं। अंत में, आपने वे स्थितियाँ भी देखीं जहाँ R में कोडिंग करते समय इसका उपयोग नहीं करना चाहिए और उन मामलों में किन विकल्पों पर विचार किया जा सकता है।
यदि आप Tidyverse के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Introduction to the Tidyverse कोर्स देखें।
R Pipes FAQs
R पाइप्स क्या हैं और वे कैसे काम करते हैं?
R पाइप्स कई ऑपरेशन्स को संक्षिप्त और अभिव्यक्तिपूर्ण तरीके से एक साथ चेन करने का तरीका हैं। इन्हें %>% ऑपरेटर से दर्शाया जाता है, जो अपने बाएँ वाले एक्सप्रेशन के आउटपुट को दाएँ वाले फंक्शन के पहले आर्ग्युमेंट के रूप में पास करता है। R में पाइप्स का उपयोग हमें विश्लेषण के चरणों की एक शृंखला जोड़ने देता है।
%>% और %<>% ऑपरेटर्स में क्या अंतर है?
%>% ऑपरेटर अपने बाएँ वाले एक्सप्रेशन के आउटपुट को दाएँ वाले फंक्शन के पहले आर्ग्युमेंट के रूप में पास करता है। %<>% ऑपरेटर भी यही करता है, लेकिन यह बाईं ओर के मान को उसी जगह अपडेट भी कर देता है।
R पाइप्स का उपयोग क्यों करें?
R पाइप्स आपको कोड को अधिक संक्षिप्त और अभिव्यक्तिपूर्ण तरीके से लिखने देते हैं, जिससे आपका कोड पढ़ना और समझना आसान हो जाता है। ये आपको ऑपरेशन्स को उस क्रम में चेन करने देते हैं जैसा आप प्राकृतिक भाषा में उन्हें पढ़ते/लिखते हैं, जिससे आपका कोड अधिक सहज और दूसरों के लिए भी समझने में आसान बनता है।
क्या R पाइप्स के कुछ नुकसान भी हैं?
R पाइप्स का एक संभावित नकारात्मक पहलू यह है कि वे कुछ R उपयोगकर्ताओं के लिए कम परिचित हो सकते हैं, इसलिए उन्हें प्रभावी ढंग से उपयोग करने के लिए थोड़ी अतिरिक्त सीख और अभ्यास की आवश्यकता हो सकती है।
जब आप
dplyr,magrittrजैसे पैकेजों के साथ काम करते हैं, तो आपने पाइप ऑपरेटर देखा या इस्तेमाल किया होगा। लेकिन क्या आप जानते हैं कि पाइप्स और मशहूर%>%ऑपरेटर कहाँ से आए, वे क्या हैं, और आपको उन्हें कैसे, कब और क्यों इस्तेमाल करना चाहिए? क्या आप इनके कुछ विकल्प भी बता सकते हैं?यह ट्यूटोरियल R में पाइप्स का परिचय देगा और निम्न विषयों को कवर करेगा: