Corso
Introduzione a R
4 ore
3.1M
Esegui e modifica il codice da questo tutorial online
Esegui codiceTi interessa imparare a manipolare i dati in R con dplyr? Dai un'occhiata al nostro corso Data Manipulation in R with dplyr.
Per capire cos'è l'operatore pipe in R e cosa puoi farci, è necessario considerare il quadro completo e conoscere la sua storia. Domande come "da dove arriva questa strana combinazione di simboli e perché è stata fatta così?" potrebbero esserti venute in mente. In questa sezione scoprirai le risposte a queste e ad altre domande.
Puoi guardare alla storia da tre prospettive: dal punto di vista matematico, da quello olistico dei linguaggi di programmazione e da quello del linguaggio R stesso. Le vedrai tutte e tre qui di seguito!
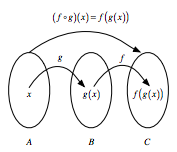
Se hai due funzioni, diciamo $f : B → C$ e $g : A → B$, puoi concatenarle prendendo l'output di una funzione e inserendolo nella successiva. In breve, "concatenare" significa passare un risultato intermedio alla funzione successiva, ma ne vedrai di più tra poco.
Per esempio, puoi scrivere $f(g(x))$: $g(x)$ funge da input per $f()$, mentre $x$, ovviamente, funge da input per $g()$.
Se volessi annotarlo, useresti la notazione $f ◦ g$, che si legge come "f segue g". In alternativa, puoi rappresentarlo visivamente così:
Come accennato nell'introduzione, questo operatore non è nuovo nella programmazione: nella Shell o nel Terminale puoi passare comandi da uno all'altro con il carattere pipeline |. Allo stesso modo, F# ha un operatore di forward pipe, che si rivelerà importante più avanti! Infine, è utile sapere che Haskell contiene molte operazioni di piping derivate dalla Shell o dal Terminale.
Ora che hai visto un po' di storia dell'operatore pipe in altri linguaggi, è il momento di concentrarsi su R. La storia di questo operatore in R inizia il 17 gennaio 2012, quando un utente anonimo ha posto la seguente domanda in questo post su Stack Overflow:
Come si può implementare in R l'operatore di forward pipe di F#? L'operatore permette di concatenare facilmente una sequenza di calcoli. Per esempio, quando hai un dato di input e vuoi chiamare in sequenza le funzioni
fooebar, puoi scriveredata |> foo |> bar?
La risposta è arrivata da Ben Bolker, professore alla McMaster University, che ha risposto:
Non so quanto bene resisterebbe a un uso reale, ma questo sembra (?) fare quello che vuoi, almeno per funzioni a un solo argomento ...
"%>%" <- function(x,f) do.call(f,list(x))
pi %>% sin
[1] 1.224606e-16
pi %>% sin %>% cos
[1] 1
cos(sin(pi))
[1] 1
Circa nove mesi dopo, Hadley Wickham ha iniziato il pacchetto dplyr su GitHub. Potresti conoscere Hadley, Chief Scientist di RStudio, come autore di molti popolari pacchetti R (tra cui quest'ultimo!) e come docente del nostro corso Introduction to Writing Functions in R.
Tuttavia, solo nel 2013 compare in questo pacchetto la prima pipe %.%. Come giustamente menziona Adolfo Álvarez nel suo post, la funzione si chiamava chain() e aveva lo scopo di semplificare la notazione per l'applicazione di diverse funzioni a un unico data frame in R.
La pipe %.% non sarebbe durata a lungo, perché Stefan Bache propose il 29 dicembre 2013 un'alternativa che includeva l'operatore come potresti conoscerlo ora:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Bache continuò a lavorare su questa operazione di pipe e, alla fine del 2013, nacque il pacchetto magrittr. Nel frattempo, Hadley Wickham continuò a lavorare su dplyr e nell'aprile 2014, l'operatore %.% venne sostituito con quello che conosci ora, %>%.
Più tardi, quello stesso anno, Kun Ren pubblicò su GitHub il pacchetto pipeR, che incorporava un diverso operatore di pipe, %>>%, progettato per aggiungere maggiore flessibilità al processo di piping. Tuttavia, si può dire con sicurezza che %>% è ormai consolidato nel linguaggio R, soprattutto con la recente popolarità del Tidyverse.
Conoscere la storia è un conto, ma questo ancora non ti dice cos'è l'operatore di forward pipe di F# né cosa fa effettivamente in R.
In F#, l'operatore di forward pipe |> è zucchero sintattico per chiamate di metodi concatenate. O, più semplicemente, ti permette di passare un risultato intermedio alla funzione successiva.
Ricorda che "concatenare" significa invocare più chiamate di metodo. Poiché ogni metodo restituisce un oggetto, puoi effettivamente concatenare le chiamate in un'unica istruzione, senza aver bisogno di variabili per memorizzare i risultati intermedi.
In R, l'operatore pipe è, come hai già visto, %>%. Se non conosci F#, puoi pensare a questo operatore come simile al + in un'istruzione ggplot2. La sua funzione è molto simile a quella vista per l'operatore di F#: prende l'output di un'istruzione e lo rende l'input della successiva. Nel descriverlo, puoi pensarlo come un "POI".
Prendi, per esempio, il seguente blocco di codice e leggilo ad alta voce:
iris %>%
  subset(Sepal.Length > 5) %>%
  aggregate(. ~ Species, ., mean)
Esatto, il blocco di codice sopra si tradurrà in qualcosa come "prendi i dati di Iris, poi fai il subset dei dati e poi aggreghi i dati".
Questa è una delle cose più potenti del Tidyverse. Infatti, avere una catena standardizzata di azioni di elaborazione si chiama "pipeline". Creare pipeline per un formato di dati è ottimo, perché puoi applicare quella pipeline a dati in arrivo con la stessa formattazione e ottenere, per esempio, un output in un formato adatto a ggplot2.
R è un linguaggio funzionale, il che significa che il tuo codice spesso contiene molte parentesi, ( e ). Con codice complesso, questo di solito implica annidare queste parentesi. Questo rende il codice R difficile da leggere e capire. Ed è qui che %>% viene in tuo soccorso!
Guarda il seguente esempio, tipico di codice annidato:
# Inizializza `x`
x <- c(0.109, 0.359, 0.63, 0.996, 0.515, 0.142, 0.017, 0.829, 0.907)

# Calcola il logaritmo di `x`, restituisci differenze opportunamente ritardate e iterate,
# calcola l'esponenziale e arrotonda il risultato
round(exp(diff(log(x))), 1)
Con l'aiuto di %<%, puoi riscrivere il codice sopra così:
# Importa `magrittr`
library(magrittr)

# Esegui gli stessi calcoli su `x` come sopra
x %>% log() %>%
    diff() %>%
    exp() %>%
    round(1)
Ti sembra difficile? Niente paura! Più avanti in questo tutorial vedrai come procedere.
Nota che devi importare la libreria magrittr per far funzionare il codice sopra. Questo perché l'operatore pipe è, come hai letto, parte della libreria magrittr ed è, dal 2014, anche parte di dplyr. Se dimentichi di importare la libreria, otterrai un errore del tipo Error in eval(expr, envir, enclos): could not find function "%>%".
Nota anche che non è un requisito formale aggiungere parentesi dopo log, diff ed exp, ma nella comunità R alcuni le usano per aumentare la leggibilità del codice.
In breve, ecco quattro motivi per cui dovresti usare le pipe in R:
Questi motivi sono tratti direttamente dalla documentazione di magrittr. Implicitamente, ritornano gli argomenti di leggibilità e flessibilità.
Anche se %>% è l'operatore pipe (principale) del pacchetto magrittr, ci sono altri operatori che dovresti conoscere e che fanno parte dello stesso pacchetto:
%<>%;# Inizializza `x`
x <- rnorm(100)
# Aggiorna il valore di `x` e assegnalo a `x`
x %<>% abs %>% sort
%T>%;rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Nota che è utile sapere che il blocco di codice sopra è in realtà una scorciatoia per:
rnorm(200) %>%
matrix(ncol = 2) %T>%
{ plot(.); . } %>%
colSums
Ma ne vedrai di più più avanti!
%$%.data.frame(z = rnorm(100)) %$%
ts.plot(z)
Ovviamente, questi tre operatori funzionano in modo leggermente diverso dall'operatore principale %>%. Vedrai più avanti in questo tutorial le loro funzionalità e il loro utilizzo.
Nota che, anche se vedrai più spesso le pipe di magrittr, potresti imbatterti in altre pipe lungo la strada! Alcuni esempi sono la dot arrow pipe %.>% o la to dot pipe %>.% di wrapr, o la Bizarro pipe ->.;.
Ora che sai come è nato l'operatore %>%, cosa sia e perché usarlo, è il momento di scoprire come puoi effettivamente sfruttarlo a tuo vantaggio. Vedrai che ci sono parecchi modi per usarlo!
Prima di passare agli usi più avanzati dell'operatore, è bene guardare prima agli esempi più basilari che lo usano. In sostanza, vedrai che ci sono tre regole che puoi seguire quando inizi:
f(x) può essere riscritto come x %>% fIn breve, questo significa che le funzioni che prendono un argomento, function(argument), possono essere riscritte così: argument %>% function(). Guarda il seguente esempio più pratico per capire come queste due forme siano equivalenti:
# Calcola il logaritmo di `x`
log(x)
# Calcola il logaritmo di `x`
x %>% log()
f(x, y) può essere riscritto come x %>% f(y)Ovviamente, ci sono molte funzioni che non prendono un solo argomento, ma multipli. È questo il caso: vedi che la funzione prende due argomenti, x e y. Come nel primo esempio, puoi riscrivere la funzione seguendo la struttura argument1 %>% function(argument2), dove argument1 è il placeholder di magrittr e argument2 la chiamata di funzione.
Tutto questo sembra teorico. Vediamo un esempio più pratico:
# Arrotonda pi
round(pi, 6)
# Arrotonda pi
pi %>% round(6)
x %>% f %>% g %>% h può essere riscritto come h(g(f(x)))Potrebbe sembrare complesso, ma non lo è quando guardi un esempio reale in R:
# Importa i dati `babynames`
library(babynames)
# Importa la libreria `dplyr`
library(dplyr)
# Carica i dati
data(babynames)
# Conta quanti bambini maschi con il nome "Taylor" sono nati
sum(select(filter(babynames,sex=="M",name=="Taylor"),n))
# Fai lo stesso ma ora con `%>%`
babynames%>%filter(sex=="M",name=="Taylor")%>%
select(n)%>%
sum
Nota come lavori dall'interno verso l'esterno quando riscrivi il codice annidato: metti prima babynames, poi usi %>% per prima cosa per filter() i dati. Dopo, selezioni n e infine fai la sum() di tutto.
Ricorda anche che hai già visto un altro esempio di codice annidato convertito in codice più leggibile all'inizio del tutorial, dove hai usato le funzioni log(), diff(), exp() e round() per eseguire calcoli su x.
Sfortunatamente, ci sono alcune eccezioni alle regole generali delineate nella sezione precedente. Vediamone alcune qui.
Considera questo esempio, in cui usi la funzione assign() per assegnare il valore 10 alla variabile x.
# Assegna `10` a `x`
assign("x", 10)
# Assegna `100` a `x`
"x" %>% assign(100)
# Restituisci `x`
x
10
Vedi che la seconda chiamata con la funzione assign(), in combinazione con la pipe, non funziona correttamente. Il valore di x non viene aggiornato.
Perché?
Perché la funzione assegna il nuovo valore 100 a un ambiente temporaneo usato da %>%. Quindi, se vuoi usare assign() con la pipe, devi essere esplicito sull'ambiente:
# Definisci il tuo ambiente
env <- environment()
# Aggiungi l'ambiente a `assign()`
"x" %>% assign(100, envir = env)
# Restituisci `x`
x
100
Gli argomenti nelle funzioni vengono calcolati solo quando la funzione li usa in R. Ciò significa che nessun argomento viene calcolato prima di chiamare la funzione. Significa anche che la pipe calcola a turno ciascun elemento della funzione.
Un caso problematico è tryCatch(), che ti permette di catturare e gestire gli errori, come in questo esempio:
tryCatch(stop("!"), error = function(e) "An error")
stop("!") %>%
tryCatch(error = function(e) "An error")
'An error'
Error in eval(expr, envir, enclos): !
Traceback:
1. stop("!") %>% tryCatch(error = function(e) "An error")
2. eval(lhs, parent, parent)
3. eval(expr, envir, enclos)
4. stop("!")
Vedrai che il modo annidato di scrivere questa riga di codice funziona perfettamente, mentre l'alternativa con la pipe restituisce un errore. Altre funzioni con lo stesso comportamento sono try(), suppressMessages() e suppressWarnings() in base R.
Ci sono anche casi in cui puoi usare l'operatore pipe come placeholder dell'argomento. Guarda i seguenti esempi:
f(x, y) può essere riscritto come y %>% f(x, .)In alcuni casi, non vorrai che il valore o il placeholder di magrittr si trovi al primo posto nella chiamata di funzione, come è stato finora in ogni esempio. Riprendi questa riga di codice:
pi %>% round(6)
Se riscrivessi questa riga, pi sarebbe il primo argomento nella tua funzione round(). Ma cosa succede se vuoi sostituire il secondo, terzo, ... argomento e usare quello come placeholder magrittr nella chiamata?
Guarda questo esempio, dove il valore è in realtà in terza posizione nella chiamata:
"Ceci n'est pas une pipe" %>% gsub("une", "un", .)
'Ceci n\'est pas un pipe'
f(y, z = x) può essere riscritto come x %>% f(y, z = .)Allo stesso modo, potresti voler rendere il valore di un argomento specifico nella tua chiamata di funzione il placeholder di magrittr. Considera la seguente riga di codice:
6 %>% round(pi, digits=.)
È semplice usare il placeholder più volte in un'espressione a destra. Tuttavia, quando il placeholder appare solo in espressioni annidate, magrittr applicherà comunque la regola del primo argomento. Il motivo è che nella maggior parte dei casi questo produce codice più pulito.
Ecco alcune "regole" generali da tenere a mente quando lavori con i placeholder degli argomenti in chiamate annidate:
f(x, y = nrow(x), z = ncol(x)) può essere riscritto come x %>% f(y = nrow(.), z = ncol(.))# Inizializza una matrice `ma`
ma <- matrix(1:12, 3, 4)
# Restituisci il massimo dei valori in input
max(ma, nrow(ma), ncol(ma))
# Restituisci il massimo dei valori in input
ma %>% max(nrow(ma), ncol(ma))
12
12
Il comportamento può essere scavalcato racchiudendo il lato destro tra parentesi graffe:
f(y = nrow(x), z = ncol(x)) può essere riscritto come x %>% {f(y = nrow(.), z = ncol(.))}# Restituisci solo il massimo tra `nrow(ma)` e `ncol(ma)`
ma %>% {max(nrow(ma), ncol(ma))}
4
Per concludere, guarda anche il seguente esempio, in cui potresti voler regolare il funzionamento del placeholder nella chiamata annidata:
# La funzione che vuoi riscrivere
paste(1:5, letters[1:5])
# La chiamata annidata con placeholder punto
1:5 %>%
paste(., letters[.])
Vedi che se il placeholder è usato solo in una chiamata annidata, il placeholder di magrittr verrà posto anche come primo argomento! Se vuoi evitare che accada, puoi usare le parentesi graffe { e }:
# La chiamata annidata con placeholder punto e parentesi graffe
1:5 %>% {
paste(letters[.])
}
# Riscrivi la chiamata sopra
paste(letters[1:5])
Le funzioni unarie sono funzioni che prendono un argomento. Qualsiasi pipeline che tu possa creare composta da un punto ., seguito da funzioni e concatenata con %>%, può essere usata in seguito per applicarla a dei valori. Guarda il seguente esempio di una pipeline del genere:
. %>% cos %>% sin
Questa pipeline prenderebbe un input, dopodiché verrebbero applicate le funzioni cos() e sin().
Ma non abbiamo finito! Se vuoi che questa pipeline faccia esattamente quanto appena letto, devi prima assegnarla a una variabile, ad esempio f. Dopo, potrai riutilizzarla per eseguire le operazioni contenute nella pipeline su altri valori.
# Funzione unaria
f <- . %>% cos %>% sin
f
structure(function (value)
freduce(value, `_function_list`), class = c("fseq", "function"
))Ricorda anche che potresti mettere le parentesi dopo le funzioni cos() e sin() nella riga di codice se vuoi migliorare la leggibilità. Considera lo stesso esempio con le parentesi: . %>% cos() %>% sin().
Vedi, costruire funzioni in magrittr è molto simile a costruirle con R base! Se non sei sicuro di quanto siano simili, guarda la riga sopra e confrontala con la riga seguente: entrambe hanno lo stesso risultato!
# è equivalente a
f <- function(.) sin(cos(.))
f
function (.)
sin(cos(.))Ci sono situazioni in cui vuoi sovrascrivere il valore del lato sinistro, proprio come nell'esempio qui sotto. Intuitivamente, userai l'operatore di assegnazione <- per farlo.
# Carica i dati Iris
iris <- read.csv(url("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data"), header = FALSE)
# Aggiungi i nomi di colonna ai dati Iris
names(iris) <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width", "Species")
# Calcola la radice quadrata di `iris$Sepal.Length` e assegnala alla variabile
iris$Sepal.Length <-
iris$Sepal.Length %>%
sqrt()
Tuttavia, esiste un operatore di assegnazione composto, che ti permette di usare una notazione abbreviata per assegnare il risultato della tua pipeline direttamente al lato sinistro:
# Calcola la radice quadrata di `iris$Sepal.Length` e assegnala alla variabile
iris$Sepal.Length %<>% sqrt
# Restituisci `Sepal.Length`
iris$Sepal.Length
Nota che l'operatore di assegnazione composto %<>% deve essere il primo operatore pipe nella catena perché funzioni. Questo è del tutto in linea con quanto appena letto sull'operatore, che è una scorciatoia per una notazione più lunga con ripetizione, in cui usi il normale operatore di assegnazione <-.
Di conseguenza, questo operatore assegnerà il risultato di una pipeline invece di restituirlo.
L'operatore tee funziona esattamente come %>%, ma restituisce il valore del lato sinistro invece del potenziale risultato delle operazioni sul lato destro.
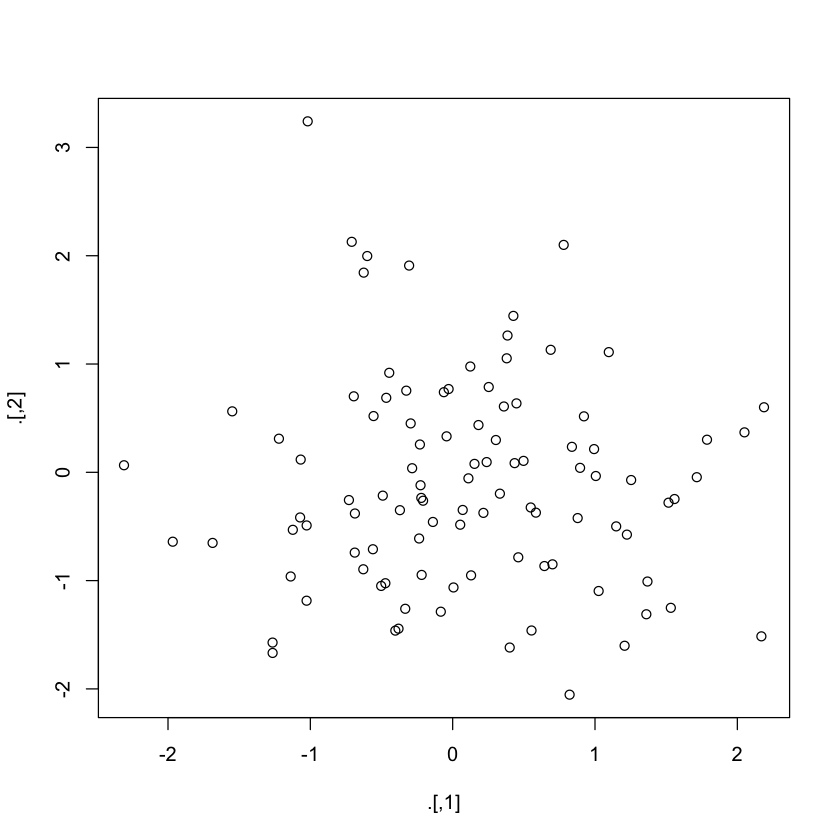
Questo significa che l'operatore tee può essere utile in situazioni in cui hai incluso funzioni usate per il loro effetto collaterale, come la creazione di grafici con plot() o la stampa su file.
In altre parole, funzioni come plot() in genere non restituiscono nulla. Ciò significa che, dopo aver chiamato plot(), per esempio, la tua pipeline finirebbe. Tuttavia, nel seguente esempio, l'operatore tee %T>% ti permette di continuare la pipeline anche dopo aver usato plot():
set.seed(123)
rnorm(200) %>%
matrix(ncol = 2) %T>%
plot %>%
colSums
Quando lavori con R, scoprirai che molte funzioni accettano un argomento data. Considera, per esempio, la funzione lm() o la funzione with(). Queste funzioni sono utili in una pipeline dove i tuoi dati vengono prima elaborati e poi passati alla funzione.
Per funzioni che non hanno un argomento data, come cor(), è comunque comodo poter esporre le variabili nei dati. È qui che entra in gioco l'operatore %$%. Considera il seguente esempio:
iris %>%
subset(Sepal.Length > mean(Sepal.Length)) %$%
cor(Sepal.Length, Sepal.Width)
0.336696922252551
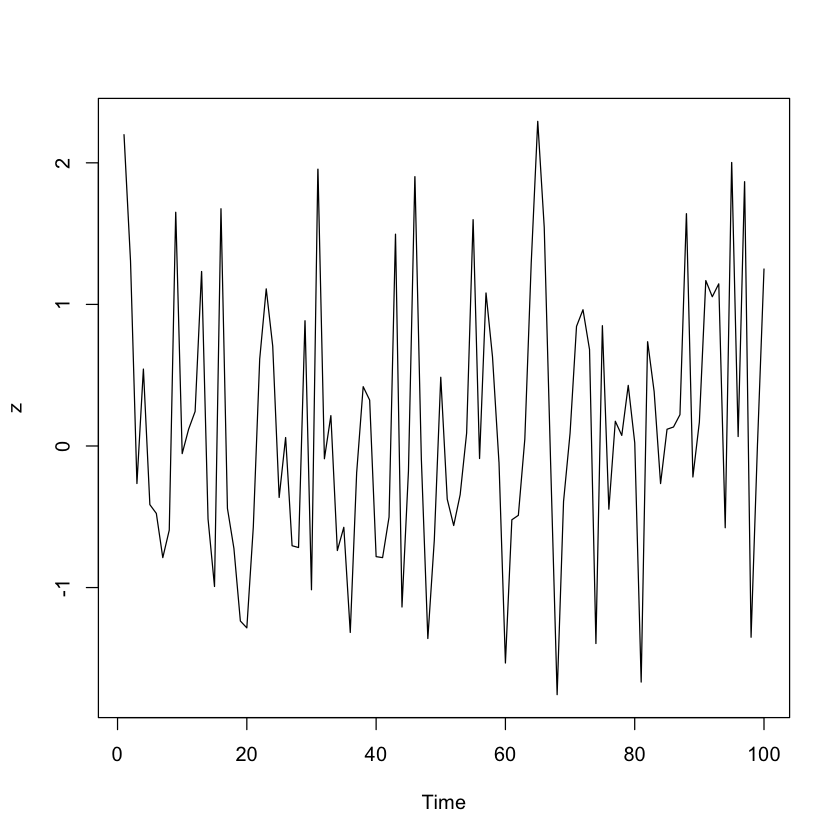
Con l'aiuto di %$% ti assicuri che Sepal.Length e Sepal.Width siano esposte a cor(). Allo stesso modo, vedi che i dati nella funzione data.frame() vengono passati a ts.plot() per tracciare più serie temporali in un unico grafico:
data.frame(z = rnorm(100)) %$%
  ts.plot(z)
dplyr e magrittrNell'introduzione a questo tutorial, hai già appreso che lo sviluppo di dplyr e magrittr è avvenuto più o meno nello stesso periodo, cioè intorno al 2013-2014. E, come hai letto, il pacchetto magrittr fa anche parte del Tidyverse.
In questa sezione scoprirai quanto può essere entusiasmante combinare entrambi i pacchetti nel tuo codice R.
Per chi è nuovo al pacchetto dplyr, dovresti sapere che questo pacchetto R è stato costruito attorno a cinque verbi: "select", "filter", "arrange", "mutate" e "summarize". Se hai già manipolato dati per qualche progetto di data science, saprai che questi verbi coprono la maggior parte delle operazioni di manipolazione che in genere devi eseguire sui tuoi dati.
Prendi un esempio di codice tradizionale che utilizza queste funzioni di dplyr:
library(hflights)

grouped_flights <- group_by(hflights, Year, Month, DayofMonth)
flights_data <- select(grouped_flights, Year:DayofMonth, ArrDelay, DepDelay)
summarized_flights <- summarise(flights_data,
                arr = mean(ArrDelay, na.rm = TRUE),
                dep = mean(DepDelay, na.rm = TRUE))
final_result <- filter(summarized_flights, arr > 30 | dep > 30)

final_result
| Year | Month | DayofMonth | arr | dep |
|---|---|---|---|---|
| 2011 | 2 | 4 | 44.08088 | 47.17216 |
| 2011 | 3 | 3 | 35.12898 | 38.20064 |
| 2011 | 3 | 14 | 46.63830 | 36.13657 |
| 2011 | 4 | 4 | 38.71651 | 27.94915 |
| 2011 | 4 | 25 | 37.79845 | 22.25574 |
| 2011 | 5 | 12 | 69.52046 | 64.52039 |
| 2011 | 5 | 20 | 37.02857 | 26.55090 |
| 2011 | 6 | 22 | 65.51852 | 62.30979 |
| 2011 | 7 | 29 | 29.55755 | 31.86944 |
| 2011 | 9 | 29 | 39.19649 | 32.49528 |
| 2011 | 10 | 9 | 61.90172 | 59.52586 |
| 2011 | 11 | 15 | 43.68134 | 39.23333 |
| 2011 | 12 | 29 | 26.30096 | 30.78855 |
| 2011 | 12 | 31 | 46.48465 | 54.17137 |
Guardando questo esempio, capisci subito perché dplyr e magrittr funzionano così bene insieme:
hflights %>%
    group_by(Year, Month, DayofMonth) %>%
    select(Year:DayofMonth, ArrDelay, DepDelay) %>%
    summarise(arr = mean(ArrDelay, na.rm = TRUE), dep = mean(DepDelay, na.rm = TRUE)) %>%
    filter(arr > 30 | dep > 30)
Entrambi i blocchi di codice sono abbastanza lunghi, ma si può sostenere che il secondo sia più chiaro se vuoi seguire tutte le operazioni. Con la creazione di variabili intermedie nel primo blocco, potresti perdere il "flusso" del codice. Usando %>%, ottieni una panoramica più chiara delle operazioni eseguite sui dati!
In breve, dplyr e magrittr sono la coppia dei sogni per manipolare dati in R!
Aggiungere tutte queste pipe al tuo codice R può essere impegnativo! Per semplificarti la vita, John Mount, co-fondatore e Principal Consultant di Win-Vector, LLC e docente DataCamp, ha rilasciato un pacchetto con alcuni add-in per RStudio che ti permettono di creare scorciatoie da tastiera per le pipe in R. Gli addin sono in realtà funzioni R con un po' di metadati speciali di registrazione. Un esempio di semplice addin può essere una funzione che inserisce uno snippet di testo usato di frequente, ma possono anche diventare molto complessi!
Con questi addin, potrai eseguire funzioni R in modo interattivo dall'IDE RStudio, usando scorciatoie da tastiera o passando dal menu Addins.
Nota che questo pacchetto è in realtà un fork del pacchetto di add-in originale di RStudio. Attenzione però: il supporto per gli addin è disponibile solo nelle versioni più recenti di RStudio! Consulta questo articolo sugli add-in di RStudio per saperne di più.
Puoi scaricare gli add-in e le scorciatoie da tastiera da GitHub.
Qui sopra hai visto che le pipe sono decisamente qualcosa da usare quando programmi in R. Più specificamente, lo hai visto passando in rassegna alcuni casi in cui le pipe si rivelano molto utili! Tuttavia, ci sono delle situazioni, delineate da Hadley Wickham in "R for Data Science", in cui è meglio evitarle:
In casi come questi, è meglio creare oggetti intermedi con nomi significativi. Non solo sarà più facile fare il debug del tuo codice, ma lo capirai meglio tu e sarà più facile da capire anche per gli altri.
Se non stai trasformando un unico oggetto principale, ma stai combinando due o più oggetti, è meglio non usare la pipe.
Le pipe sono fondamentalmente lineari ed esprimere relazioni complesse con esse porterà solo a codice complesso, difficile da leggere e capire.
Usare le pipe nello sviluppo interno di pacchetti è sconsigliato, perché rende più difficile il debug!
Per ulteriori riflessioni su questo argomento, dai un'occhiata a questa discussione su Stack Overflow. Altre situazioni che compaiono in quella discussione sono loop, dipendenze tra pacchetti, ordine degli argomenti e leggibilità.
In breve, potresti riassumere tutto così: tieni a mente le due cose che rendono questa costruzione così efficace, cioè leggibilità e flessibilità. Non appena uno di questi due grandi vantaggi viene meno, potresti considerare alcune alternative al posto delle pipe.
Dopo tutto quello che hai letto, potresti essere interessato anche ad alcune alternative presenti nel linguaggio R. Alcune delle soluzioni che hai visto in questo tutorial sono le seguenti:
Invece di concatenare tutte le operazioni insieme e ottenere un unico risultato, spezza la catena e assicurati di salvare i risultati intermedi in variabili separate. Fai attenzione alla denominazione di queste variabili: l'obiettivo dovrebbe sempre essere rendere il tuo codice il più comprensibile possibile!
Una possibile obiezione alle pipe è che vanno contro il "flusso" a cui sei abituato con R base. La soluzione allora è restare sull'annidamento del codice! Ma cosa fare se non ti piacciono le pipe e pensi che l'annidamento possa essere piuttosto confuso? La soluzione può essere usare le tabulazioni per evidenziare la gerarchia.
Hai coperto un bel po' di terreno in questo tutorial sulle pipe in R: hai visto da dove viene %>%, cos'è esattamente, perché dovresti usarlo e come dovresti usarlo. Hai visto che i pacchetti dplyr e magrittr lavorano meravigliosamente insieme e che esistono anche altri operatori. Infine, hai visto anche alcuni casi in cui non dovresti usarlo quando programmi in R e quali alternative puoi adottare in tali casi.
Se ti interessa saperne di più sul Tidyverse, considera il corso di DataCamp Introduction to the Tidyverse.
Corsi R
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



