
课程
Polars 入门
3 小时
7.1K
实践并学习路径你的进步。
使用 Google 继续在数据分析领域,pandas 长期以来一直是数据专业人士在 Python 中处理表格数据的默认选择。
然而,随着数据集规模和复杂性不断增长,pandas 可能会遇到性能瓶颈、多核利用率有限以及内存受限等问题。
这正是 Polars 作为现代替代方案崭露头角的原因。Polars 是用 Rust 编写的 DataFrame 库,提供极快的性能、高效的内存管理,以及以可扩展性为核心的设计理念。
在本教程中,我们将介绍什么是 Polars,以及如何在 Python 中执行一些基本的 Polars 操作。如果您希望进行动手练习,建议查看 Introduction to Polars 课程。
Polars 提供了一组独特的功能,使其与 pandas 区别开来:
Polars 支持超出基础类型范围的多种数据类型:
Int32、Int64、Float32、Float64。true/false 值。Date、Datetime、Duration、Time。List 与 Struct 类型,适用于类 JSON 数据。作为 pandas 更新、更现代的替代方案,Polars 具有多项优势:
现在,让我们看看如何在 Python 中开始使用 Polars。
在使用 Polars 之前,您需要正确设置环境。
Polars 支持 Windows、macOS 和 Linux。可在虚拟环境、系统 Python,或容器化流程(Docker)中安装。
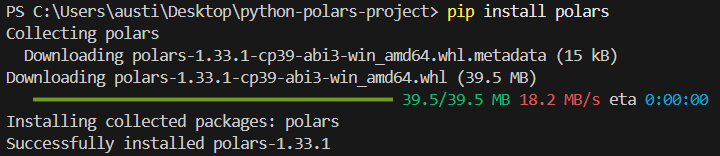
要在 Python 中安装 polars 库,请在终端运行以下命令。
pip install polars您应当会看到如下安装信息:
或者,如果您使用的是 conda 环境,也可以在那里安装该库。
conda install -c conda-forge polars要检查是否安装成功,请编写以下简单脚本:
import polars as pl
print(pl.__version__)通过在启动 Python 会话前设置环境变量,Polars 允许您调优其运行方式和输出展示。例如:
POLARS_MAX_THREADS:限制线程数。POLARS_FMT_MAX_COLS:控制打印的列数。POLARS_FMT_TABLE_WIDTH:调整 DataFrame 展示宽度。以下是在运行 Python 前在 shell 中设置这些变量的示例:
export POLARS_MAX_THREADS=8
export POLARS_FMT_MAX_COLS=20在深入了解 Polars 的特性之前,准备一个可在整个教程中反复使用的数据集会很有帮助。我们可以使用 Python 内置的 csv 模块或 pandas 生成一个简单的 CSV 文件。
下面的示例会创建一个包含合成数据的 transactions.csv 文件:
import csv
import random
from datetime import datetime, timedelta

# Define column names
columns = ["transaction_id", "customer_id", "amount", "transaction_date"]

# Generate synthetic rows
rows = []
start_date = datetime(2023, 1, 1)
for i in range(1, 101):
    customer_id = random.randint(1, 10)
    amount = round(random.uniform(10, 2000), 2)
    date = start_date + timedelta(days=random.randint(0, 90))
    rows.append([i, customer_id, amount, date.strftime("%Y-%m-%d")])

# Write to CSV
with open("transactions.csv", "w", newline="") as f:
    writer = csv.writer(f)
    writer.writerow(columns)
    writer.writerows(rows)
该脚本会创建一个包含 100 笔交易的数据集,其中金额、客户 ID 和交易日期均为随机生成。您可以根据需要调整范围和规模。
保存并运行此脚本一次,您就会得到一个 CSV 文件,可在本文的示例中使用。
Polars 建立在两个核心抽象之上:Series 和 DataFrame。
它们共同提供了一种结构化且高效的数据处理方式,与 pandas 在精神上相似,但由 Polars 的 Rust 引擎进行优化。让我们分解主要概念。
在 Polars 中,Series 是一维数组,类似于电子表格或数据库表中的一列。每个 Series 都具有:
Int64、Utf8、Float64、Boolean 等)。由于严格执行数据类型,Polars 中的 Series 往往比 Python 列表更快且更可预测。
示例:
import polars as pl
# Create a Series of integers
s = pl.Series("numbers", [1, 2, 3, 4, 5])
print(s)输出:
shape: (5,)
Series: 'numbers' [i64]
[
    1
    2
    3
    4
    5
]
DataFrame 是一种二维结构,在一个模式(schema)下将多个 Series 组织在一起。从概念上看,它就像 SQL 或 Excel 中的表。行表示记录,列表示字段。
示例:
df = pl.DataFrame({
    "id": [1, 2, 3],
    "name": ["Alice", "Bob", "Charlie"],
    "age": [25, 30, 35]
})
print(df)输出:
shape: (3, 3)
┌─────┬─────────┬─────┐
│ id  │ name    │ age │
│ --- │ ---     │ --- │
│ i64 │ str     │ i64 │
├─────┼─────────┼─────┤
│ 1   │ Alice   │ 25  │
│ 2   │ Bob     │ 30  │
│ 3   │ Charlie │ 35  │
└─────┴─────────┴─────┘
每一列都是一个 Series,且 DataFrame 会强制其模式。
Polars 的一大优势是严格的模式约束。每列都有固定的数据类型,Polars 确保所有操作都遵循该类型。这可以避免动态类型操作中容易出现的潜在错误。
例如,您不能在未显式转换的情况下,将字符串列与整数列相加。
示例:
df = df.with_columns(
    (pl.col("age") + 5).alias("age_plus_5")
)
print(df)这里,age 是 i64,结果仍为整数。如果尝试与字符串列相加,Polars 会抛出错误,而不会静默失败。
真实世界的数据常常包含缺失值,Polars 提供了清晰的处理工具:
fill_null():用给定值替换空值。drop_nulls():删除包含空值的行。is_null() / is_not_null():布尔检查。Polars 推崇表达式体系,即将操作定义为对列的转换,而非逐行的 Python 循环。
这些表达式是向量化的,意味着它们一次性作用于整列,速度更快。
Polars 会构建快速的向量化计算,而无需手动循环。
Polars 提供两种执行模式:
下面是即时执行的示例:
df = pl.DataFrame({"x": [1, 2, 3]})
print(df.select(pl.col("x") * 2)) # eager: runs instantly下面是惰性执行的示例:
lazy_df = pl.DataFrame({"x": [1, 2, 3]}).lazy()
result = lazy_df.select(pl.col("x") * 2).collect()  # execute on collect()
print(result)
此处在调用 .collect() 前不会进行任何计算。在大型工作流中,这可以显著提升性能。
接下来,我们将基于创建的数据集,演示在 Polars 中执行一些基本操作。
Polars 可从多种文件格式和内存对象中摄取数据。这使其能够灵活集成到现代数据流水线。
以下展示从不同来源读取数据的方法:
从我们之前创建的 CSV 数据集读取:
import polars as pl

df = pl.read_csv("transactions.csv")
print(df.head())
如果需要,我们也可以从 Parquet 中读取数据集。
df_parquet = pl.read_parquet("transactions.parquet")如果您有一个 JSON 文件,可以使用以下代码读取:
df_json = pl.read_json("transactions.json")
#For JSON Lines (NDJSON), use the following instead:
df_json = pl.read_ndjson("transactions.json")
以下展示如何从 Arrow Table 读取数据集:
import pyarrow as pa

arrow_table = pa.table({
    "transaction_id": [1, 2],
    "customer_id": [5, 7],
    "amount": [150.25, 300.75],
    "transaction_date": ["2023-01-02", "2023-01-03"]
})
df_arrow = pl.from_arrow(arrow_table)现在让我们从数据集中选择特定的列或行。
在使用 Polars 时,一个常见操作是选择您想要处理并保留的列。
方法如下:
# Select only transaction_id and amount
df.select(["transaction_id", "amount"])您还可以根据设置的条件筛选行,类似于 pandas。
# Get only high-value transactions above $1,000
high_value = df.filter(pl.col("amount") > 1000)
print(high_value)在 Polars 中应用表达式,涉及在不同的上下文中使用 polars.Expr 对象来执行数据转换。
您可以使用 pl.col() 或 pl.lit() 创建表达式。
# Add a 10% discount column to simulate promotional pricing
df.select([
    pl.col("transaction_id"),
    pl.col("amount"),
    (pl.col("amount") * 0.9).alias("discounted_amount")
])我们可以使用 group_by 来按客户分析消费模式。
# Total and average spend per customer
agg_df = df.group_by("customer_id").agg([
    pl.sum("amount").alias("total_spent"),
    pl.mean("amount").alias("avg_transaction")
])
print(agg_df)
示例输出:
shape: (10, 3)
┌─────────────┬────────────┬───────────────┐
│ customer_id │ total_spent│ avg_transaction│
│ ---         │ ---        │ ---           │
│ i64         │ f64        │ f64           │
├─────────────┼────────────┼───────────────┤
│ 1           │ 5230.12    │ 523.01        │
│ 2           │ 6120.45    │ 680.05        │
│ ...         │ ...        │ ...           │
└─────────────┴────────────┴───────────────┘我们生成的数据集默认没有空值,但让我们模拟如何处理它们。
缺失值可能会对后续分析和数据可视化造成影响。您需要填补缺失值以确保流程顺畅。
填充缺失值的方法如下:
# Imagine 'amount' has missing values, then replace with 0
df_filled = df.with_columns(
    pl.col("amount").fill_null(0)
)如果不处理空值,可能会导致错误。以下是删除它们的方法:
df_no_nulls = df.drop_nulls()数据集中可能存在类型格式不正确的情况。您可以使用 .cast 方法进行转换:
# Ensure customer_id is treated as string instead of int
df_casted = df.with_columns(
    pl.col("customer_id").cast(pl.Utf8)
)Polars 允许通过方法链实现更清晰的工作流。此类链式方法在 SQL 或 R 语言 的 tidyverse 包中也被广泛使用。
示例:找出三月份总消费最高的客户
pipeline = (
    df
   .with_columns(pl.col("transaction_date").str.strptime(pl.Date, format="%Y-%m-%d"))
    #.col("date_str").str.to_date(format="%Y-%m-%d")
    .filter(pl.col("transaction_date").dt.month() == 3)  # transactions in March
    .group_by("customer_id")
    .agg(pl.sum("amount").alias("march_spent"))
    .sort("march_spent", descending=True)
)
print(pipeline)
该流水线将:
这种链式方法允许在不使用中间 DataFrame 的情况下完成流水线分析。
除了基础用法,Polars 在处理大型数据集时尤为出色,这要归功于其惰性求值引擎。该模型先构建查询计划,在幕后进行优化,然后再执行流水线。对于数百万行或复杂转换,这能显著提升性能与效率。
默认情况下,Polars 以即时模式运行,即计算立即发生,类似于 pandas。而惰性模式的工作方式不同:
.collect() 时才会执行这些转换。下面是惰性模式示例:
import polars as pl

# Load dataset in lazy mode
lazy_df = pl.scan_csv("transactions.csv")

# Build a transformation pipeline
pipeline = (
    lazy_df
    .filter(pl.col("amount") > 1000)                # step 1: filter expensive transactions
    .group_by("customer_id")                         # step 2: group by customer
    .agg(pl.sum("amount").alias("total_spent"))     # step 3: aggregate
)

# Nothing has run yet, computation happens only on collect()
result = pipeline.collect()
print(result)Polars 通过应用下推技术来优化查询:
amount > 1000 时,Polars 会在读取 CSV 时就应用该过滤,而不是在加载所有行之后。customer_id 和 amount,Polars 会完全跳过读取 transaction_date。当数据过大而无法放入内存时,Polars 提供流式执行。Polars 不会一次性加载所有数据,而是以批次处理,从而保持稳定的内存占用。
这对多 GB 的 CSV 或 Parquet 文件尤为有用。
示例(流式模式):
# Enable streaming execution for huge datasets
stream_result = (
    lazy_df
    .group_by("customer_id")
    .agg(pl.sum("amount").alias("total_spent"))
    .collect(streaming=True)   # execute in streaming mode
)
使用 streaming=True 时,Polars 会避免构建庞大的内存中间表,使其在大型工作负载上比 pandas 更具可扩展性。
.collect() 执行与惰性查询调试.collect() 方法是触发惰性流水线执行的开关。在此之前,您可以使用以下方法检查和调试查询计划:
.describe_plan():显示逻辑计划。.describe_optimized_plan():显示 Polars 应用下推与简化后的优化计划。Polars 可帮助提升您的分析流水线的运行性能。
以下是一些最佳实践:
实际分析常常需要合并数据集。Polars 提供完整的连接操作套件并进行了优化,即使在大表上也能轻松合并。
Polars 支持所有主要连接类型:
示例:将交易与客户元数据进行连接
# Create customer metadata DataFrame
customers = pl.DataFrame({
    "customer_id": [1, 2, 3, 4, 5],
    "customer_name": ["Alice", "Bob", "Charlie", "David", "Eva"]
})

# Inner join on customer_id
df_joined = df.join(customers, on="customer_id", how="inner")
print(df_joined.head())
Polars 在这两方面都优于 Pandas:
窗口函数允许在组内或按顺序的行上进行计算,而不折叠结果,类似于 SQL 的窗口函数。
Polars 允许使用窗口上下文按客户或按时间段计算统计值。
以下是一些在 Polars 中可用的窗口函数示例:
示例:客户的运行总计
df_window = df.with_columns( pl.col("amount") .sort_by("transaction_date") .cum_sum() .over("customer_id") .alias("running_total") )
print(df_window.head())滚动函数在滑动的行或时间窗口上进行操作。
示例:7 天滚动交易额
df = df.with_columns(pl.col("transaction_date").str.strptime(pl.Date, format="%Y-%m-%d")
rolling = (
    df.group_by_rolling("transaction_date", period="7d")
      .agg(pl.sum("amount").alias("rolling_7d_sum"))
)
print(rolling.head())
通过调整参数,也支持扩展(累计)窗口和中心对齐窗口。
您可以在窗口内使用排名函数和自定义聚合。
示例:按客户对交易额进行排名
ranked = df.with_columns(
    pl.col("amount").rank("dense", descending=True).over("customer_id").alias("rank")
)
print(ranked.head())
这会为每位客户的消费生成排名(1 = 最高)。
窗口函数支持上下文计算:
print(
    df.group_by("customer_id").agg(pl.col("amount").cum_sum().alias("cumulative_spent"))
)对于习惯使用 SQL 的分析师,Polars 提供 SQL 上下文,您可以直接用 SQL 语法查询 DataFrame,同时仍能利用 Polars 的速度。
首先,您需要在运行 SQL 之前注册一个 DataFrame。
from polars import SQLContext

ctx = SQLContext()
ctx.register("transactions", df)下面通过一个示例展示如何在 Python 中使用 Polars 运行 SQL 查询。
示例:使用 SQL 查询每位客户的总消费
result = ctx.execute("""
    SELECT customer_id, SUM(amount) AS total_spent
    FROM transactions
    GROUP BY customer_id
    ORDER BY total_spent DESC
""").collect()

print(result)您可以混合使用 SQL 与表达式:
sql_result = ctx.execute("SELECT * FROM transactions WHERE amount > 1500")
df_sql = sql_result.collect()

# Continue with Polars expressions
df_sql = df_sql.with_columns((pl.col("amount") * 0.95).alias("discounted"))
这对于从 SQL 工具过渡的团队非常有用。
Polars 的目标并非与世隔绝,而是作为一款高性能 DataFrame 库,与更广泛的 Python 数据生态良好协作。这种互操作性确保分析师和工程师可以逐步采用 Polars,同时继续利用现有工具。
以下是一些集成方向:
最后,让我们快速看看一些 Polars 的使用示例:
df = df.with_columns([
    pl.col("transaction_date").str.strptime(pl.Date, "%Y-%m-%d").alias("txn_date"),
    pl.col("amount").fill_null(strategy="mean")
])result = (
pl.read_csv("transactions.csv")
.lazy()
.filter(pl.col("amount") > 1000)
.group_by("customer_id")
.agg(pl.sum("amount").alias("total_spent"))
.collect()
)下面是针对交易金额的滚动平均示例。
import polars as pl

# Load & parse dates
df = (
    pl.read_csv("transactions.csv")
    .with_columns(pl.col("transaction_date").str.strptime(pl.Date, "%Y-%m-%d"))
)

# (A) Overall: daily totals + 7-day rolling average
daily = (
    df.sort("transaction_date")
      .group_by_dynamic("transaction_date", every="1d")
      .agg(pl.sum("amount").alias("daily_total"))
      .sort("transaction_date")
      .with_columns(
          pl.col("daily_total").rolling_mean(window_size=7).alias("ma7")
      )
)

# (B) Per-customer: daily totals + 7-day rolling average within each customer
daily_by_cust = (
    df.sort("transaction_date")
     .group_by_dynamic(index_column="transaction_date", every="1d", by="customer_id")
      .agg(pl.sum("amount").alias("daily_total"))
      .sort(["customer_id", "transaction_date"])
      .with_columns(
          pl.col("daily_total")
            .rolling_mean(window_size=7)
            .over("customer_id")
            .alias("ma7_per_customer")
      )
)

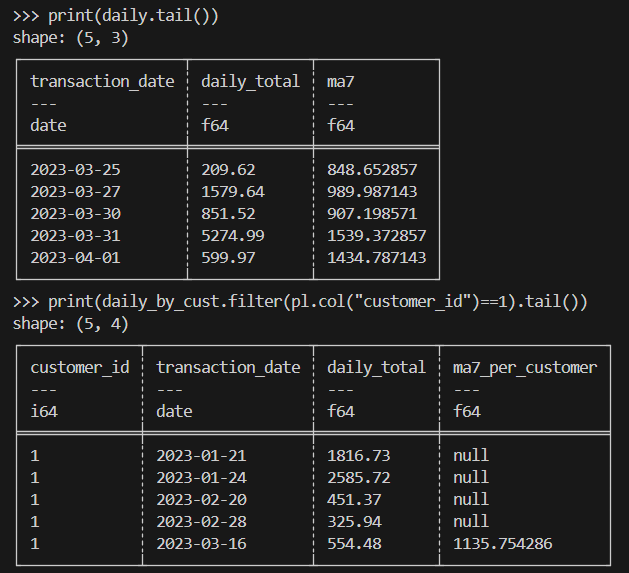
print(daily.tail())
print(daily_by_cust.filter(pl.col("customer_id")==1).tail())
预期结果如下所示:
在进行科学计算时,您需要高效处理数百万行的实验或模拟类交易数据。
下面是一个示例实现:
import polars as pl

# Assume a very large Parquet file with columns: id, value, ts (UTC)
# Use lazy scan_* to avoid loading into memory up-front
lazy = (
    pl.scan_parquet("experiments.parquet")           # or: pl.scan_csv("experiments.csv")
      .filter(pl.col("value") > 0)                   # predicate pushdown
      .select(["id", "value", "ts"])                 # projection pushdown
      .with_columns(
          # Example transformations: standardization & bucketize timestamps by hour
          ((pl.col("value") - pl.col("value").mean()) / pl.col("value").std())
              .alias("z_value"),
          pl.col("ts").dt.truncate("1h").alias("ts_hour")
      )
      .group_by(["id", "ts_hour"])
      .agg([
          pl.len().alias("n"),
          pl.mean("z_value").alias("z_mean"),
          pl.std("z_value").alias("z_std")
      ])
      .sort(["id", "ts_hour"])
)

# Execute in streaming mode to keep memory usage low
result = lazy.collect(streaming=True)

# Optionally write out partitioned Parquet for downstream analysis
result.write_parquet("experiments_hourly_stats.parquet")
print(result.head())Python Polars 提供了一个现代、高性能的 DataFrame 库,解决了许多 pandas 的限制。尽管 pandas 仍然在较小、临时的分析中很受欢迎,但对于可扩展、高效且可靠的数据处理,Polars 越来越成为 Python 领域的首选工具。
想进一步了解 Polars?您一定会喜欢我们的Introduction to Polars 课程,或我们的Introduction to Polars 文章。我们的Polars Engine 文章您可能也会感兴趣。
热门 DataCamp 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续