
{count, plural, other {课程}}
R 中的回归入门
{hours} 小时
79.4K
从本质上讲,R² 说明了因变量的方差中有多大比例可归因于自变量(或自变量组)。我们可以将其理解为模型对数据“故事”的把握程度,以及还剩下多少无法解释的噪声。由于其概念简洁、解释直接,R² 在线性回归诊断中被广泛使用,尤其是在简单与多元线性回归中。
本文将讨论 R² 的含义、计算方法、解释方式以及常见误区,从而在实践中既自信又谨慎地使用它。此外,我们还将给出在 R 和 Python 中计算 R² 的一些代码示例。
R²(记作 R²)是回归模型拟合优度的统计量。它告诉我们,因变量的变异中有多少可以由模型解释。
R² 的取值介于 0 与 1 之间:
尽管概念直接,但在从理论走向实践时,R² 的解释需要更细腻的把握。
计算 R² 有多种在数学上等价的方法,每一种都从不同角度揭示“拟合”的含义,取决于场景——如简单回归、多元回归、矩阵代数或贝叶斯建模。下面介绍最常用的几种方法。
这是最标准、最常用的公式:
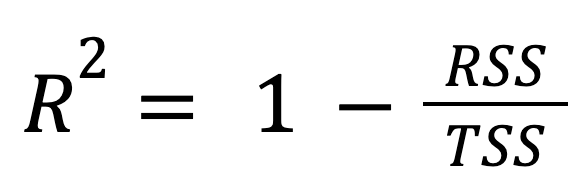
其中:
换言之,R² 表示模型所解释的总变异占比。
这种方式突出显示回归模型相较于仅预测响应变量均值时的改进程度。
R² 也可直接用解释方差来表示:
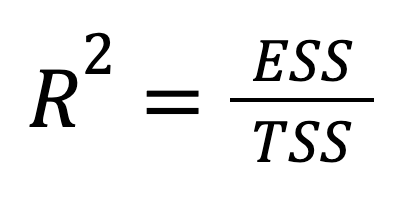
其中:
这一版本强调模型预测对结果总变异的覆盖程度。换句话说,焦点从我们未能解释的部分(RSS)转向我们已经解释的部分(ESS),从而提供一种更为乐观的表述。
如需深入了解三种平方和的组成Understanding Sum of Squares: A Guide to SST, SSR, and SSE。
在 ANOVA 表的语境下,R² 自然地从总变异的分解中出现:

其中:
该表述体现了模型捕捉到的总方差比例,以及剩余未解释的部分。
这一视角的独特之处在于将 R² 与假设检验联系起来。这是因为 ESS 与 RSS 的比值用于计算 F 统计量,使得 R² 成为 ANOVA 风格显著性检验中的重要组成部分。
前面三种方法都是由回归分解推导而来的代数等价公式。现在,换一个新视角:
在只有一个自变量的简单线性回归中,R² 有一个捷径:
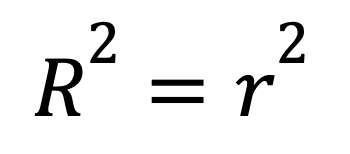
其中
该公式表明,两变量之间较强的线性关系会直接转化为较高的 R²。
若要理解简单线性回归背后的理论,请参阅Simple Linear Regression: Everything You Need to Know。
R² 也可视为一种对模型误差的归一化度量:
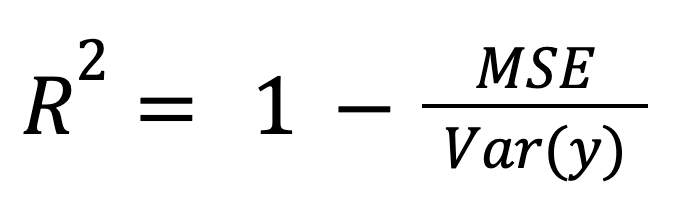
其中:
当跨不同量纲或单位比较模型时,这种表述尤其有用,因为它用数据整体离散程度对模型误差进行了归一化。
在残差与预测不相关的假设下,R² 也可被解释为模型所捕捉到的方差占比:
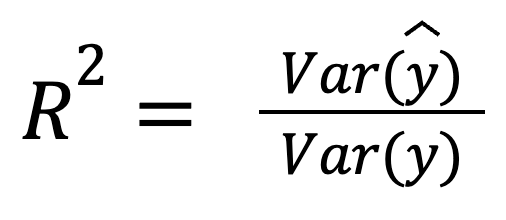
其中:
该版本强调预测值本身对真实数据离散程度的反映情况。
如前所述,R² 容易计算,但要有意义地解读则更具挑战。
需要牢记的是,R²度量的是相关,而非因果。即便自变量能够解释结果,也不代表它们导致了该结果,相关并不意味着因果。此外,R² 也不表明预测是否准确。
以下是两个与线性回归进阶主题相关的资源:
在合适的情境下,R² 十分有用。它适用于:
另一方面,以下情形下 R² 可能具有误导性:
下面使用 Kaggle 的 Fish Market 数据集来展示 R² 概念。在两种编程语言中,我们将构建两个模型:
先来看 R。
# Load data
fish <- read.csv("Fish.csv")

# Model 1
model1 <- lm(Weight ~ Length1 + Length2 + Height + Width, data=fish)
summary(model1)$r.squared
输出:
[1] 0.8673# Model 2 with an irrelevant predictor
fish$random_noise <- rnorm(nrow(fish))
model2 <- lm(Weight ~ Length1 + Length2 + Height + Width + random_noise, data=fish)
summary(model2)$r.squared输出:
[1] 0.8679可以看到,在加入无关自变量(模型 2)后,R² 略有上升。然而这并不意味着模型变得更好,毕竟我们只是加入了随机噪声。
想要进一步阅读,请参阅以下教程:
并记得参加我们的相关课程:
接下来试试 Python。
import pandas as pd
import statsmodels.api as sm
import numpy as np

# Load data
fish = pd.read_csv('Fish.csv')
X1 = fish[['Length1', 'Length2', 'Height', 'Width']]
y = fish['Weight']

# Model 1
X1 = sm.add_constant(X1)
model1 = sm.OLS(y, X1).fit()
print(model1.rsquared)
输出:
0.8673# Model 2 with an irrelevant predictor
fish['random_noise'] = np.random.randn(len(fish))
X2 = fish[['Length1', 'Length2', 'Height', 'Width', 'random_noise']]
X2 = sm.add_constant(X2)
model2 = sm.OLS(y, X2).fit()
print(model2.rsquared)输出:
0.8679同样,我们观察到 R² 略有上升,但这只是捕捉到了随机噪声。
继续学习,欢迎报名以下课程:
接下来简要比较 R² 与两个相关指标:调整 R² 和预测 R²。
与 R² 不同,调整 R² 会考虑自变量的数量,具体而言,它会因包含不必要的自变量而对模型进行惩罚:
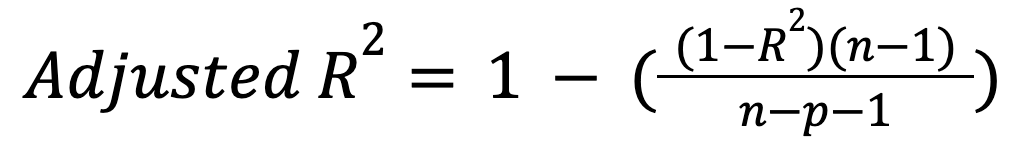
其中:
该指标仅在新自变量能实质提升模型时才会上升,反之则可能下降。想进一步了解这一重要扩展,请阅读教程:Adjusted R-Squared: A Clear Explanation with Examples。
常规 R² 反映模型在训练数据上的表现,而预测 R² 则衡量其在新的、未见过的数据上的表现。因此,该指标评估的是模型的泛化能力。
预测 R² 通常通过交叉验证或留出部分训练数据进行测试来计算。如果模型过拟合,则预测 R² 可能显著低于常规 R²。因此,当常规 R² 很高而预测 R² 很低时,多半表明模型过拟合。
下面来看一些关于 R² 的常见“神话”,以及事实真相:
总而言之,我们了解了什么是 R²,如何计算这一指标(数学上以及在 R 与 Python 中实现),何时使用与避免使用它,以及如何解读结果。此外,我们还涉及了两个相关指标和一些关于 R² 的常见误解。
简言之,R² 是衡量回归模型拟合优度的一个有用、直观且简洁的指标。它是模型评估的良好起点,但应谨慎使用,并与其他指标结合解读,切勿将其视为全部,尤其在多元回归与模型选择的情境中。
与 DataCamp 一起学习
{count, plural, other {课程}}
{count, plural, other {课程}}
{count, plural, other {课程}}