Kimi K2 由 Moonshot AI 开发,是一款最前沿的专家混合(Mixture-of-Experts,MoE)语言模型。它在前沿知识、推理与编程任务上表现出色,并针对具身智能能力(包括工具使用与自主解决问题)进行了专项优化。
正如我们在Kimi K2 指南中所探讨的,这一模型在各项基准测试中取得了优异成绩,成为当前最优秀的通用开源语言模型。我们正处在Deepseek R1 时刻。为此,我将教您如何在单块 GPU 上运行这台高达 1 TB 的巨型模型。
我们将学习如何配置 Runpod 机器、安装 llama.cpp,并以更快速度下载模型。另外,我们会使用 llama.cpp 的 CLI 运行模型,将部分模型层卸载到内存(RAM)。最后,我们还将解决运行此类模型时常见的问题。您也可以查看我们关于全新 Kimi K2.5(Agent Swarm) 的指南。
设置 Runpod
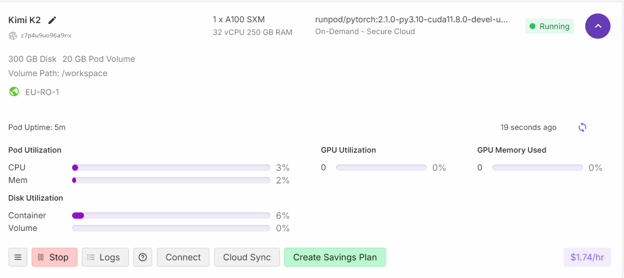
前往Runpod GPU Cloud,使用 Python Container Image 2.8.0 版本,在 A100 SXM 机器上创建云实例。
之后,通过 Edit pod 选项将容器磁盘存储提升至 300 GB。
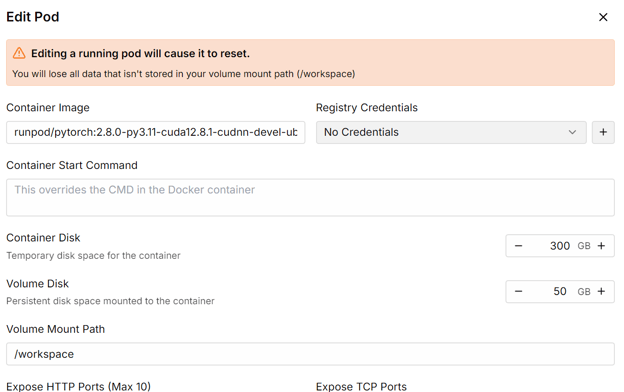
一切就绪后,您会看到已拥有 300 GB 存储空间,这已足够,因为我们的 1-bit 量化模型需要 250 GB 存储。
安装 llama.cpp
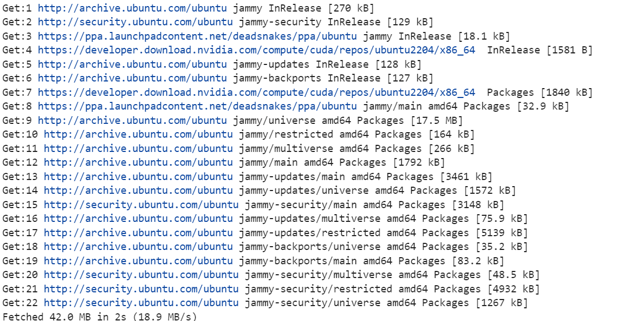
1. 点击 connect 按钮,启动 Jupyter Lab 实例。新建一个 Notebook,并安装必要的 Linux 工具,如 cmake 与 curl。
!apt-get update
!apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y技术支持
2. 将目录切换到根目录。我们不会使用 workspace 目录。这样做的原因是提升模型下载与加载速度。您可在末尾的故障排查部分了解更多。
%cd ..技术支持
3. 克隆最新的 llama.cpp 仓库。
!git clone https://github.com/ggml-org/llama.cpp技术支持
4. 设置构建选项。我们将在 GPU 机器上进行构建。如果您想使用 CPU 推理,请将 DGGML_CUDA=ON 改为 DGGML_CUDA=OFF。
!cmake llama.cpp -B llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DLLAMA_CURL=ON \
  -DCMAKE_CUDA_ARCHITECTURES="80;90" \
  -DCMAKE_CUDA_FLAGS="-Wno-deprecated-gpu-targets"技术支持
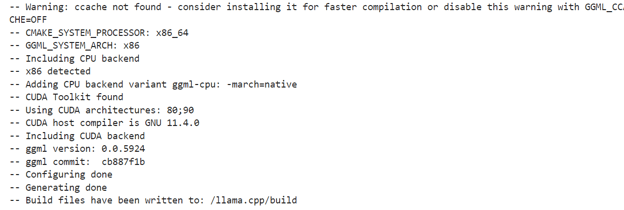
5. 我们将使用 cmake 命令来构建以下工具:llama-quantize、llama-cli、llama-gguf-split 和 llama-mtmd-cli。
!cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli技术支持
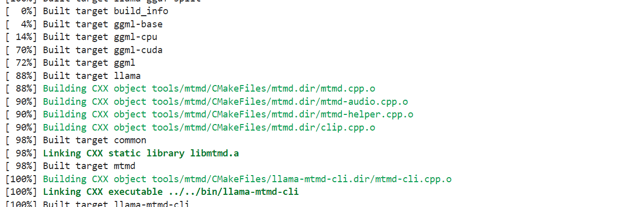
6. 将所有构建产物复制到主仓库目录,便于访问。
!cp llama.cpp/build/bin/llama-* llama.cpp技术支持
使用 xnet 极速下载 Kimi K2
Unsloth 提供的 Kimi K2 量化版本支持 xnet,可实现较 Git LFS 快 4 倍的下载与上传。要在本地启用它,请安装最新版的 huggingface_hub 与 hf_transfer:
!pip install huggingface_hub hf_transfer技术支持
使用 snapshot_download API 仅下载该仓库的 1-bit 量化 GGUF 模型文件:
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0"

from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Kimi-K2-Instruct-GGUF",
    local_dir = "/unsloth/Kimi-K2-Instruct-GGUF",
    allow_patterns = ["*UD-TQ1_0*"],
)技术支持
下载耗时取决于您的网络与存储速度。
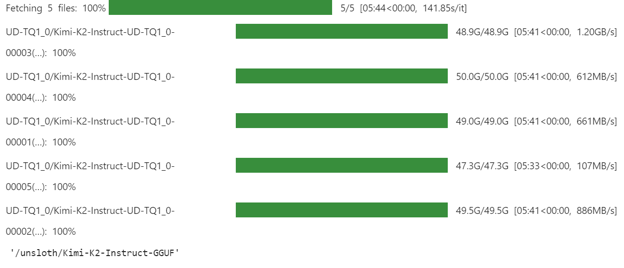
启用 xnet 并使用更快的存储后,我们的下载速度非常快。
如何在本地运行 Kimi K2
现在可以测试我们量化后的模型了。这个阶段我花了最多时间调试,因为要在单块 GPU 上运行。虽然并非不可能,但在模型加载与执行方面会遇到一些问题。
我们使用全部 CPU 线程,并尽量将更多层加载到 GPU。这涉及将上下投影的专家混合层卸载到 CPU。
下面是在终端中运行且表现稳定的命令:
./llama.cpp/llama-cli \
  --model /unsloth/Kimi-K2-Instruct-GGUF/UD-TQ1_0/Kimi-K2-Instruct-UD-TQ1_0-00001-of-00005.gguf \
  --cache-type-k q4_0 \
  --threads -1 \
  --n-gpu-layers 99 \
  --temp 0.6 \
  --min_p 0.01 \
  --ctx-size 16384 \
  --seed 3407 \
  -ot ".ffn_(up|down)_exps.=CPU" \
  --prompt "Hey"技术支持
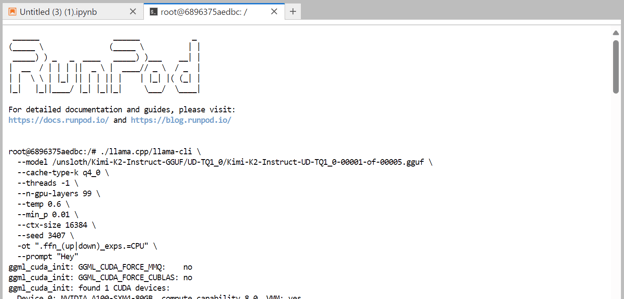
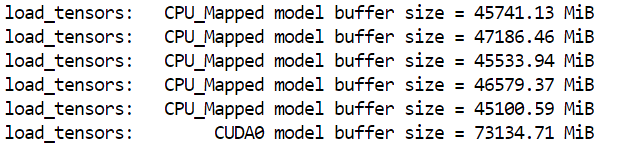
加载完整模型耗时将近一分钟。可见模型能很好地装入这台机器。
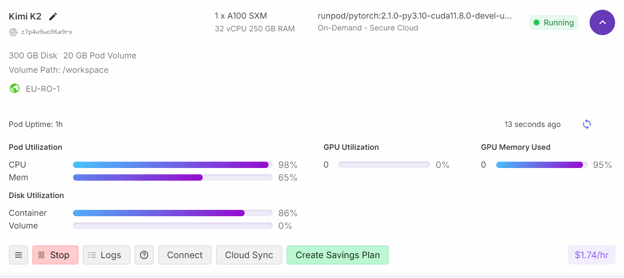
在 Runpod 仪表盘中,您会看到 CPU 利用率很高,且 RAM 与 VRAM 均在使用中。
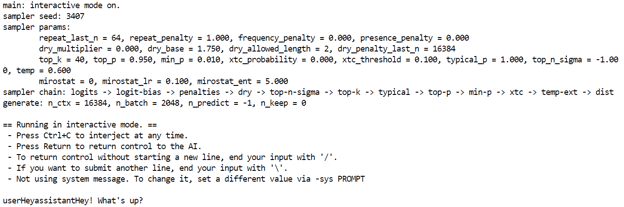
大约在加载与预热四分钟后,您就可以开始向模型提问了。
我提了个简单问题:“What is monsoon? Write the answer in one line.”
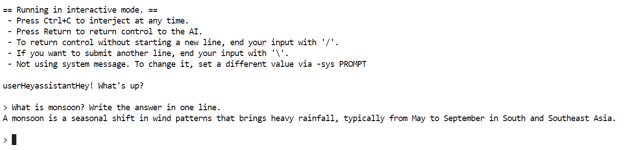
生成几乎花了五分钟时间。
我调查了为何生成 token 很慢,结果发现 GPU 只作为显存使用,而所有计算都由 CPU 完成。为解决此问题,您需要将更多层卸载到 GPU,这意味着需要 2 台 A100 机器。
故障排查
本节将讨论在单块 GPU 上运行大型模型时常见的问题,以及如何应对。
1. 了解 VRAM 与计算(compute)的区别
当您看到 GPU 内存使用 95%、GPU 计算 0%、CPU 负载 99% 时,通常意味着 VRAM 仅充当模型的内存存储,而实际计算发生在 CPU 上。
即便是高度量化、体积更小的 1-bit 模型,仍需加载到内存中,这会导致 VRAM 占用。只有将更多层卸载到 VRAM 后,GPU 才会开始参与计算。
2. 解决 token 生成缓慢
要提升 token 生成速度,需要将更多模型层卸载到 GPU。也可考虑多 GPU 方案,比如三块 A100。将温度设置为 0.6,有助于减少生成文本的重复与不连贯。
3. 硬件要求与性能
如果 VRAM 或 RAM 受限,您仍可在消费级 CPU 上运行 1-bit 模型。但生成速度会非常慢(例如 20 秒/个 token)。
运行 1-bit 模型的唯一硬性要求是:磁盘空间 + RAM + VRAM 的总和 ≥ 250GB。
若想获得最佳性能(每秒 5 个以上 token),至少需要 250GB 统一内存,或 RAM 与 VRAM 合计达到 250GB。
4. 处理下载缓慢
安装最新版的 huggingface_hub 与 hf_transfer,以获得 “xnet 速度”,其比普通 Git LFS 快 4 倍。
为优化 GGUF 分片文件的存储与加载,建议使用容器磁盘(container disk)而非容器卷(container volume)进行存储。因为容器卷可能导致下载与模型加载缓慢。
5. 处理模型加载缓慢
加载缓慢通常意味着您在加载超大型模型。从网络存储加载会显著拖慢速度。务必使用本地 M.2 SSD 存储模型。与传统硬盘或网络存储相比,M.2 SSD 的读写速度快得多,可大幅缩短加载时间。
若 RAM 不足以加载模型,操作系统可能会将数据换出到磁盘(使用 swap 文件),其速度远慢于 RAM,造成瓶颈。尽量采用多 GPU 且更大 RAM 的方案。
结语
运行量化版 Kimi K2 仍可能遇到挑战,因为诸如llama.cpp 等工具在持续演进以追赶模型的最新更新。未来数周内,您可期待更完善的方案,将 token 生成计算转移到 GPU,以获得更佳性能,而非仅依赖 CPU。
此外,这对我来说也是一次宝贵的学习经历。我更深入地了解了开源社区如何协作,尽可能高效地优化与部署这些模型。
Kimi K2 脱颖而出,成为顶尖的开源模型之一,在前沿知识、数学与编程方面,作为非“思维链”类模型也能达到最先进水平,能力已接近 DeepSeek R1 等模型。
它在工具选择与代理型任务方面尤为强大,是 Claude 4 Sonnet 等高端模型在编码项目或“vibe coding”中的高性价比替代方案。
您可以按照本指南,将量化版 Kimi K2 部署为内部解决方案。Llama.cpp 允许以兼容 OpenAI 的 API 形式服务语言模型。想继续学习,请务必查看我们的Kimi K2 示例指南。若您对代理型 AI 感兴趣,欢迎学习我们的新课程:使用 LangGraph 构建多智能体系统。


Kimi K2 由 Moonshot AI 开发,是一款最前沿的专家混合(Mixture-of-Experts,MoE)语言模型。它在前沿知识、推理与编程任务上表现出色,并针对具身智能能力(包括工具使用与自主解决问题)进行了专项优化。
正如我们在Kimi K2 指南中所探讨的,这一模型在各项基准测试中取得了优异成绩,成为当前最优秀的通用开源语言模型。我们正处在Deepseek R1 时刻。为此,我将教您如何在单块 GPU 上运行这台高达 1 TB 的巨型模型。
我们将学习如何配置 Runpod 机器、安装 llama.cpp,并以更快速度下载模型。另外,我们会使用 llama.cpp 的 CLI 运行模型,将部分模型层卸载到内存(RAM)。最后,我们还将解决运行此类模型时常见的问题。您也可以查看我们关于全新 Kimi K2.5(Agent Swarm) 的指南。
设置 Runpod
前往Runpod GPU Cloud,使用 Python Container Image 2.8.0 版本,在 A100 SXM 机器上创建云实例。
之后,通过 Edit pod 选项将容器磁盘存储提升至 300 GB。
一切就绪后,您会看到已拥有 300 GB 存储空间,这已足够,因为我们的 1-bit 量化模型需要 250 GB 存储。
安装 llama.cpp
1. 点击 connect 按钮,启动 Jupyter Lab 实例。新建一个 Notebook,并安装必要的 Linux 工具,如
cmake与curl。2. 将目录切换到根目录。我们不会使用 workspace 目录。这样做的原因是提升模型下载与加载速度。您可在末尾的故障排查部分了解更多。
3. 克隆最新的 llama.cpp 仓库。
4. 设置构建选项。我们将在 GPU 机器上进行构建。如果您想使用 CPU 推理,请将
DGGML_CUDA=ON改为DGGML_CUDA=OFF。5. 我们将使用
cmake命令来构建以下工具:llama-quantize、llama-cli、llama-gguf-split和llama-mtmd-cli。6. 将所有构建产物复制到主仓库目录,便于访问。
使用 xnet 极速下载 Kimi K2
Unsloth 提供的 Kimi K2 量化版本支持 xnet,可实现较 Git LFS 快 4 倍的下载与上传。要在本地启用它,请安装最新版的
huggingface_hub与hf_transfer:使用
snapshot_downloadAPI 仅下载该仓库的 1-bit 量化 GGUF 模型文件:下载耗时取决于您的网络与存储速度。
启用 xnet 并使用更快的存储后,我们的下载速度非常快。
如何在本地运行 Kimi K2
现在可以测试我们量化后的模型了。这个阶段我花了最多时间调试,因为要在单块 GPU 上运行。虽然并非不可能,但在模型加载与执行方面会遇到一些问题。
我们使用全部 CPU 线程,并尽量将更多层加载到 GPU。这涉及将上下投影的专家混合层卸载到 CPU。
下面是在终端中运行且表现稳定的命令:
加载完整模型耗时将近一分钟。可见模型能很好地装入这台机器。
在 Runpod 仪表盘中,您会看到 CPU 利用率很高,且 RAM 与 VRAM 均在使用中。
大约在加载与预热四分钟后,您就可以开始向模型提问了。
我提了个简单问题:“What is monsoon? Write the answer in one line.”
生成几乎花了五分钟时间。
我调查了为何生成 token 很慢,结果发现 GPU 只作为显存使用,而所有计算都由 CPU 完成。为解决此问题,您需要将更多层卸载到 GPU,这意味着需要 2 台 A100 机器。
故障排查
本节将讨论在单块 GPU 上运行大型模型时常见的问题,以及如何应对。
1. 了解 VRAM 与计算(compute)的区别
当您看到 GPU 内存使用 95%、GPU 计算 0%、CPU 负载 99% 时,通常意味着 VRAM 仅充当模型的内存存储,而实际计算发生在 CPU 上。
即便是高度量化、体积更小的 1-bit 模型,仍需加载到内存中,这会导致 VRAM 占用。只有将更多层卸载到 VRAM 后,GPU 才会开始参与计算。
2. 解决 token 生成缓慢
要提升 token 生成速度,需要将更多模型层卸载到 GPU。也可考虑多 GPU 方案,比如三块 A100。将温度设置为 0.6,有助于减少生成文本的重复与不连贯。
3. 硬件要求与性能
如果 VRAM 或 RAM 受限,您仍可在消费级 CPU 上运行 1-bit 模型。但生成速度会非常慢(例如 20 秒/个 token)。
运行 1-bit 模型的唯一硬性要求是:磁盘空间 + RAM + VRAM 的总和 ≥ 250GB。
若想获得最佳性能(每秒 5 个以上 token),至少需要 250GB 统一内存,或 RAM 与 VRAM 合计达到 250GB。
4. 处理下载缓慢
安装最新版的
huggingface_hub与hf_transfer,以获得 “xnet 速度”,其比普通 Git LFS 快 4 倍。为优化 GGUF 分片文件的存储与加载,建议使用容器磁盘(container disk)而非容器卷(container volume)进行存储。因为容器卷可能导致下载与模型加载缓慢。
5. 处理模型加载缓慢
加载缓慢通常意味着您在加载超大型模型。从网络存储加载会显著拖慢速度。务必使用本地 M.2 SSD 存储模型。与传统硬盘或网络存储相比,M.2 SSD 的读写速度快得多,可大幅缩短加载时间。
若 RAM 不足以加载模型,操作系统可能会将数据换出到磁盘(使用 swap 文件),其速度远慢于 RAM,造成瓶颈。尽量采用多 GPU 且更大 RAM 的方案。
结语
运行量化版 Kimi K2 仍可能遇到挑战,因为诸如llama.cpp 等工具在持续演进以追赶模型的最新更新。未来数周内,您可期待更完善的方案,将 token 生成计算转移到 GPU,以获得更佳性能,而非仅依赖 CPU。
此外,这对我来说也是一次宝贵的学习经历。我更深入地了解了开源社区如何协作,尽可能高效地优化与部署这些模型。
Kimi K2 脱颖而出,成为顶尖的开源模型之一,在前沿知识、数学与编程方面,作为非“思维链”类模型也能达到最先进水平,能力已接近 DeepSeek R1 等模型。
它在工具选择与代理型任务方面尤为强大,是 Claude 4 Sonnet 等高端模型在编码项目或“vibe coding”中的高性价比替代方案。
您可以按照本指南,将量化版 Kimi K2 部署为内部解决方案。Llama.cpp 允许以兼容 OpenAI 的 API 形式服务语言模型。想继续学习,请务必查看我们的Kimi K2 示例指南。若您对代理型 AI 感兴趣,欢迎学习我们的新课程:使用 LangGraph 构建多智能体系统。