
Corso
Creare agenti AI con Google ADK
1 ore
7.6K
Kimi K2, sviluppato da Moonshot AI, è un modello linguistico Mixture-of-Experts (MoE) all’avanguardia. Eccelle in conoscenze di frontiera, ragionamento e coding ed è ottimizzato in modo specifico per capacità agentiche, tra cui l’uso di tool e la risoluzione autonoma dei problemi.
Come esploriamo nella nostra guida a Kimi K2, il modello sta ottenendo risultati eccezionali nei benchmark, rendendolo il miglior modello linguistico open source general-purpose. Stiamo vivendo il momento Deepseek R1 e, per celebrarlo, ti mostrerò come eseguire questo enorme modello da 1 terabyte su una singola GPU.
Impareremo a configurare la macchina Runpod, installare llama.cpp e scaricare il modello a una velocità maggiore. Inoltre, eseguiremo il modello usando la CLI di llama.cpp, scaricando i layer del modello sulla RAM. Infine, affronteremo i problemi più comuni che emergono quando si eseguono questi modelli. Puoi trovare anche la nostra guida alla nuova Kimi K2.5 con Agent Swarm.
Vai su Runpod GPU Cloud e crea un cloud con la macchina A100 SXM utilizzando la Python Container Image versione 2.8.0.
Dopodiché, aumenta l’archiviazione del disco del container a 300 GB usando l’opzione Edit pod.
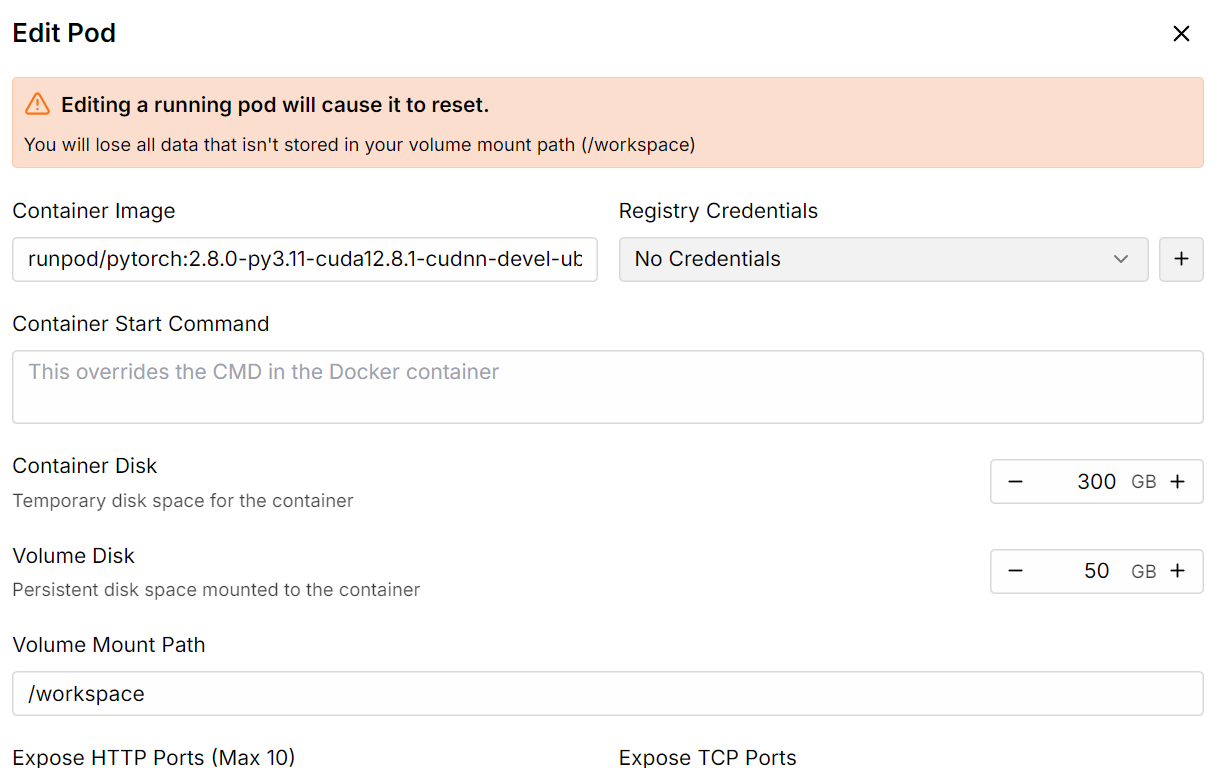
Una volta terminata la configurazione, vedrai che hai 300 GB di storage, sufficienti perché il nostro modello quantizzato a 1 bit richiede 250 GB di spazio.
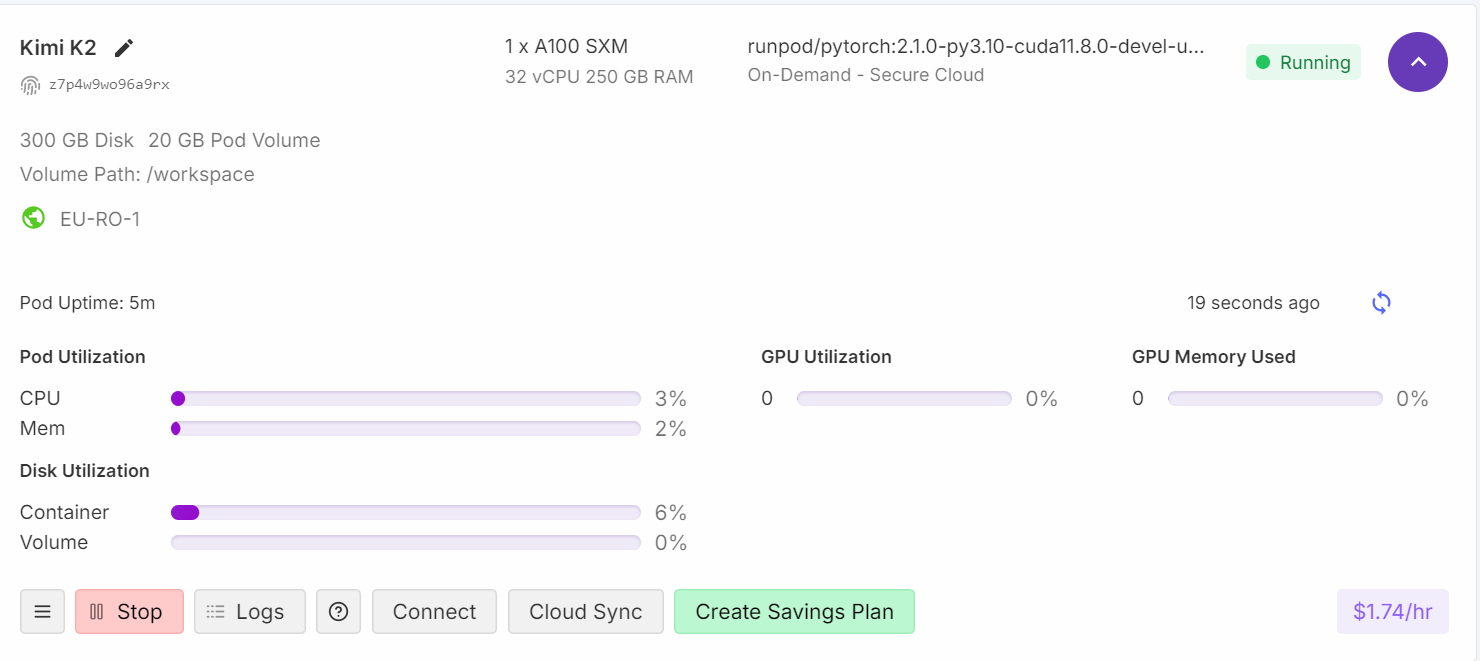
1. Clicca sul pulsante connect e avvia l’istanza Jupyter Lab. Crea un nuovo notebook e installa gli strumenti Linux necessari, come cmake e curl.
!apt-get update
!apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
2. Cambia la directory alla root. Non useremo la directory workspace. Il motivo è aumentare sia la velocità di download sia quella di caricamento del modello. Ne parleremo meglio nella sezione di troubleshooting alla fine.
%cd ..3. Clona l’ultima versione del repository llama.cpp.
!git clone https://github.com/ggml-org/llama.cpp
4. Imposta le opzioni di build. Stiamo eseguendo la build per una macchina GPU. Se vuoi usare l’inferenza su CPU, cambia DGGML_CUDA=ON in DGGML_CUDA=OFF.
!cmake llama.cpp -B llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DLLAMA_CURL=ON \
  -DCMAKE_CUDA_ARCHITECTURES="80;90" \
  -DCMAKE_CUDA_FLAGS="-Wno-deprecated-gpu-targets"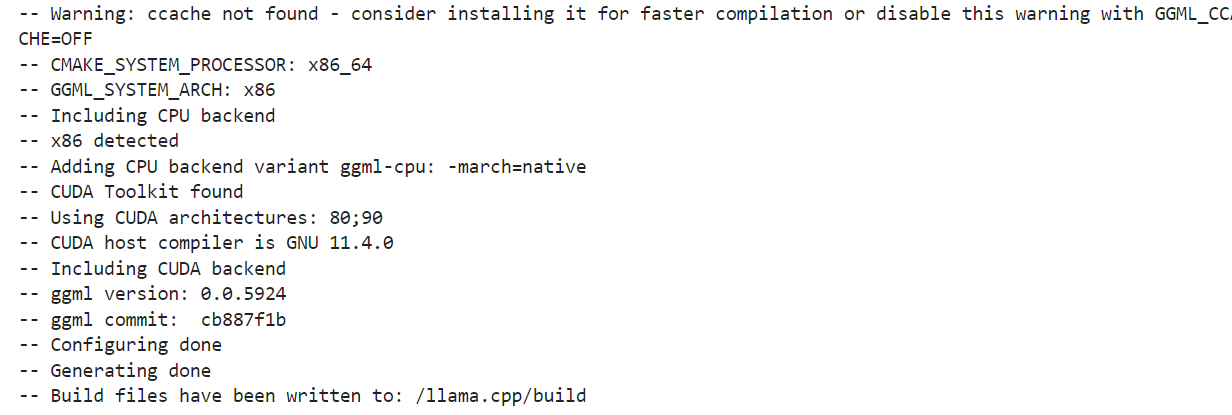
5. Useremo il comando cmake per compilare gli strumenti: llama-quantize, llama-cli, llama-gguf-split e llama-mtmd-cli.
!cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli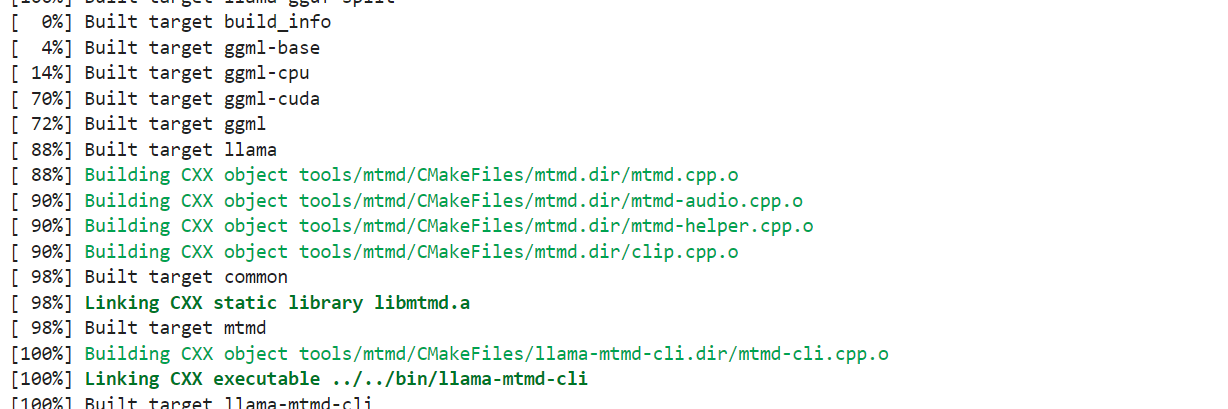
6. Copia tutti gli strumenti di build nel repository principale, così da poterli raggiungere facilmente.
!cp llama.cpp/build/bin/llama-* llama.cppLe versioni quantizzate del modello Kimi K2 di Unsloth supportano xnet, che consente download e upload 4 volte più veloci rispetto a Git LFS. Per attivarlo in locale, installa l’ultima versione di huggingface_hub e hf_transfer:
!pip install huggingface_hub hf_transfer
Usa le API di snapshot_download per scaricare solo i file del modello GGUF quantizzato a 1 bit per il repository:
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0"

from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Kimi-K2-Instruct-GGUF",
    local_dir = "/unsloth/Kimi-K2-Instruct-GGUF",
    allow_patterns = ["*UD-TQ1_0*"],
)
Il download richiederà un po’ di tempo, a seconda della velocità di internet e dello storage.
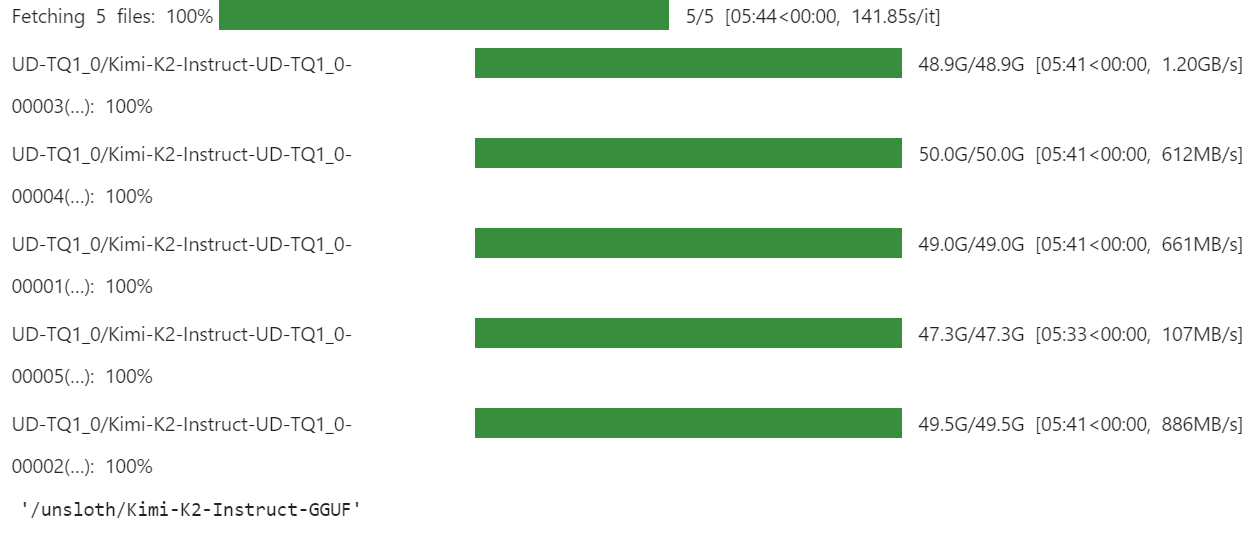
Per noi è stato velocissimo perché abbiamo soluzioni di storage più rapide con xnet attivato.
È il momento di testare la nostra versione quantizzata del modello. È qui che ho passato la maggior parte del tempo a fare debug, perché sto cercando di eseguirlo su una singola GPU. Non è impossibile, ma comporta diversi problemi legati al caricamento e all’esecuzione del modello.
Stiamo usando tutti i thread della CPU e massimizzando il caricamento dei layer sulla GPU, il che comporta l’offload su CPU sia delle up che delle down projection dei layer della Mixture of Experts.
Ecco il comando che stiamo eseguendo nel terminale, che funziona senza intoppi:
./llama.cpp/llama-cli \
  --model /unsloth/Kimi-K2-Instruct-GGUF/UD-TQ1_0/Kimi-K2-Instruct-UD-TQ1_0-00001-of-00005.gguf \
  --cache-type-k q4_0 \
  --threads -1 \
  --n-gpu-layers 99 \
  --temp 0.6 \
  --min_p 0.01 \
  --ctx-size 16384 \
  --seed 3407 \
  -ot ".ffn_(up|down)_exps.=CPU" \
  --prompt "Hey"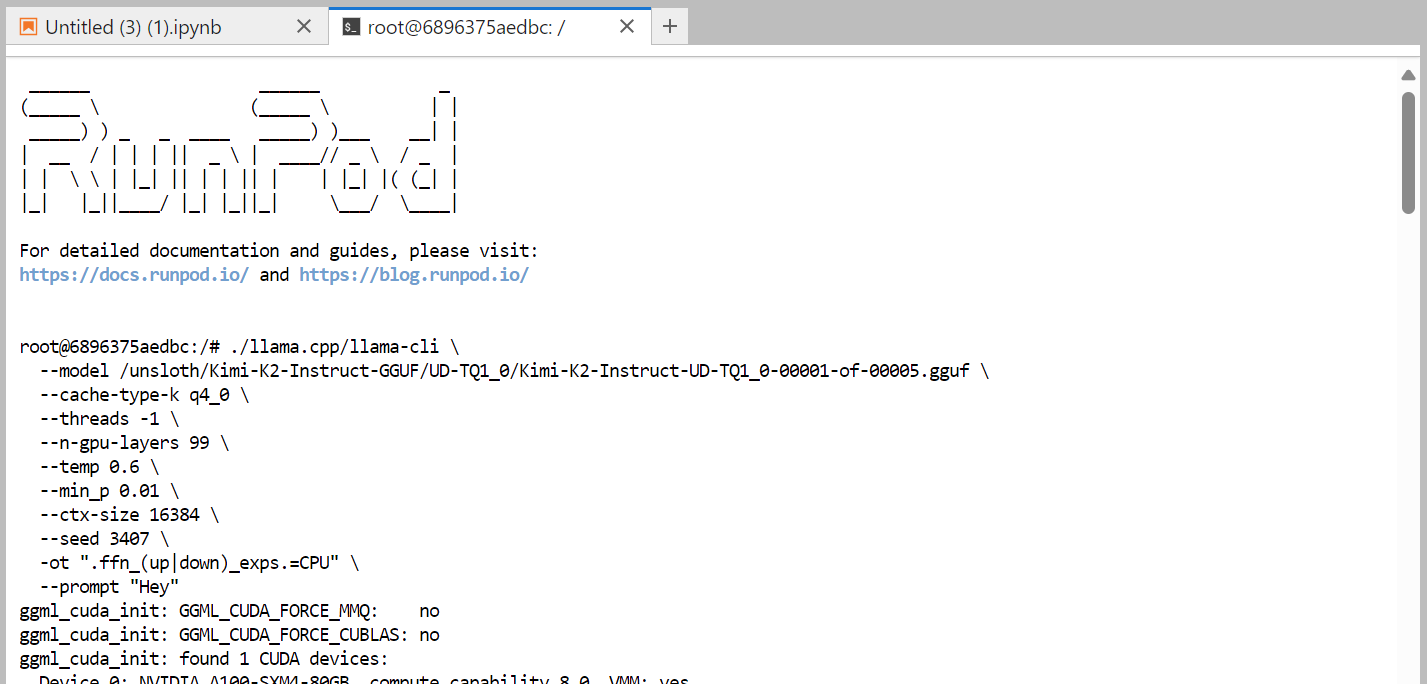
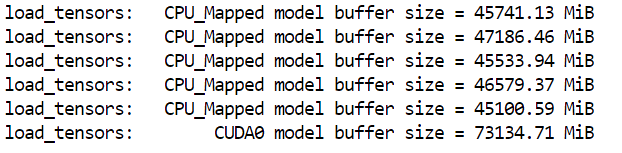
Il caricamento dell’intero modello ha richiesto quasi un minuto. Come possiamo vedere, il modello entra perfettamente nella macchina.
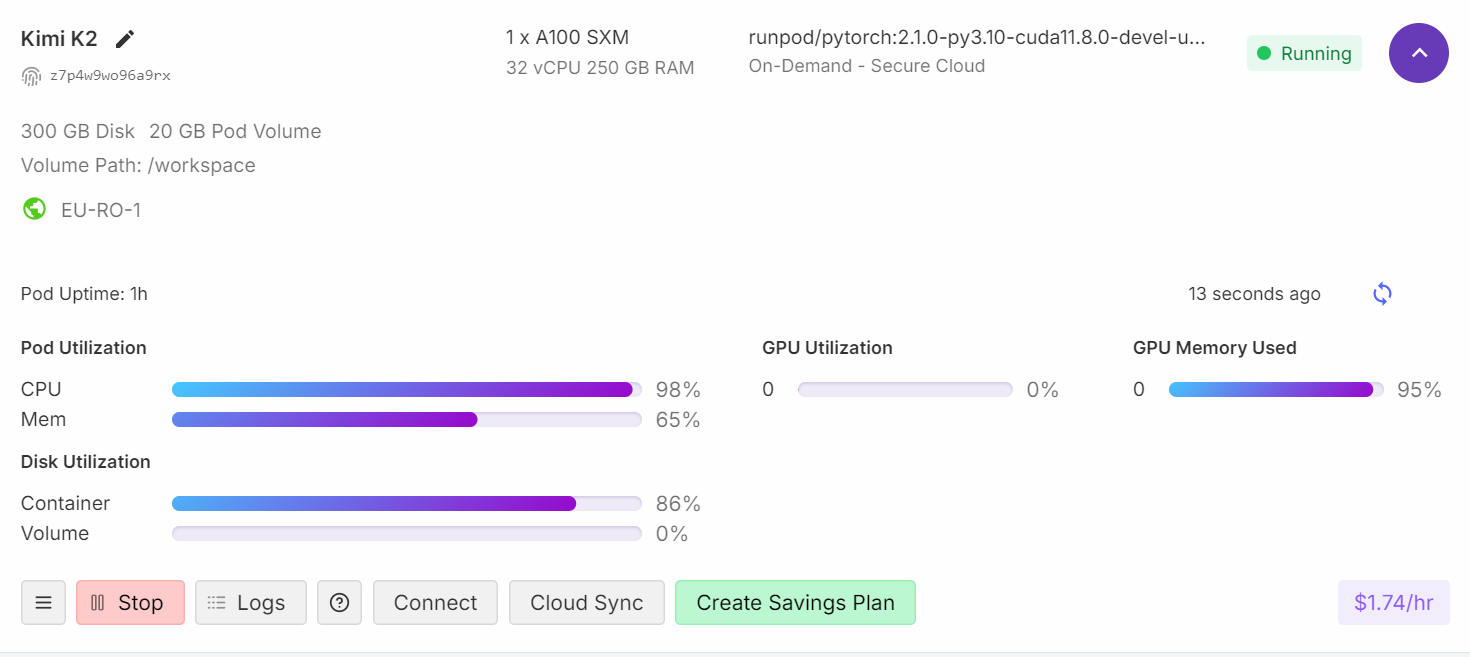
Se controlli la dashboard di Runpod, vedrai che l’uso della CPU è alto e sia la RAM sia la VRAM vengono utilizzate.
Dopo circa quattro minuti di caricamento e riscaldamento, sei pronto per fare domande al modello.
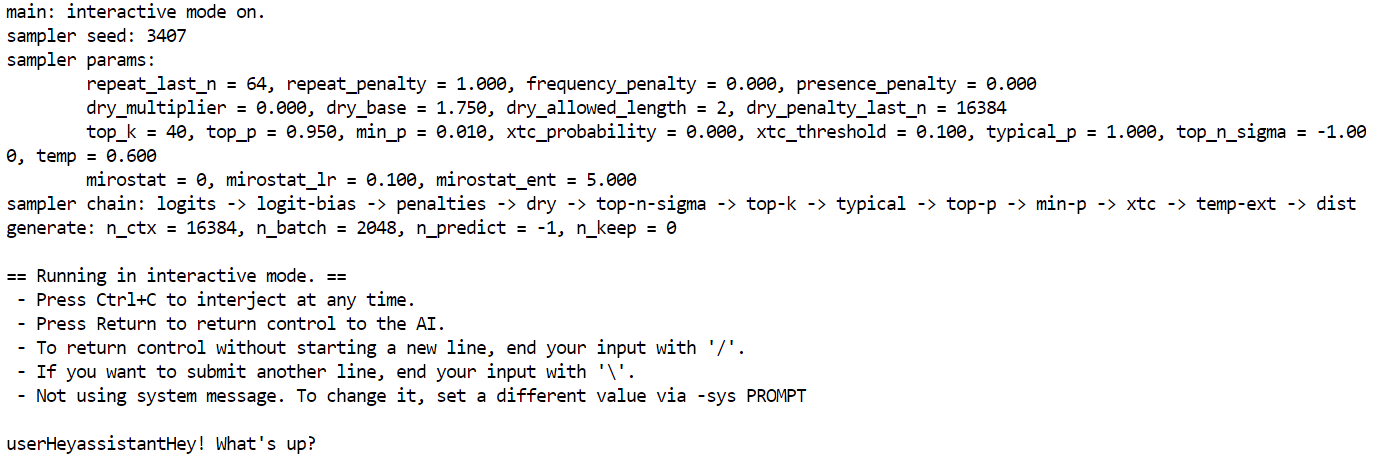
Ho fatto una domanda semplice: "Che cos’è il monsone? Scrivi la risposta in una riga."
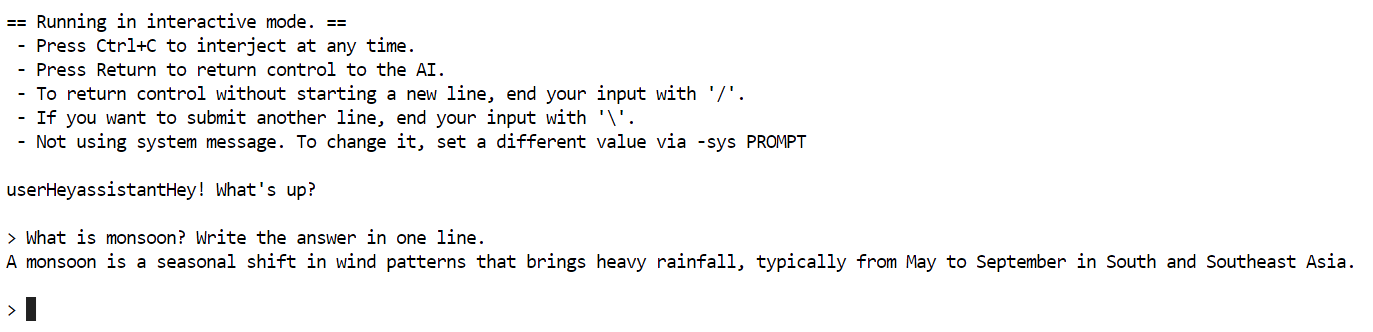
La generazione ha richiesto quasi cinque minuti.
Ho indagato sul motivo della lentezza nella generazione dei token e si scopre che la GPU viene usata solo come memoria mentre tutta l’elaborazione è eseguita dalla CPU. Per risolvere, devi offloadare più layer sulla GPU, il che significa che ti serviranno 2 macchine A100.
In questa sezione, parleremo dei problemi comuni riscontrati quando si esegue un modello grande su una singola GPU e di come superarli.
Quando vedi 95% di utilizzo della RAM GPU, 0% di compute GPU e 99% di carico CPU, in genere significa che la VRAM sta fungendo da memoria per il modello, mentre l’elaborazione reale avviene sulla CPU.
Anche i modelli molto quantizzati e più piccoli a 1 bit devono comunque essere caricati in memoria, il che contribuisce all’uso della VRAM. L’utilizzo della GPU per il calcolo inizierà solo se offloaderai più layer sulla VRAM.
Per migliorare la velocità di generazione dei token, devi offloadare più layer del modello sulla GPU. Valuta magari una configurazione multi-GPU, come tre GPU A100. Imposta la temperatura a 0,6 per ridurre ripetizioni e incoerenze nel testo generato.
Se hai VRAM o RAM limitata, puoi comunque eseguire modelli a 1 bit su una CPU consumer. Tuttavia, la generazione dei token sarà molto lenta (ad esempio, 1 token ogni 20 secondi).
L’unico requisito rigoroso per eseguire modelli a 1 bit è che lo spazio su disco + RAM + VRAM totale sia maggiore o uguale a 250 GB.
Per prestazioni ottimali (5+ token/secondo), avrai bisogno di almeno 250 GB di memoria unificata o di 250 GB combinati tra RAM e VRAM.
Installa l’ultima versione di huggingface_hub e hf_transfer per accedere alla "xnet speed", 4 volte più veloce del semplice Git LFS.
Per ottimizzare l’archiviazione e il caricamento dei file GGUF shardati, è consigliabile usare un container disk per lo storage anziché un container volume. I container volume possono infatti causare download e caricamenti del modello lenti.
Un caricamento lento del modello indica spesso che stai caricando un modello molto grande. Caricare modelli da storage di rete può rallentare notevolmente il processo. Usa sempre un SSD M.2 locale per archiviare i modelli. Gli SSD M.2 offrono velocità di lettura/scrittura molto più elevate rispetto ai dischi rigidi tradizionali o allo storage di rete, riducendo drasticamente i tempi di caricamento.
Se non c’è RAM sufficiente per caricare il modello, il sistema operativo potrebbe iniziare a fare swapping su disco (usando un file di swap), molto più lento della RAM e causa di colli di bottiglia. Prova a usare una configurazione multi-GPU con più RAM.
L’esecuzione di versioni quantizzate di Kimi K2 può ancora presentare sfide, poiché strumenti come llama.cpp sono in continua evoluzione per stare al passo con gli ultimi aggiornamenti del modello. Nelle prossime settimane, aspettati soluzioni migliorate che sposteranno i calcoli di generazione dei token sulle GPU per prestazioni migliori, invece di affidarsi esclusivamente alle CPU.
Inoltre, per me è stata un’esperienza di apprendimento preziosa. Ho acquisito una migliore comprensione di come la community open source collabori per ottimizzare e distribuire questi modelli nel modo più efficiente possibile.
Kimi K2 si distingue come uno dei migliori modelli open source, avvicinandosi alle capacità di modelli come DeepSeek R1, con prestazioni all’avanguardia in conoscenze di frontiera, matematica e coding tra i modelli non “thinking”.
È particolarmente forte nella selezione degli strumenti e nelle attività agentiche, rendendolo un’alternativa conveniente a modelli premium come Claude 4 Sonnet per progetti di coding o vibe coding.
Puoi esporre la versione quantizzata di Kimi K2 per le tue soluzioni interne seguendo questa guida. Llama.cpp ti permette di servire i modelli linguistici come un’API compatibile con OpenAI. Per continuare a imparare, dai un’occhiata alla nostra guida a Kimi K2 con esempi. Se ti interessa l’AI agentica, non perderti il nostro nuovo corso su come creare sistemi multi-agent con LangGraph.
I migliori corsi di AI
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



