
कोर्स
Google ADK के साथ AI एजेंट बनाना
1 घंटा
7.6K
Moonshot AI द्वारा विकसित Kimi K2 एक अत्याधुनिक Mixture-of-Experts (MoE) भाषा मॉडल है। यह फ्रंटियर नॉलेज, तर्क-वितर्क और कोडिंग कार्यों में उत्कृष्ट है, और विशेष रूप से एजेंटिक क्षमताओं—टूल उपयोग और स्वायत्त समस्या-समाधान—के लिए अनुकूलित है।
जैसा कि हम अपने Kimi K2 गाइड में देखते हैं, यह मॉडल बेहतरीन बेंचमार्क हासिल कर रहा है, जिससे यह सर्वश्रेष्ठ जनरल-पर्पज़ ओपन-सोर्स भाषा मॉडल बनता है। हम Deepseek R1 का क्षण देख रहे हैं, और इसे सेलिब्रेट करने के लिए मैं आपको सिखाऊँगा कि इस विशाल 1-टेराबाइट मॉडल को एक ही GPU पर कैसे चलाया जाए।
हम Runpod मशीन सेट करना, llama.cpp इंस्टॉल करना, और मॉडल को तेज़ी से डाउनलोड करना सीखेंगे। साथ ही, हम llama.cpp CLI से मॉडल चलाएँगे और मॉडल लेयर्स को RAM में ऑफलोड करेंगे। अंततः, हम इन मॉडलों को चलाते समय आने वाली आम समस्याओं का समाधान करेंगे। आप हमारे नए Agent Swarm के साथ Kimi K2.5 के गाइड को भी देख सकते हैं।
Runpod GPU Cloud पर जाएँ और Python Container Image संस्करण 2.8.0 का उपयोग करते हुए A100 SXM मशीन के साथ एक क्लाउड बनाएँ।
इसके बाद, Edit pod विकल्प का उपयोग करके कंटेनर डिस्क स्टोरेज को 300 GB तक बढ़ाएँ।
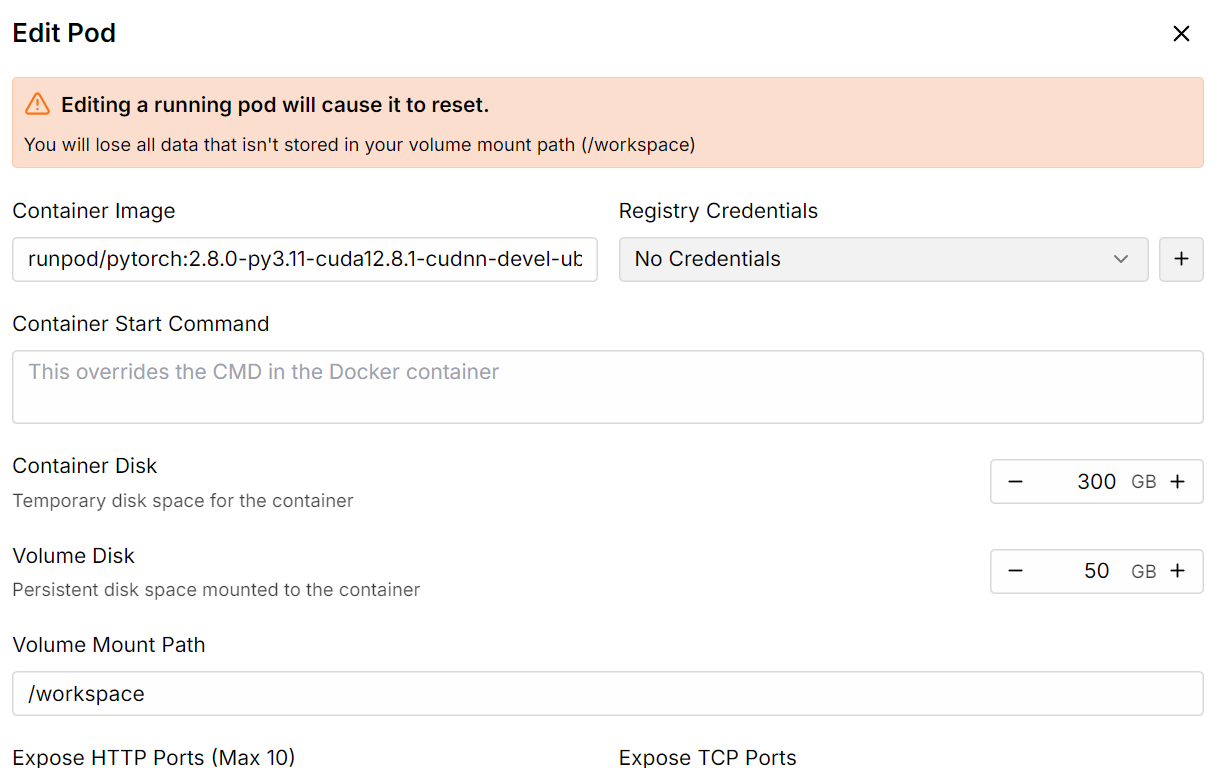
सब सेट होने के बाद, आप देखेंगे कि आपके पास 300 GB स्टोरेज है, जो पर्याप्त है क्योंकि हमारा 1-बिट क्वांटाइज़्ड मॉडल 250 GB स्टोरेज लेता है।
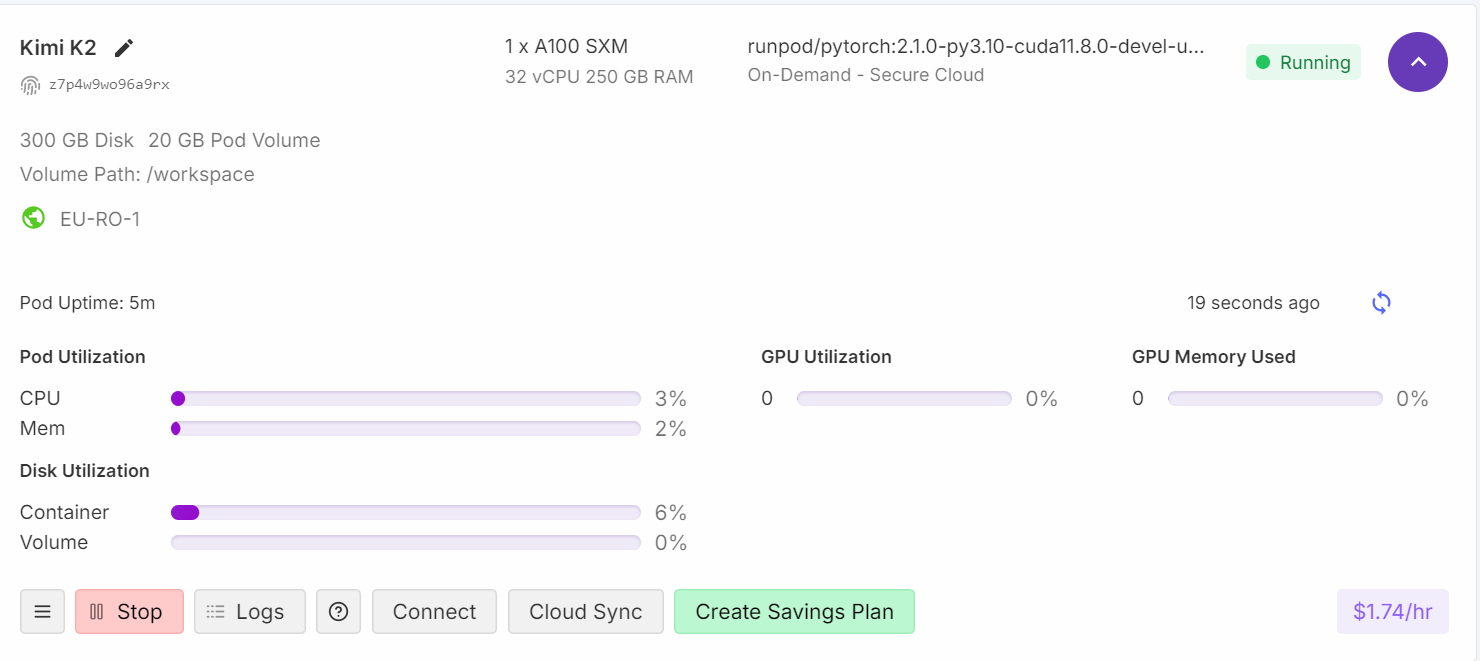
1. Connect बटन पर क्लिक करें और Jupyter Lab इंस्टेंस लॉन्च करें। एक नया नोटबुक बनाएँ और ज़रूरी Linux टूल्स, जैसे cmake और curl इंस्टॉल करें।
!apt-get update
!apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
2. डायरेक्टरी को रूट पर बदलें। हम workspace डायरेक्टरी का उपयोग नहीं करेंगे। इसका कारण मॉडल की डाउनलोडिंग और लोडिंग दोनों की गति बढ़ाना है। इसके बारे में आप अंत में ट्रबलशूटिंग सेक्शन में और जानेंगे।
%cd ..3. llama.cpp रिपॉज़िटरी का नवीनतम संस्करण क्लोन करें।
!git clone https://github.com/ggml-org/llama.cpp
4. बिल्ड विकल्प सेट करें। हम GPU मशीन के लिए बिल्ड चला रहे हैं। यदि आप CPU इन्फरेंस उपयोग करना चाहते हैं, तो DGGML_CUDA=ON को DGGML_CUDA=OFF में बदल दें।
!cmake llama.cpp -B llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DLLAMA_CURL=ON \
  -DCMAKE_CUDA_ARCHITECTURES="80;90" \
  -DCMAKE_CUDA_FLAGS="-Wno-deprecated-gpu-targets"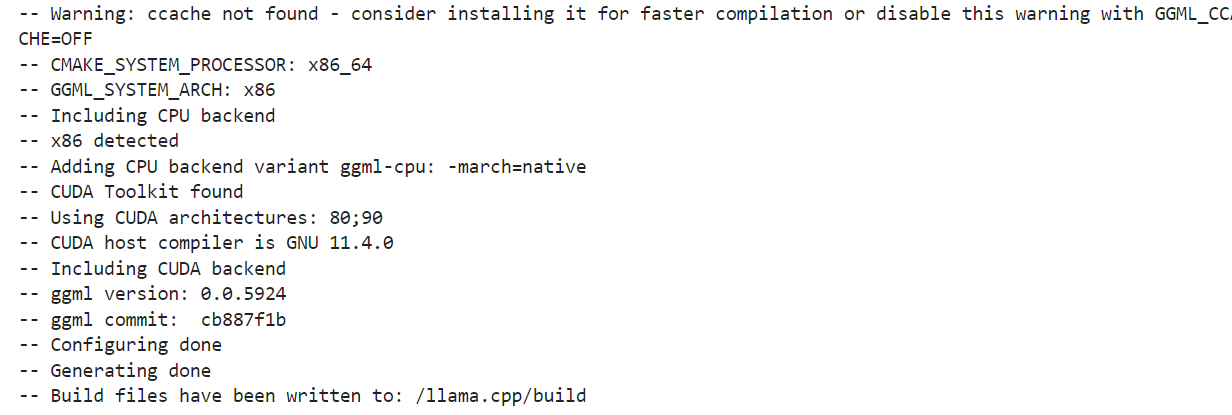
5. हम cmake कमांड का उपयोग करके टूल्स बनाएँगे: llama-quantize, llama-cli, llama-gguf-split, और llama-mtmd-cli।
!cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli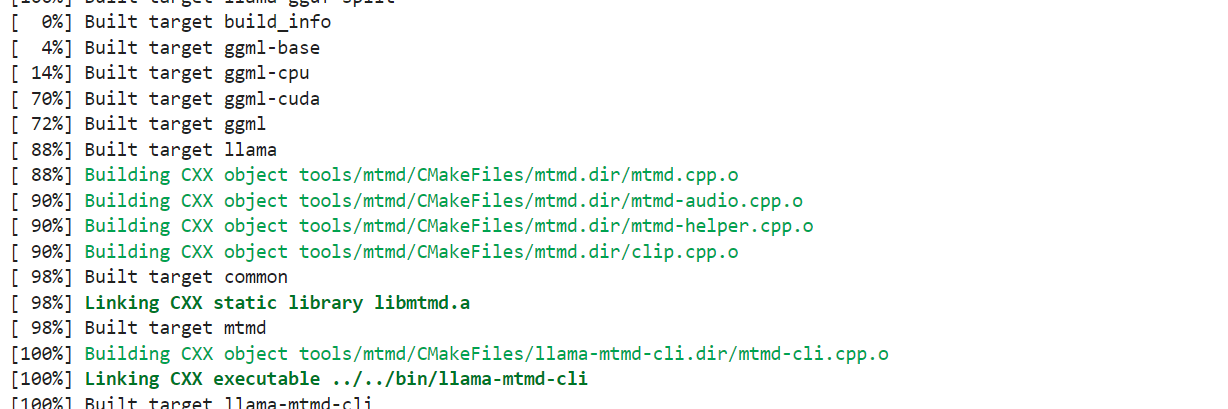
6. सभी बिल्ड टूल्स को मुख्य रिपॉज़िटरी में कॉपी करें ताकि हम उन्हें आसानी से एक्सेस कर सकें।
!cp llama.cpp/build/bin/llama-* llama.cppUnsloth द्वारा Kimi K2 मॉडल के क्वांटाइज़्ड संस्करण xnet का समर्थन करते हैं, जो Git LFS की तुलना में 4 गुना तेज़ डाउनलोड और अपलोड की अनुमति देता है। इसे लोकली सक्रिय करने के लिए, कृपया huggingface_hub और hf_transfer के नवीनतम संस्करण इंस्टॉल करें:
!pip install huggingface_hub hf_transfer
रिपॉज़िटरी के केवल 1-बिट क्वांटाइज़्ड GGUF मॉडल फ़ाइलें डाउनलोड करने के लिए snapshot_download API का उपयोग करें:
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0"

from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Kimi-K2-Instruct-GGUF",
    local_dir = "/unsloth/Kimi-K2-Instruct-GGUF",
    allow_patterns = ["*UD-TQ1_0*"],
)
इंटरनेट और स्टोरेज की गति के अनुसार डाउनलोड में समय लग सकता है।
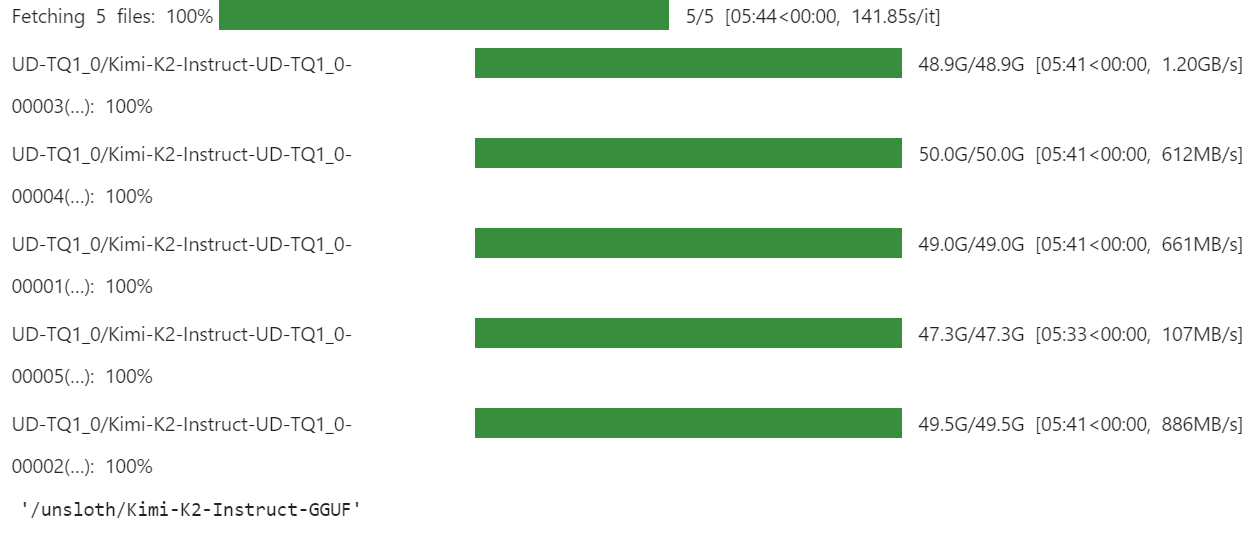
हमारे लिए यह बहुत तेज़ था क्योंकि xnet सक्षम होने के साथ हमारे पास तेज़ स्टोरेज समाधान हैं।
अब हमारे क्वांटाइज़्ड संस्करण का परीक्षण करने का समय है। यहीं पर मैंने सबसे अधिक समय डिबगिंग में लगाया, क्योंकि मैं इसे एक ही GPU पर चलाने की कोशिश कर रहा था। यह असंभव नहीं है, लेकिन इसमें मॉडल लोडिंग और निष्पादन से जुड़ी कई समस्याएँ आती हैं।
हम सभी CPU थ्रेड्स का उपयोग कर रहे हैं और लेयर लोडिंग को GPU पर अधिकतम कर रहे हैं, जिसमें up और down projection Mixture of Experts लेयर्स का CPU ऑफलोडिंग शामिल है।
यहाँ वह कमांड है जिसे हम टर्मिनल में चला रहे हैं, जो बिना रुकावट काम करता है:
./llama.cpp/llama-cli \
  --model /unsloth/Kimi-K2-Instruct-GGUF/UD-TQ1_0/Kimi-K2-Instruct-UD-TQ1_0-00001-of-00005.gguf \
  --cache-type-k q4_0 \
  --threads -1 \
  --n-gpu-layers 99 \
  --temp 0.6 \
  --min_p 0.01 \
  --ctx-size 16384 \
  --seed 3407 \
  -ot ".ffn_(up|down)_exps.=CPU" \
  --prompt "Hey"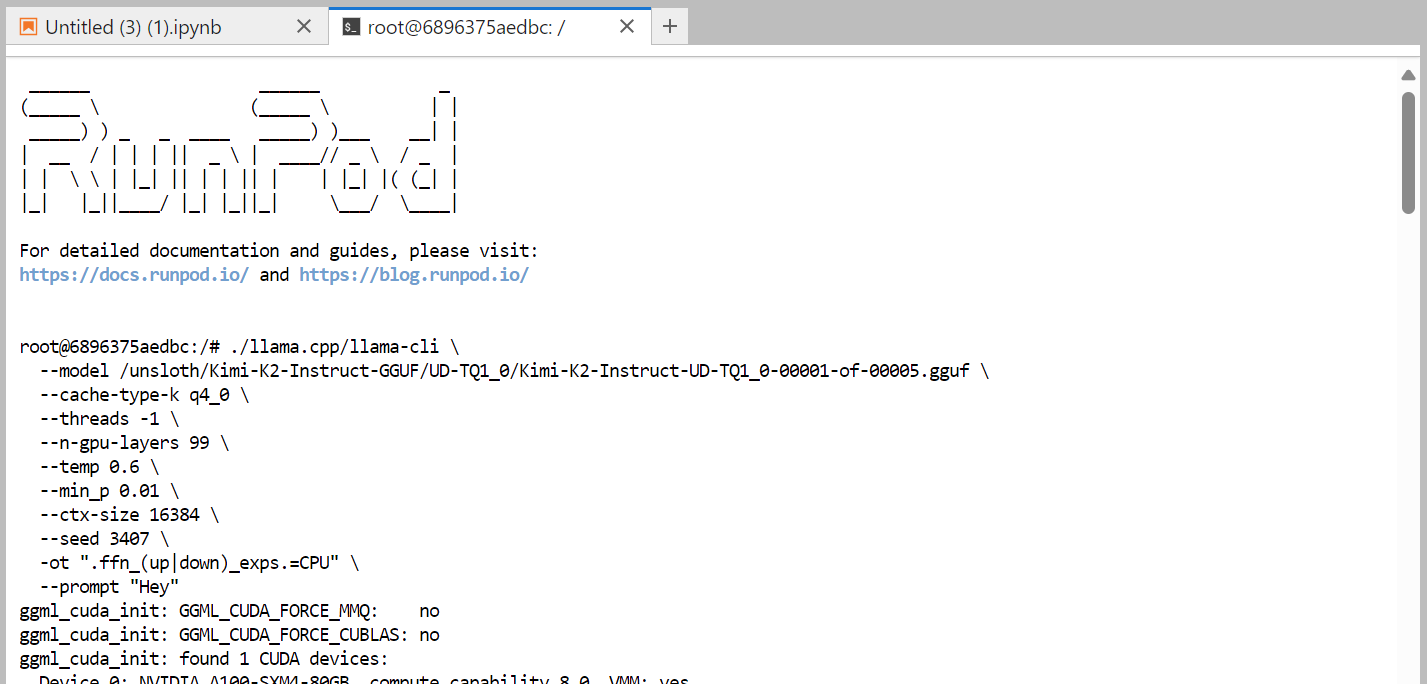
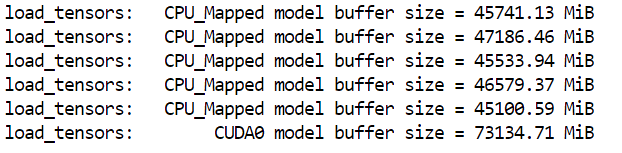
पूरे मॉडल को लोड होने में लगभग एक मिनट लगा। जैसा कि हम देख सकते हैं, मॉडल मशीन में पूरी तरह फिट बैठता है।
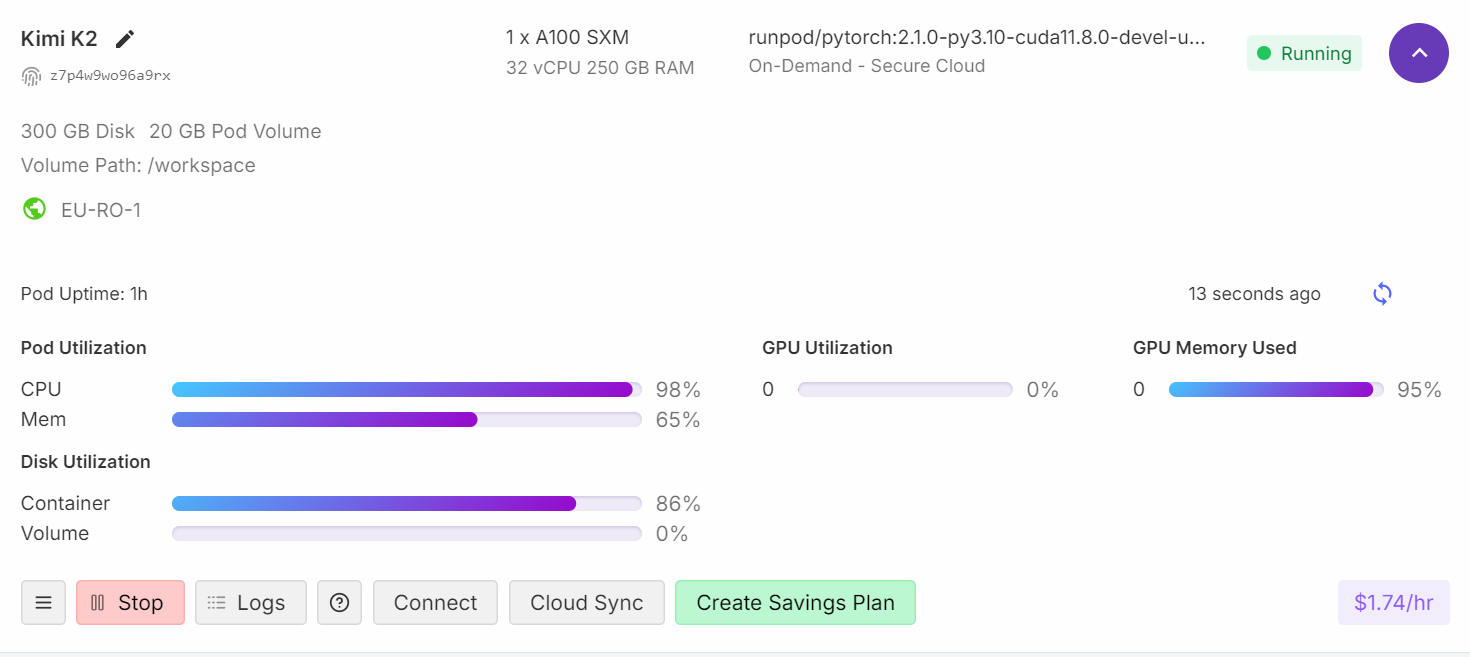
यदि आप अपना Runpod डैशबोर्ड जाँचते हैं, तो आप देखेंगे कि आपका CPU उपयोग उच्च है, और RAM तथा VRAM दोनों मेमोरी उपयोग में हैं।
लगभग चार मिनट लोडिंग और वॉर्म-अप के बाद, आप मॉडल से प्रश्न पूछने के लिए तैयार हैं।
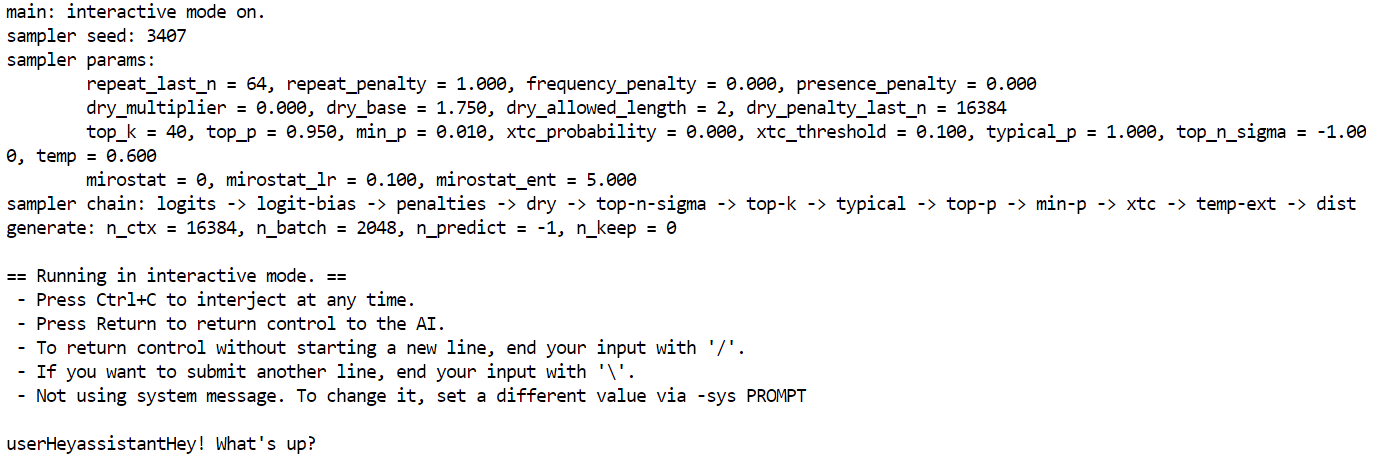
मैंने एक सरल प्रश्न पूछा: "मानसून क्या है? उत्तर एक पंक्ति में लिखें।"
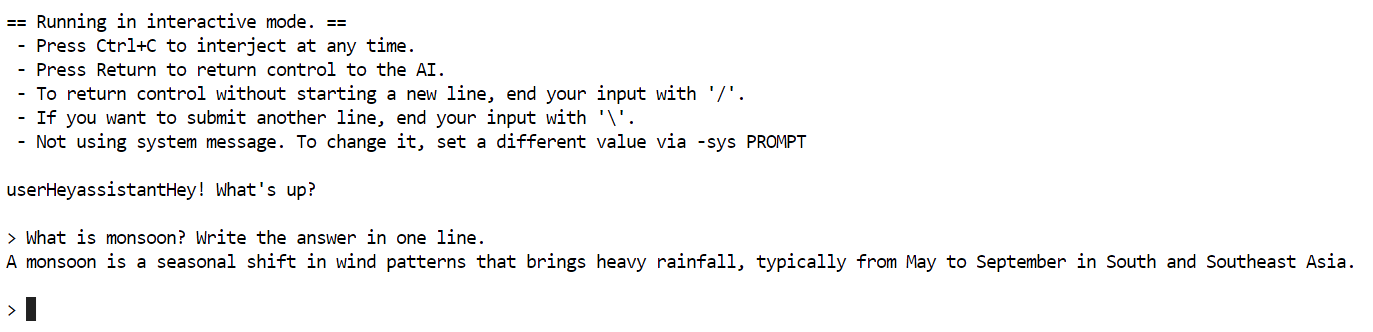
जेनरेशन पूरी होने में लगभग पाँच मिनट लगे।
मैंने यह समझने के लिए शोध किया कि टोकन जेनरेशन धीमा क्यों है, और पता चला कि GPU का उपयोग केवल मेमोरी के रूप में हो रहा है जबकि सारा प्रोसेसिंग CPU पर हो रही है। इस समस्या का समाधान करने के लिए, आपको और अधिक लेयर्स को GPU पर ऑफलोड करने की आवश्यकता है, जिसका अर्थ है कि आपको 2 A100 मशीनों की आवश्यकता होगी।
इस सेक्शन में, हम एक बड़े मॉडल को एक ही GPU पर चलाने के दौरान आने वाली आम समस्याओं और उन्हें दूर करने के तरीकों पर चर्चा करेंगे।
जब आप 95% GPU RAM उपयोग, 0% GPU compute और 99% CPU लोड देखते हैं, तो आमतौर पर इसका मतलब है कि VRAM मॉडल के लिए मेमोरी स्टोरेज की तरह काम कर रही है, जबकि असली प्रोसेसिंग CPU पर हो रही है।
काफी क्वांटाइज़्ड और छोटे 1-बिट मॉडल भी मेमोरी में लोड होने की ज़रूरत रखते हैं, जो VRAM उपयोग में योगदान देता है। GPU का कंप्यूट उपयोग तभी शुरू होगा जब आप और अधिक लेयर्स को VRAM पर ऑफलोड करेंगे।
टोकन जेनरेशन की गति बढ़ाने के लिए, आपको मॉडल की अधिक लेयर्स को GPU पर ऑफलोड करना होगा। संभव हो तो मल्टी-GPU सेटअप, जैसे तीन A100 GPUs, पर विचार करें। जेनरेटेड टेक्स्ट में दोहराव और असंगति कम करने के लिए temperature को 0.6 पर रखें।
यदि आपके पास सीमित VRAM या RAM है, तो भी आप 1-बिट मॉडल को कंज़्यूमर CPU पर चला सकते हैं। हालाँकि, टोकन जेनरेशन बहुत धीमा होगा (जैसे, 20 सेकंड में 1 टोकन)।
1-बिट मॉडल चलाने के लिए केवल सख्त आवश्यकता यह है कि आपका कुल disk space + RAM + VRAM 250GB से अधिक या बराबर हो।
उत्तम प्रदर्शन (5+ टोकन/सेकंड) के लिए, आपको कम से कम 250GB यूनिफाइड मेमोरी या RAM और VRAM मिलाकर 250GB चाहिए।
"xnet स्पीड" एक्सेस करने के लिए huggingface_hub और hf_transfer का नवीनतम संस्करण इंस्टॉल करें, जो साधारण Git LFS से 4 गुना तेज़ है।
GGUF शार्डेड फ़ाइलों के स्टोरेज और लोडिंग को अनुकूलित करने के लिए, स्टोरेज के लिए कंटेनर volume के बजाय कंटेनर disk का उपयोग करने की सिफारिश की जाती है। ऐसा इसलिए क्योंकि कंटेनर volumes धीमे डाउनलोड और मॉडल लोडिंग का कारण बन सकते हैं।
धीमी मॉडल लोडिंग अक्सर यह संकेत देती है कि आप बहुत बड़े मॉडल को लोड कर रहे हैं। नेटवर्क स्टोरेज से मॉडल लोड करना प्रक्रिया को काफ़ी धीमा कर सकता है। हमेशा अपने मॉडल को लोकल M.2 SSD पर स्टोर करें। M.2 SSD पारंपरिक हार्ड ड्राइव या नेटवर्क स्टोरेज की तुलना में कहीं तेज़ पढ़ने/लिखने की गति देता है, जिससे लोडिंग समय में भारी कमी आती है।
यदि मॉडल को लोड करने के लिए पर्याप्त RAM नहीं है, तो ऑपरेटिंग सिस्टम डेटा को डिस्क पर स्वैप करना शुरू कर सकता है (swap file का उपयोग करते हुए), जो RAM से बहुत धीमा है और बॉटलनेक बनाता है। अधिक RAM के साथ मल्टी-GPU सेटअप रखने की कोशिश करें।
Kimi K2 के क्वांटाइज़्ड संस्करण चलाने में अभी भी चुनौतियाँ आ सकती हैं, क्योंकि llama.cpp जैसे टूल मॉडल के नवीनतम अपडेट की रफ़्तार के साथ तालमेल बिठाने के लिए सक्रिय रूप से विकसित हो रहे हैं। आने वाले हफ्तों में, ऐसे बेहतर समाधान की उम्मीद करें जो टोकन जेनरेशन की गणनाएँ CPU पर निर्भर रहने के बजाय GPU पर शिफ्ट करें और प्रदर्शन सुधारें।
इसके अलावा, यह मेरे लिए एक मूल्यवान सीखने का अनुभव रहा है। मैंने समझा कि ओपन-सोर्स समुदाय इन मॉडलों को यथासंभव कुशलता से ऑप्टिमाइज़ और डिप्लॉय करने के लिए कैसे मिलकर काम करता है।
Kimi K2 शीर्ष ओपन-सोर्स मॉडलों में से एक है, जो DeepSeek R1 जैसे मॉडलों की क्षमताओं के क़रीब पहुँच रहा है, और फ्रंटियर नॉलेज, गणित और कोडिंग में नॉन-थिंकिंग मॉडलों के बीच अत्याधुनिक प्रदर्शन देता है।
यह टूल चयन और एजेंटिक कार्यों में विशेष रूप से मज़बूत है, जिससे यह Claude 4 Sonnet जैसे प्रीमियम मॉडलों का एक किफायती विकल्प बनता है—कोडिंग प्रोजेक्ट्स या vibe coding के लिए।
आप इस गाइड का उपयोग करके Kimi K2 के क्वांटाइज़्ड संस्करण को अपनी इन-हाउस सॉल्यूशंस के लिए सर्व कर सकते हैं। Llama.cpp आपको OpenAI संगतता के साथ भाषा मॉडलों को API के रूप में सर्व करने देता है। और सीखते रहने के लिए, हमारा उदाहरणों सहित Kimi K2 गाइड ज़रूर देखें। यदि आप एजेंटिक AI के बारे में सीखने के इच्छुक हैं, तो हमारे नए कोर्स LangGraph के साथ मल्टी-एजेंट सिस्टम बनाना को अवश्य देखें।
शीर्ष AI पाठ्यक्रम
कोर्स
कोर्स
कोर्स