
Kursus
Membangun Agen AI dengan Google ADK
1 jam
7.6K
Kimi K2, dikembangkan oleh Moonshot AI, adalah model bahasa Mixture-of-Experts (MoE) mutakhir. Model ini unggul dalam pengetahuan frontier, penalaran, dan tugas pengkodean, serta dioptimalkan khusus untuk kapabilitas agentik, termasuk penggunaan alat dan pemecahan masalah otonom.
Seperti yang kami bahas dalam panduan Kimi K2 kami, model ini meraih hasil tolok ukur yang luar biasa, menjadikannya model bahasa open-source serbaguna terbaik. Kita sedang menyaksikan momen Deepseek R1, dan untuk merayakannya, saya akan mengajarkan Anda cara menjalankan model raksasa berukuran 1 terabita ini pada satu GPU.
Kita akan mempelajari cara menyiapkan mesin Runpod, memasang llama.cpp, dan mengunduh model dengan kecepatan lebih tinggi. Selain itu, kita akan menjalankan model menggunakan CLI llama.cpp, dengan mengalihkan (offload) layer model ke RAM. Terakhir, kita akan membahas masalah umum yang muncul saat menjalankan model-model ini. Anda juga dapat menemukan panduan kami untuk Kimi K2.5 dengan Agent Swarm yang baru.
Buka Runpod GPU Cloud dan buat cloud dengan mesin A100 SXM menggunakan Python Container Image versi 2.8.0.
Setelah itu, tingkatkan penyimpanan disk container menjadi 300 GB dengan opsi Edit pod.
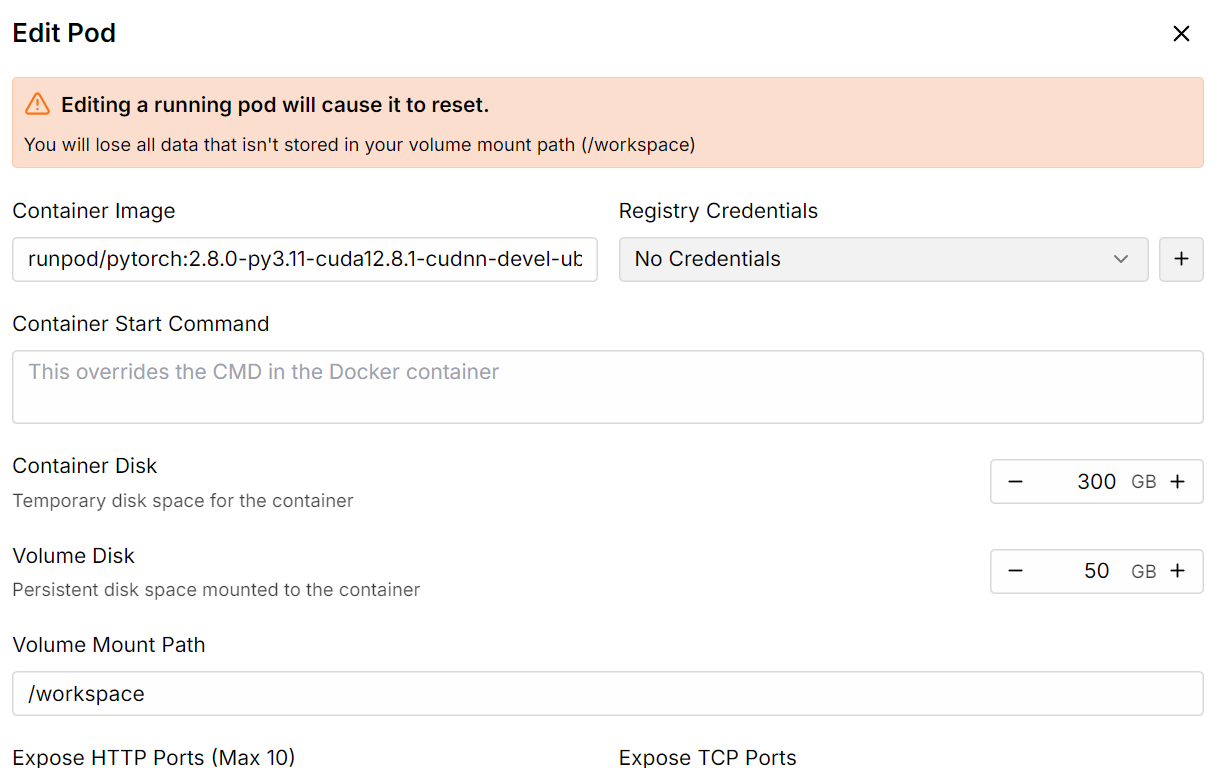
Setelah semuanya siap, Anda akan melihat bahwa Anda memiliki penyimpanan 300 GB, yang sudah cukup karena model 1-bit terkuantisasi kita membutuhkan 250 GB penyimpanan.
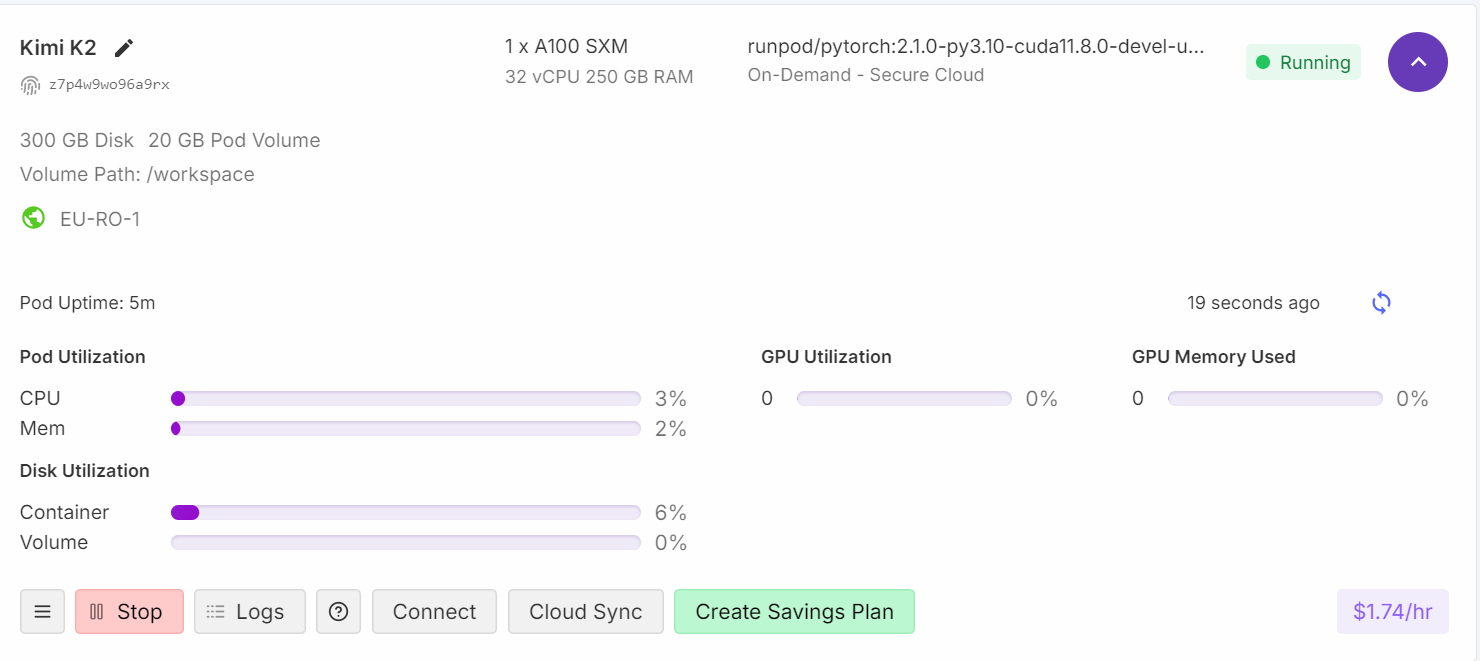
1. Klik tombol connect dan jalankan instance Jupyter Lab. Buat notebook baru dan pasang alat Linux yang diperlukan, seperti cmake dan curl.
!apt-get update
!apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
2. Ubah direktori ke root. Kita tidak akan menggunakan direktori workspace. Alasannya adalah untuk meningkatkan kecepatan pengunduhan dan pemuatan model. Anda akan mempelajarinya lebih lanjut di bagian pemecahan masalah di akhir.
%cd ..3. Clone versi terbaru repositori llama.cpp.
!git clone https://github.com/ggml-org/llama.cpp
4. Atur opsi build. Kita menjalankan build untuk mesin GPU. Jika Anda ingin menggunakan inferensi CPU, ubah DGGML_CUDA=ON menjadi DGGML_CUDA=OFF.
!cmake llama.cpp -B llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DLLAMA_CURL=ON \
  -DCMAKE_CUDA_ARCHITECTURES="80;90" \
  -DCMAKE_CUDA_FLAGS="-Wno-deprecated-gpu-targets"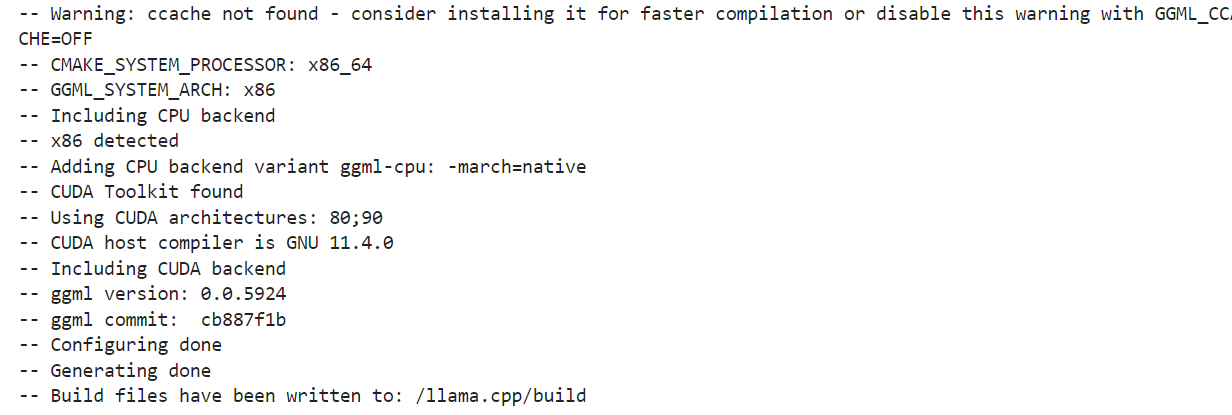
5. Kita akan menggunakan perintah cmake untuk membangun alat: llama-quantize, llama-cli, llama-gguf-split, dan llama-mtmd-cli.
!cmake --build llama.cpp/build --config Release -j --clean-first --target llama-quantize llama-cli llama-gguf-split llama-mtmd-cli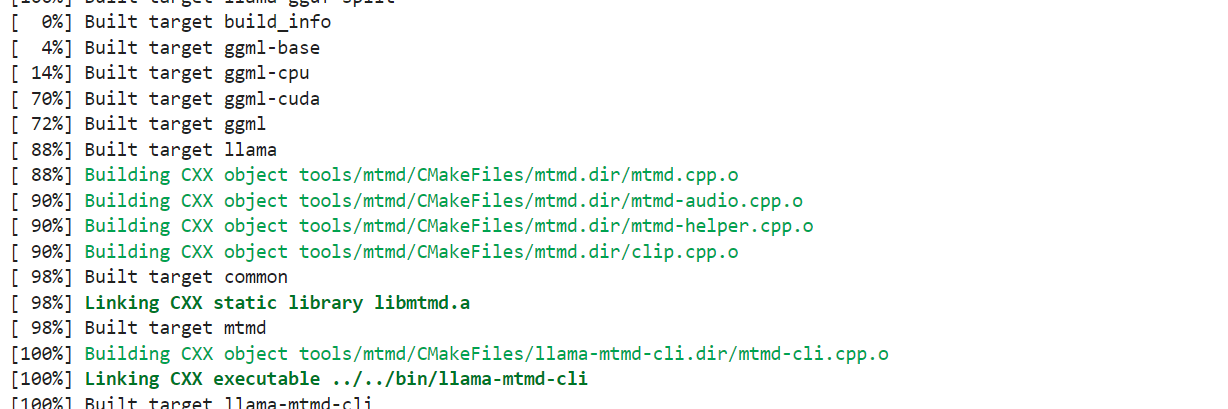
6. Salin semua alat build ke repositori utama agar kita dapat mengaksesnya dengan mudah.
!cp llama.cpp/build/bin/llama-* llama.cppVersi terkuantisasi model Kimi K2 oleh Unsloth mendukung xnet, yang memungkinkan pengunduhan dan pengunggahan 4 kali lebih cepat daripada Git LFS. Untuk mengaktifkannya secara lokal, pasang versi terbaru huggingface_hub dan hf_transfer:
!pip install huggingface_hub hf_transfer
Gunakan API snapshot_download untuk mengunduh hanya berkas model GGUF 1-bit terkuantisasi untuk repositori tersebut:
import os
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "0"

from huggingface_hub import snapshot_download
snapshot_download(
    repo_id = "unsloth/Kimi-K2-Instruct-GGUF",
    local_dir = "/unsloth/Kimi-K2-Instruct-GGUF",
    allow_patterns = ["*UD-TQ1_0*"],
)
Proses pengunduhan akan memakan waktu, tergantung kecepatan internet dan penyimpanan Anda.
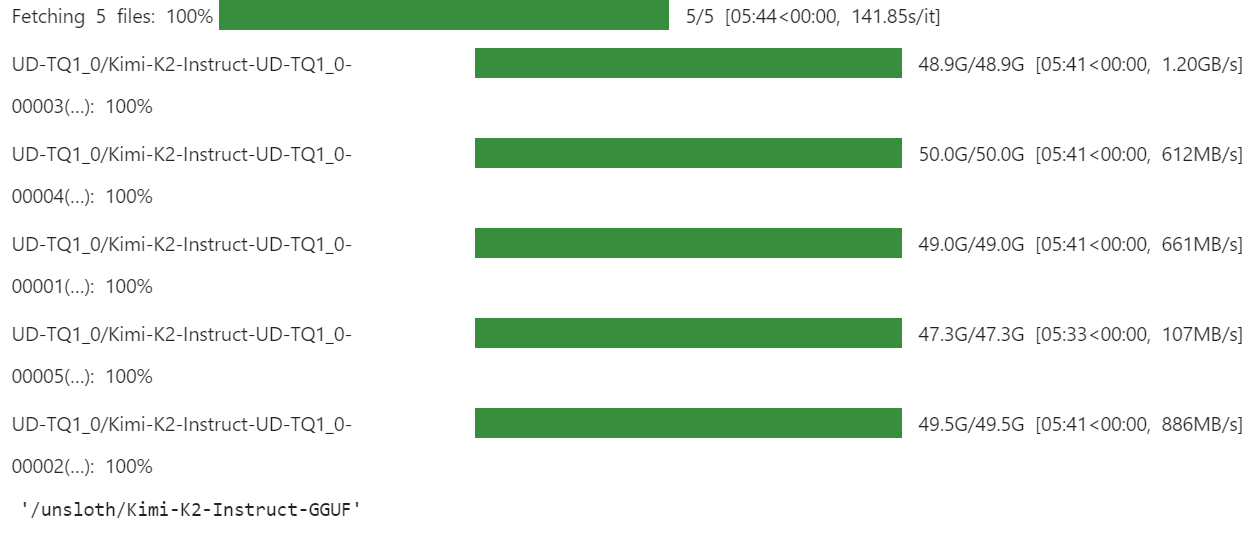
Bagi kami, prosesnya sangat cepat karena kami memiliki solusi penyimpanan yang lebih cepat dengan xnet diaktifkan.
Sekarang saatnya menguji versi model yang telah dikuantisasi. Inilah bagian yang paling banyak menyita waktu debugging saya, karena saya mencoba menjalankannya pada satu GPU. Meski bukan mustahil, ada beberapa masalah terkait pemuatan dan eksekusi model.
Kami menggunakan semua thread CPU dan memaksimalkan pemuatan layer ke GPU, yang melibatkan offload CPU untuk layer Mixture of Experts proyeksi up dan down.
Berikut perintah yang kami jalankan di terminal, yang berjalan mulus:
./llama.cpp/llama-cli \
  --model /unsloth/Kimi-K2-Instruct-GGUF/UD-TQ1_0/Kimi-K2-Instruct-UD-TQ1_0-00001-of-00005.gguf \
  --cache-type-k q4_0 \
  --threads -1 \
  --n-gpu-layers 99 \
  --temp 0.6 \
  --min_p 0.01 \
  --ctx-size 16384 \
  --seed 3407 \
  -ot ".ffn_(up|down)_exps.=CPU" \
  --prompt "Hey"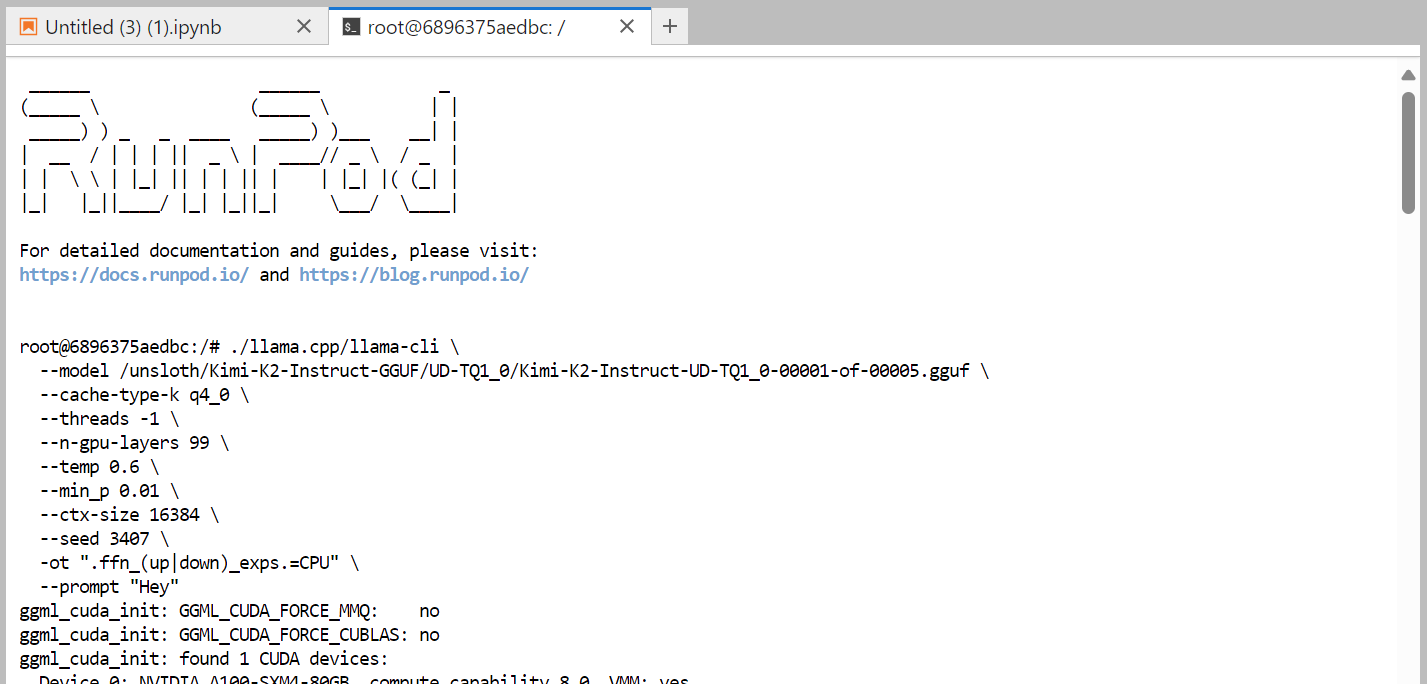
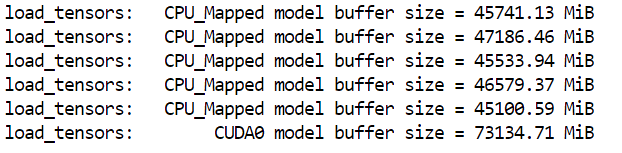
Butuh hampir satu menit untuk memuat model penuh. Seperti yang terlihat, model ini pas dengan sempurna di mesin.
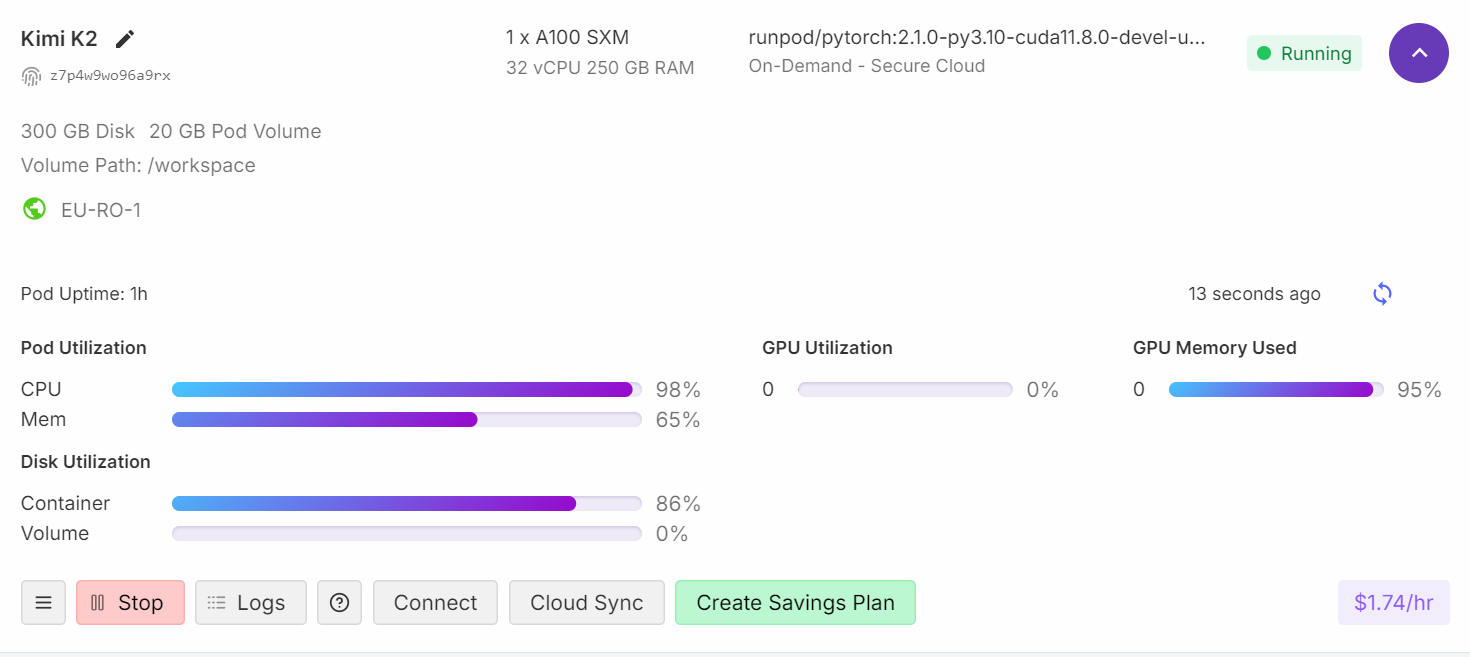
Jika Anda memeriksa dasbor Runpod, Anda akan melihat penggunaan CPU tinggi, dan memori RAM serta VRAM sama-sama digunakan.
Setelah sekitar empat menit pemuatan dan pemanasan, Anda siap mengajukan pertanyaan ke model.
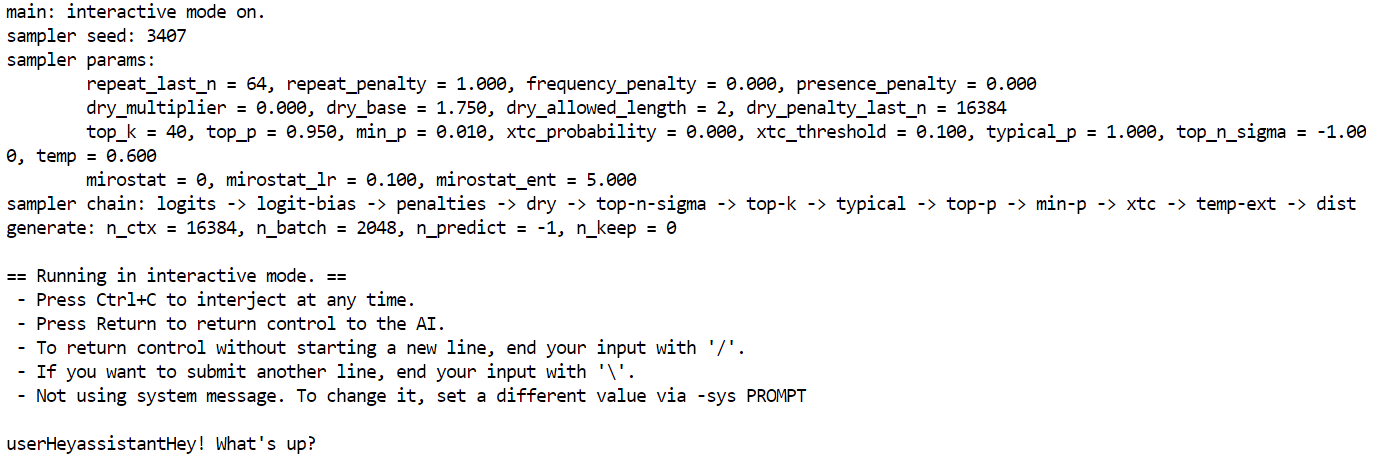
Saya menanyakan pertanyaan sederhana: "Apa itu monsun? Tulis jawabannya dalam satu baris."
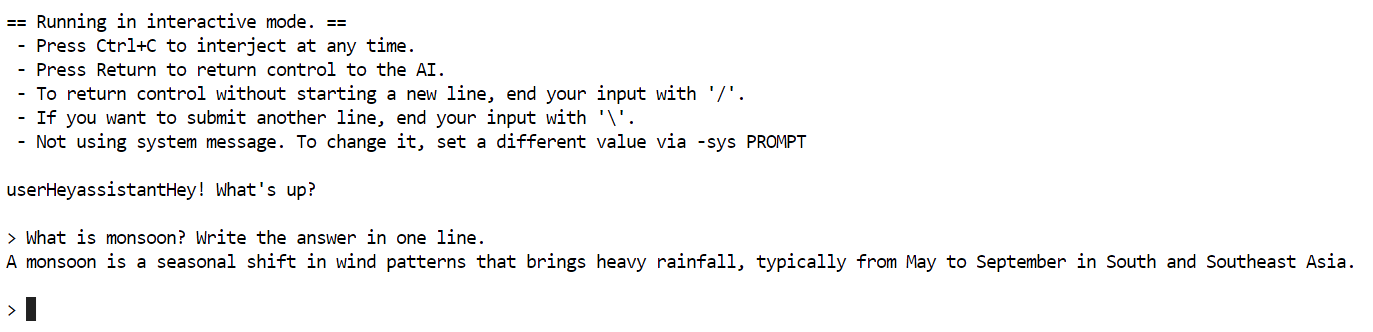
Butuh hampir lima menit untuk menyelesaikan generasi.
Saya menelusuri alasan mengapa generasi token lambat, dan ternyata GPU hanya digunakan sebagai memori sedangkan seluruh pemrosesan dilakukan oleh CPU. Untuk mengatasi masalah ini, Anda perlu mengalihkan lebih banyak layer ke GPU, yang berarti Anda akan memerlukan 2 mesin A100.
Di bagian ini, kita akan membahas masalah umum yang ditemui saat menjalankan model besar pada satu GPU dan bagaimana cara mengatasinya.
Ketika Anda melihat penggunaan RAM GPU 95%, komputasi GPU 0%, dan beban CPU 99%, biasanya berarti VRAM bertindak sebagai penyimpanan memori bagi model, sementara pemrosesan sebenarnya berlangsung di CPU.
Bahkan model 1-bit yang sangat terkuantisasi dan lebih kecil tetap perlu dimuat ke memori, yang berkontribusi pada penggunaan VRAM. Pemanfaatan GPU untuk komputasi baru akan terjadi jika Anda mengalihkan lebih banyak layer ke VRAM.
Untuk meningkatkan kecepatan generasi token, Anda perlu mengalihkan lebih banyak layer model ke GPU. Pertimbangkan juga setup multi-GPU, seperti tiga GPU A100. Atur temperature ke 0,6 untuk membantu mengurangi pengulangan dan ketidakkonsistenan pada teks yang dihasilkan.
Jika Anda memiliki VRAM atau RAM terbatas, Anda tetap dapat menjalankan model 1-bit pada CPU konsumen. Namun, generasi token akan sangat lambat (misalnya, 1 token per 20 detik).
Syarat ketat satu-satunya untuk menjalankan model 1-bit adalah total ruang disk + RAM + VRAM Anda harus lebih besar atau sama dengan 250GB.
Untuk kinerja optimal (5+ token/detik), Anda memerlukan setidaknya 250GB memori terpadu atau gabungan 250GB RAM dan VRAM.
Pasang versi terbaru huggingface_hub dan hf_transfer untuk mengakses "kecepatan xnet," yang 4x lebih cepat daripada Git LFS sederhana.
Untuk mengoptimalkan penyimpanan dan pemuatan berkas GGUF yang dipecah (sharded), disarankan menggunakan container disk untuk penyimpanan, bukan container volume. Ini karena container volume dapat menyebabkan pengunduhan dan pemuatan model menjadi lambat.
Pemuatan model yang lambat sering kali menunjukkan Anda sedang memuat model yang sangat besar. Memuat model dari penyimpanan jaringan dapat sangat memperlambat proses. Selalu gunakan SSD M.2 lokal untuk menyimpan model Anda. SSD M.2 menawarkan kecepatan baca/tulis yang jauh lebih cepat dibanding hard drive tradisional atau penyimpanan jaringan, sehingga memangkas waktu pemuatan secara drastis.
Jika RAM tidak cukup untuk memuat model, sistem operasi mungkin mulai menukar data ke disk (menggunakan berkas swap), yang jauh lebih lambat daripada RAM dan menciptakan bottleneck. Cobalah menggunakan setup multi-GPU dengan RAM lebih besar.
Menjalankan versi Kimi K2 yang dikuantisasi masih dapat menemui tantangan, karena alat seperti llama.cpp terus berkembang untuk mengikuti pembaruan terbaru model. Dalam beberapa minggu ke depan, harapkan solusi yang lebih baik yang mengalihkan komputasi generasi token ke GPU untuk kinerja lebih baik, alih-alih hanya mengandalkan CPU.
Selain itu, ini menjadi pengalaman belajar yang berharga bagi saya. Saya mendapatkan wawasan tentang bagaimana komunitas open-source berkolaborasi untuk mengoptimalkan dan menerapkan model-model ini seefisien mungkin.
Kimi K2 menonjol sebagai salah satu model open-source terbaik, mendekati kapabilitas model seperti DeepSeek R1, dengan performa mutakhir dalam pengetahuan frontier, matematika, dan pengkodean di antara model non-thinking.
Model ini sangat kuat dalam pemilihan alat dan tugas agentik, sehingga menjadi alternatif hemat biaya untuk model premium seperti Claude 4 Sonnet untuk proyek coding atau vibe coding.
Anda dapat menyajikan versi Kimi K2 yang dikuantisasi untuk solusi internal menggunakan panduan ini. Llama.cpp memungkinkan Anda menyajikan model bahasa sebagai API yang kompatibel dengan OpenAI. Untuk terus belajar, pastikan Anda memeriksa panduan Kimi K2 beserta contoh kami. Jika Anda tertarik mempelajari AI agentik, pastikan mengikuti kursus baru kami tentang membangun sistem multi-agent dengan LangGraph.
Kursus AI Teratas
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




