

如何访问 Runway Gen-4
要使用 Runway Gen-4,您需要订阅。请注意,它仍在逐步推出中,因此取决于您所在地区,可能尚不可用,或仅限更高等级的订阅。在美国,12 美元的订阅可获得 625 个 Gen-4 使用额度。
此外,即便订阅后,我也等了一天该功能才在我的账号中可用。
如何用 Runway Gen-4 生成视频
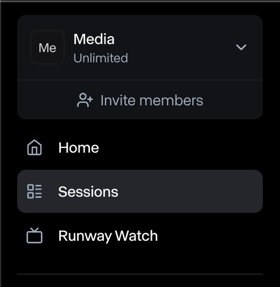
在 Runway ML 中,视频是在会话(session)中生成的。要创建视频,首先需要在左侧菜单选择“Sessions”项以创建新会话:
随后点击右侧的“New Session”按钮创建会话:
打开会话后,您会看到一个简洁的界面,您可以将一张图像与文本提示结合来生成视频:
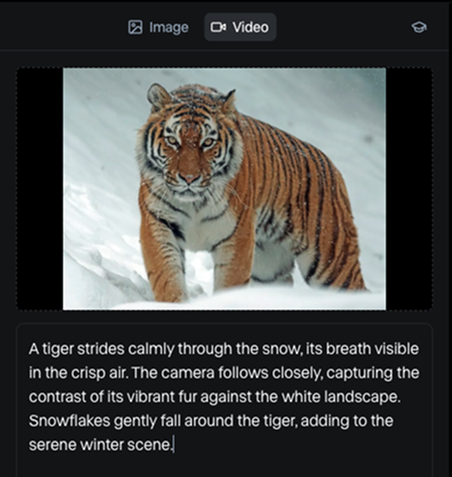
图片来源:Pexels
请务必在底部选择 Gen-4 模型:
以下是结果:
在我看来,这段视频相当不错。
如果您需要撰写提示词的指导,他们提供了这份指南页面。我使用该指南的方式是,基于它创建了一个 AI 机器人,用来把我的高层想法转换为可用的 Runway 提示词。
请注意,与其他视频生成模型不同,这里无法仅凭文本生成视频——该模型始终需要一张图片。
如何在 Runway 中创建图像
在第一个示例中,我使用了一张网上找到的可免费使用的图片。它们是制作视频的绝佳素材来源。
Runway 也提供图像生成模型。然而,出于某种原因,它在基础方案中不可用,我需要订阅其最昂贵的方案才能访问。
生成图像的步骤:
- 选择“Image”模式
- 输入描述图像的提示词
- 选择图像风格(可基于您已有的图像生成,或选择 Runway 提供的预设)。
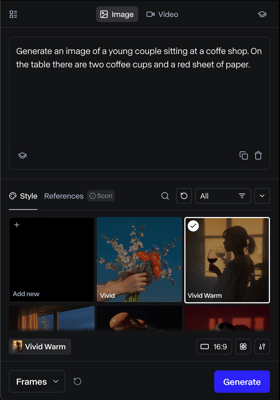
模型生成了以下四张图片:
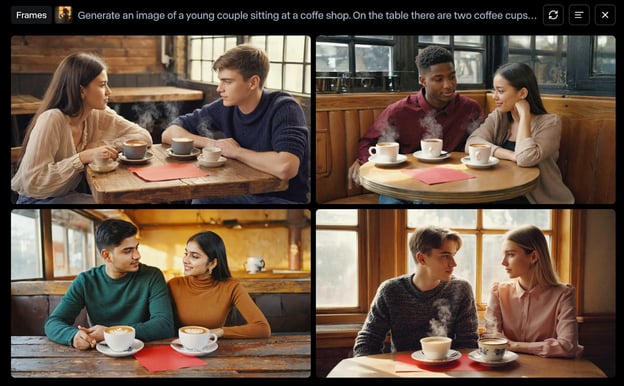
只有下方两张符合提示词。可以看到上方两张图中咖啡杯都超过了两个,且第一张还有一些奇怪的伪影。
我让桌上出现一张红色纸张的原因,是想从这张图片生成一段男子折纸花并送给女孩的视频。
为此,我们可以将鼠标悬停在想用的图像上并点击“Use”按钮:
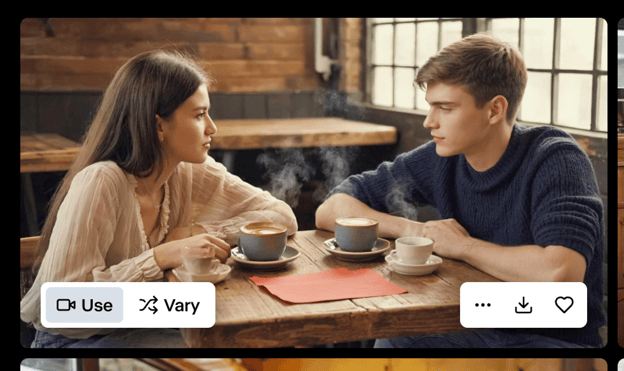
我写了一个提示词,要求用固定机位拍摄男子折一朵折纸花并将其递给女孩。我尝试了两次,一次生成 5 秒视频,另一次生成 10 秒视频。这次结果相当令人失望(这里我使用了 Gen-4):
角色一致性所缺失的功能
过去几周我测试了许多 AI 视频生成工具。在创作更长内容时,我们面临的主要难题之一是:如何让同一角色出现在多个场景中。这类工具通常只能生成几秒钟的视频片段。通过拼接多个场景固然可以做出较长的视频,但前提是我们得能在多个场景中保持相同的角色。
在他们的Gen-4 介绍文章中,他们让人感觉使用新模式就能很轻松地生成更长的视频:
我原本以为可以提供角色的图像,生成包含该角色的场景图,然后用 Gen-4 逐一生成各个场景。但至少目前还不支持。
在图像生成标签页,我们可以看到一个“References”功能,但尚不可用。
我认为这有些误导,因为没有这个功能,他们在公告中展示的那些视频根本无法制作。
绕开 Runway 的局限
好在,谷歌和 OpenAI 最近都在各自的图像生成模型中提供了类似功能。谷歌的 Gemini 2.0 具有“讲故事”模式,可为给定故事生成一系列图像;而 OpenAI 的 GPT-4o 图像生成器可以接收参考图像,并将其改造成我们想要的内容。如果您想进一步了解这两款工具,我在此处做了介绍:
用 Gemini 讲故事生成为视频
这是我用 Gemini 创作的视频:讲述一团火焰与一滴水相爱,却发现彼此无法触碰的视觉故事。
在讲故事模式中,Gemini 会生成一组图像来呈现一个视觉故事。随后,我根据 Runway 的指南使用一款 AI 工具为每一帧生成动画提示词。以下是结果:
这些片段通过视频剪辑软件拼接而成。我做了一些剪切和简单转场。另外,我在 Gemini 和 Runway 上都进行了大量迭代,才得到想要的画面。
我对结果相当满意。虽然偶有小瑕疵,但总体上我讲出了想讲的故事。老实说这个故事让我颇感伤感,也说明即便是 AI 生成的内容也能承载真切的人类情感——因为背后依然是人想要表达一条信息。
用 GPT-4o 图像生成来做视频
我认为在生成图像方面,GPT-4o 比 Gemini 更强大且更灵活。前一个视频需要大量迭代才能接近我想要的效果,我甚至还用 GPT-4o 生成了其中一个画面。
这次我想尝试一个故事:一位冒险者爬进一幅画中,被传送到画中的世界。
我先让 GPT-4o 生成角色。当我对角色满意后,我构思了以下画面:
- 角色在凝视这幅画。
- 我们看到角色凝神注视这幅画的面部特写。
- 角色正爬入这幅画。
- 角色已经进入画中世界。
- 航拍镜头展示这片广阔的新世界。
当我对这些画面满意后,使用 Gen-4 分别为每一张生成视频,并在视频剪辑软件中将它们合成:
可以看到,只有 Runway 能完成这个任务。这表明一旦所有功能就绪,该模型将具备巨大的潜力。
更多 Runway Gen-4 示例
本节我会展示更多我尝试生成的视频,帮助您更好地了解 Runway Gen-4 目前的能力边界。
纸飞机
我想到一个点子:拍一个人折纸飞机然后让它飞起来。我创建了四个画面:
- 这个人在折飞机。
- 这个人在田野里奔跑,准备把飞机掷出。
- 这个人跳进飞机里。
- 这个人在飞机里飞行。
在这个例子中我们再次看到,模型在纸张细节上表现吃力,我猜细节太多了。而且跳进飞机的那一幕非常怪异。
给物体做动画
我很好奇模型如何处理现实世界物体的动画,于是拍了一张照片并让 Gen-4 让它们跳舞。在我看来,结果相当有趣:
红绿灯
他们网站上有一个案例:红绿灯里的小人活了过来,从红绿灯中跳出。这启发我尝试做一个小视频:红绿灯小人被警察追赶,然后跳进一个未启用的人行横道信号灯里躲避警察。
以下是我用 GPT-4o 生成的三张图以及对应的视频:
很遗憾,Gen-4 未能实现我的构想。我尝试了多次迭代,结果始终相去甚远。
结语
总体而言,我觉得 Gen-4 是一款不错的图像转视频模型,尤其在熟悉的场景中表现更佳。不过,要让它按我的设想行事时,我还是遇到了不少阻力与挫败感。
我也觉得他们的发布有点误导,因为用来制作一致性长视频的一些功能尚未上线,而在购买订阅前这一点并不清楚。我真心希望 AI 公司能等产品真正完善再宣传。如果不是谷歌和 OpenAI 的近期发布,我不可能做出本文中的这些视频。
我认为 Runway 很有前景,但距离让每个有故事的人都能讲好故事,还有一段路。我们距离“想到一个东西、写成文字、立刻让它成真”的境界,仍相去甚远。
他们的示例非常美,我相信是用 Gen-4 制作的,但我也认为幕后为此倾注了巨大的工作量,才让它们得以呈现。

Runway 推出了 Gen-4,这是一款图像生成视频模型,旨在解决 AI 生成视频中的顽疾:在多镜头之间保持角色与场景的一致性。
他们在发布演示中展示的短片质量很高,这个模型也充满潜力。不过,我们还是在本文中亲自上手,看看 Runway Gen-4 是否名副其实。
什么是 Runway Gen-4?
Runway 发布了 Gen-4,这是其最新的由文本或图像生成短视频的模型。该模型承袭自 Gen-3 Alpha(于 2024 年初推出),属于让 AI 生成视频更连贯、更具叙事实用性的一系列尝试。
与早期模型不同,Gen-4 更加重视时间一致性——确保角色和物体在帧与镜头间不变形、不消失地持续出现。比如,看看这部名为The Herd的短片: