
लर्निंग पाथ
Runway ने Gen-4 पेश किया है—एक इमेज-टू-वीडियो मॉडल जिसे AI-जनित वीडियो की एक पुरानी समस्या सुलझाने के लिए बनाया गया है: कई शॉट्स में किरदारों और दृश्यों की एकरूपता बनाए रखना।
रिलीज़ डेमो में दिखाए गए शॉर्ट फिल्में काफ़ी अच्छी हैं, और मॉडल में काफी संभावनाएँ नज़र आती हैं। फिर भी, इस लेख में हम खुद परखेंगे कि क्या Runway Gen-4 उम्मीदों पर खरा उतरता है।
Runway Gen-4 क्या है?
Runway ने Gen-4 जारी किया है, जो टेक्स्ट या इमेज से छोटे वीडियो क्लिप जनरेट करने के लिए इसका नवीनतम मॉडल है। यह मॉडल Gen-3 Alpha का उत्तराधिकारी है, जो 2024 की शुरुआत में लॉन्च हुआ था, और AI-जनित वीडियो को अधिक सुसंगत और कथात्मक रूप से उपयोगी बनाने के निरंतर प्रयासों का हिस्सा है।
पहले के मॉडलों के विपरीत, Gen-4 समयगत स्थिरता पर अधिक जोर देता है—यह सुनिश्चित करते हुए कि किरदार और ऑब्जेक्ट बिना विकृत हुए या ग़ायब हुए फ्रेम्स और शॉट्स में बने रहें। उदाहरण के लिए, इस लघु फिल्म The Herd को देखें:
Runway Gen-4 तक कैसे पहुँचें
Runway Gen-4 का उपयोग करने के लिए हमें एक सब्सक्रिप्शन चाहिए। ध्यान रखें कि यह अभी भी चरणबद्ध तरीके से रोलआउट हो रहा है, इसलिए आपके स्थान के अनुसार यह अभी उपलब्ध न भी हो, या केवल उच्च-स्तरीय प्लान्स पर मिले। अमेरिका में, $12 के सब्सक्रिप्शन से Gen-4 के लिए 625 क्रेडिट मिलते हैं।
इसके अलावा, सब्सक्राइब करने के बाद भी, मुझे अपने अकाउंट पर यह उपलब्ध होने के लिए एक दिन इंतज़ार करना पड़ा।
Runway Gen-4 से वीडियो कैसे जनरेट करें
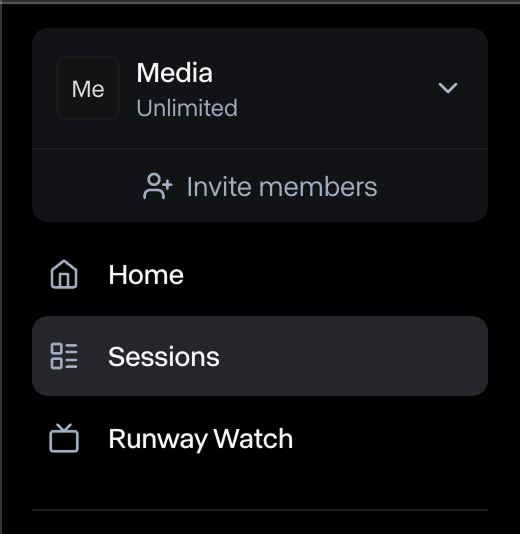
Runway ML में वीडियो सेशंस के अंदर जनरेट होते हैं। वीडियो बनाने के लिए, पहले हमें बाईं ओर मेन्यू में “Sessions” आइटम चुनकर एक नया सेशन बनाना होगा:

फिर दाईं ओर “New Session” बटन पर क्लिक करके सेशन बनाते हैं:

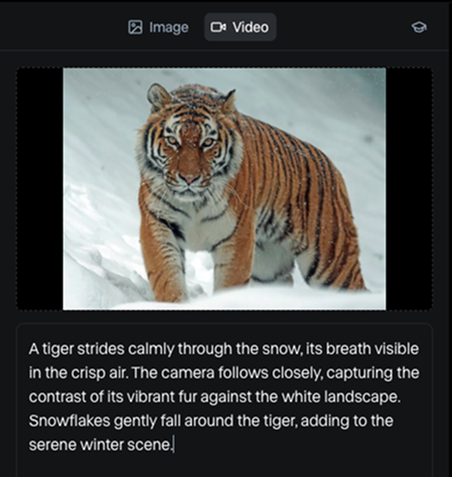
सेशन खोलने पर एक सरल इंटरफ़ेस मिलता है जहाँ हम इमेज और टेक्स्ट प्रॉम्प्ट को मिलाकर वीडियो जनरेट कर सकते हैं:
छवि स्रोत: Pexels
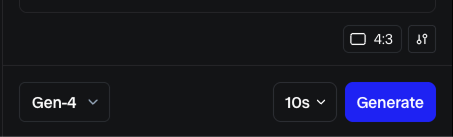
नीचे Gen-4 मॉडल चुनना न भूलें:

यह रहा परिणाम:
मेरी राय में वीडियो काफ़ी अच्छा है।
यदि आपको प्रॉम्प्ट लिखने में मार्गदर्शन चाहिए, तो वे यह गाइडलाइन पेज देते हैं। मैंने इन गाइडलाइनों के आधार पर एक AI बॉट बनाया, जो मेरी उच्च-स्तरीय आइडियाज़ को उपयोगी Runway प्रॉम्प्ट्स में बदलने के लिए तैयार किया गया था।
ध्यान दें कि अन्य वीडियो जनरेशन मॉडलों के विपरीत, हम केवल टेक्स्ट से वीडियो जनरेट नहीं कर सकते—मॉडल को हमेशा एक इमेज की आवश्यकता होती है।
Runway में इमेज कैसे बनाएँ
इस पहले उदाहरण में, मैंने ऑनलाइन मिली एक मुफ्त-उपयोग छवि का उपयोग किया। ऐसे स्रोत वीडियो बनाने में काफी उपयोगी हो सकते हैं।
Runway एक इमेज जनरेशन मॉडल भी देता है। हालांकि, किसी कारणवश यह बेसिक प्लान पर उपलब्ध नहीं था, और इसे एक्सेस करने के लिए मुझे उनके सबसे महंगे प्लान पर अपग्रेड करना पड़ा।
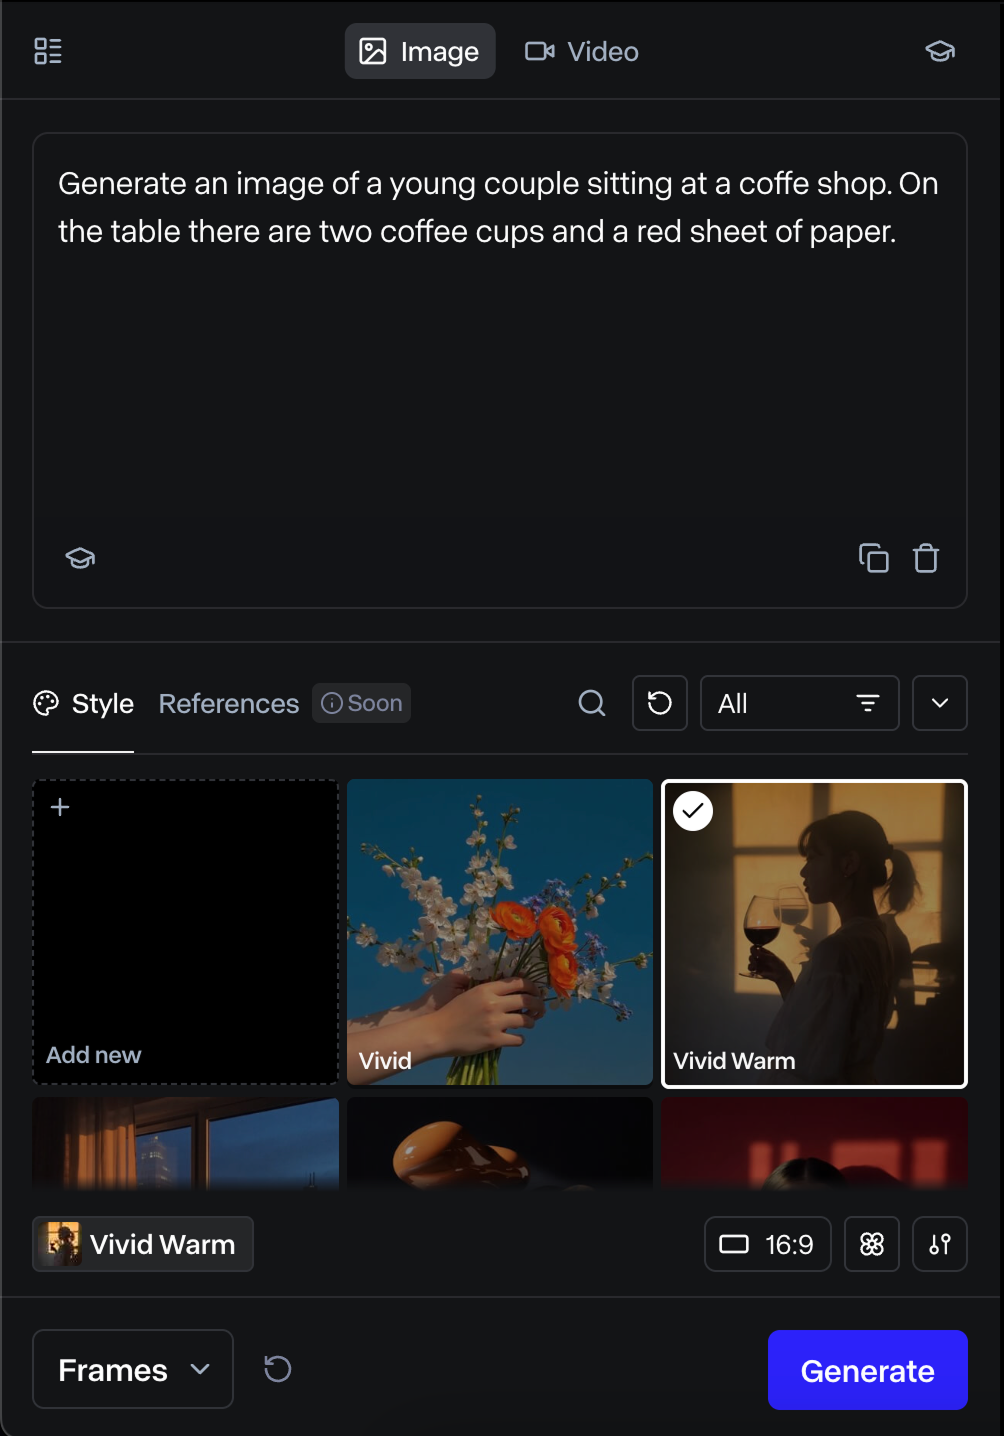
इमेज जनरेट करने के लिए:
- “Image” मोड चुनें
- इमेज का वर्णन करता हुआ एक प्रॉम्प्ट टाइप करें
- इमेज स्टाइल चुनें (यह आपकी मौजूदा किसी इमेज से या Runway द्वारा दिए गए किसी प्रीसेट से लिया जा सकता है)।

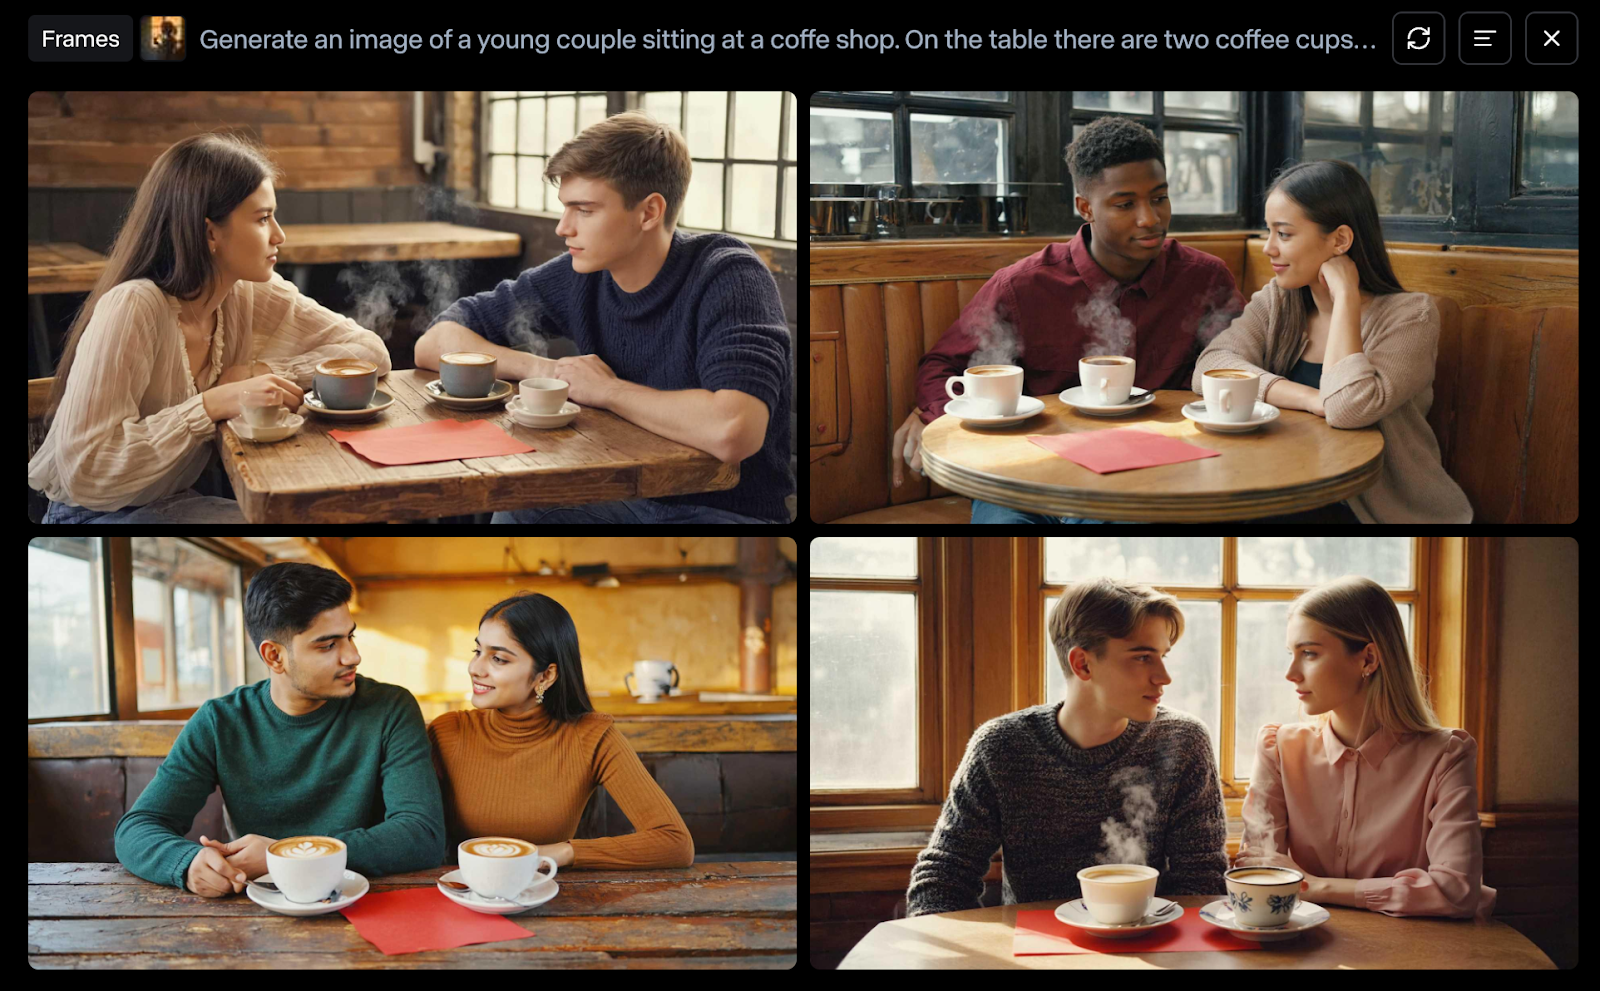
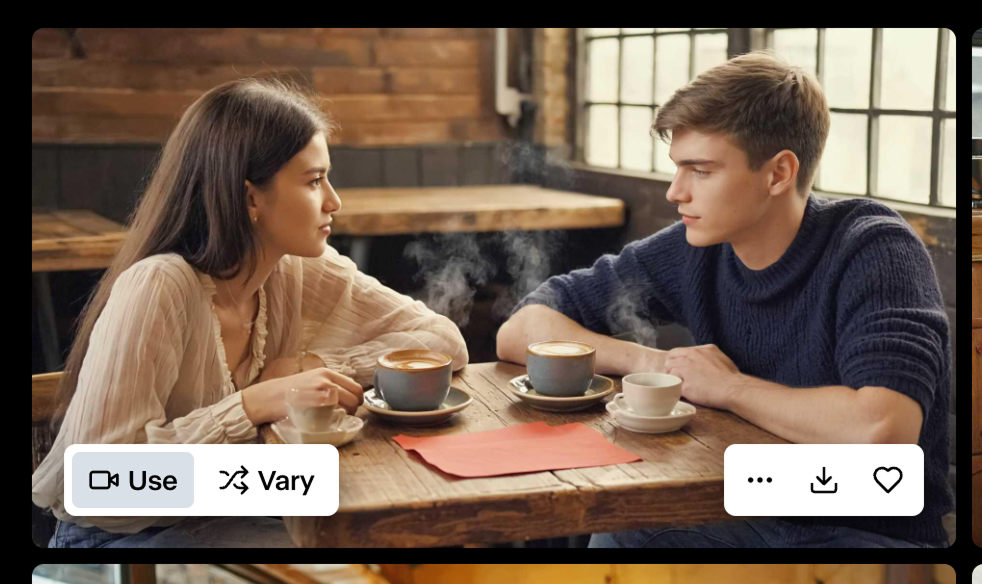
मॉडल ने ये चार इमेज जनरेट कीं:

केवल नीचे वाली दो इमेज प्रॉम्प्ट के अनुरूप हैं। ऊपर की दोनों इमेज में दो से अधिक कॉफी कप हैं, और पहली में कुछ अजीब आर्टिफैक्ट्स भी हैं।
मैंने मेज़ पर लाल कागज़ इसलिए माँगा था ताकि इस इमेज से एक वीडियो बनाया जा सके जिसमें एक आदमी लड़की को देने के लिए ओरिगामी पेपर फ्लावर बनाता है।
ऐसा करने के लिए, जिस इमेज का उपयोग करना है उस पर होवर करें और “Use” बटन पर क्लिक करें:
मैंने एक प्रॉम्प्ट बनाया जिसमें फिक्स्ड कैमरा से आदमी को ओरिगामी फूल बनाते और लड़की को देते दिखाने को कहा। मैंने इसे दो बार आज़माया—पहले 5-सेकंड का वीडियो जनरेट किया और फिर 10-सेकंड का। इस बार नतीजे काफ़ी निराशाजनक रहे (मैंने यहाँ Gen-4 का उपयोग किया):
किरदार स्थिरता के लिए गुम सुविधाएँ
पिछले कुछ हफ्तों में मैंने कई AI वीडियो-जनरेट करने वाले टूल्स की जाँच की है। लंबी सामग्री बनाने की एक प्रमुख चुनौती यह है कि एक ही किरदार को कई दृश्यों में बनाए रखा जा सके। ये टूल्स आमतौर पर कुछ सेकंड के वीडियो जनरेट करने देते हैं। कई सीन जोड़कर लंबा वीडियो बनाना संभव है, लेकिन हमें यह क्षमता चाहिए कि वही किरदार कई दृश्यों में नज़र आए।
अपने Gen-4 परिचय लेख में वे दिखाते हैं कि नए मोड का उपयोग करके लंबे वीडियो बनाना बहुत आसान है:
मुझे उम्मीद थी कि मैं अपने किरदार की एक इमेज दूँगा, उसी किरदार के साथ दृश्य-इमेजें बनाऊँगा, और अंत में Gen-4 से प्रत्येक दृश्य जनरेट कर लूँगा। लेकिन कम से कम फिलहाल, यह समर्थित नहीं है।

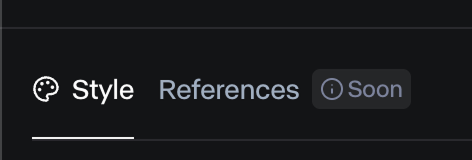
इमेज जनरेशन टैब में हमें “References” नामक एक फ़ीचर दिखता है जो अभी उपलब्ध नहीं है।
मुझे यह भ्रामक लगता है, क्योंकि उस फ़ीचर के बिना उनकी घोषणा में दिखाए गए वीडियो बनाना संभव ही नहीं है।
Runway की सीमाओं से निपटना
खुशकिस्मती से, Google और OpenAI दोनों ने हाल ही में अपने इमेज जनरेशन मॉडलों में यह सुविधा जारी की है। Google का Gemini 2.0 एक स्टोरीटेलिंग मोड देता है जो किसी कहानी के लिए छवियों की एक श्रृंखला बनाता है, जबकि OpenAI का GPT-4o इमेज जनरेटर एक संदर्भ-इमेज लेकर उसे मनचाहे रूप में ढाल सकता है। यदि आप इन दोनों टूल्स के बारे में अधिक जानना चाहते हैं, तो मैंने यहाँ कवर किया है:
- GPT-4o Image Generation: 8 व्यवहारिक उदाहरणों के साथ एक गाइड
- Gemini Image Editing: 10 व्यवहारिक उदाहरणों के साथ एक गाइड
Gemini स्टोरीटेलिंग से वीडियो बनाना
यहाँ एक वीडियो है जो मैंने Gemini से एक दृश्य कहानी सुनाने को कहकर बनाया—एक लौ और एक पानी की बूँद एक-दूसरे से प्रेम करने लगते हैं, लेकिन समझते हैं कि वे एक-दूसरे को छू नहीं सकते।
स्टोरीटेलिंग मोड में, Gemini दृश्य कहानी सुनाने के लिए छवियों का एक क्रम जनरेट करता है। फिर मैंने Runway की गाइडलाइनों के आधार पर प्रत्येक फ्रेम को ऐनिमेट करने के लिए AI टूल से प्रॉम्प्ट्स बनवाए। यह रहा परिणाम:
क्लिप्स को एक वीडियो एडिटिंग सॉफ़्टवेयर में जोड़कर बनाया गया। मैंने कुछ कट्स और सरल ट्रांज़िशन्स किए। साथ ही, मुझे मनचाहा फ्रेम पाने के लिए Gemini और Runway दोनों पर कई बार दोहराव करना पड़ा।
मैं परिणाम से काफ़ी संतुष्ट हूँ। कहीं-कहीं गड़बड़ियाँ हैं, लेकिन कुल मिलाकर मैं वह कहानी सुना सका जो मैं बताना चाहता था। सच कहूँ तो यह कहानी मुझे काफ़ी उदास कर गई—यह दिखाती है कि AI-जनित सामग्री भी वास्तविक मानवीय भावनाएँ संजो सकती है, क्योंकि इसके पीछे अब भी एक इंसान संदेश व्यक्त करने की कोशिश कर रहा होता है।
GPT-4o इमेज जनरेशन से वीडियो बनाना
मुझे लगता है कि इमेज जनरेशन में GPT-4o, Gemini की तुलना में कहीं अधिक शक्तिशाली और बहुमुखी है। पिछले वीडियो में मनचाही दिशा तक पहुँचने के लिए बहुत ज़्यादा पुनरावृत्तियाँ करनी पड़ीं, और एक फ्रेम तो मुझे GPT-4o से ही बनवाना पड़ा।
मैं एक साहसी यात्री की कहानी आज़माना चाहता हूँ जो एक पेंटिंग में चढ़ता है और पेंटिंग की दुनिया में टेलीपोर्ट हो जाता है।
मैंने GPT-4o से किरदार जनरेट करवाने से शुरुआत की। जब मैं परिणाम से खुश हुआ, तो मैंने मनचाहे फ्रेम सोचे:
- किरदार पेंटिंग को देख रहा है।
- किरदार के चेहरे का क्लोज़-अप जिसमें वह पेंटिंग को निहार रहा है।
- किरदार पेंटिंग के अंदर चढ़ रहा है।
- अब किरदार पेंटिंग की दुनिया में है।
- एक एरियल शॉट इस विशाल नई दुनिया को दिखाता है।
फ्रेम्स से संतुष्ट होने के बाद, मैंने प्रत्येक फ्रेम से Gen-4 में वीडियो जनरेट किया और उन्हें वीडियो एडिटिंग सॉफ़्टवेयर में जोड़ दिया:
पहली कोशिश के लिए मुझे यह पूरी तरह बुरा नहीं लगता। वह दृश्य जहाँ आदमी पेंटिंग में प्रवेश करता है, दोबारा काम मांगता है। मैंने कई जनरेशन आज़माए, लेकिन कोई भी मनचाहे जैसा नहीं बना।
Runway Gen-4 बनाम अन्य टूल्स
चूँकि किरदार स्थिरता बनाए रखने के लिए आवश्यक मूलभूत टूल्स Runway पर लिखे जाने के समय तक उपलब्ध नहीं थे, Gen-4 फिलहाल केवल एक इमेज-टू-वीडियो मॉडल भर है। इसलिए, मैं इसे अन्य मॉडलों से तुलना करना चाहता था कि यह कैसा प्रदर्शन करता है।
मैंने “लौ और पानी की बूँद” वीडियो के पहले दृश्य को ऐनिमेट करना चुना, जिसमें लौ दाईं ओर चलती है और फ्रेम से बाहर निकल जाती है।
हम देखते हैं कि यह कार्य केवल Runway ही कर सका। यह दर्शाता है कि जब सभी फ़ीचर्स उपलब्ध हो जाएँगे, तो इस मॉडल में बहुत बड़ी संभावनाएँ हैं।
Runway Gen-4 के और उदाहरण
इस अनुभाग में, मैं कुछ और वीडियो दिखाता हूँ जिन्हें मैंने जनरेट करने की कोशिश की, ताकि आप समझ सकें कि इस चरण पर Runway Gen-4 क्या कर सकता है।
पेपर प्लेन
मेरे मन में एक वीडियो का विचार था जिसमें कोई पेपर एयरप्लेन बनाता है और फिर उसे उड़ाता है। मैंने चार फ्रेम बनाए:
- व्यक्ति प्लेन बना रहा है।
- व्यक्ति खेत में दौड़ते हुए प्लेन फेंकने जा रहा है।
- व्यक्ति प्लेन के अंदर कूद रहा है।
- व्यक्ति प्लेन में उड़ रहा है।
इस उदाहरण में फिर दिखता है कि मॉडल को कागज़ से दिक्कत हुई—शायद यह बहुत बारीक़ विवरण है। साथ ही, प्लेन में कूदने वाला सीन काफ़ी अजीब है।
वस्तुओं को ऐनिमेट करना
मैं जानना चाहता था कि वास्तविक दुनिया की वस्तुओं को ऐनिमेट करने में मॉडल कैसा करता है, इसलिए मैंने एक फोटो ली और Gen-4 से उन्हें नचाने को कहा। परिणाम मेरी नज़र में काफ़ी मज़ेदार है:
ट्रैफिक लाइट
उनकी वेबसाइट पर एक उदाहरण है जिसमें ट्रैफिक लाइट का स्टिकमैन ज़िंदा हो जाता है और ट्रैफिक लाइट से बाहर कूदता है। इससे प्रेरित होकर मैंने एक छोटा वीडियो बनाने की कोशिश की जिसमें ट्रैफिक लाइट स्टिकमैन पुलिस से भागता है और फिर छिपने के लिए निष्क्रिय पैदल यात्री ट्रैफिक लाइट में कूद जाता है।
यहाँ GPT-4o से जनरेट की गई तीन इमेज हैं, उनके साथ वीडियो:
दुर्भाग्य से, Gen-4 मेरी कल्पना को साकार नहीं कर सका। मैंने कई बार दोहराया, लेकिन हर बार परिणाम बहुत दूर रहे।
निष्कर्ष
कुल मिलाकर, मुझे लगता है कि Gen-4 एक अच्छा इमेज-टू-वीडियो मॉडल है, खासकर परिचित दृश्यों के मामले में। हालांकि, इसे अपनी मनचाही दिशा में काम कराने में मुझे काफी घर्षण और हताशा महसूस हुई।
मुझे यह भी लगा कि उनकी घोषणा कुछ हद तक भ्रामक थी, क्योंकि लंबे, सुसंगत वीडियो बनाने वाली कुछ सुविधाएँ अभी उपलब्ध ही नहीं हैं—और सब्सक्रिप्शन लेने से पहले यह बात बिल्कुल स्पष्ट नहीं थी। काश AI कंपनियाँ अपने प्रोडक्ट पूरे होने पर ही उन्हें बढ़ा-चढ़ाकर पेश करतीं। अगर Google और OpenAI की हालिया रिलीज़ न होतीं, तो मैं यहाँ बनाए गए किसी भी वीडियो को नहीं बना पाता।
मुझे लगता है कि Runway में दम है, लेकिन वे अब भी ऐसे प्रोडक्ट से दूर हैं जिसे कोई भी कहानी बताने वाला व्यक्ति सहजता से इस्तेमाल कर सके। हम अब भी उस मुकाम से बहुत दूर हैं जहाँ कुछ कल्पना करें, उसे शब्दों में रखें, और उसे जीवंत होते देखें।
उनके उदाहरण बेहद सुंदर हैं, और मुझे विश्वास है कि वे Gen-4 से बने हैं, लेकिन मुझे यह भी लगता है कि उन्हें सच में जीवंत बनाने के लिए पीछे बहुत व्यापक मेहनत हुई है।