
Program
Runway, yapay zekâ ile üretilen videolarda süregelen bir sorunu çözmek için tasarlanmış bir görüntüden videoya modeli olan Gen-4’ü tanıttı: birden fazla planda karakter ve sahne tutarlılığını korumak.
Yayın demosunda gösterdikleri kısa filmler oldukça iyi ve model büyük bir potansiyel taşıyor. Ancak bu yazıda biz de bizzat inceleyip Runway Gen-4’ün beklentileri karşılayıp karşılamadığını göreceğiz.
Runway Gen-4 Nedir?
Runway, metin veya görsellerden kısa video klipler üreten en yeni modeli Gen-4’ü yayınladı. Model, 2024’ün başlarında çıkan Gen-3 Alpha’nın halefi ve yapay zekâ ile üretilen videoları daha tutarlı ve anlatı açısından daha kullanışlı hale getirmeye yönelik bir dizi çalışmanın parçası.
Önceki modellere kıyasla Gen-4, zamansal tutarlılığa daha fazla önem veriyor—karakterlerin ve nesnelerin kareler ve planlar boyunca bozulmadan veya kaybolmadan devamlılığını sağlıyor. Örneğin, The Herd adlı şu kısa filme göz atın:
Runway Gen-4’e Nasıl Erişilir
Runway Gen-4’e erişmek için bir abonelik gerekiyor. Henüz kademeli dağıtımda olduğunu unutmayın; bulunduğunuz yere göre henüz kullanıma açılmamış olabilir ya da yalnızca üst seviye aboneliklerde sunulabilir. ABD’de 12$’lık bir abonelik, Gen-4’ü kullanmak için 625 kredi sağlıyor.
Ayrıca, abone olduktan sonra bile hesabımda aktif olmasını beklemek için bir gün beklemem gerekti.
Runway Gen-4 ile Nasıl Video Üretilir
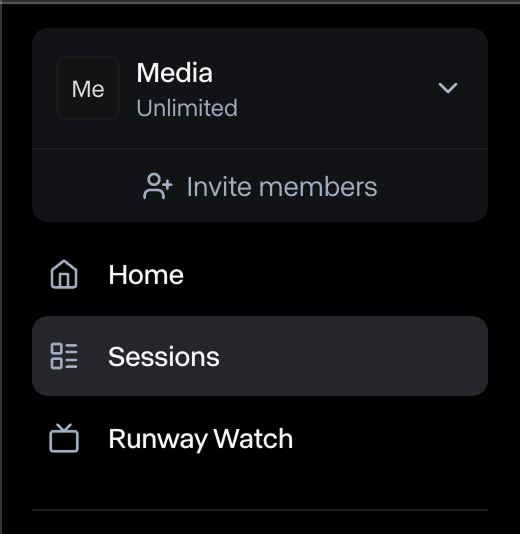
Runway ML’de videolar oturumlar içinde üretilir. Bir video oluşturmak için önce sol menüdeki “Sessions” öğesini seçerek yeni bir oturum oluşturmamız gerekir:

Ardından, bir oturum oluşturmak için sağ taraftaki “New Session” düğmesine tıklarız:

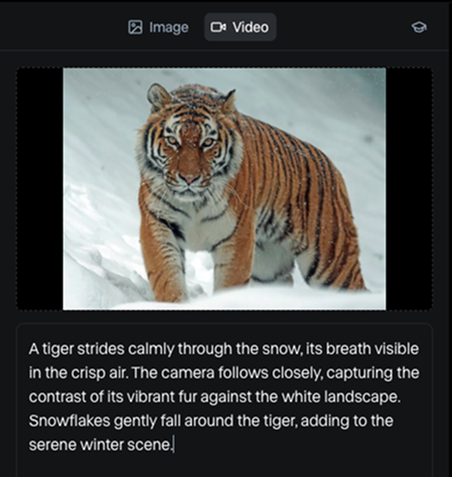
Oturumu açtığımızda, bir görsel ve bir metin istemini birleştirerek video üretebileceğimiz basit bir arayüzle karşılaşıyoruz:
Görsel kaynağı: Pexels
Altta Gen-4 modelini seçtiğinizden emin olun:

Sonuç şöyle:
Bence video oldukça iyi.
İstem oluşturmada rehberliğe ihtiyacınız varsa, şu kılavuz sayfasını sağlıyorlar. Ben, kılavuzları kullanarak istem üretmek için bu yönergelerle beslenmiş ve yüksek düzeydeki fikirlerimi kullanılabilir Runway istemlerine dönüştürmek üzere tasarlanmış bir yapay zekâ botu oluşturdum.
Dikkat edin, diğer video üretim modellerinden farklı olarak burada yalnızca metinden video üretemiyoruz—model her zaman bir görsel gerektiriyor.
Runway’de nasıl görsel oluşturulur
İlk örnekte çevrim içi bulduğum telifsiz bir görsel kullandım. Bu tür görseller, video üretimi için harika bir kaynak olabilir.
Runway ayrıca bir görsel üretim modeli de sunuyor. Ancak nedense temel planda mevcut değildi ve erişmek için en pahalı planlarına abone olmam gerekti.
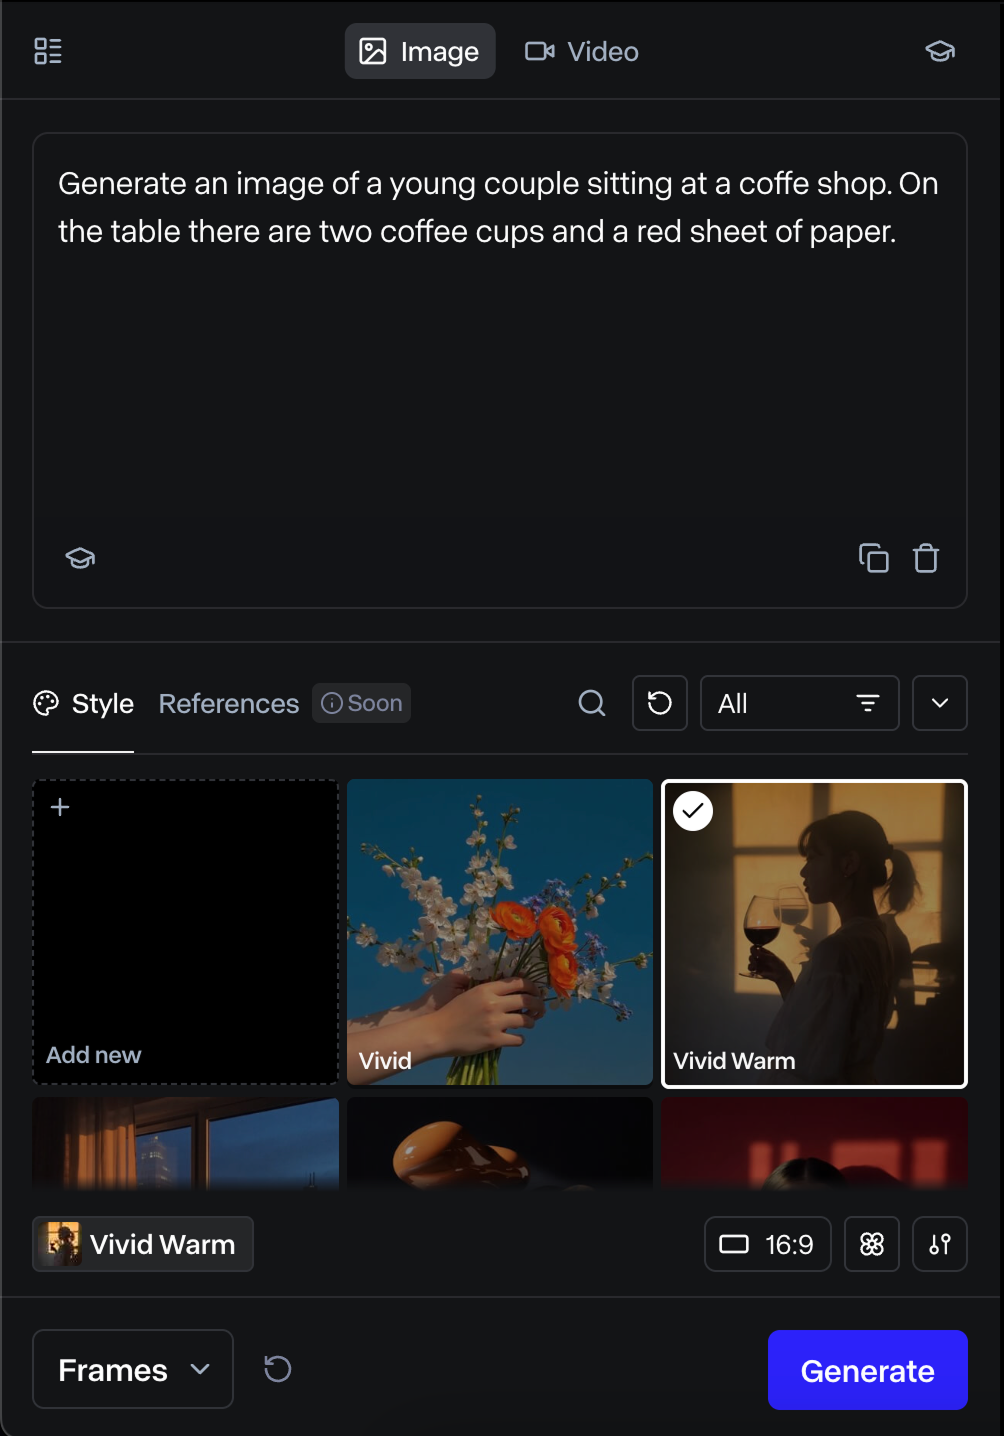
Görsel üretmek için:
- “Image” modunu seçin
- Görseli tanımlayan bir istem yazın
- Görsel stilini seçin (bu, elinizdeki mevcut bir görselden veya Runway’in sağladığı bir hazır ayardan üretilebilir).

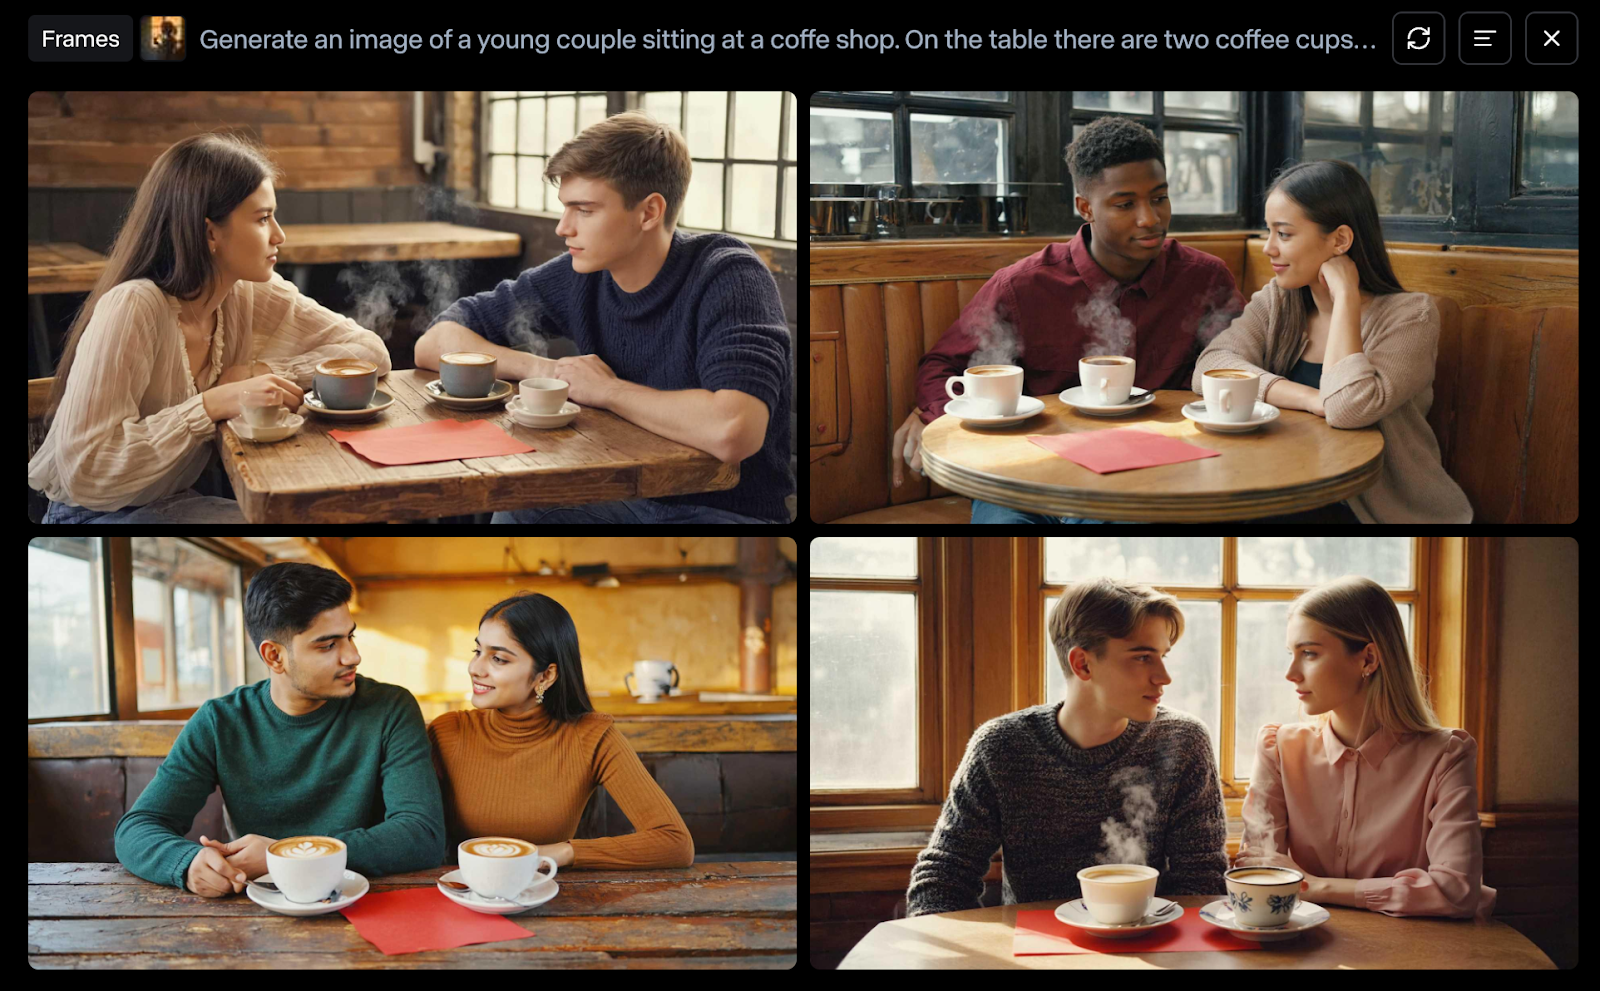
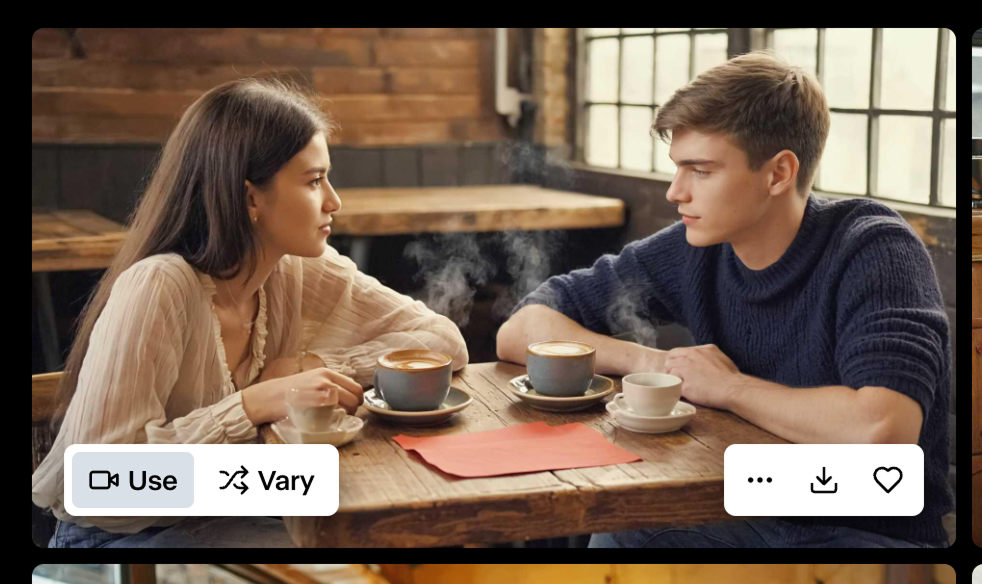
Model şu dört görseli üretti:

Yalnızca alttaki iki görsel isteme uyuyor. Üstteki iki görselde ikiden fazla kahve fincanı var ve ilki garip yapaylıklar da içeriyor.
Masadaki kırmızı kâğıdı istememe sebep, bu görselden, erkeğin kıza vermek üzere origami kâğıt çiçeği yaptığı bir video üretmek istememdi.
Bunu yapmak için, kullanmak istediğimiz görselin üzerine gelip “Use” düğmesine tıklayabiliriz:
Sabit kamerayla, erkeğin bir origami çiçek yapıp kıza vermesini anlatan bir video üretmesini isteyen bir istem oluşturdum. Bunu iki kez denedim, önce 5 saniyelik, sonra 10 saniyelik bir video ürettim. Bu sefer sonuçlar oldukça hayal kırıklığı yarattı (burada Gen-4 kullandım):
Karakter Tutarlılığı İçin Eksik Özellikler
Son birkaç haftadır birçok yapay zekâ video üretim aracını test ediyorum. Daha uzun içerikler oluştururken karşılaştığımız başlıca sorunlardan biri, aynı karakteri birden fazla sahnede kullanabilmek. Bu araçlar genellikle birkaç saniye süren videolar üretmemize izin veriyor. Birden çok sahneyi birleştirerek uzun bir video yapmak mümkün, ancak aynı karakterin birden fazla sahnede yer alabilmesi gerekiyor.
Kendi Gen-4 tanıtım yazılarında, yeni modu kullanarak daha uzun videolar üretmenin çok kolay olduğu izlenimini veriyorlar:
Karakterimin bir görselini sağlayıp, o karakterin yer aldığı sahne görsellerini üretmeyi ve son olarak her sahneyi Gen-4 ile üretmeyi bekliyordum. Ancak bu, en azından şimdilik, desteklenmiyor.

Görsel üretim sekmesinde, henüz kullanılamayan bir “References” özelliği görüyoruz.
Bunu yanıltıcı buluyorum; çünkü bu özellik olmadan, duyurularındaki videoları yapmak basitçe mümkün değil.
Runway’in Kısıtlarını Aşmak
Neyse ki hem Google hem de OpenAI bu özelliği kısa süre önce görsel üretim modellerinde yayınladı. Google’ın Gemini 2.0’ı, verilen bir hikâye için görsel bir hikâye anlatan görüntü dizileri üreten bir storytelling moduna sahipken OpenAI’nin GPT-4o görsel üreticisi bir referans görsel alıp onu istediğimiz şeye dönüştürebiliyor. Bu iki araç hakkında daha fazla bilgi edinmek isterseniz, burada ele aldım:
- GPT-4o Görsel Üretimi: 8 Uygulamalı Örnekle Rehber
- Gemini Görsel Düzenleme: 10 Uygulamalı Örnekle Rehber
Gemini storytelling ile video üretmek
Gemini’den, âşık olup da birbirlerine dokunamayacaklarını öğrenen bir alev ile su damlası hakkında görsel bir hikâye anlatmasını isteyerek oluşturduğum bir video burada.
Storytelling modunda Gemini, görsel bir hikâye anlatmak için bir dizi görüntü üretir. Ardından, her bir kareyi canlandırmak için Runway’in yönergelerine dayalı istemler üretmek üzere bir yapay zekâ aracı kullandım. Sonuç şöyle:
Klipler, bir video düzenleme yazılımında bir araya getirildi. Biraz kesme ve basit geçişler yaptım. Ayrıca, istediğim karelere ulaşmak için hem Gemini hem de Runway üzerinde epey yineleme yapmak zorunda kaldım.
Sonuçtan oldukça memnunum. Yer yer aksaklıklar var, ancak genel olarak anlatmak istediğim hikâyeyi anlatabildim. Bu hikâyeyi hazırlarken aslında biraz da hüzünlendim; bu da, arkasında bir mesajını ifade etmeye çalışan bir insan olduğu sürece, yapay zekâyla üretilen içeriklerin bile gerçek insan duyguları taşıyabildiğini gösteriyor.
GPT-4o görsel üretimiyle video üretmek
Bence GPT-4o, görsel üretmede Gemini’ye kıyasla çok daha güçlü ve çok yönlü. Önceki video, istediğime yaklaşmak için çok sayıda yineleme gerektirdi ve bir kareyi üretmek için hatta GPT-4o’yu kullanmak zorunda kaldım.
Bir tablonun içine tırmanıp tablonun dünyasına ışınlanan bir maceracının hikâyesini denemek istiyorum.
Önce GPT-4o’dan karakteri üretmesini istedim. Sonuçtan memnun kalınca istediğim kareleri düşündüm:
- Karakter tabloya bakıyor.
- Karakterin tabloyu düşünerek yüzünün yakın planını görüyoruz.
- Karakter tablonun içine tırmanıyor.
- Karakter artık tablonun dünyasında.
- Havadan bir çekim bu uçsuz bucaksız yeni dünyayı gösteriyor.
Karelerden memnun kalınca, her biriyle Gen-4 kullanarak bir video ürettim ve bunları bir video düzenleme yazılımında bir araya getirdim:
İlk deneme için fena değil bence. Adamın tablonun içine yürüdüğü sahne yeniden çalışma gerektiriyor. Birden çok üretim denedim ama hiçbiri istediğim gibi olmadı.
Runway Gen-4 Diğer Araçlara Karşı
Karakter tutarlılığını sağlamak için gereken temel araçlar Runway’de henüz mevcut olmadığından, bu yazının yazıldığı tarihte Gen-4 yalnızca bir görüntüden videoya modeli konumunda. Bu nedenle, performansını görmek için diğer modellerle karşılaştırmak istedim.
Alev ve Su Damlası videosunun ilk sahnesini, alevin sağa doğru yürüyüp kadrajdan çıktığı kısmı canlandırmayı seçtim.
İşte Runway, Sora ve WanVideo arasında yan yana bir karşılaştırma:
Yalnızca Runway’in görevi yerine getirebildiğini görüyoruz. Bu da, tüm özellikler kullanıma açıldığında modelin büyük bir potansiyel taşıdığını gösteriyor.
Daha Fazla Runway Gen-4 Örneği
Bu bölümde, Runway Gen-4’ün şu aşamada neler yapabildiğine daha iyi bir bakış sunmak için denediğim birkaç videoyu daha gösteriyorum.
Kâğıt uçak
Birinin kâğıttan uçak yapıp sonra uçurmasını anlatan bir video fikrim vardı. Dört kare oluşturdum:
- Kişi uçağı yapıyor.
- Kişi bir tarlada koşarak uçağı fırlatmaya hazırlanıyor.
- Kişi uçağın içine atlıyor.
- Kişi uçakta uçuyor.
Bu örnekte de modelin kâğıtla zorlandığını görüyoruz. Sanırım detay seviyesi fazla. Ayrıca uçağa atlama sahnesi oldukça tuhaf.
Nesneleri canlandırmak
Modelin gerçek dünya nesnelerini canlandırmayı nasıl başardığını merak ettim; bu yüzden bir fotoğraf çektim ve Gen-4’ten onların dans etmesini istedim. Sonuç bana göre epey komik:
Trafik ışığı
Web sitelerinde, trafik ışığındaki çöp adamın canlanıp trafik ışığından dışarı zıpladığı bir örnek var. Bu beni, polislerden kaçan ve ardından saklanmak için pasif durumdaki bir yaya trafik ışığının içine atlayan bir trafik ışığı çöp adamının kısa bir videosunu yaratmayı denemeye teşvik etti.
İşte GPT-4o ile ürettiğim üç görsel ve bunlarla oluşturulan videolar:
Ne yazık ki Gen-4, hayalimi gerçeğe dönüştüremedi. Birden çok yineleme yaptım, ancak sonuçlar hep hedefin çok uzağında kaldı.
Sonuç
Genel olarak, Gen-4’ün özellikle tanıdık sahnelerde iyi bir görüntüden videoya modeli olduğunu düşünüyorum. Ancak ondan istediğimi elde etme sürecinde epey sürtünme ve hayal kırıklığı yaşadım.
Ayrıca, tutarlı uzun metraj videolar yapmak için gereken bazı özellikler henüz mevcut olmadığından duyurularını biraz yanıltıcı buldum; aboneliği almadan önce bu hiç de net değildi. Keşke yapay zekâ şirketleri ürünlerini tamamlamadan önce abartılı tanıtımlara girişmeseler. Google ve OpenAI’nin son yayınları olmasaydı, burada yaptığım videoların hiçbirini yapamazdım.
Runway’in umut vadettiğini düşünüyorum, ancak hikâyesi olan herkesin rahatça kullanabileceği bir ürünü sunmaktan hâlâ uzaklar. Bir şeyi hayal edip kelimelere dökerek hemen hayata geçtiğini görebileceğimiz noktaya gelmemize daha çok var.
Örnekleri çok güzel ve bence Gen-4 ile yapıldılar; fakat onları hayata geçirmek için perde arkasında muazzam bir emek harcandığını da düşünüyorum.