
Weiter zum Inhalt

Runway Gen-4: Ein Guide mit praktischen Beispielen

Lerne Runway Gen-4 anhand praktischer Beispiele kennen und erfahre, wie du die Grenzen des Modells mit Bildgeneratoren aus GPT-4o und Gemini umgehst.
Aktualisiert 18. Sept. 2026  · 8 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

Runway hat Gen-4 vorgestellt, ein Image-to-Video-Modell, das ein hartnäckiges Problem KI-generierter Videos angeht: die Konsistenz von Figuren und Szenen über mehrere Shots hinweg aufrechtzuerhalten.

Die Kurzfilme aus der Release-Demo sind wirklich stark, und das Modell macht viel Hoffnung. In diesem Artikel schauen wir uns aber selbst an, ob Runway Gen-4 den Erwartungen gerecht wird.

Was ist Runway Gen-4?

Runway hat Gen-4 veröffentlicht, sein neuestes Modell zur Generierung kurzer Videoclips aus Text oder Bildern. Das Modell ist der Nachfolger von Gen-3 Alpha aus Anfang 2024 und Teil einer Reihe von Bestrebungen, KI-Video kohärenter und erzählerisch nutzbarer zu machen.

Anders als frühere Modelle legt Gen-4 mehr Gewicht auf zeitliche Konsistenz—also darauf, dass Figuren und Objekte über Frames und Shots hinweg bestehen bleiben, ohne zu verzerren oder zu verschwinden. Ein Beispiel dafür ist der Kurzfilm The Herd:

So greifst du auf Runway Gen-4 zu

Für den Zugriff auf Runway Gen-4 brauchst du ein Abo. Beachte, dass der Rollout noch läuft. Je nach Standort ist es möglicherweise noch nicht verfügbar oder nur in höherpreisigen Abos enthalten. In den USA erhältst du mit einem 12-$-Abo 625 Credits für Gen-4.

Selbst nach dem Abschluss des Abos musste ich übrigens noch einen Tag warten, bis es in meinem Konto freigeschaltet war.

So erzeugst du ein Video mit Runway Gen-4

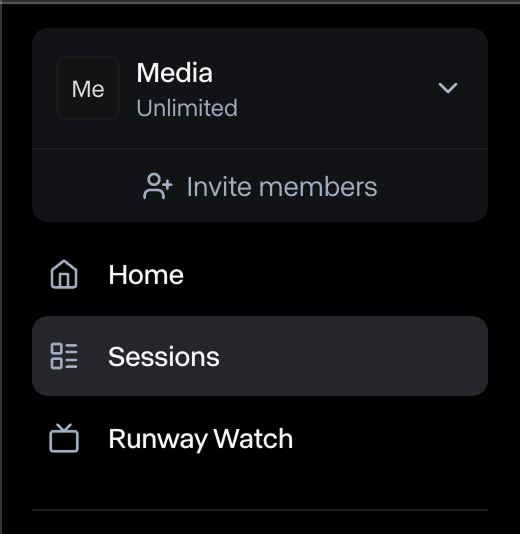
Videos in Runway ML werden in Sessions erstellt. Um ein Video zu erzeugen, legst du zuerst eine neue Session an, indem du im linken Menü auf „Sessions“ klickst:

runway gen 4 sesions tab

Anschließend klickst du rechts auf „New Session“, um die Session zu erstellen:

new session button

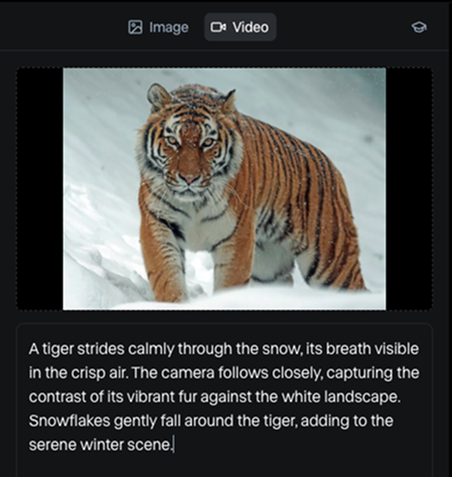
In der Session erwartet dich eine einfache Oberfläche, in der du ein Bild und einen Textprompt kombinierst, um ein Video zu generieren:

runway image and text as a prompt

Bildquelle: Pexels

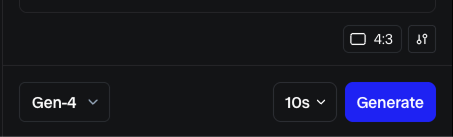
Wähle unten unbedingt das Gen-4-Modell aus:

how to select the Runway gen 4 model

Hier ist das Ergebnis:

Das Video ist meiner Meinung nach ziemlich gut gelungen.

Wenn du Hilfe beim Formulieren eines Prompts brauchst, gibt es diese Guideline-Seite. Ich habe mir dafür einen KI-Bot gebaut, der auf Basis dieser Guidelines meine groben Ideen in brauchbare Runway-Prompts übersetzt.

Beachte: Anders als bei vielen anderen Videomodellen lässt sich hier kein reiner Text-zu-Video-Flow nutzen—das Modell benötigt immer ein Bild.

So erstellst du ein Bild in Runway

Im ersten Beispiel habe ich ein frei nutzbares Bild aus dem Netz verwendet. Solche Quellen eignen sich hervorragend, um Videos zu erstellen.

Runway stellt auch ein Bildgenerierungsmodell bereit. Aus irgendeinem Grund war es im Basis-Abo jedoch nicht verfügbar, und ich musste das teuerste Abo buchen, um Zugriff zu bekommen.

So generierst du ein Bild:

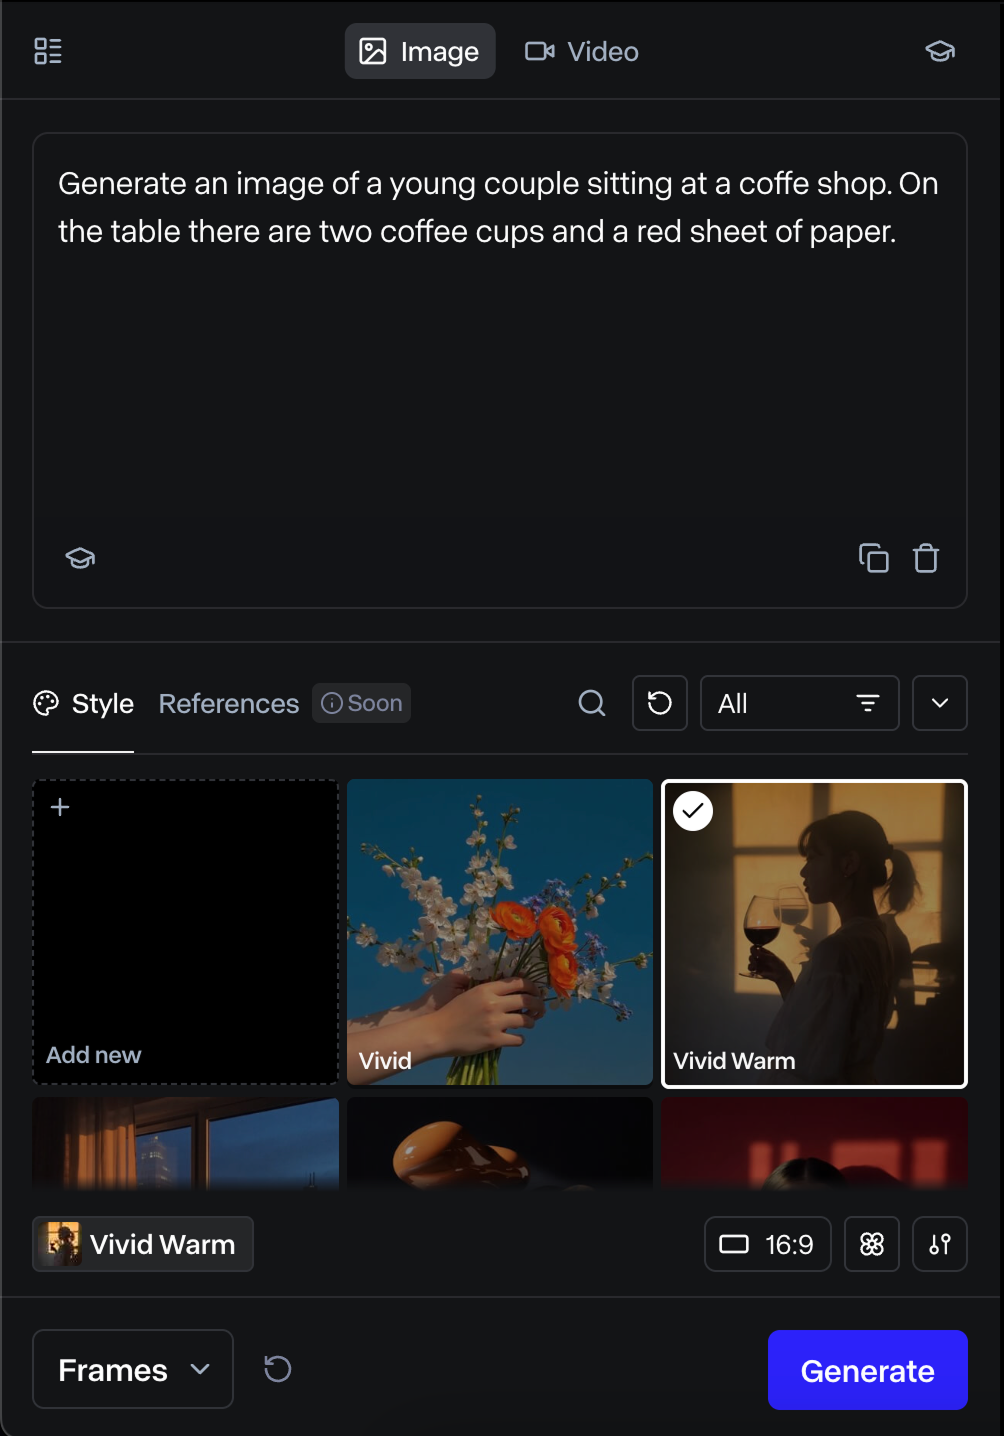
  1. „Image“-Modus auswählen
  2. Einen Prompt mit der gewünschten Bildbeschreibung eingeben
  3. Den Bildstil wählen (entweder aus einem eigenen Referenzbild oder einer Runway-Vorlage).

how to creat a video in runway

Das Modell hat diese vier Bilder erzeugt:
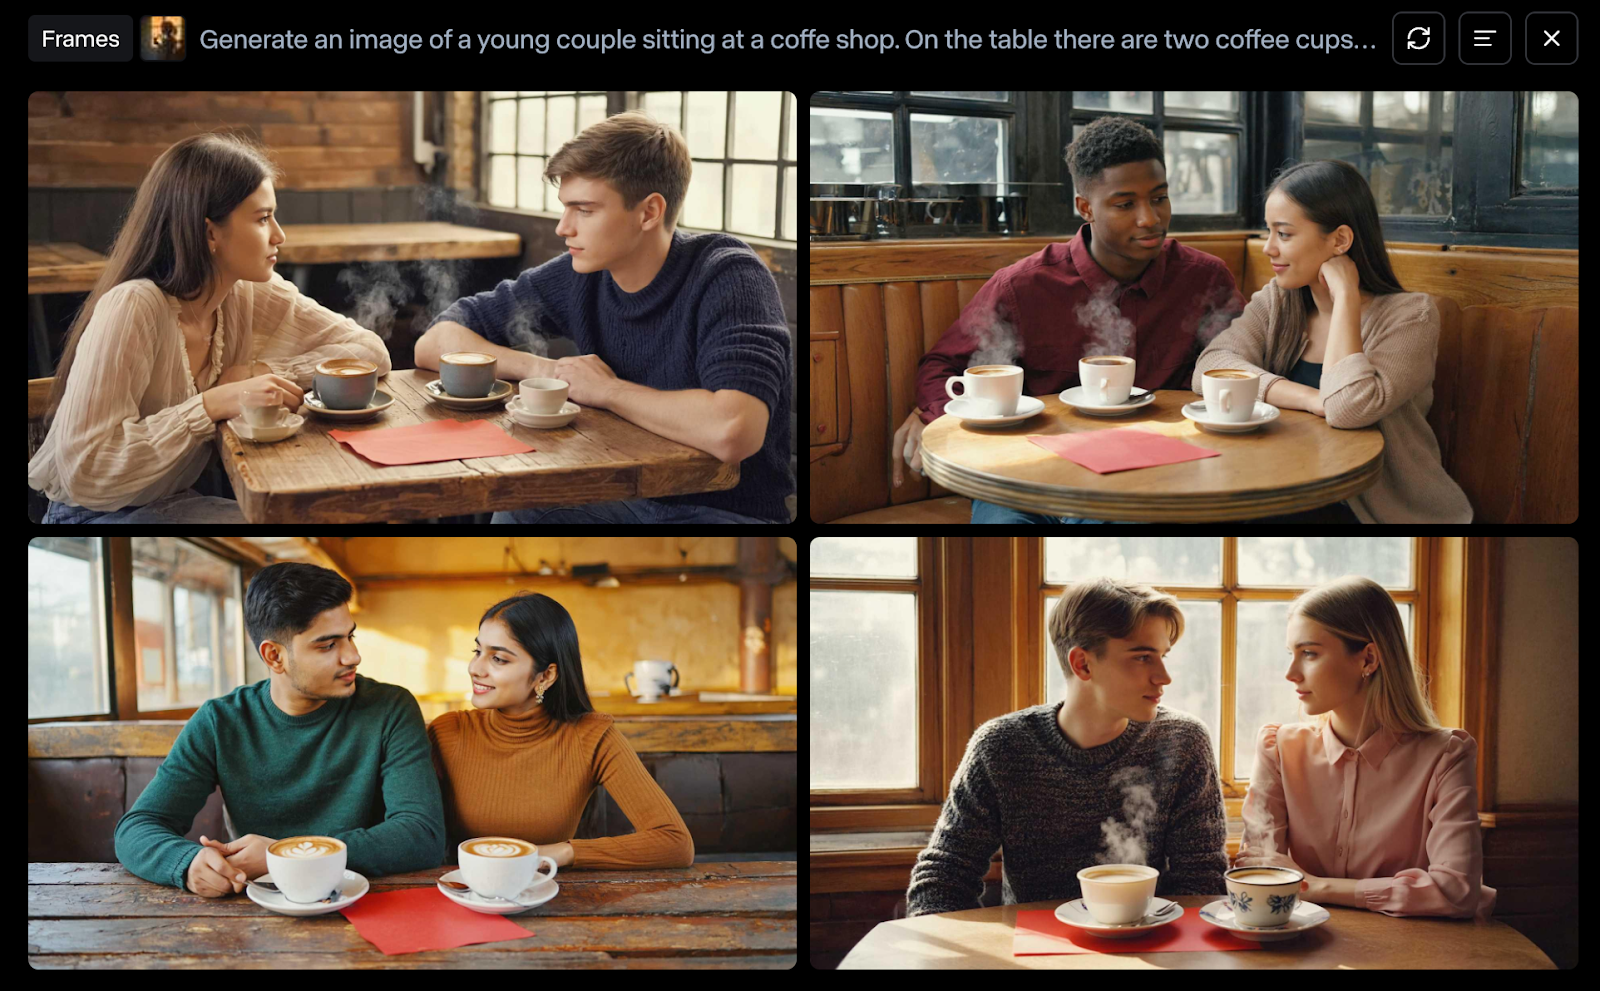
image output with runway

Nur die beiden unteren erfüllen den Prompt. Auf den oberen beiden sehen wir mehr als zwei Kaffeetassen, und das erste zeigt sogar merkwürdige Artefakte.

Den roten Bogen auf dem Tisch habe ich verlangt, weil ich daraus ein Video generieren wollte, in dem der Mann eine Origami-Papierblume faltet, um sie dem Mädchen zu schenken.

Dazu fahren wir mit der Maus über das gewünschte Bild und klicken auf „Use“:
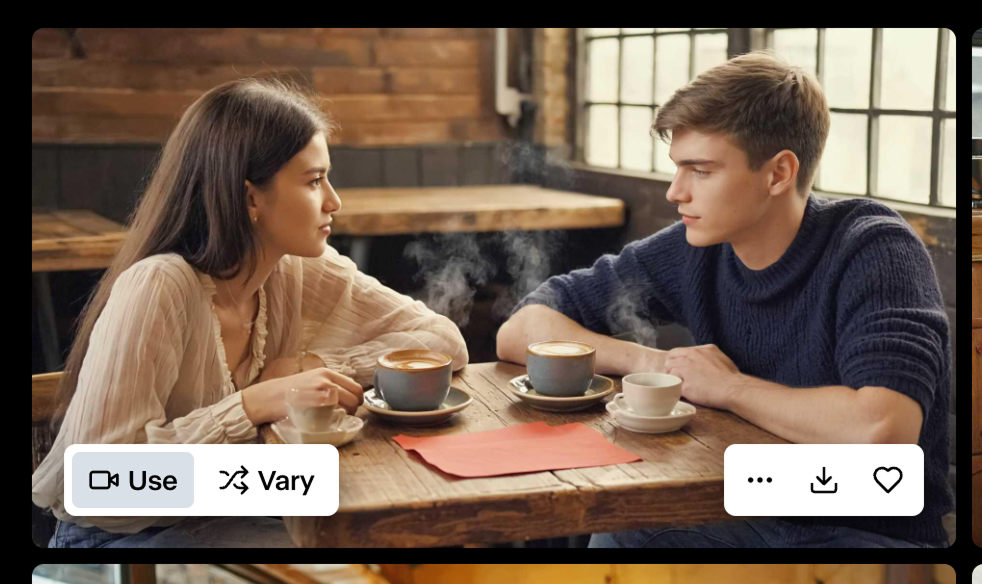
the use button in runway

Ich habe dann einen Prompt formuliert, der ein Video mit fixer Kamera verlangt, in dem der Mann eine Origami-Blume bastelt und sie dem Mädchen gibt. Ich habe es zweimal versucht: einmal mit 5 Sekunden und dann mit 10 Sekunden. Die Ergebnisse waren diesmal ziemlich enttäuschend (ich habe hier Gen-4 genutzt):

Fehlende Funktionen für Figurenkonsistenz

Ich habe in den letzten Wochen viele KI-Videotools getestet. Eines der Hauptprobleme bei längeren Inhalten ist, dieselbe Figur in mehreren Szenen beizubehalten. Die Tools erzeugen meist Clips von wenigen Sekunden. Das reicht, um längere Videos aus mehreren Szenen zusammenzusetzen, aber dafür brauchen wir konsistente Figuren über die Szenen hinweg.

Im Einführungsartikel zu Gen-4 wirkt es so, als ließen sich mit dem neuen Modus sehr einfach längere Videos erzeugen:

Ich hatte erwartet, ein Bild meiner Figur vorzugeben, damit passende Szenenbilder mit eben dieser Figur erzeugt werden, um anschließend jede Szene mit Gen-4 zu animieren. Das wird jedoch derzeit nicht unterstützt.

the references feature in runway will be available soon

Im Tab zur Bildgenerierung sehen wir zwar eine Funktion „References“, sie ist aber noch nicht verfügbar.

Das finde ich irreführend, denn ohne diese Funktion lassen sich die Videos aus der Ankündigung schlicht nicht nachbauen.

So umgehst du die Grenzen von Runway

Zum Glück haben Google und OpenAI diese Funktion kürzlich in ihren Bildgeneratoren veröffentlicht. Googles Gemini 2.0 hat einen Storytelling-Modus, der zu einer Geschichte eine Bildserie erzeugt, während OpenAIs GPT-4o-Bildgenerator ein Referenzbild übernehmen und daraus nahezu alles machen kann. Wenn du mehr über diese beiden Tools erfahren willst, findest du hier Details:

Ein Video mit Gemini-Storytelling erstellen

Hier ist ein Video, für das ich Gemini gebeten habe, eine visuelle Geschichte über eine Flamme und einen Wassertropfen zu erzählen, die sich verlieben, aber lernen, dass sie sich nicht berühren können.

Im Storytelling-Modus erzeugt Gemini eine Bildsequenz, die die Geschichte visuell erzählt. Anschließend habe ich mit einem KI-Tool Prompts anhand der Runway-Guidelines erstellt, um jedes Frame zu animieren. Das ist dabei herausgekommen:

Die Clips habe ich in einer Videosoftware zusammengeschnitten, ein paar Schnitte gesetzt und einfache Übergänge genutzt. Außerdem musste ich sowohl bei Gemini als auch bei Runway viel iterieren, um die gewünschten Frames zu bekommen.

Mit dem Ergebnis bin ich ziemlich zufrieden. Es gibt zwar hier und da Glitches, aber insgesamt konnte ich die Geschichte so erzählen, wie ich sie erzählen wollte. Tatsächlich hat mich die Story etwas traurig gemacht—ein Zeichen dafür, dass selbst KI-generierte Inhalte echte Emotionen transportieren können, weil am Ende doch ein Mensch dahintersteht, der eine Botschaft ausdrücken möchte.

Ein Video mit GPT-4o-Bildgenerierung erstellen

Ich finde, GPT-4o ist beim Generieren von Bildern deutlich stärker und vielseitiger als Gemini. Beim vorherigen Video brauchte es viele Iterationen, um in die Nähe meines Ziels zu kommen, und ein Frame musste ich sogar mit GPT-4o erzeugen.

Als Nächstes wollte ich die Geschichte eines Abenteurers erzählen, der in ein Gemälde klettert und in dessen Welt teleportiert wird.

Ich habe GPT-4o zunächst die Figur erstellen lassen. Als ich zufrieden war, habe ich die gewünschten Frames festgelegt:

  1. Die Figur betrachtet das Gemälde.
  2. Close-up des Gesichts der Figur, wie sie das Gemälde betrachtet.
  3. Die Figur klettert in das Gemälde hinein.
  4. Die Figur befindet sich nun in der Welt des Gemäldes.
  5. Eine Luftaufnahme zeigt die Weite dieser neuen Welt.

Als die Frames standen, habe ich für jedes mit Gen-4 ein Video erzeugt und sie in einer Videosoftware zusammengesetzt:

Für einen ersten Versuch ist es gar nicht so schlecht. Die Szene, in der der Mann ins Gemälde geht, braucht aber Überarbeitung. Ich habe mehrere Generierungen versucht, aber keine entsprach meinen Vorstellungen.

Runway Gen-4 im Vergleich mit anderen Tools

Da die grundlegenden Funktionen für Figurenkonsistenz bei Runway aktuell noch fehlen, ist Gen-4 Stand heute ein reines Image-to-Video-Modell. Deshalb wollte ich es mit anderen Modellen vergleichen, um die Performance einzuordnen.

Ich habe die erste Szene des „Flame and Water Drop“-Videos animiert, in der die Flamme nach rechts läuft und den Frame verlässt.

Hier ist ein Direktvergleich zwischen Runway, Sora und WanVideo:

Wir sehen, dass nur Runway die Aufgabe meistert. Das zeigt, welches Potenzial in diesem Modell steckt, sobald alle Funktionen verfügbar sind.

Weitere Beispiele für Runway Gen-4

In diesem Abschnitt zeige ich ein paar weitere Videos, die ich ausprobiert habe, damit du besser einschätzen kannst, was Runway Gen-4 aktuell leisten kann.

Papierflieger

Ich hatte die Idee, ein Video zu machen, in dem jemand einen Papierflieger baut und ihn anschließend fliegen lässt. Dafür habe ich vier Frames erstellt:

  • Die Person baut den Flieger.
  • Die Person läuft auf einem Feld an, um den Flieger zu werfen.
  • Die Person springt in den Flieger hinein.
  • Die Person fliegt im Flieger.

Auch hier sieht man, dass das Modell mit dem Papier kämpft—vermutlich zu viele Details. Zudem wirkt die Szene, in der in den Flieger gesprungen wird, sehr seltsam.

Objekte animieren

Mich hat interessiert, wie das Modell mit realen Gegenständen umgeht. Also habe ich ein Foto genommen und Gen-4 gebeten, die Objekte tanzen zu lassen. Das Ergebnis ist, wie ich finde, ziemlich witzig:

Ampelmännchen

Auf der Website gibt es ein Beispiel, in dem ein Ampel-Männchen lebendig wird und aus der Ampel springt. Das hat mich inspiriert, ein kurzes Video zu versuchen: Ein Ampel-Männchen rennt vor der Polizei davon und springt dann in eine inaktive Fußgängerampel, um sich zu verstecken.

Hier sind die drei mit GPT-4o erzeugten Bilder sowie die dazugehörigen Videos:

Leider konnte Gen-4 meine Idee nicht umsetzen. Trotz vieler Iterationen lag das Ergebnis immer weit daneben.

Fazit

Insgesamt ist Gen-4 ein gutes Image-to-Video-Modell, besonders für vertraute Szenen. Gleichzeitig hatte ich viel Reibung und Frust, bis es das tat, was ich wollte.

Auch die Ankündigung empfand ich als etwas irreführend, weil wichtige Funktionen für konsistente Longform-Videos noch nicht verfügbar sind—und das war vor dem Aboabschluss keineswegs klar. Ich wünschte, KI-Unternehmen würden warten, bis ihre Produkte fertig sind, statt sie zu früh zu hypen. Ohne die jüngsten Releases von Google und OpenAI hätte ich keines der hier gezeigten Videos erstellen können.

Runway hat Potenzial, aber von einem Produkt, mit dem jede Person ihre Geschichte einfach umsetzen kann, sind wir noch ein gutes Stück entfernt. Von „vorstellen, aufschreiben, ansehen“ sind wir weiterhin weit weg.

Die Beispiele von Runway sind wunderschön, und ich glaube, sie wurden mit Gen-4 erstellt. Gleichzeitig vermute ich, dass enorm viel Arbeit hinter den Kulissen nötig war, um sie zum Leben zu erwecken.


François Aubry's photo
Author
François Aubry
LinkedIn
Full-Stack-Ingenieur und Gründer von CheapGPT. Das Unterrichten war schon immer meine Leidenschaft. Schon als Schülerin habe ich eifrig nach Möglichkeiten gesucht, anderen Schülern Nachhilfe zu geben und sie zu unterstützen. Diese Leidenschaft führte dazu, dass ich einen Doktortitel anstrebte, wobei ich auch als Lehrassistentin tätig war, um meine akademischen Bemühungen zu unterstützen. In diesen Jahren fand ich im traditionellen Klassenzimmer große Erfüllung, indem ich Verbindungen förderte und das Lernen erleichterte. Doch mit dem Aufkommen von Online-Lernplattformen erkannte ich das transformative Potenzial der digitalen Bildung. Ich war sogar aktiv an der Entwicklung einer solchen Plattform an unserer Hochschule beteiligt. Es ist mir ein großes Anliegen, traditionelle Unterrichtsprinzipien mit innovativen digitalen Methoden zu verbinden. Meine Leidenschaft ist es, Kurse zu erstellen, die nicht nur ansprechend und informativ, sondern auch für Lernende im digitalen Zeitalter zugänglich sind.
Themen
Künstliche Intelligenz
Große Sprachmodelle

Lerne KI mit diesen Kursen!

Lernpfad

KI-Grundlagen für Unternehmen

12 Std.
Beschleunige deinen Einstieg in die KI, meistere ChatGPT und entwickle eine umfassende KI-Strategie.
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow