
Programa
Runway ha presentado Gen-4, un modelo de imagen a vídeo diseñado para abordar un problema persistente del vídeo generado por IA: mantener la coherencia de personajes y escenas a lo largo de varios planos.
Los cortometrajes que mostraron en la demo de lanzamiento son muy buenos y el modelo promete mucho. Aun así, en este artículo vamos a probarlo por nuestra cuenta para ver si Runway Gen-4 está a la altura de las expectativas.
¿Qué es Runway Gen-4?
Runway ha lanzado Gen-4, su nuevo modelo para generar clips de vídeo cortos a partir de texto o imágenes. El modelo sucede a Gen-3 Alpha, lanzado a principios de 2024, y forma parte de los esfuerzos por hacer que el vídeo generado por IA sea más coherente y útil a nivel narrativo.
A diferencia de modelos anteriores, Gen-4 pone el foco en la consistencia temporal: garantiza que personajes y objetos se mantengan a través de fotogramas y planos sin deformarse ni desaparecer. Por ejemplo, echa un vistazo a este cortometraje llamado The Herd:
Cómo acceder a Runway Gen-4
Para acceder a Runway Gen-4, necesitas una suscripción. Ten en cuenta que aún se está desplegando, así que, según tu ubicación, puede que todavía no esté disponible o que solo lo esté en planes de mayor nivel. En EE. UU., una suscripción de 12 $ incluye 625 créditos para usar Gen-4.
Además, incluso después de suscribirme, tuve que esperar un día para que estuviera disponible en mi cuenta.
Cómo generar un vídeo con Runway Gen-4
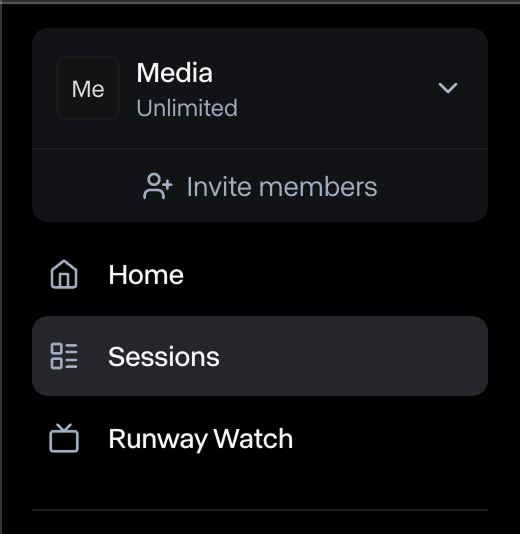
Los vídeos en Runway ML se generan dentro de sesiones. Para crear un vídeo, primero hay que crear una nueva sesión seleccionando el elemento «Sessions» en el menú de la izquierda:

Luego hacemos clic en el botón «New Session» a la derecha para crear una sesión:

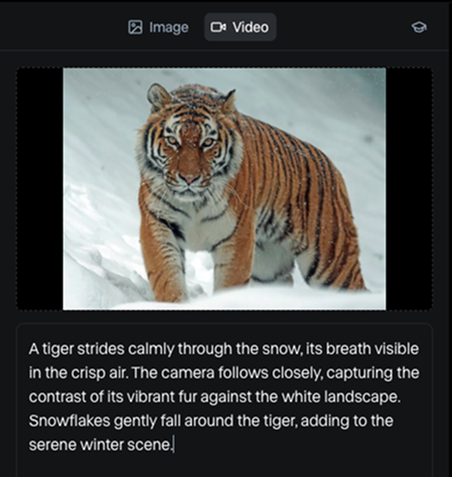
Al abrir la sesión, verás una interfaz sencilla donde puedes combinar una imagen y un prompt de texto para generar un vídeo:
Fuente de la imagen: Pexels
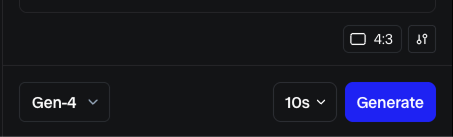
Asegúrate de seleccionar el modelo Gen-4 en la parte inferior:

Este es el resultado:
El vídeo está bastante bien, en mi opinión.
Si necesitas ayuda para crear un prompt, ofrecen esta página de directrices. Yo utilicé esas pautas creando un bot de IA con las directrices para transformar mis ideas de alto nivel en prompts utilizables de Runway.
Ten en cuenta que, a diferencia de otros modelos de generación de vídeo, no se puede generar un vídeo solo con texto: el modelo siempre requiere una imagen.
Cómo crear una imagen en Runway
En este primer ejemplo utilicé una imagen de libre uso que encontré online. Son un gran recurso para crear vídeos.
Runway también ofrece un modelo de generación de imágenes. Sin embargo, por alguna razón, no estaba disponible en el plan básico y tuve que suscribirme a su plan más caro para acceder.
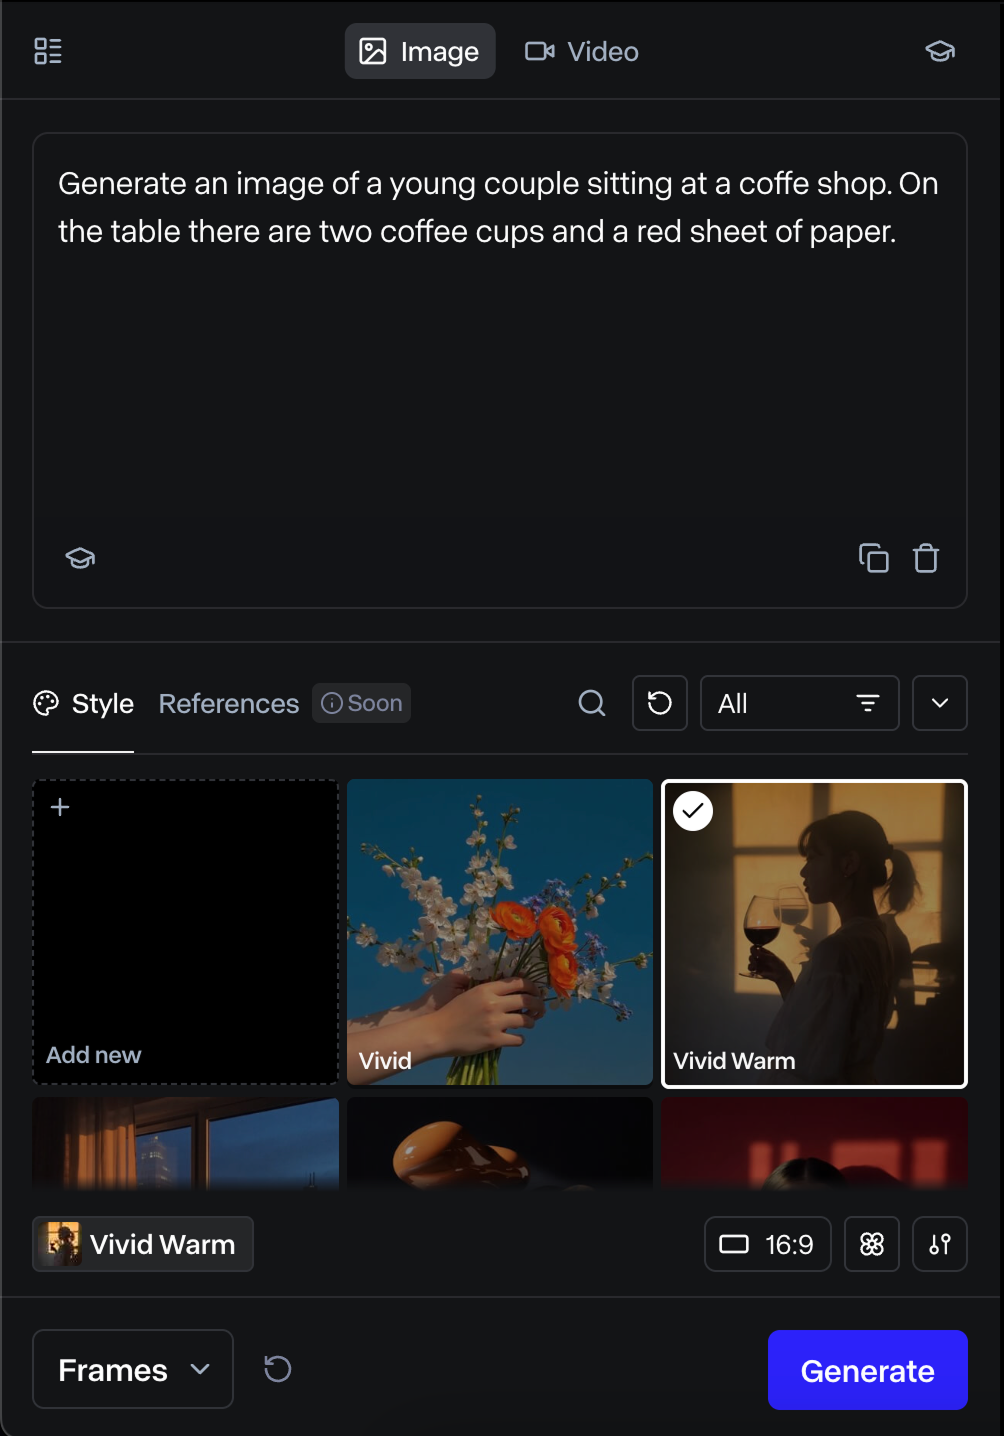
Para generar una imagen:
- Selecciona el modo «Image»
- Escribe un prompt que describa la imagen
- Selecciona el estilo de imagen (puede generarse a partir de una imagen que ya tengas o un preset de Runway).

El modelo generó estas cuatro imágenes:
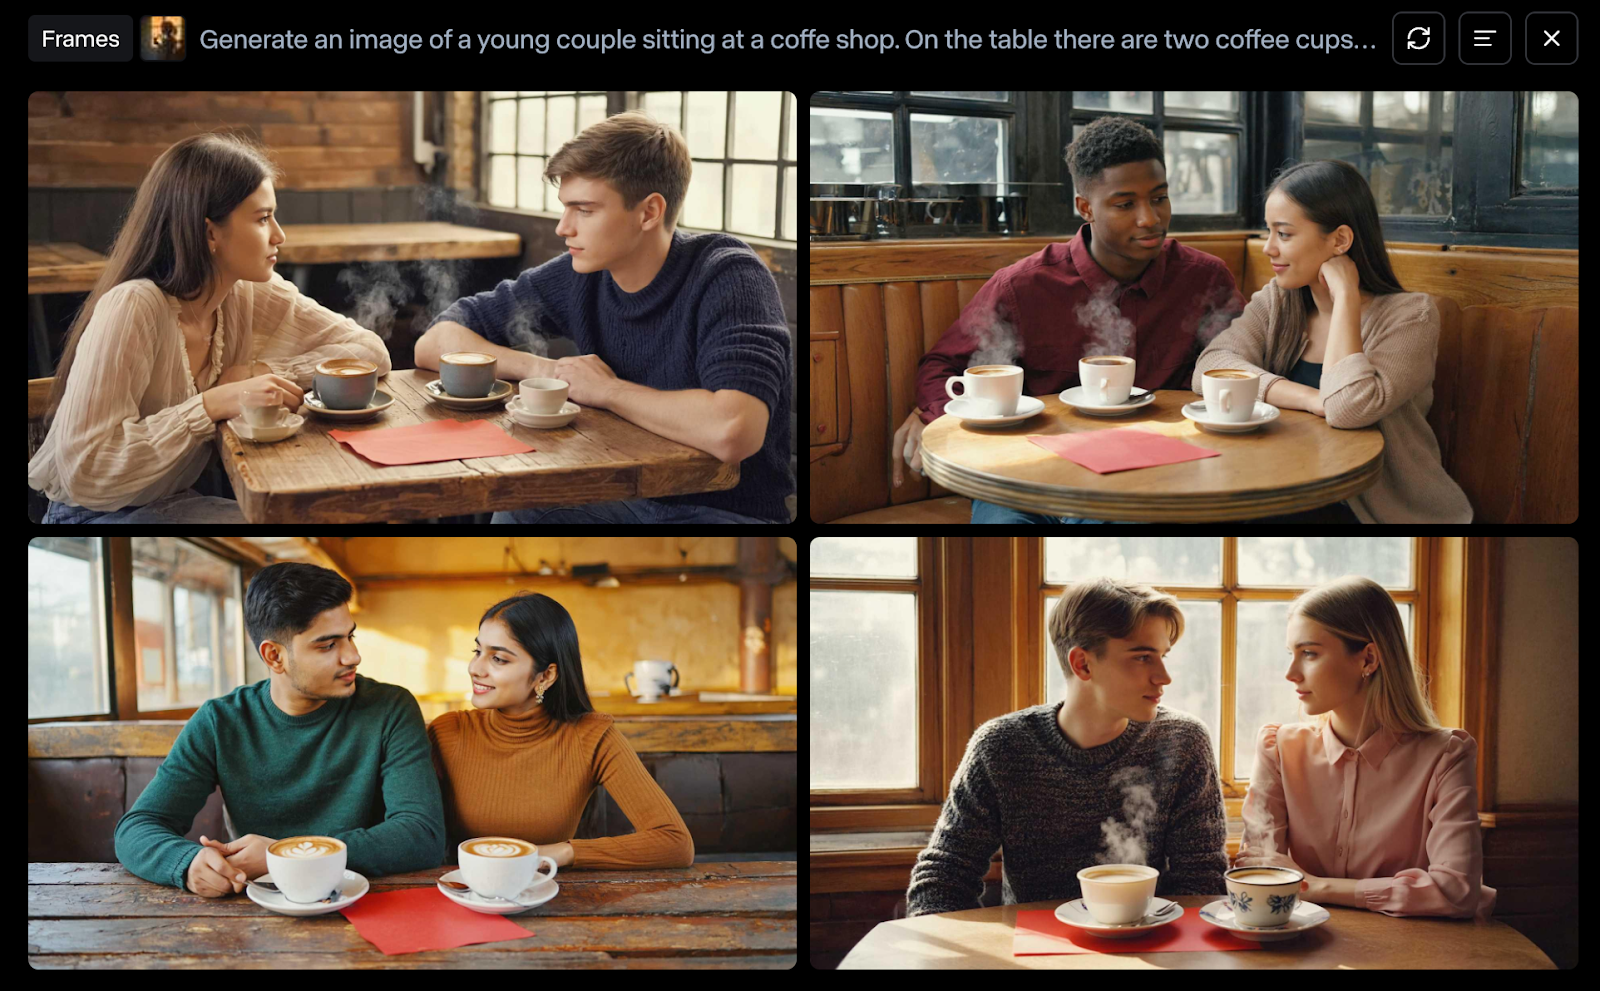
Solo las dos de abajo cumplen el prompt. Vemos que en ambas imágenes de arriba hay más de dos tazas de café, y la primera incluso tiene artefactos extraños.
Pedí un papel rojo sobre la mesa porque quería generar un vídeo a partir de esta imagen del hombre haciendo una flor de origami para dársela a la chica.
Para hacerlo, podemos pasar el ratón sobre la imagen que queramos usar y hacer clic en el botón «Use»:
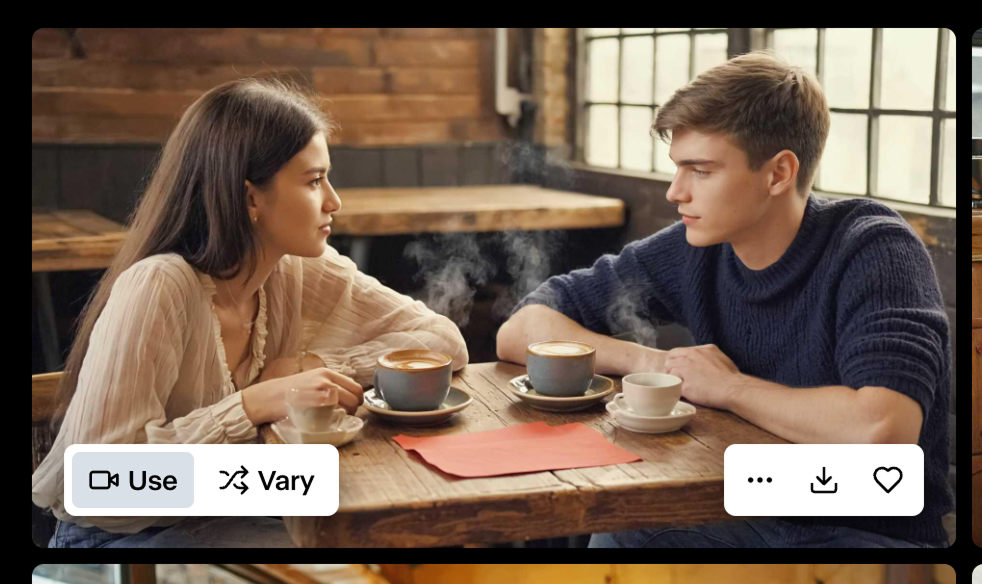
Creé un prompt pidiendo un vídeo con cámara fija del hombre haciendo una flor de origami y dándosela a la chica. Lo probé dos veces, primero generando un vídeo de 5 segundos y luego uno de 10. Esta vez los resultados fueron bastante decepcionantes (aquí usé Gen-4):
Funciones que faltan para la consistencia de personajes
He estado probando muchas herramientas de generación de vídeo con IA en las últimas semanas. Uno de los principales problemas al crear contenido más largo es poder mantener al mismo personaje en varias escenas. Estas herramientas normalmente permiten generar vídeos de pocos segundos. Eso basta para montar un vídeo largo combinando varias escenas, pero necesitamos que el mismo personaje aparezca en varias de ellas.
En su artículo de presentación de Gen-4, parece que el nuevo modo facilita mucho generar vídeos más largos:
Esperaba poder proporcionar una imagen de mi personaje, generar las imágenes de las escenas con ese personaje y, por último, generar cada escena con Gen-4. Sin embargo, eso no está soportado, al menos por ahora.

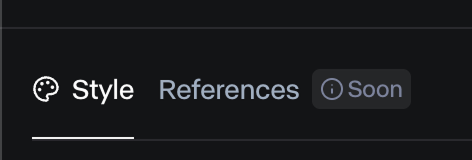
En la pestaña de generación de imágenes, vemos una función de «References» que aún no está disponible.
Esto me parece confuso porque, sin esa función, los vídeos de su anuncio sencillamente no se pueden hacer.
Cómo sortear las limitaciones de Runway
Por suerte, tanto Google como OpenAI han lanzado recientemente esta función en sus modelos de generación de imágenes. Gemini 2.0 de Google tiene un modo de storytelling que genera una serie de imágenes para una historia, mientras que el generador de imágenes de GPT-4o de OpenAI puede tomar una imagen de referencia y convertirla en lo que queramos. Si quieres saber más sobre estas dos herramientas, las cubrí aquí:
- GPT-4o Image Generation: A Guide With 8 Practical Examples
- Gemini Image Editing: A Guide With 10 Practical Examples
Generar un vídeo con el storytelling de Gemini
Aquí tienes un vídeo que creé pidiéndole a Gemini que contara una historia visual sobre una llama y una gota de agua que se enamoran pero aprenden que no pueden tocarse.
En el modo de storytelling, Gemini genera una secuencia de imágenes para contar la historia. Después, utilicé una herramienta de IA para generar prompts basados en las directrices de Runway y animar cada fotograma. Este es el resultado:
Los clips se montaron con un editor de vídeo. Hice algunos cortes y transiciones sencillas. Además, tuve que iterar bastante tanto en Gemini como en Runway hasta conseguir el fotograma que buscaba.
Estoy bastante satisfecho con el resultado. Hay algunos fallos aquí y allá, pero en general logré contar la historia que quería. De hecho, me sentí bastante triste con esta historia, lo que demuestra que incluso el contenido generado por IA puede transmitir emociones humanas reales, porque detrás sigue habiendo una persona intentando expresar un mensaje.
Generar un vídeo con la generación de imágenes de GPT-4o
Creo que GPT-4o es mucho más potente y versátil que Gemini a la hora de generar imágenes. El vídeo anterior requirió muchas iteraciones para acercarse a lo que quería, e incluso tuve que usar GPT-4o para generar uno de los fotogramas.
Quiero probar una historia sobre un aventurero que se sube a un cuadro y es teletransportado al mundo del propio cuadro.
Empecé pidiendo a GPT-4o que generase el personaje. Cuando estuve contento con el resultado, pensé en los planos que quería:
- El personaje mira el cuadro.
- Primer plano del personaje contemplando el cuadro.
- El personaje está trepando dentro del cuadro.
- El personaje ya está en el mundo del cuadro.
- Un plano aéreo muestra este nuevo mundo inmenso.
Cuando estuve conforme con los planos, usé Gen-4 para generar un vídeo con cada uno y los monté en un editor de vídeo:
Creo que no está nada mal para un primer intento. La escena en la que el hombre entra en el cuadro necesita rehacerse. Probé múltiples generaciones, pero ninguna quedó como quería.
Runway Gen-4 frente a otras herramientas
Dado que las herramientas fundamentales para mantener la consistencia de personajes aún no están disponibles en Runway, a fecha de hoy Gen-4 es básicamente un modelo de imagen a vídeo. Por eso quise compararlo con otros modelos para ver cómo rinde.
Elegí animar la primera escena del vídeo de la llama y la gota de agua, donde la llama camina hacia la derecha y sale del encuadre.
Aquí tienes una comparación en paralelo entre Runway, Sora y WanVideo:
Vemos que solo Runway logra realizar la tarea. Esto demuestra el enorme potencial del modelo cuando todas las funciones estén disponibles.
Más ejemplos de Runway Gen-4
En esta sección muestro algunos vídeos más que intenté generar para que te hagas una mejor idea de lo que Runway Gen-4 puede hacer en este momento.
Avión de papel
Tenía la idea de hacer un vídeo de alguien construyendo un avión de papel y luego haciéndolo volar. Creé cuatro planos:
- La persona está haciendo el avión.
- La persona está en un campo corriendo para lanzar el avión.
- La persona salta dentro del avión.
- La persona vuela en el avión.
En este ejemplo vemos de nuevo que el modelo tuvo dificultades con el papel. Supongo que hay demasiado detalle. Además, la escena del salto dentro del avión es muy extraña.
Animar objetos
Tenía curiosidad por ver cómo se comporta el modelo al animar objetos del mundo real, así que tomé una foto y le pedí a Gen-4 que los hiciera bailar. El resultado me parece bastante gracioso:
Semáforo
En su web tienen un ejemplo de un monigote de semáforo que cobra vida y salta fuera del semáforo. Esto me inspiró para intentar crear un pequeño vídeo de un monigote de semáforo huyendo de la policía y luego saltando a un semáforo peatonal inactivo para esconderse.
Aquí están las tres imágenes que generé con GPT-4o, junto con los vídeos:
Por desgracia, Gen-4 no fue capaz de hacer realidad mi idea. Probé múltiples iteraciones y siempre se quedaba muy lejos.
Conclusión
En general, creo que Gen-4 es un buen modelo de imagen a vídeo, sobre todo en escenas cotidianas. Sin embargo, sentí mucha fricción y frustración para conseguir que hiciera lo que yo quería.
También me pareció que su anuncio era un poco engañoso, porque algunas funciones necesarias para hacer vídeos largos consistentes todavía no están disponibles, y eso no quedaba nada claro antes de pagar la suscripción. Ojalá las empresas de IA esperasen a tener sus productos listos en lugar de inflar el hype. Si no fuera por los lanzamientos recientes de Google y OpenAI, no habría podido hacer ninguno de los vídeos que ves aquí.
Creo que Runway tiene potencial, pero aún están lejos de ofrecer un producto con el que cualquiera que tenga una historia pueda contarla. Seguimos muy lejos de poder imaginar algo, ponerlo en palabras y verlo cobrar vida.
Sus ejemplos son muy bellos y creo que están hechos con Gen-4, pero también pienso que hubo un tremendo trabajo detrás de las cámaras para hacerlos realidad.