
Lộ trình
Runway đã giới thiệu Gen-4, một mô hình chuyển ảnh thành video được thiết kế để giải quyết vấn đề dai dẳng trong video do AI tạo ra: duy trì tính nhất quán của nhân vật và bối cảnh xuyên suốt nhiều cảnh quay.
Những phim ngắn họ trình chiếu trong bản demo ra mắt rất ấn tượng, và mô hình này hứa hẹn nhiều tiềm năng. Tuy nhiên, trong bài viết này, chúng ta sẽ tự mình xem xét và đánh giá xem Runway Gen-4 có đáp ứng được kỳ vọng hay không.
Runway Gen-4 là gì?
Runway đã phát hành Gen-4, mô hình mới nhất của họ để tạo các đoạn video ngắn từ văn bản hoặc hình ảnh. Mô hình này kế thừa từ Gen-3 Alpha, ra mắt đầu năm 2024, và là một phần trong nỗ lực giúp video do AI tạo ra mạch lạc và hữu ích hơn về mặt kể chuyện.
Không giống các mô hình trước, Gen-4 chú trọng hơn vào tính nhất quán theo thời gian—đảm bảo nhân vật và vật thể được duy trì xuyên suốt khung hình và cảnh quay mà không bị biến dạng hay biến mất. Ví dụ, hãy xem phim ngắn có tên The Herd này:
Cách truy cập Runway Gen-4
Để truy cập Runway Gen-4, chúng ta cần đăng ký gói thuê bao. Lưu ý rằng tính năng này vẫn đang được triển khai, nên tùy khu vực, có thể bạn chưa dùng được hoặc chỉ có ở các gói cao cấp hơn. Tại Mỹ, gói 12 đô la cung cấp 625 tín dụng để dùng Gen-4.
Ngoài ra, ngay cả sau khi đăng ký, tôi vẫn phải đợi một ngày để tính năng này xuất hiện trên tài khoản của mình.
Cách tạo video với Runway Gen-4
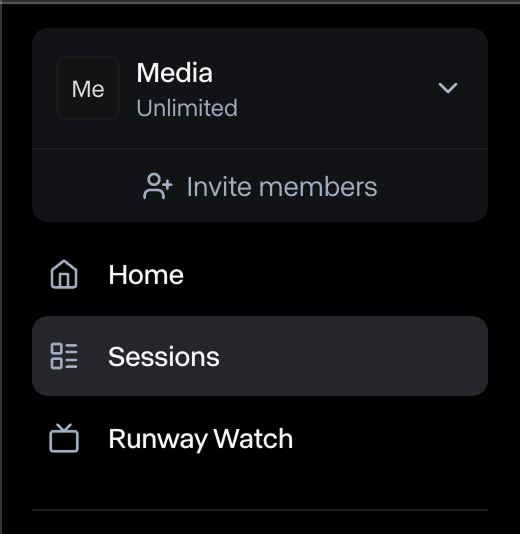
Video trong Runway ML được tạo bên trong các phiên (session). Để tạo video, trước tiên chúng ta cần tạo một phiên mới bằng cách chọn mục “Sessions” trong menu bên trái:

Sau đó, nhấp nút “New Session” ở bên phải để tạo một phiên:

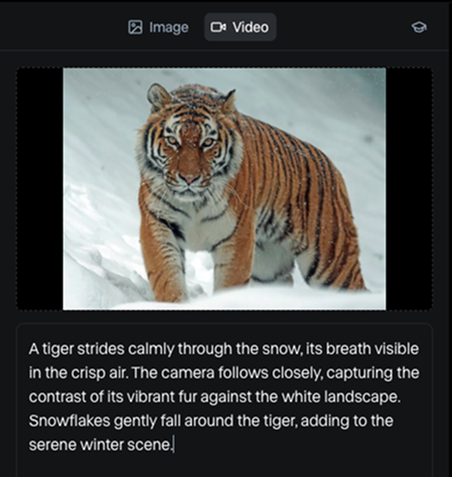
Khi mở phiên, bạn sẽ thấy một giao diện đơn giản nơi có thể kết hợp hình ảnh và lời nhắc văn bản để tạo video:
Nguồn ảnh: Pexels
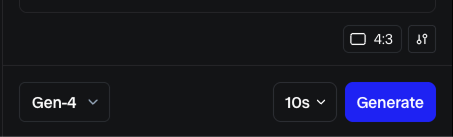
Hãy nhớ chọn mô hình Gen-4 ở phía dưới:

Đây là kết quả:
Theo tôi, video khá ổn.
Nếu bạn cần hướng dẫn tạo lời nhắc, họ cung cấp trang hướng dẫn này. Cách tôi dùng các hướng dẫn để tạo lời nhắc là tôi tạo một bot AI dựa trên những hướng dẫn đó, nhằm chuyển ý tưởng cấp cao của mình thành lời nhắc phù hợp với Runway.
Lưu ý rằng, không giống các mô hình tạo video khác, chúng ta không thể tạo video chỉ từ văn bản—mô hình luôn yêu cầu có hình ảnh.
Cách tạo hình ảnh trong Runway
Trong ví dụ đầu tiên này, tôi dùng một hình ảnh miễn phí tìm được trên mạng. Những hình như vậy có thể là nguồn tư liệu tuyệt vời để tạo video.
Runway cũng cung cấp một mô hình tạo ảnh. Tuy nhiên, vì lý do nào đó, nó không có trong gói cơ bản, và tôi phải đăng ký gói đắt nhất để truy cập.
Để tạo ảnh:
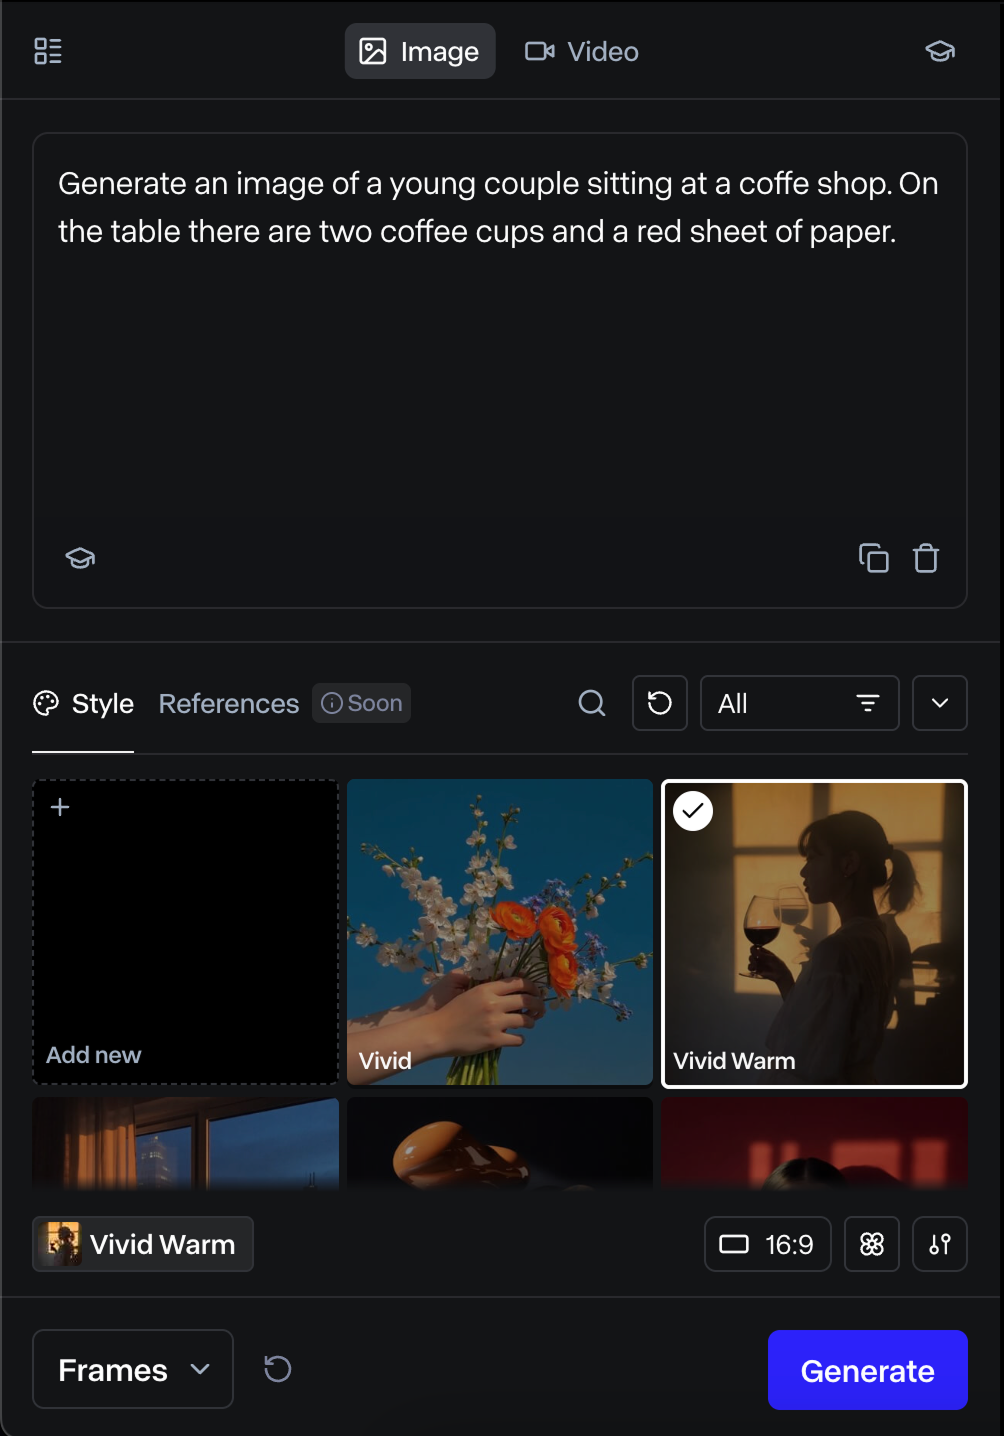
- Chọn chế độ “Image”
- Nhập lời nhắc mô tả hình ảnh
- Chọn phong cách hình ảnh (có thể tạo từ ảnh sẵn có của bạn hoặc preset do Runway cung cấp).

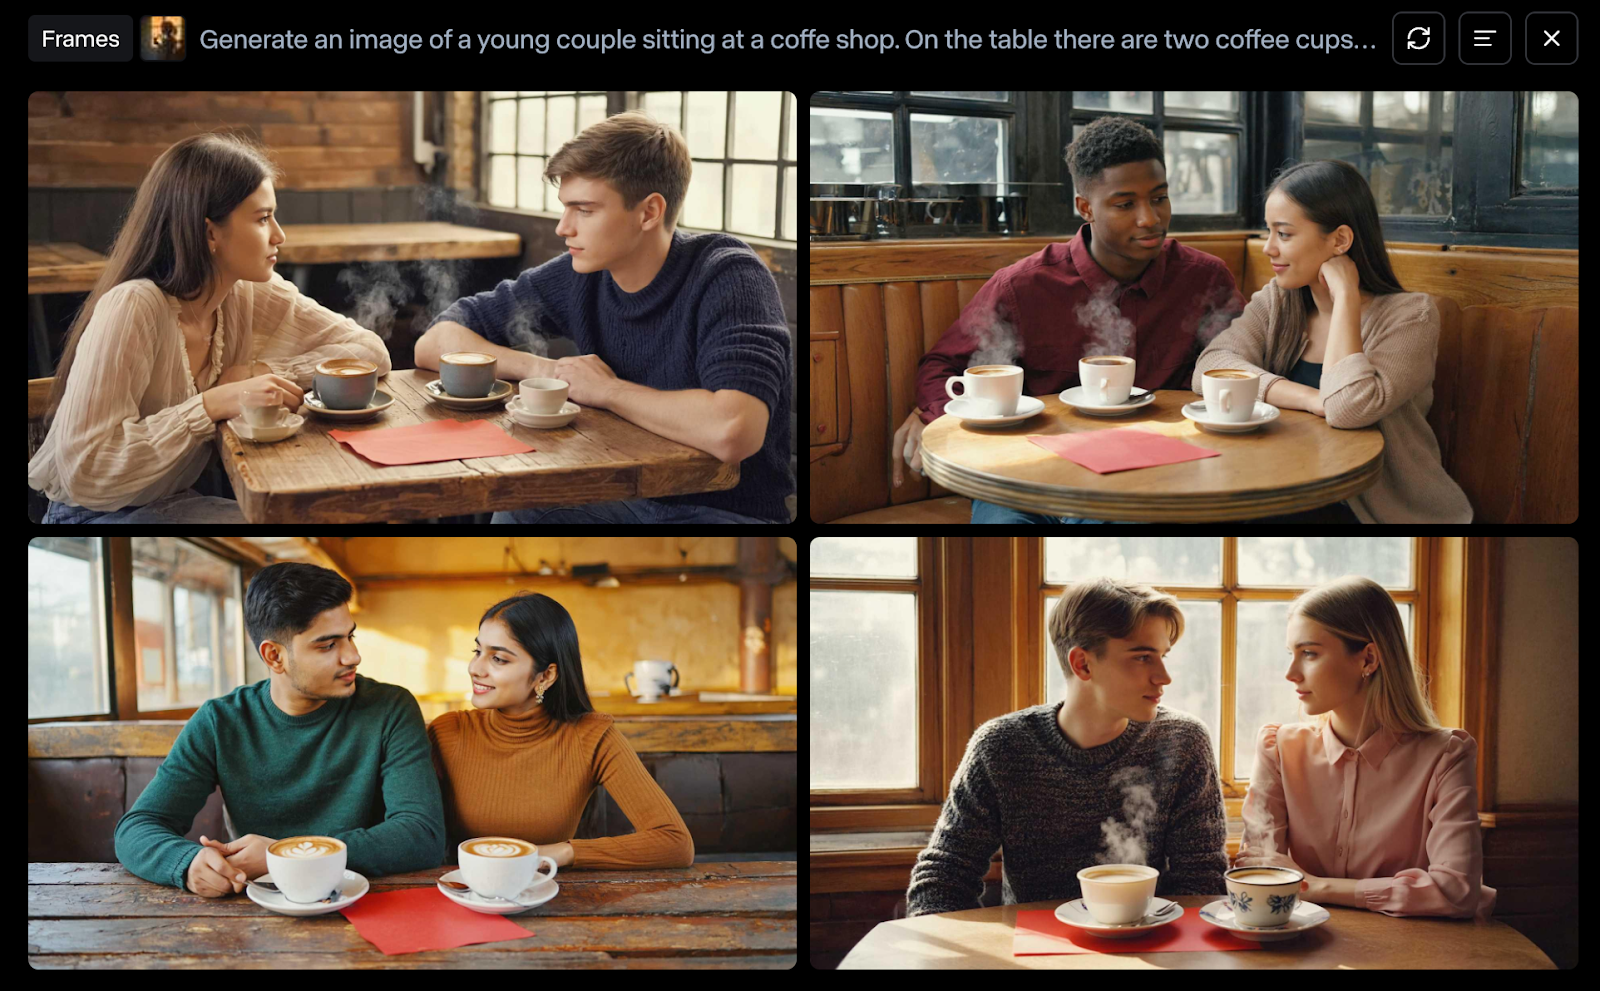
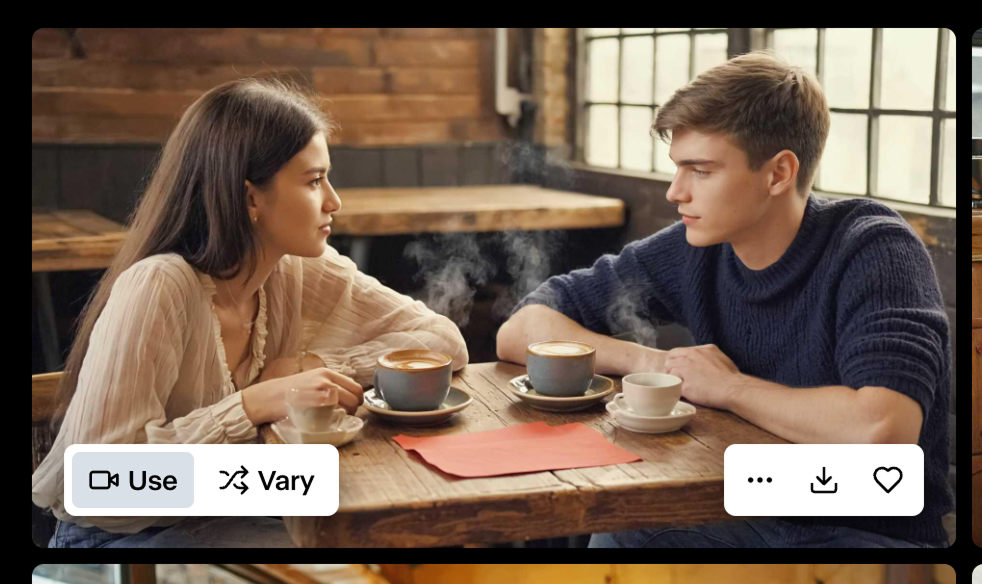
Mô hình đã tạo ra bốn hình sau:

Chỉ có hai hình phía dưới đáp ứng đúng lời nhắc. Ta có thể thấy cả hai hình phía trên đều có nhiều hơn hai tách cà phê, và hình đầu tiên còn có vài lỗi tạo tác kỳ lạ.
Lý do tôi yêu cầu có tờ giấy đỏ trên bàn là vì tôi muốn tạo video từ hình ảnh người đàn ông gấp hoa giấy origami để tặng cô gái.
Để làm vậy, chúng ta có thể di chuột lên hình muốn dùng và nhấp nút “Use”:
Tôi đã tạo một lời nhắc yêu cầu làm video với camera cố định về người đàn ông gấp hoa origami và đưa cho cô gái. Tôi thử hai lần, một lần tạo video 5 giây rồi 10 giây. Kết quả lần này khá thất vọng (tôi dùng Gen-4 ở đây):
Tính năng còn thiếu để duy trì nhân vật nhất quán
Vài tuần qua tôi đã thử nghiệm nhiều công cụ tạo video bằng AI. Một trong những vấn đề chính khi làm nội dung dài là khả năng giữ cùng một nhân vật xuyên suốt nhiều cảnh. Các công cụ này thường cho phép tạo video dài vài giây. Như vậy đủ để ghép nhiều cảnh thành video dài, nhưng chúng ta cần khả năng để cùng một nhân vật xuất hiện trong nhiều cảnh.
Trong bài giới thiệu Gen-4, họ khiến người đọc nghĩ rằng rất dễ dùng chế độ mới để tạo video dài hơn:
Tôi kỳ vọng có thể cung cấp ảnh nhân vật của mình, tạo ảnh cho các bối cảnh có nhân vật đó, rồi cuối cùng tạo từng cảnh bằng Gen-4. Tuy nhiên, hiện tại điều đó chưa được hỗ trợ, ít nhất là bây giờ.

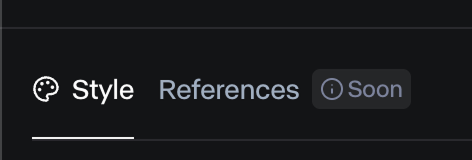
Trong tab tạo ảnh, ta thấy tính năng “References” nhưng chưa dùng được.
Tôi thấy điều này gây hiểu lầm vì không có tính năng đó, các video trong thông báo của họ đơn giản là không thể thực hiện.
Cách khắc phục hạn chế của Runway
May mắn là cả Google và OpenAI gần đây đã phát hành tính năng này trong các mô hình tạo ảnh của họ. Gemini 2.0 của Google có chế độ kể chuyện sẽ tạo một loạt ảnh cho một câu chuyện nhất định, trong khi trình tạo ảnh của GPT-4o từ OpenAI có thể nhận ảnh tham chiếu và biến nó thành bất cứ thứ gì chúng ta muốn. Nếu bạn muốn tìm hiểu thêm về hai công cụ này, tôi đã đề cập ở đây:
- Tạo ảnh với GPT-4o: Hướng dẫn kèm 8 ví dụ thực tiễn
- Chỉnh sửa ảnh với Gemini: Hướng dẫn kèm 10 ví dụ thực tiễn
Tạo video với chế độ kể chuyện của Gemini
Đây là một video tôi tạo khi nhờ Gemini kể một câu chuyện trực quan về một ngọn lửa và một giọt nước yêu nhau nhưng hiểu rằng họ không thể chạm vào nhau.
Trong chế độ kể chuyện, Gemini tạo ra chuỗi hình ảnh để kể một câu chuyện bằng hình. Sau đó, tôi dùng một công cụ AI để tạo lời nhắc dựa trên hướng dẫn của Runway nhằm tạo chuyển động cho từng khung hình. Đây là kết quả:
Các đoạn clip được ghép lại bằng phần mềm chỉnh sửa video. Tôi có cắt ghép và thêm vài chuyển cảnh đơn giản. Ngoài ra, tôi phải lặp đi lặp lại khá nhiều với cả Gemini và Runway để có được khung hình mong muốn.
Tôi khá hài lòng với kết quả. Có vài lỗi nhỏ đây đó, nhưng nhìn chung, tôi đã kể được câu chuyện mình muốn. Thực sự tôi thấy khá buồn với câu chuyện này, cho thấy ngay cả nội dung do AI tạo ra cũng có thể chứa đựng cảm xúc chân thật của con người, vì sau tất cả vẫn có một con người đang cố gắng truyền tải thông điệp.
Tạo video với GPT-4o bằng cách tạo ảnh
Tôi cho rằng GPT-4o mạnh mẽ và linh hoạt hơn nhiều trong việc tạo ảnh so với Gemini. Video trước đó đòi hỏi rất nhiều vòng lặp để đến gần điều tôi muốn, và tôi thậm chí còn phải dùng GPT-4o để tạo một trong các khung hình.
Tôi muốn thử một câu chuyện về một nhà phiêu lưu trèo vào trong một bức tranh và được dịch chuyển vào thế giới bên trong bức tranh.
Tôi bắt đầu bằng cách nhờ GPT-4o tạo nhân vật. Khi đã ưng ý, tôi nghĩ về các khung hình mong muốn:
- Nhân vật đang nhìn vào bức tranh.
- Cận cảnh gương mặt nhân vật đang suy ngẫm về bức tranh.
- Nhân vật đang trèo vào bên trong bức tranh.
- Nhân vật hiện ở trong thế giới của bức tranh.
- Một cảnh quay trên không cho thấy thế giới mới rộng lớn này.
Khi đã hài lòng với các khung hình, tôi dùng Gen-4 để tạo video cho từng khung và ghép chúng lại bằng phần mềm chỉnh sửa video:
Tôi nghĩ không tệ cho một lần thử đầu tiên. Cảnh người đàn ông bước vào bức tranh cần làm lại. Tôi đã thử nhiều lần tạo nhưng không lần nào đạt đúng như ý.
Runway Gen-4 so với các công cụ khác
Vì những công cụ nền tảng để giữ nhân vật nhất quán vẫn chưa có trên Runway tính đến thời điểm viết bài, Gen-4 hiện chỉ là mô hình chuyển ảnh thành video. Do đó, tôi muốn so sánh với các mô hình khác để xem hiệu năng của nó.
Tôi chọn tạo chuyển động cho cảnh đầu tiên của video Ngọn Lửa và Giọt Nước, nơi ngọn lửa đi sang phải và rời khỏi khung hình.
Dưới đây là so sánh cạnh nhau giữa Runway, Sora và WanVideo:
Ta có thể thấy chỉ Runway thực hiện được nhiệm vụ. Điều này cho thấy mô hình có tiềm năng rất lớn khi toàn bộ tính năng được mở.
Nhiều ví dụ Gen-4 khác
Trong phần này, tôi trình bày thêm vài video đã thử tạo để giúp bạn hiểu rõ hơn Runway Gen-4 có thể làm gì ở giai đoạn hiện tại.
Máy bay giấy
Tôi có ý tưởng làm video về một người gấp máy bay giấy rồi cho nó bay. Tôi tạo bốn khung:
- Người đó đang gấp máy bay.
- Người đó ở cánh đồng chạy để ném máy bay.
- Người đó nhảy vào trong máy bay.
- Người đó đang bay trên máy bay.
Trong ví dụ này, ta lại thấy mô hình gặp khó với tờ giấy. Tôi đoán là quá nhiều chi tiết. Ngoài ra, cảnh nhảy vào máy bay cũng rất kỳ lạ.
Làm vật thể chuyển động
Tôi tò mò xem mô hình xử lý việc làm chuyển động các vật thể đời thực ra sao, nên tôi chụp một bức ảnh và nhờ Gen-4 cho chúng nhảy múa. Kết quả theo tôi là khá vui nhộn:
Đèn giao thông
Trên website của họ có ví dụ một hình người que trên đèn giao thông sống dậy và nhảy ra khỏi đèn. Điều này truyền cảm hứng để tôi thử tạo một video ngắn về người que đèn giao thông chạy trốn cảnh sát rồi nhảy vào một đèn dành cho người đi bộ đang tắt để ẩn náu.
Đây là ba hình tôi tạo bằng GPT-4o, kèm theo các video:
Đáng tiếc, Gen-4 đã không thể hiện thực hóa ý tưởng của tôi. Tôi thử nhiều vòng lặp nhưng kết quả luôn khác xa mong muốn.
Kết luận
Nhìn chung, tôi thấy Gen-4 là một mô hình chuyển ảnh thành video tốt, đặc biệt với các bối cảnh quen thuộc. Tuy vậy, tôi gặp khá nhiều vướng mắc và thất vọng khi cố gắng khiến nó làm đúng theo ý mình.
Tôi cũng cảm thấy thông báo ra mắt của họ hơi gây hiểu lầm vì một số tính năng để tạo video dài có tính nhất quán vẫn chưa có, và điều đó hoàn toàn không rõ ràng trước khi mua gói thuê bao. Tôi ước các công ty AI hãy đợi sản phẩm hoàn thiện thay vì thổi phồng quá sớm. Nếu không có các bản phát hành gần đây của Google và OpenAI, tôi đã không thể làm bất kỳ video nào trong bài này.
Tôi nghĩ Runway đầy hứa hẹn, nhưng họ vẫn còn xa mới có thể cung cấp một sản phẩm để bất kỳ ai có câu chuyện muốn kể cũng có thể thực hiện. Chúng ta vẫn còn cách rất xa viễn cảnh chỉ cần tưởng tượng điều gì đó, diễn đạt bằng lời, và thấy nó sống động hóa.
Các ví dụ của họ rất đẹp, và tôi tin là được làm bằng Gen-4, nhưng tôi cũng nghĩ có một lượng lớn công việc hậu trường để khiến chúng thành hiện thực.