
Accéder au contenu principal

Runway Gen-4 : guide avec exemples concrets

Découvrez les capacités de Runway Gen-4 au travers d'exemples concrets, et comment contourner ses limites en utilisant les modèles de génération d'images de GPT-4o et Gemini.
Actualisé 19 sept. 2026  · 8 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Runway a présenté Gen-4, un modèle image-vers-vidéo conçu pour répondre à un problème récurrent de la vidéo générée par l'IA : maintenir la cohérence des personnages et des scènes sur plusieurs plans.

Les courts-métrages montrés lors de la démo de lancement sont très réussis, et le modèle est plein de promesses. Toutefois, examinons-le nous-mêmes dans cet article pour voir si Runway Gen-4 est à la hauteur des attentes.

Qu'est-ce que Runway Gen-4 ?

Runway a lancé Gen-4, son dernier modèle pour générer de courts clips vidéo à partir de texte ou d'images. Ce modèle succède à Gen-3 Alpha, lancé début 2024, et s'inscrit dans une série d'efforts pour rendre la vidéo générée par l'IA plus cohérente et utile sur le plan narratif.

Contrairement aux versions précédentes, Gen-4 met davantage l'accent sur la cohérence temporelle : il veille à ce que les personnages et les objets persistent d'un cadre à l'autre et d'un plan à l'autre sans se déformer ni disparaître. Par exemple, regardez ce court-métrage intitulé The Herd :

Comment accéder à Runway Gen-4

Pour accéder à Runway Gen-4, il faut un abonnement. Notez que le déploiement est progressif : selon votre région, il se peut qu'il ne soit pas encore disponible ou qu'il ne le soit que sur des offres supérieures. Aux États-Unis, un abonnement à 12 $ donne 625 crédits pour utiliser Gen-4.

Par ailleurs, même après avoir souscrit, j'ai dû attendre un jour avant qu'il ne soit activé sur mon compte.

Comment générer une vidéo avec Runway Gen-4

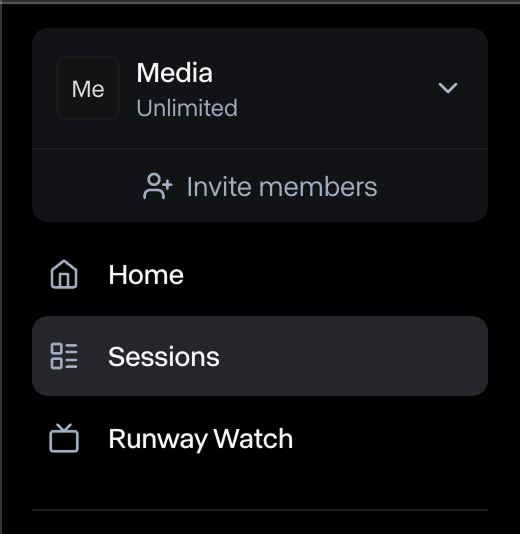
Les vidéos dans Runway ML se génèrent au sein de sessions. Pour créer une vidéo, commencez par créer une nouvelle session en sélectionnant l'onglet « Sessions » dans le menu de gauche :

runway gen 4 sesions tab

Cliquez ensuite sur le bouton « New Session » à droite pour créer une session :

new session button

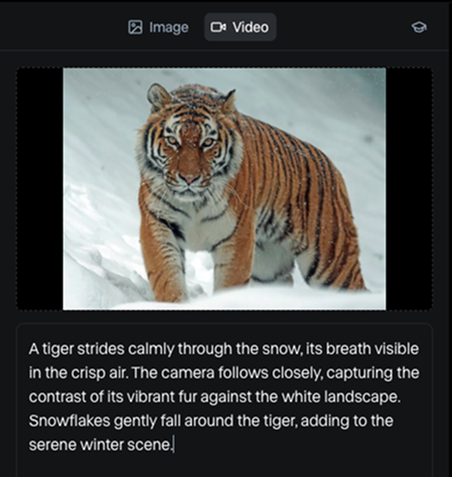
En ouvrant la session, vous accédez à une interface simple où combiner une image et un prompt textuel pour générer une vidéo :

runway image and text as a prompt

Source de l'image : Pexels

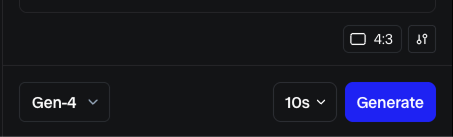
Veillez à sélectionner le modèle Gen-4 en bas de l'écran :

how to select the Runway gen 4 model

Voici le résultat :

La vidéo est plutôt réussie à mon avis.

Si vous avez besoin d'aide pour rédiger un prompt, Runway propose cette page de recommandations. Pour générer mes prompts, j'ai créé un agent IA intégrant ces consignes afin de transformer mes idées en prompts Runway exploitables.

Notez que, contrairement à d'autres modèles de génération vidéo, on ne peut pas générer une vidéo à partir du seul texte : le modèle exige toujours une image.

Comment créer une image dans Runway

Dans ce premier exemple, j'ai utilisé une image libre de droits trouvée en ligne. C'est une excellente ressource pour créer des vidéos.

Runway propose également un modèle de génération d'images. Cependant, pour une raison quelconque, il n'était pas disponible dans l'offre de base, et j'ai dû m'abonner à leur formule la plus chère pour y accéder.

Pour générer une image :

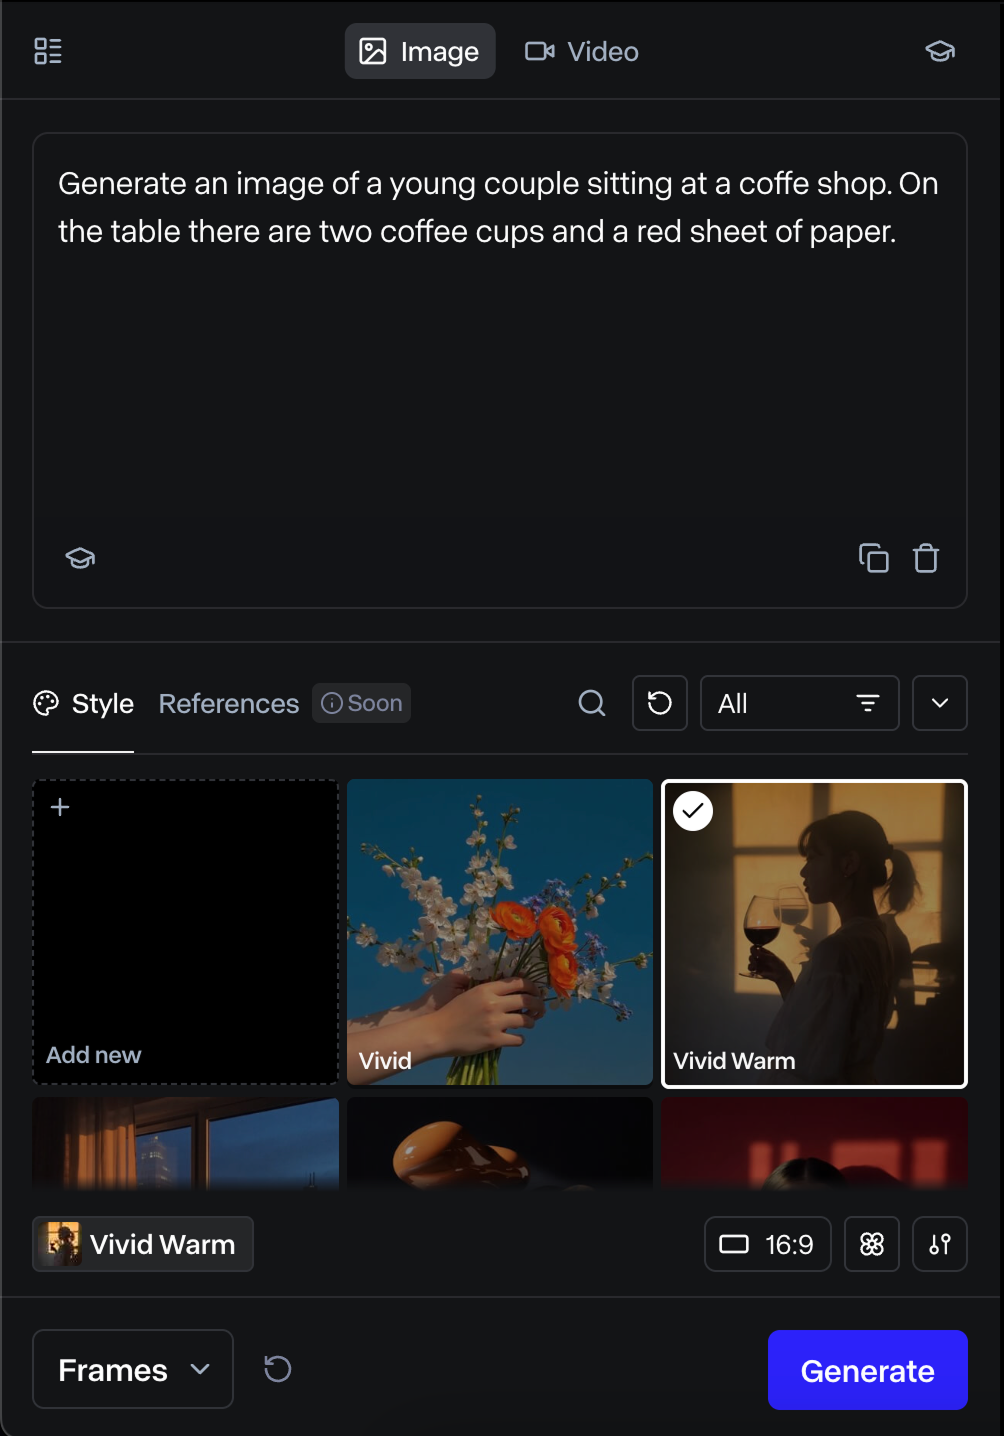
  1. Sélectionnez le mode « Image »
  2. Saisissez un prompt décrivant l'image
  3. Choisissez le style de l'image (il peut être généré à partir d'une image existante ou d'un préréglage fourni par Runway).

how to creat a video in runway

Le modèle a généré ces quatre images :
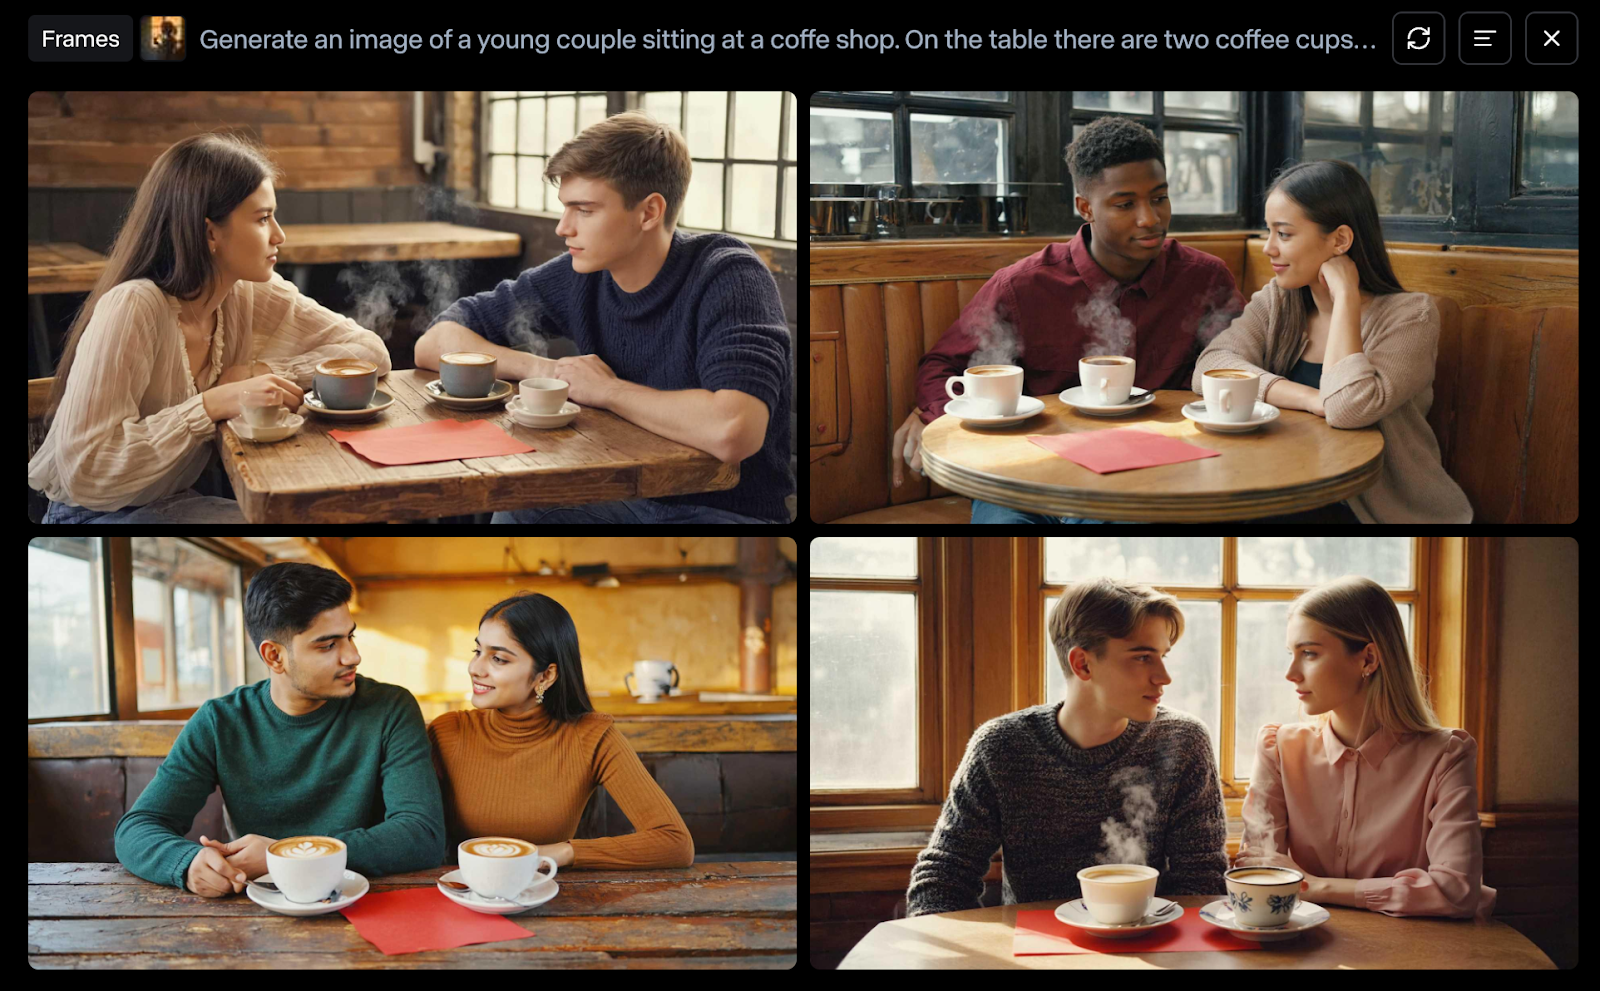
image output with runway

Seules les deux du bas respectent le prompt. On voit que les deux images du haut comportent plus de deux tasses de café, et la première présente même d'étranges artéfacts.

J'ai demandé une feuille rouge sur la table car je voulais générer une vidéo à partir de cette image de l'homme qui réalise une fleur en origami pour l'offrir à la jeune femme.

Pour ce faire, survolez l'image à utiliser et cliquez sur le bouton « Use » :
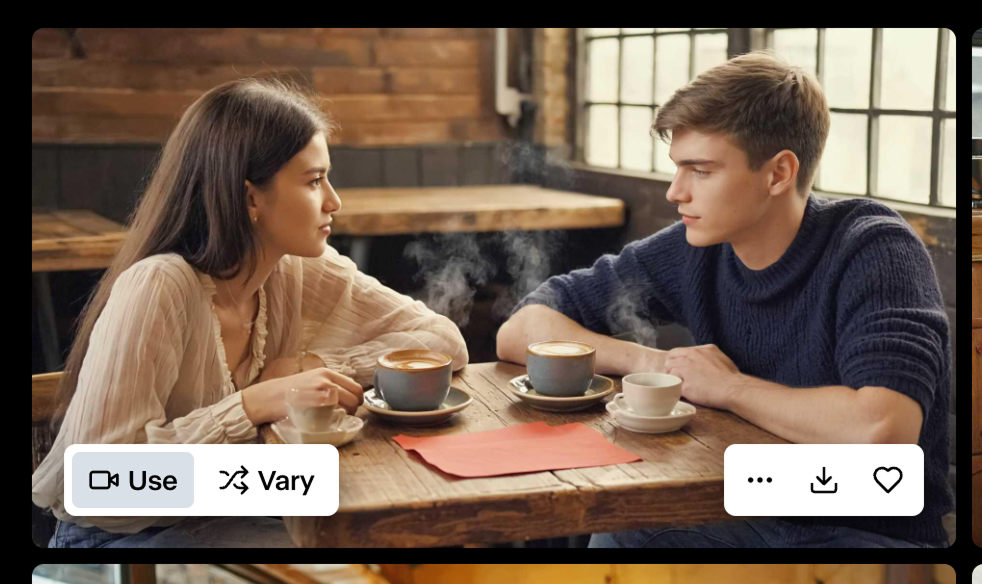
the use button in runway

J'ai conçu un prompt demandant de créer une vidéo avec caméra fixe où l'homme réalise une fleur en origami puis l'offre à la jeune femme. J'ai essayé deux fois, d'abord en 5 secondes puis en 10 secondes. Les résultats ont été assez décevants cette fois (j'ai utilisé Gen-4) :

Fonctionnalités manquantes pour la cohérence des personnages

J'ai testé de nombreux outils de génération vidéo par IA ces dernières semaines. L'un des principaux obstacles à la création de contenus plus longs est de pouvoir conserver le même personnage sur plusieurs scènes. Ces outils permettent généralement de générer des vidéos de quelques secondes. C'est suffisant pour composer une vidéo plus longue en assemblant des plans, mais il faut pouvoir y faire apparaître le même personnage à plusieurs reprises.

Dans leur article de présentation de Gen-4, ils laissent entendre qu'il est très simple d'utiliser le nouveau mode pour générer des vidéos plus longues :

Je m'attendais à pouvoir fournir l'image de mon personnage, générer les images des scènes avec ce personnage, puis générer chaque scène avec Gen-4. Or ce n'est pas pris en charge, du moins pour l'instant.

the references feature in runway will be available soon

Dans l'onglet de génération d'images, on aperçoit une fonctionnalité « References » qui n'est pas encore disponible.

Je trouve cela trompeur, car sans cette fonctionnalité, les vidéos de leur annonce ne sont tout simplement pas réalisables.

Contourner les limites de Runway

Heureusement, Google et OpenAI ont récemment proposé cette capacité dans leurs modèles d'images. Le storytelling de Gemini 2.0 de Google génère une série d'images pour un récit donné, tandis que le générateur d'images de GPT-4o d'OpenAI peut partir d'une image de référence et la décliner selon nos besoins. Pour en savoir plus sur ces deux outils, je les ai présentés ici :

Générer une vidéo avec le storytelling de Gemini

Voici une vidéo que j'ai créée en demandant à Gemini de raconter une histoire visuelle : une flamme et une goutte d'eau tombent amoureuses mais apprennent qu'elles ne peuvent pas se toucher.

En mode storytelling, Gemini génère une séquence d'images pour raconter une histoire visuelle. Ensuite, j'ai utilisé un outil d'IA pour générer des prompts conformes aux lignes directrices de Runway afin d'animer chaque image. Voici le résultat :

Les clips ont été assemblés dans un logiciel de montage vidéo. J'ai effectué quelques coupes et des transitions simples. J'ai aussi dû itérer de nombreuses fois sur Gemini et Runway pour obtenir les images souhaitées.

Je suis plutôt satisfait du résultat. Il y a quelques accros ici et là, mais globalement, j'ai pu raconter l'histoire que je voulais. Cette histoire m'a même rendu assez triste : elle montre que même un contenu généré par l'IA peut transmettre de véritables émotions humaines car, derrière tout cela, il y a toujours un humain qui cherche à faire passer un message.

Générer une vidéo avec la génération d'images de GPT-4o

Je trouve GPT-4o bien plus puissant et polyvalent que Gemini pour générer des images. La vidéo précédente a nécessité beaucoup d'itérations pour s'approcher de ce que je voulais, et j'ai même dû utiliser GPT-4o pour générer l'un des cadres.

Je veux tenter l'histoire d'un aventurier qui grimpe dans un tableau et se retrouve téléporté dans le monde représenté par ce tableau.

J'ai d'abord demandé à GPT-4o de générer le personnage. Une fois satisfait du résultat, j'ai défini les plans souhaités :

  1. Le personnage regarde le tableau.
  2. Gros plan sur le visage du personnage qui contemple le tableau.
  3. Le personnage grimpe à l'intérieur du tableau.
  4. Le personnage est désormais dans le monde du tableau.
  5. Un plan aérien révèle l'immensité de ce nouveau monde.

Une fois les cadres validés, j'ai utilisé Gen-4 pour générer une vidéo pour chacun, puis je les ai assemblés dans un logiciel de montage :

Pour un premier essai, ce n'est pas si mal. La scène où l'homme entre dans le tableau mériterait d'être retravaillée. J'ai testé de multiples générations, sans obtenir exactement le rendu souhaité.

Runway Gen-4 vs d'autres outils

Puisque les briques essentielles pour assurer la cohérence des personnages ne sont pas encore disponibles sur Runway à ce jour, Gen-4 demeure un modèle image-vers-vidéo. J'ai donc souhaité le comparer à d'autres modèles pour évaluer ses performances.

J'ai choisi d'animer la première scène de la vidéo « Flamme et goutte d'eau », où la flamme marche vers la droite et sort du cadre.

Voici une comparaison côte à côte entre Runway, Sora et WanVideo :

On constate qu'il n'y a que Runway qui parvient à réaliser la tâche. Cela montre l'énorme potentiel de ce modèle une fois toutes les fonctionnalités disponibles.

D'autres exemples avec Runway Gen-4

Dans cette section, je présente quelques autres vidéos que j'ai tenté de générer pour vous donner une idée plus précise de ce que Runway Gen-4 sait faire à ce stade.

Avion en papier

J'avais l'idée de produire une vidéo où quelqu'un construit un avion en papier puis le fait voler. J'ai conçu quatre plans :

  • La personne fabrique l'avion.
  • La personne court dans un champ pour lancer l'avion.
  • La personne saute dans l'avion.
  • La personne vole à bord de l'avion.

Dans cet exemple, on voit encore que le modèle a du mal avec le papier : sans doute trop de détails. De plus, la scène où la personne saute dans l'avion est très étrange.

Animer des objets

Je voulais voir comment le modèle gère l'animation d'objets réels : j'ai pris une photo et demandé à Gen-4 de les faire danser. Le résultat est assez drôle, à mon avis :

Bonhomme de feu tricolore

Sur leur site, ils montrent un exemple où le bonhomme lumineux d'un feu piéton prend vie et saute hors du feu. Cela m'a donné envie de créer une courte vidéo d'un bonhomme de feu tricolore qui fuit la police, puis saute dans un feu piéton inactif pour s'y cacher.

Voici les trois images que j'ai générées avec GPT-4o, ainsi que les vidéos :

Malheureusement, Gen-4 n'a pas réussi à concrétiser mon idée. Malgré de multiples itérations, on restait toujours loin du compte.

Conclusion

Dans l'ensemble, Gen-4 est un bon modèle image-vers-vidéo, surtout sur des scènes familières. Mais j'ai ressenti beaucoup de frictions et de frustration pour obtenir ce que je voulais.

J'ai aussi trouvé leur annonce un peu trompeuse : certaines fonctionnalités indispensables pour des vidéos longues et cohérentes ne sont tout simplement pas encore disponibles, et ce n'était pas du tout clair avant de souscrire. J'aimerais que les entreprises d'IA attendent que leurs produits soient aboutis avant de les survendre. Sans les sorties récentes de Google et OpenAI, je n'aurais pas pu réaliser les vidéos présentées ici.

Runway est prometteur, mais reste encore loin d'un produit qui permette à toute personne ayant une histoire à raconter de la réaliser simplement. Nous sommes encore très loin de pouvoir imaginer quelque chose, le décrire, puis le voir prendre vie.

Leurs exemples sont très beaux, et je pense qu'ils ont bien été réalisés avec Gen-4, mais je crois aussi qu'ils ont nécessité énormément de travail en coulisses pour les faire aboutir.


François Aubry's photo
Author
François Aubry
LinkedIn
Ingénieur full-stack et fondateur de CheapGPT. L'enseignement a toujours été ma passion. Dès mes premiers jours d'études, j'ai cherché avec enthousiasme des occasions de donner des cours particuliers et d'aider d'autres étudiants. Cette passion m'a amenée à poursuivre un doctorat, où j'ai également été assistante d'enseignement pour soutenir mes efforts académiques. Au cours de ces années, j'ai trouvé un immense épanouissement dans le cadre d'une classe traditionnelle, en favorisant les liens et en facilitant l'apprentissage. Cependant, avec l'avènement des plateformes d'apprentissage en ligne, j'ai reconnu le potentiel de transformation de l'éducation numérique. En fait, j'ai participé activement au développement d'une telle plateforme dans notre université. Je suis profondément engagée dans l'intégration des principes d'enseignement traditionnels avec des méthodologies numériques innovantes. Ma passion est de créer des cours qui sont non seulement attrayants et instructifs, mais aussi accessibles aux apprenants à l'ère du numérique.
Sujets
Intelligence artificielle
Grands modèles linguistiques

Formez-vous à l'IA avec ces cours !

Cursus

Principes fondamentaux de l'intelligence artificielle dans le monde des affaires

12 h
Accélérez votre transition vers l'IA, maîtrisez chatGPT et développez une stratégie complète en matière d'intelligence artificielle.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow