
Programa
A Runway lançou o Gen-4, um modelo de image-to-video criado para resolver um problema persistente em vídeos gerados por IA: manter a consistência de personagens e cenários em múltiplos takes.
Os curta-metragens exibidos no demo de lançamento são muito bons, e o modelo promete bastante. Mesmo assim, vamos conferir por conta própria neste artigo e ver se o Runway Gen-4 entrega o que promete.
O que é o Runway Gen-4?
A Runway lançou o Gen-4, seu modelo mais recente para gerar clipes curtos a partir de texto ou imagens. O modelo é o sucessor do Gen-3 Alpha, lançado no início de 2024, e faz parte de uma série de esforços para tornar vídeos gerados por IA mais coerentes e úteis para narrativa.
Diferente dos modelos anteriores, o Gen-4 dá mais ênfase à consistência temporal — garantindo que personagens e objetos persistam entre quadros e cenas sem deformar ou desaparecer. Por exemplo, confira este curta chamado The Herd:
Como acessar o Runway Gen-4
Para acessar o Runway Gen-4, é necessário assinar um plano. Vale lembrar que o recurso ainda está sendo liberado gradualmente, então pode ser que, dependendo da sua região, ele não esteja disponível ainda ou só apareça nos planos mais avançados. Nos EUA, uma assinatura de US$ 12 dá 625 créditos para usar o Gen-4.
Além disso, mesmo após assinar, precisei esperar um dia até ele ficar disponível na minha conta.
Como gerar um vídeo com o Runway Gen-4
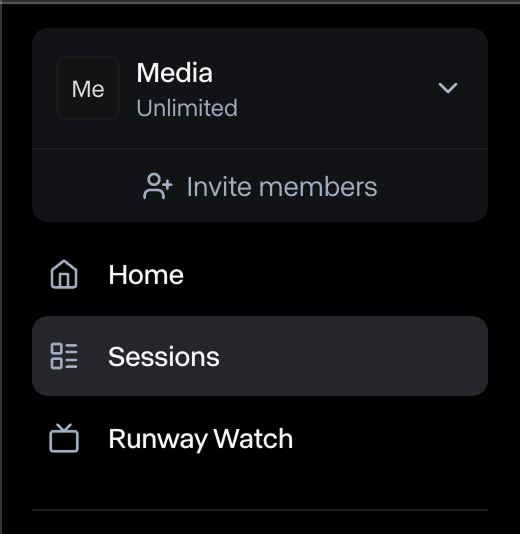
Os vídeos no Runway ML são gerados dentro de sessões. Para criar um vídeo, primeiro abrimos uma nova sessão selecionando o item "Sessions" no menu à esquerda:

Depois, clicamos no botão "New Session" à direita para criar a sessão:

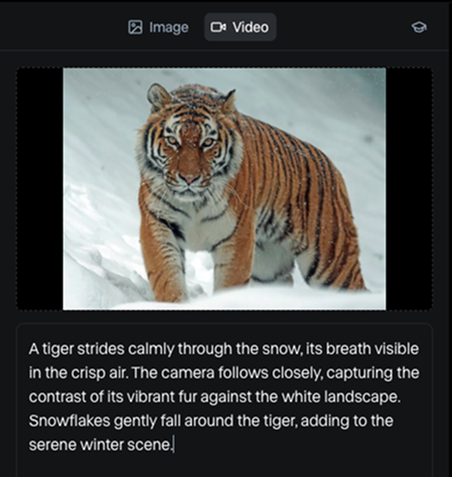
Ao abrir a sessão, vemos uma interface simples onde podemos combinar uma imagem e um prompt de texto para gerar um vídeo:
Fonte da imagem: Pexels
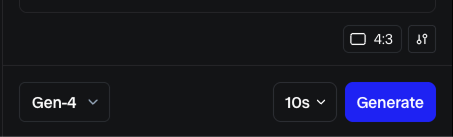
Certifique-se de selecionar o modelo Gen-4 na parte inferior:

Aqui está o resultado:
Na minha opinião, o vídeo ficou bem bom.
Se você precisar de ajuda para criar um prompt, eles disponibilizam esta página de diretrizes. Eu usei as diretrizes criando um bot de IA com essas regras para transformar minhas ideias de alto nível em prompts prontos para o Runway.
Observe que, ao contrário de outros modelos de geração de vídeo, não dá para gerar um vídeo só com texto — o modelo sempre exige uma imagem.
Como criar uma imagem no Runway
Neste primeiro exemplo, usei uma imagem de uso livre que encontrei online. Elas podem ser ótimos recursos para criar vídeos.
O Runway também oferece um modelo de geração de imagens. Porém, por algum motivo, ele não estava disponível no plano básico e precisei assinar o plano mais caro para acessar.
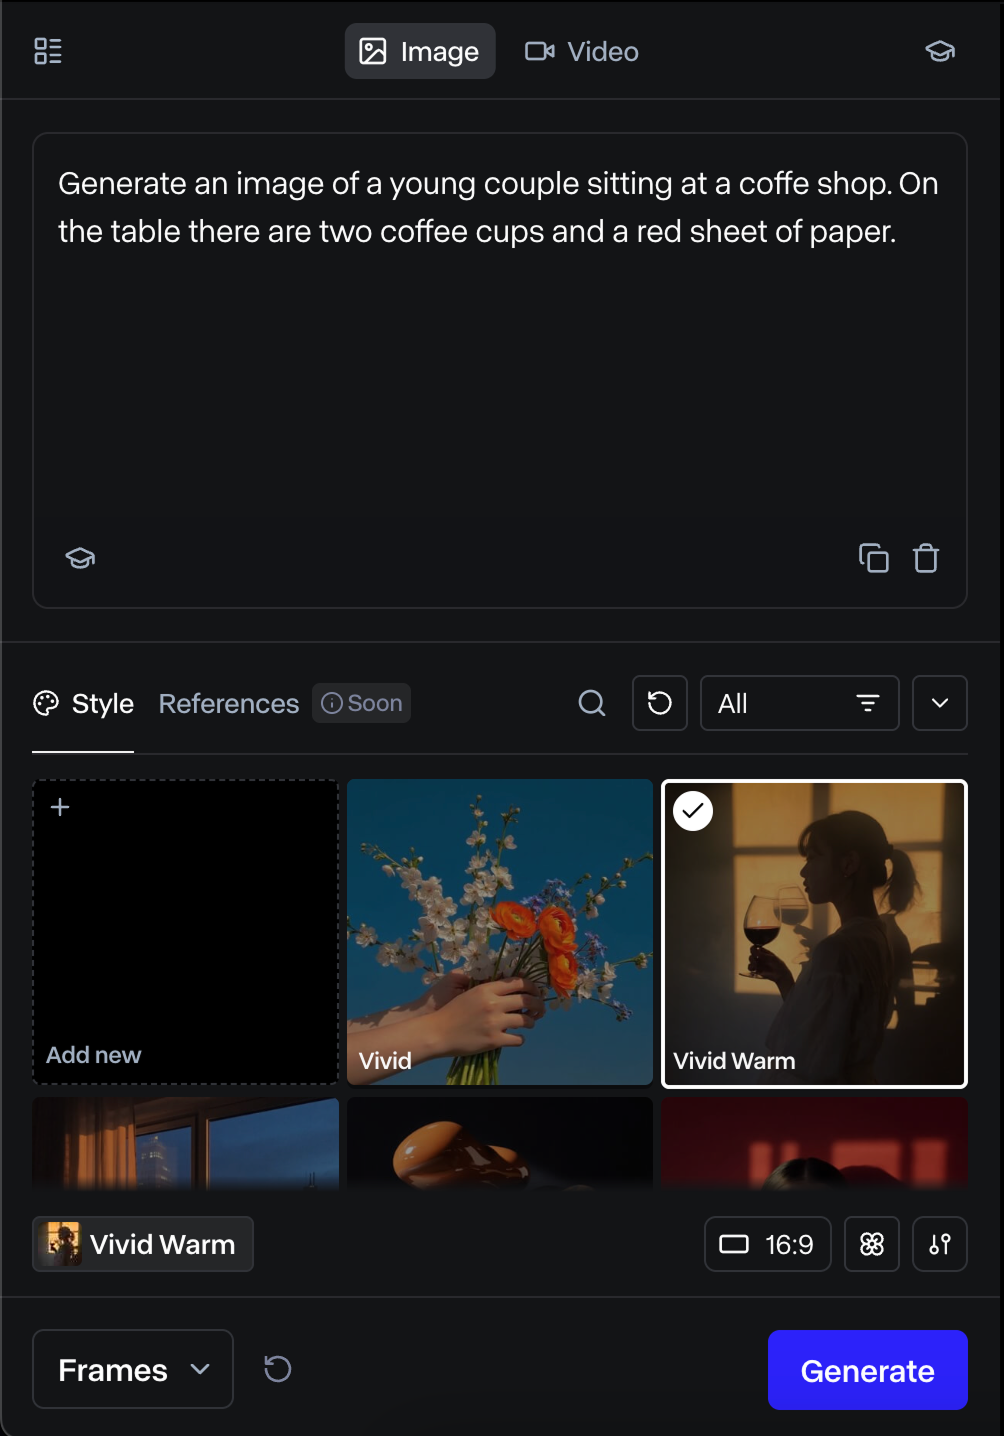
Para gerar uma imagem:
- Selecione o modo "Image"
- Digite um prompt descrevendo a imagem
- Escolha o estilo da imagem (pode ser gerado a partir de uma imagem sua ou de um preset do Runway).

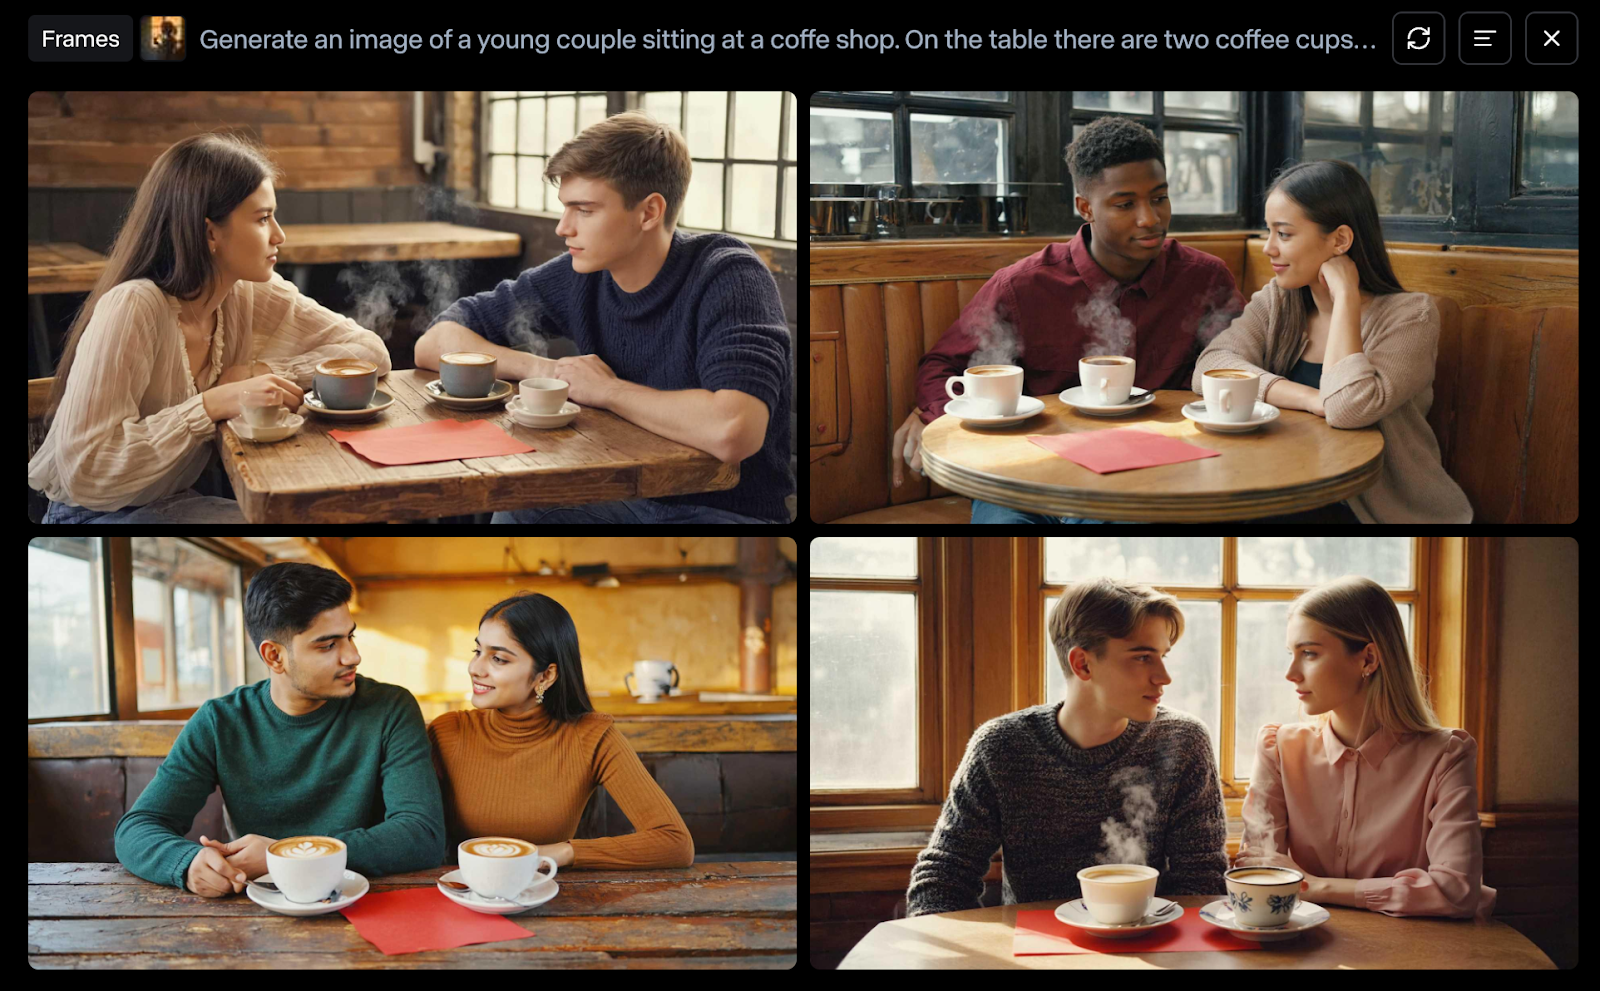
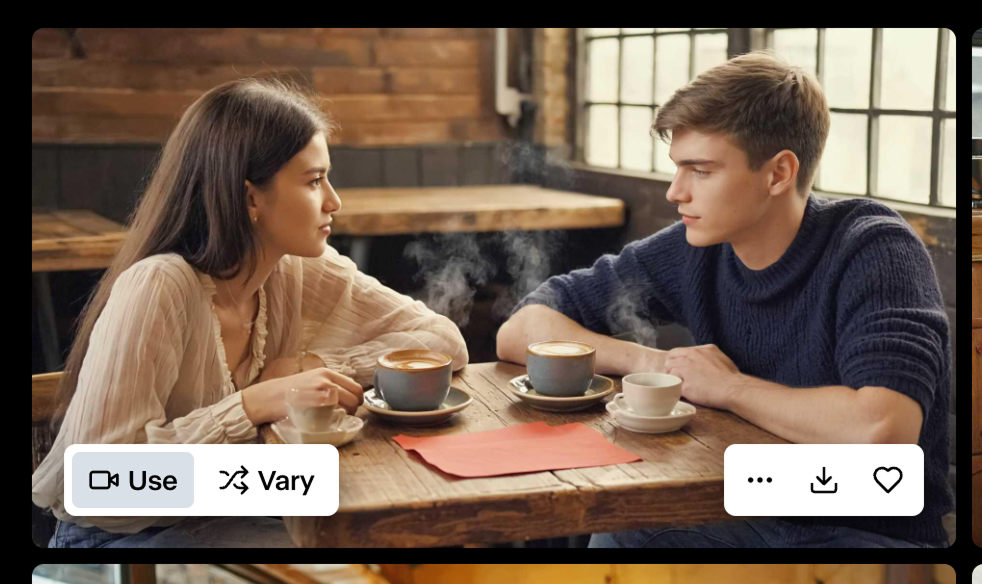
O modelo gerou estas quatro imagens:

Apenas as duas de baixo atendem ao prompt. Dá para ver que as duas de cima têm mais de duas xícaras de café, e a primeira ainda tem alguns artefatos estranhos.
O motivo de eu pedir um papel vermelho na mesa foi porque eu queria gerar um vídeo em que o homem faz uma flor de origami para dar à garota.
Para isso, passamos o mouse sobre a imagem que queremos usar e clicamos em "Use":
Criei um prompt pedindo um vídeo com câmera fixa do homem fazendo a flor de origami e entregando para a garota. Testei duas vezes: primeiro gerando um vídeo de 5 segundos e depois um de 10. Os resultados foram bem decepcionantes desta vez (usei o Gen-4 aqui):
Recursos ausentes para consistência de personagens
Nas últimas semanas, testei muitas ferramentas de geração de vídeo com IA. Um dos principais desafios para criar conteúdos mais longos é conseguir manter o mesmo personagem em várias cenas. Essas ferramentas normalmente permitem gerar vídeos de alguns segundos. Isso já dá para montar um vídeo longo combinando várias cenas, mas precisamos que o mesmo personagem apareça em vários trechos.
No artigo de introdução do Gen-4, eles dão a entender que é muito fácil usar o novo modo para gerar vídeos mais longos:
Eu esperava conseguir fornecer uma imagem do meu personagem, gerar as imagens das cenas com esse personagem e, por fim, animar cada cena com o Gen-4. Porém, isso não é suportado — pelo menos por enquanto.

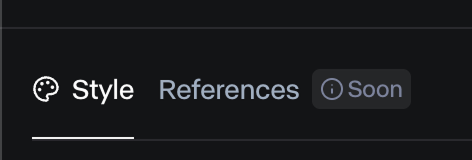
Na aba de geração de imagens, vemos um recurso de "References" que ainda não está disponível.
Acho isso confuso porque, sem esse recurso, os vídeos do anúncio simplesmente não são possíveis de fazer.
Como contornar as limitações do Runway
Felizmente, Google e OpenAI lançaram recentemente esse recurso em seus modelos de geração de imagens. O Gemini 2.0 do Google tem um modo de storytelling que gera uma sequência de imagens para uma história, enquanto o gerador de imagens do GPT-4o, da OpenAI, pode usar uma imagem de referência e transformá-la no que quisermos. Se você quiser saber mais sobre essas duas ferramentas, falei delas aqui:
- GPT-4o Image Generation: A Guide With 8 Practical Examples
- Gemini Image Editing: A Guide With 10 Practical Examples
Gerando um vídeo com o storytelling do Gemini
Aqui está um vídeo que criei pedindo ao Gemini para contar uma história visual sobre uma chama e uma gota d'água que se apaixonam, mas descobrem que não podem se tocar.
No modo de storytelling, o Gemini gera uma sequência de imagens para contar a história visual. Depois, usei uma ferramenta de IA para gerar prompts com base nas diretrizes do Runway e animar cada quadro. Veja o resultado:
Os clipes foram montados em um software de edição de vídeo. Fiz alguns cortes e transições simples. Além disso, precisei iterar bastante tanto no Gemini quanto no Runway para chegar aos quadros desejados.
Fiquei bem satisfeito com o resultado. Há alguns glitches aqui e ali, mas, no geral, consegui contar a história que eu queria. Eu até fiquei meio triste com a narrativa, o que mostra que conteúdo gerado por IA também pode carregar emoções reais — afinal, por trás de tudo ainda tem um humano tentando passar uma mensagem.
Gerando um vídeo com a geração de imagens do GPT-4o
Acho que o GPT-4o é bem mais poderoso e versátil para gerar imagens do que o Gemini. O vídeo anterior exigiu muitas iterações para chegar perto do que eu queria, e precisei até usar o GPT-4o para gerar um dos quadros.
Quero testar a história de um aventureiro que entra em um quadro e é teleportado para o mundo dentro da pintura.
Comecei pedindo ao GPT-4o para gerar o personagem. Quando fiquei satisfeito com o resultado, pensei nos quadros que eu queria:
- O personagem olhando para a pintura.
- Um close no rosto do personagem contemplando a pintura.
- O personagem está entrando dentro da pintura.
- O personagem já está no mundo da pintura.
- Uma imagem aérea mostra esse novo mundo vasto.
Quando finalizei os quadros, usei o Gen-4 para gerar um vídeo de cada um e depois juntei tudo em um software de edição:
Para uma primeira tentativa, não ficou nada mal. A cena em que o homem entra na pintura precisa de retrabalho. Testei várias gerações, mas nenhuma ficou do jeito que eu queria.
Runway Gen-4 vs. outras ferramentas
Como as ferramentas essenciais para manter consistência de personagem ainda não estão disponíveis no Runway, até o momento, o Gen-4 é basicamente um modelo de image-to-video. Por isso, quis compará-lo com outros modelos para ver seu desempenho.
Escolhi animar a primeira cena do vídeo da Chama e da Gota d'Água, em que a chama anda para a direita e sai do quadro.
Aqui está uma comparação lado a lado entre o Runway, Sora e WanVideo:
Podemos ver que só o Runway consegue executar a tarefa. Isso mostra o enorme potencial do modelo quando todos os recursos estiverem disponíveis.
Mais exemplos do Runway Gen-4
Nesta seção, trago mais alguns vídeos que tentei gerar para te ajudar a entender melhor o que o Runway Gen-4 consegue fazer neste momento.
Avião de papel
Tive a ideia de fazer um vídeo de alguém construindo um avião de papel e depois fazendo-o voar. Criei quatro quadros:
- A pessoa está fazendo o avião.
- A pessoa está em um campo correndo para arremessar o avião.
- A pessoa está pulando dentro do avião.
- A pessoa está voando no avião.
Neste exemplo, vemos novamente que o modelo teve dificuldade com o papel. Imagino que seja detalhe demais. Além disso, a cena de pular dentro do avião ficou bem estranha.
Animando objetos
Eu estava curioso para ver como o modelo lida com a animação de objetos do mundo real, então tirei uma foto e pedi ao Gen-4 para fazê-los dançar. O resultado ficou bem engraçado, na minha opinião:
Sinal de trânsito
No site deles, há um exemplo de um stickman do semáforo ganhando vida e pulando para fora do sinal. Isso me inspirou a tentar criar um vídeo curto de um stickman de semáforo fugindo da polícia e depois pulando em um semáforo de pedestres inativo para se esconder.
Aqui estão as três imagens que gerei com o GPT-4o, junto com os vídeos:
Infelizmente, o Gen-4 não conseguiu tirar a minha ideia do papel. Tentei várias iterações e o resultado sempre ficou bem distante do que eu imaginava.
Conclusão
No geral, sinto que o Gen-4 é um bom modelo de image-to-video, especialmente em cenas mais familiares. Porém, senti muita fricção e frustração para fazê-lo cumprir exatamente o que eu queria.
Também achei o anúncio um pouco enganoso, porque alguns recursos essenciais para criar vídeos longos e consistentes ainda não estão disponíveis — e isso não estava nada claro antes de assinar. Gostaria que as empresas de IA esperassem os produtos ficarem prontos em vez de criar hype. Se não fossem os lançamentos recentes do Google e da OpenAI, eu não teria conseguido fazer nenhum dos vídeos que mostrei aqui.
Acho que o Runway tem potencial, mas ainda está longe de entregar um produto que qualquer pessoa com uma história para contar consiga usar. Ainda estamos bem distantes de imaginar algo, colocar em palavras e ver ganhar vida.
Os exemplos deles são lindos, e acredito que foram feitos com o Gen-4, mas também acho que houve um trabalho enorme de bastidores para fazê-los acontecer.