
Lewati ke konten utama

Runway Gen 4: Panduan dengan Contoh Praktis

Pelajari kemampuan Runway Gen-4 melalui contoh praktis, serta cara menyiasati keterbatasannya dengan menggunakan model pembuatan gambar dari GPT-4o dan Gemini.
Diperbarui 28 Sep 2026  · 8 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Runway telah meluncurkan Gen-4, model image-to-video yang dirancang untuk mengatasi masalah yang terus berulang pada video buatan AI: menjaga konsistensi karakter dan adegan di beberapa bidikan.

Film pendek yang mereka tampilkan dalam demo peluncuran sangat bagus, dan model ini memiliki banyak potensi. Namun, kita akan meninjaunya sendiri dalam artikel ini dan melihat apakah Runway Gen-4 memenuhi ekspektasi.

Apa itu Runway Gen-4?

Runway telah merilis Gen-4, model terbarunya untuk menghasilkan klip video pendek dari teks atau gambar. Model ini merupakan penerus Gen-3 Alpha, yang diluncurkan awal 2024, dan merupakan bagian dari serangkaian upaya untuk membuat video buatan AI lebih koheren dan berguna secara naratif.

Berbeda dari model-model sebelumnya, Gen-4 menekankan konsistensi temporal—memastikan karakter dan objek bertahan di seluruh frame dan bidikan tanpa distorsi atau menghilang. Misalnya, lihat film pendek berjudul The Herd berikut ini:

Cara Mengakses Runway Gen-4

Untuk mengakses Runway Gen-4, kita memerlukan langganan. Perlu diketahui bahwa peluncurannya masih berlangsung, jadi tergantung lokasi Anda, mungkin belum tersedia atau hanya tersedia pada paket langganan tingkat lebih tinggi. Di AS, langganan $12 memberikan 625 kredit untuk menggunakan Gen-4.

Selain itu, bahkan setelah berlangganan, saya harus menunggu satu hari hingga fitur ini tersedia di akun saya.

Cara Membuat Video dengan Runway Gen-4

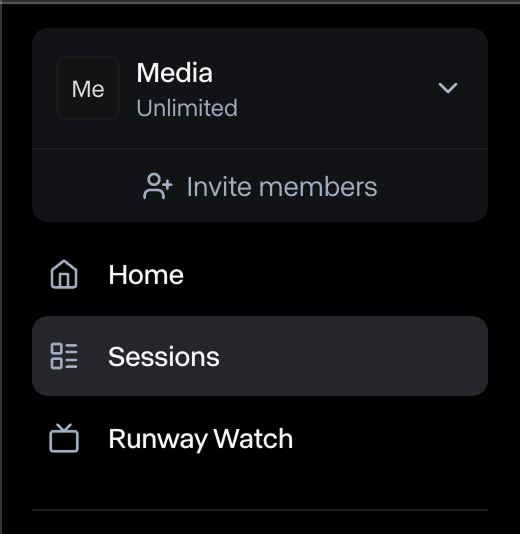
Video di Runway ML dibuat di dalam sesi. Untuk membuat video, pertama kita perlu membuat sesi baru dengan memilih item “Sessions” di menu sebelah kiri:

runway gen 4 sesions tab

Lalu klik tombol “New Session” di sebelah kanan untuk membuat sesi:

new session button

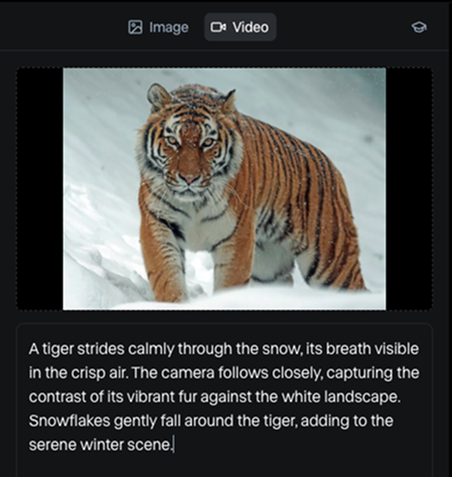
Saat kita membuka sesi, kita disajikan antarmuka sederhana di mana kita dapat menggabungkan sebuah gambar dan prompt teks untuk menghasilkan video:

runway image and text as a prompt

Sumber gambar: Pexels

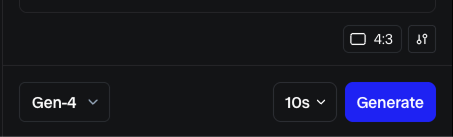
Pastikan untuk memilih model Gen-4 di bagian bawah:

how to select the Runway gen 4 model

Berikut hasilnya:

Menurut saya videonya cukup bagus.

Jika Anda membutuhkan panduan membuat prompt, mereka menyediakan halaman panduan ini. Cara saya menggunakan panduan tersebut adalah dengan membuat bot AI berdasarkan pedoman itu, yang dirancang untuk mengubah ide tingkat tinggi saya menjadi prompt Runway yang dapat digunakan.

Perhatikan bahwa, berbeda dengan model pembuat video lainnya, kita tidak dapat membuat video dari teks saja—model selalu memerlukan sebuah gambar. 

Cara membuat gambar di Runway

Pada contoh pertama ini, saya menggunakan gambar bebas pakai yang saya temukan secara online. Ini bisa menjadi sumber yang bagus untuk membuat video.

Runway juga menyediakan model pembuatan gambar. Namun, entah mengapa, fitur ini tidak tersedia pada paket dasar, dan saya harus berlangganan paket termahal mereka untuk mengaksesnya.

Untuk membuat gambar:

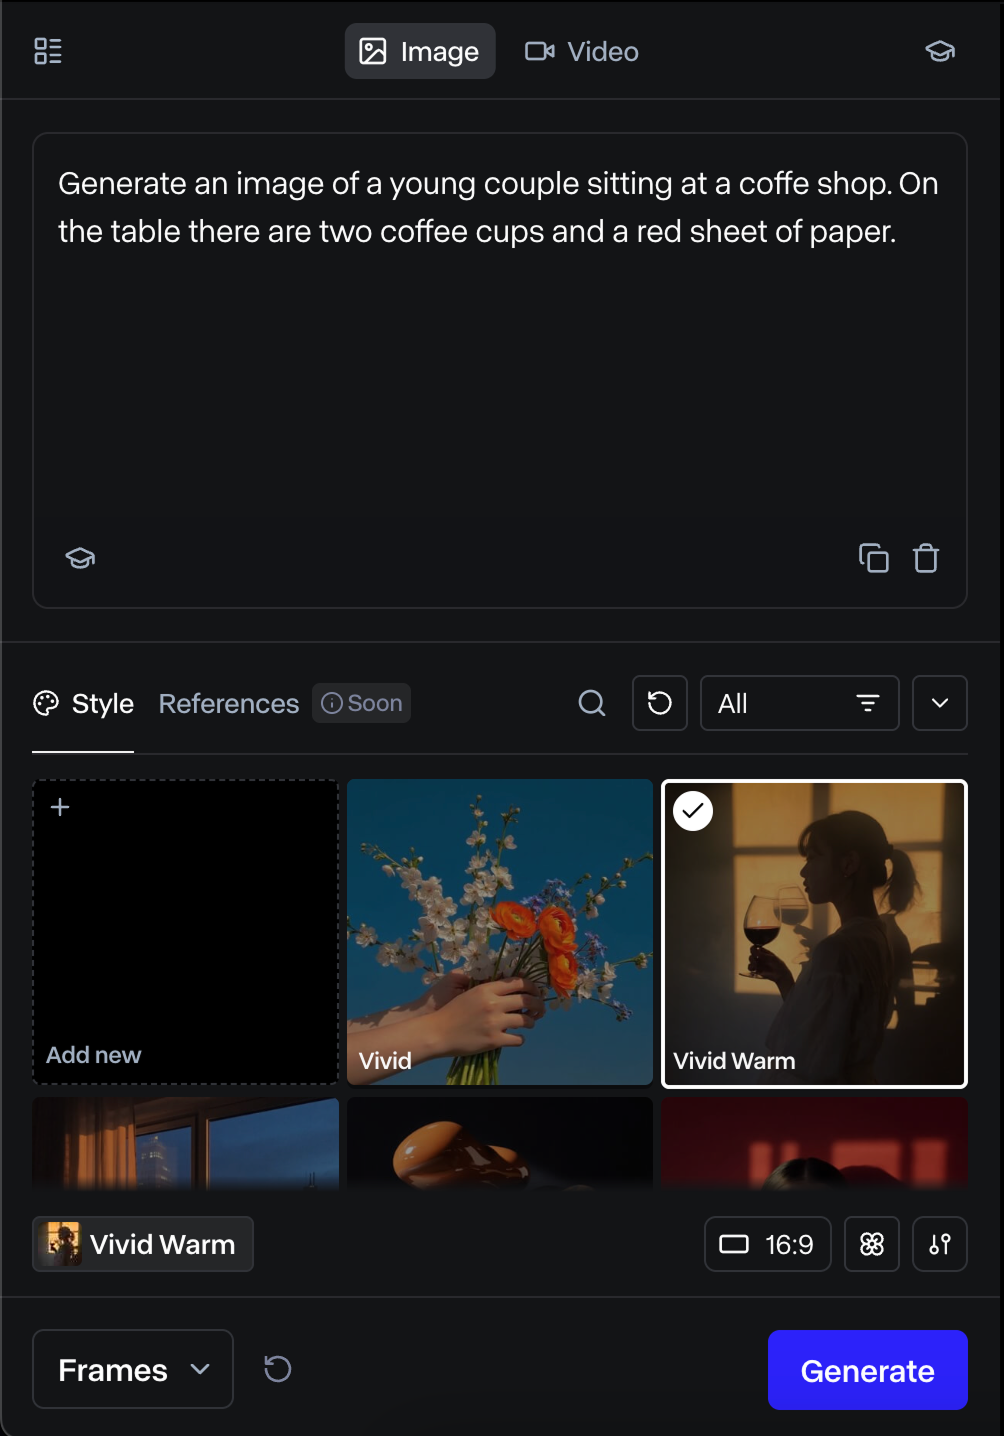
  1. Pilih mode “Image”
  2. Ketik prompt yang mendeskripsikan gambar
  3. Pilih gaya gambar (ini dapat dihasilkan dari gambar yang Anda miliki atau preset yang disediakan Runway). 

how to creat a video in runway

Model menghasilkan empat gambar berikut:
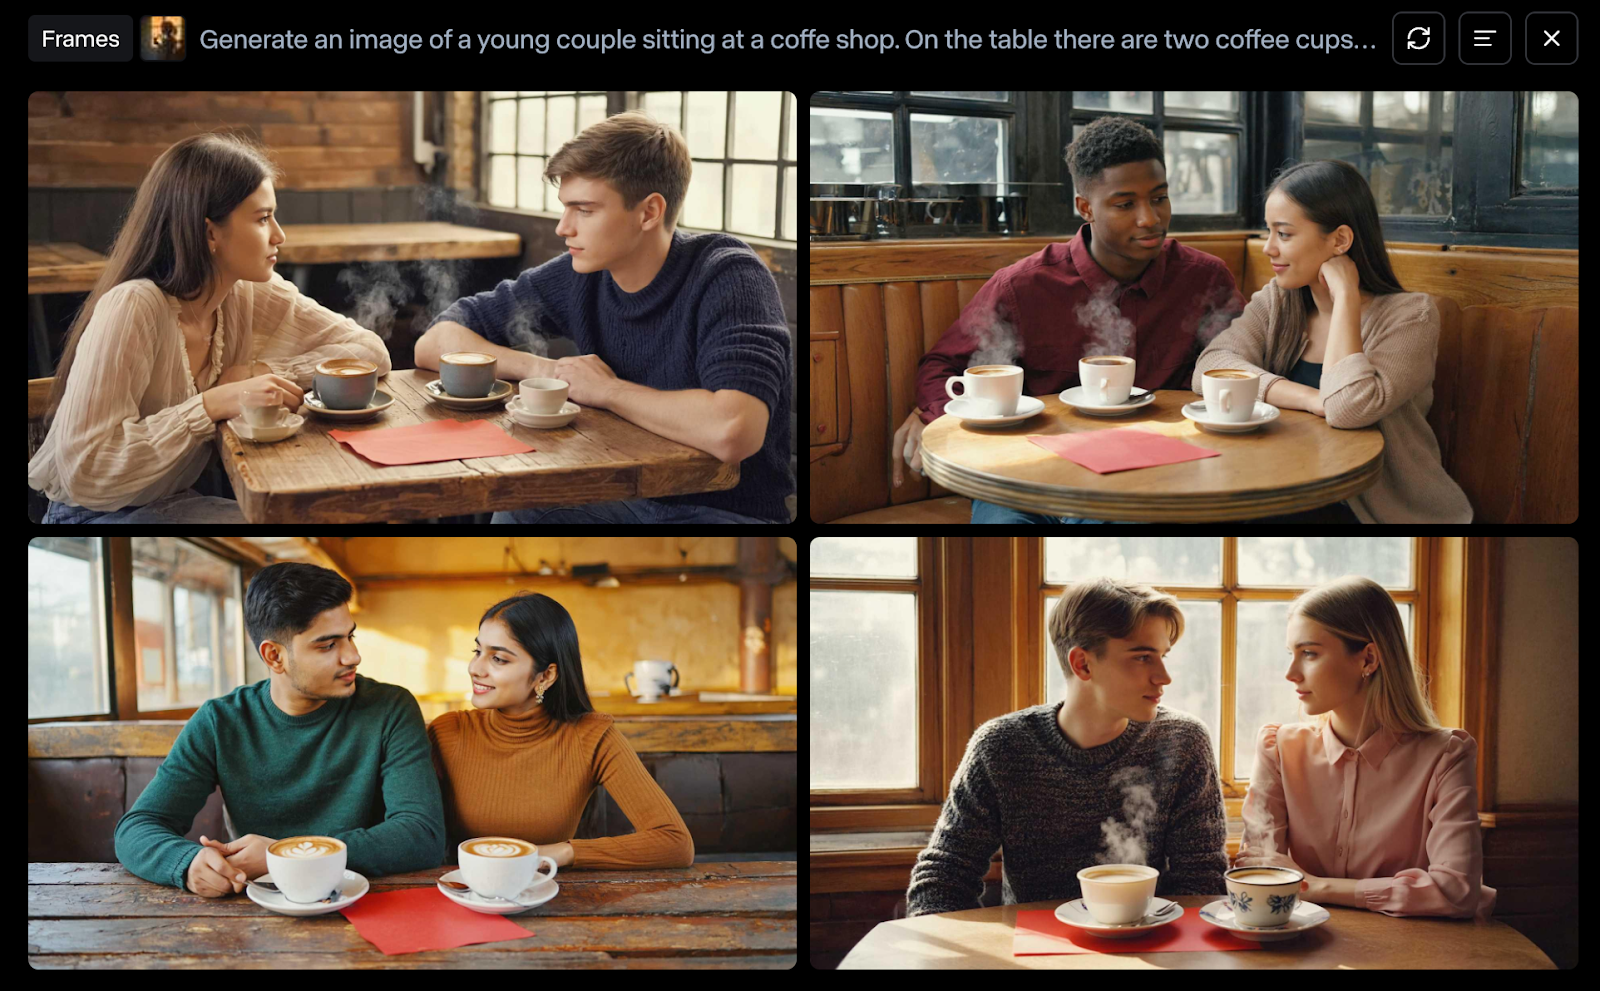
image output with runway

Hanya dua gambar di bagian bawah yang sesuai dengan prompt. Terlihat kedua gambar di bagian atas memiliki lebih dari dua cangkir kopi, dan yang pertama bahkan memiliki artefak aneh.

Alasan saya meminta kertas merah di meja adalah karena saya ingin membuat video dari gambar ini tentang pria yang membuat bunga kertas origami untuk diberikan kepada gadis itu.

Untuk melakukannya, kita dapat mengarahkan kursor ke gambar yang ingin digunakan dan klik tombol “Use”:
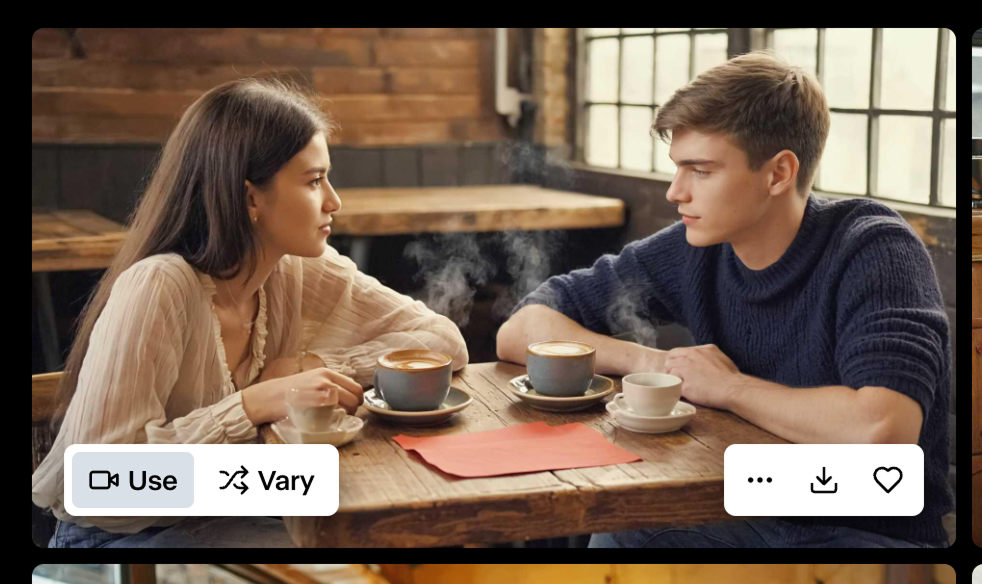
the use button in runway

Saya membuat prompt yang meminta pembuatan video dengan kamera tetap tentang pria yang membuat bunga origami dan memberikannya kepada gadis itu. Saya mencobanya dua kali, sekali membuat video 5 detik lalu 10 detik. Hasilnya kali ini cukup mengecewakan (saya menggunakan Gen-4 di sini):

Fitur yang Hilang untuk Konsistensi Karakter

Beberapa minggu terakhir saya banyak menguji alat pembuat video AI. Salah satu masalah utama saat membuat konten yang lebih panjang adalah kemampuan menampilkan karakter yang sama di beberapa adegan. Alat-alat ini biasanya memungkinkan kita membuat video berdurasi beberapa detik. Ini cukup untuk membuat video panjang dengan menggabungkan beberapa adegan, tetapi kita memerlukan kemampuan agar karakter yang sama muncul di banyak adegan.

Dalam artikel pengenalan Gen-4, mereka membuatnya terlihat sangat mudah menggunakan mode baru untuk membuat video yang lebih panjang:

Saya berharap bisa memberikan gambar karakter saya, membuat gambar adegan dengan karakter tersebut di dalamnya, lalu membuat setiap adegan menggunakan Gen-4. Namun, itu belum didukung, setidaknya untuk saat ini.

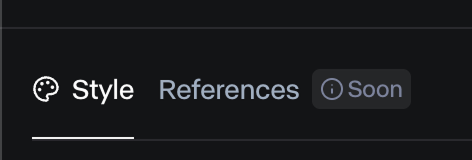
the references feature in runway will be available soon

Di tab pembuatan gambar, kita melihat fitur “References” yang belum tersedia.

Saya merasa ini menyesatkan karena tanpa fitur itu, video di pengumuman mereka sebenarnya tidak mungkin dibuat.

Menyiasati Keterbatasan Runway

Untungnya, Google dan OpenAI baru-baru ini merilis fitur ini di model pembuatan gambar mereka. Gemini 2.0 dari Google memiliki mode penceritaan yang akan menghasilkan rangkaian gambar untuk sebuah cerita, sementara pembuat gambar GPT-4o dari OpenAI dapat mengambil gambar referensi dan mengubahnya menjadi apa pun yang kita inginkan. Jika Anda ingin mempelajari lebih lanjut tentang kedua alat ini, saya membahasnya di sini:

Membuat video dengan penceritaan Gemini

Berikut video yang saya buat dengan meminta Gemini menceritakan kisah visual tentang api dan tetesan air yang jatuh cinta tetapi menyadari bahwa mereka tidak bisa saling menyentuh.

Dalam mode penceritaan, Gemini menghasilkan rangkaian gambar untuk menceritakan kisah visual. Lalu, saya menggunakan alat AI untuk membuat prompt berdasarkan pedoman Runway guna menganimasikan setiap frame. Berikut hasilnya:

Klip-klip tersebut disatukan menggunakan perangkat lunak penyuntingan video. Saya melakukan sedikit pemotongan dan beberapa transisi sederhana. Saya juga harus berulang kali mencoba di Gemini dan Runway untuk mendapatkan frame yang saya inginkan.

Saya cukup puas dengan hasilnya. Ada beberapa gangguan di sana-sini, tetapi secara keseluruhan, saya dapat menceritakan kisah yang ingin saya sampaikan. Saya bahkan merasa cukup sedih dengan kisah ini yang menunjukkan bahwa konten buatan AI pun bisa memuat emosi manusia yang nyata karena pada akhirnya masih ada manusia yang mencoba menyampaikan pesan.

Membuat video dengan pembuatan gambar GPT-4o

Menurut saya GPT-4o jauh lebih kuat dan serbaguna dalam membuat gambar dibandingkan Gemini. Video sebelumnya memerlukan banyak iterasi untuk mendekati keinginan saya, dan saya bahkan harus menggunakan GPT-4o untuk membuat salah satu frame.

Saya ingin mencoba kisah seorang petualang yang memanjat masuk ke dalam sebuah lukisan dan kemudian terteleportasi ke dunia di dalam lukisan tersebut.

Saya mulai dengan meminta GPT-4o membuat karakternya. Saat saya puas dengan hasilnya, saya memikirkan frame yang saya inginkan:

  1. Karakternya sedang melihat lukisan.
  2. Kita melihat close-up wajah karakter yang sedang merenungkan lukisan.
  3. Karakternya memanjat masuk ke dalam lukisan.
  4. Karakternya kini berada di dunia dalam lukisan.
  5. Pengambilan gambar dari udara memperlihatkan dunia baru yang luas ini.

Setelah puas dengan frame-frame tersebut, saya menggunakan Gen-4 untuk membuat video dari masing-masing frame dan menyusunnya di perangkat lunak penyuntingan video:

Menurut saya tidak terlalu buruk untuk upaya pertama. Adegan ketika pria itu berjalan masuk ke lukisan perlu diperbaiki. Saya sudah mencoba banyak generasi, tetapi tidak ada yang sesuai keinginan.

Runway Gen-4 vs. Alat Lain

Karena alat-alat fundamental yang diperlukan untuk menjaga konsistensi karakter belum tersedia di Runway hingga tulisan ini dibuat, Gen-4 pada dasarnya hanyalah model image-to-video. Oleh karena itu, saya ingin membandingkannya dengan model lain untuk melihat performanya.

Saya memilih untuk menganimasikan adegan pertama dari video Api dan Tetesan Air, di mana api berjalan ke kanan dan keluar dari frame.

Berikut perbandingan berdampingan antara Runway, Sora, dan WanVideo:

Kita dapat melihat bahwa hanya Runway yang dapat melakukan tugas tersebut. Ini menunjukkan potensi besar model ini setelah semua fiturnya tersedia.

Lebih Banyak Contoh Runway Gen-4

Pada bagian ini, saya menampilkan beberapa video lagi yang saya coba buat untuk memberikan pemahaman yang lebih baik tentang apa yang bisa dilakukan Runway Gen-4 pada tahap ini.

Pesawat kertas

Saya memiliki ide membuat video tentang seseorang membangun pesawat kertas lalu menerbangkannya. Saya membuat empat frame:

  • Orang tersebut sedang membuat pesawat.
  • Orang tersebut berada di lapangan berlari untuk melempar pesawat.
  • Orang tersebut melompat ke dalam pesawat.
  • Orang tersebut sedang terbang di dalam pesawat.

Pada contoh ini, kita kembali melihat model kesulitan dengan kertas. Saya kira detailnya terlalu banyak. Selain itu, adegan melompat ke dalam pesawat juga sangat aneh.

Menganimasikan objek

Saya penasaran bagaimana model menangani animasi objek dunia nyata, jadi saya mengambil sebuah foto dan meminta Gen-4 untuk membuatnya menari. Hasilnya cukup lucu menurut saya:

Lampu lalu lintas

Di situs web mereka, ada contoh stickman lampu lalu lintas yang hidup dan melompat keluar dari lampu lalu lintas. Ini menginspirasi saya untuk mencoba membuat video pendek tentang stickman lampu lalu lintas yang berlari dari polisi lalu melompat ke lampu penyeberangan pejalan kaki yang tidak aktif untuk bersembunyi dari polisi.

Berikut tiga gambar yang saya buat dengan GPT-4o, beserta videonya:

Sayangnya, Gen-4 tidak mampu mewujudkan visi saya. Saya mencoba berkali-kali tetapi hasilnya selalu jauh dari harapan.

Kesimpulan

Secara keseluruhan, saya merasa Gen-4 adalah model image-to-video yang bagus, terutama untuk adegan yang familiar. Namun, saya merasakan banyak hambatan dan frustrasi saat mencoba membuatnya melakukan apa yang saya inginkan.

Saya juga merasa pengumuman mereka agak menyesatkan karena beberapa fitur untuk membuat video panjang yang konsisten belum tersedia, dan hal itu sama sekali tidak jelas sebelum membeli langganan. Saya berharap perusahaan AI menunggu produknya selesai alih-alih membangunnya dengan hype. Jika bukan karena rilis terbaru dari Google dan OpenAI, saya tidak akan bisa membuat video apa pun yang saya buat di sini.

Saya pikir Runway menunjukkan harapan, tetapi mereka masih jauh dari menghadirkan produk yang memungkinkan siapa pun dengan sebuah cerita untuk bisa mewujudkannya. Kita masih sangat jauh dari kemampuan membayangkan sesuatu, menuliskannya, dan melihatnya menjadi nyata.

Contoh-contoh mereka sangat indah, dan saya percaya itu dibuat dengan Gen-4, tetapi saya juga berpikir ada banyak sekali pekerjaan di balik layar untuk mewujudkannya.


François Aubry's photo
Author
François Aubry
LinkedIn
Insinyur full-stack & pendiri di CheapGPT. Mengajar selalu menjadi passion saya. Sejak masa awal sebagai mahasiswa, saya aktif mencari peluang untuk membimbing dan membantu mahasiswa lain. Passion ini mendorong saya menempuh studi PhD, di mana saya juga menjadi asisten pengajar untuk mendukung kegiatan akademik saya. Selama tahun-tahun itu, saya menemukan kepuasan besar dalam suasana kelas tradisional, membangun koneksi dan memfasilitasi proses belajar. Namun, dengan hadirnya platform pembelajaran daring, saya melihat potensi transformatif pendidikan digital. Bahkan, saya terlibat aktif dalam pengembangan salah satu platform tersebut di universitas kami. Saya sangat berkomitmen untuk mengintegrasikan prinsip-prinsip pengajaran tradisional dengan metodologi digital yang inovatif. Tujuan saya adalah menciptakan kursus yang tidak hanya menarik dan informatif, tetapi juga mudah diakses oleh para pembelajar di era digital ini.
Topik
Kecerdasan Buatan
Large Language Models

Pelajari AI dengan kursus-kursus ini!

Program

Dasar-Dasar Bisnis Kecerdasan Buatan

12 jam
Percepat perjalanan AI Anda, kuasai ChatGPT, dan kembangkan strategi Kecerdasan Buatan yang komprehensif.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

Lihat SelengkapnyaLihat Selengkapnya
